
对话 StageCraft 作者,聊一聊 VLA 从本体迁移到环境变化差在哪

今年 IEEE/RSJ 智能机器人与系统国际会议(IROS)于 9 月 27 日至 10 月 1 日期间在美国匹兹堡召开。
本届 IROS 收录的论文接近 1,900 篇,分设三百多个主题报告场次。
作为机器人领域与 ICRA 齐名的两大顶级旗舰会议之一,IROS 覆盖研究方向极其全面,囊括机器人结构设计、运动控制、环境感知,机器人人工智能、灵巧操作、自动驾驶与人机交互等核心领域,汇聚了全球机器人领域的前沿研究成果。
本次会议全程在匹兹堡举办,为期数日的会议日程紧凑密集,各会场报告轮番开展。即便全天沉浸式聆听分享,我们也仅能涉猎部分前沿成果。
其中一场,是关于 StageCraft 的。
这项由亚利桑那州立大学团队完成的工作,论文全称是《StageCraft: Execution Aware Mitigation of Distractor and Obstruction Failures in VLA Models》,中文大意为「对 VLA 中干扰物与遮挡失败的执行期缓解」。论文 3 月正式发布,已被 IROS 2026 接收。
这项研究核心聚焦视觉语言动作模型(VLA)的泛化边界难题。当下主流的 VLA 模型依托大规模预训练,具备优异的跨任务、跨场景通用能力,但在真实机器人工作台作业场景中,一旦出现训练分布之外的干扰物体,或遭遇物理遮挡情况,模型的任务执行成功率便会大幅下降。
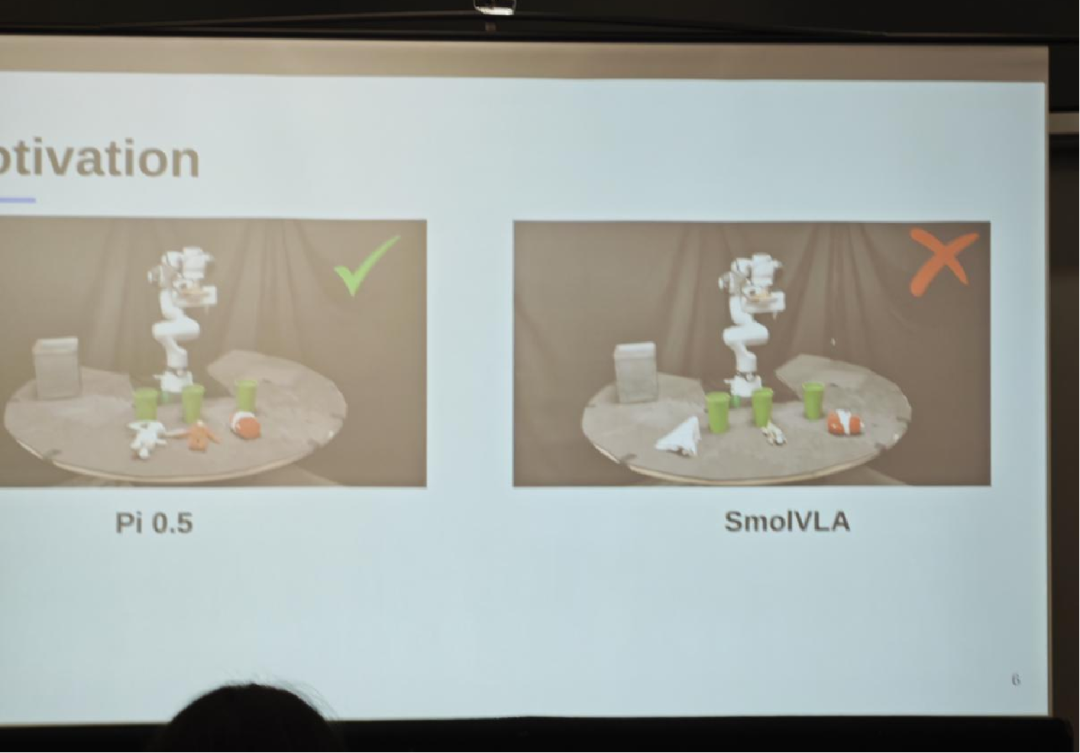
这类性能失效问题,在机器人真实落地场景中十分常见。
多数情况下,VLA 模型本身足以完成目标任务,失败根源并非模型能力不足,而是外界环境干扰。传统优化方案存在明显局限:通过重采数据、微调模型的方式修复泛化问题,不仅成本高、效率低,多数真实场景也无法复刻原始训练数据,导致优化工作难以落地。
不同于主流方法在训练流程中堆叠优化策略的思路,StageCraft 另辟蹊径,无需重新训练模型、无需改动策略参数,仅通过调整环境初始状态解决失效问题。系统会先采集机器人在各类干扰场景中的任务执行数据,依托视觉语言模型 (Vision-Language Model,VLM)进 行推理分析,精准定位引发任务失败的关键物体,最终仅移除最小规模的干扰物体集合,即可消除环境干扰。
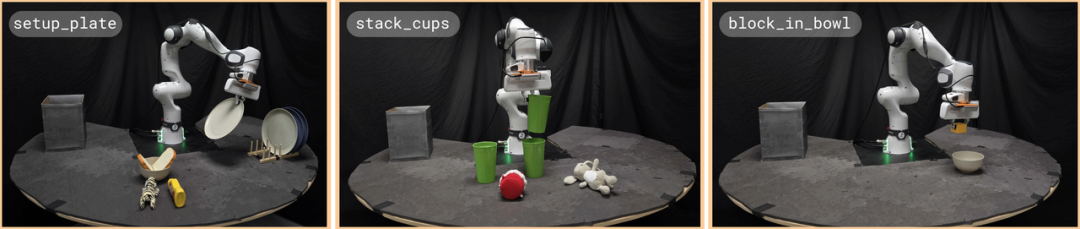
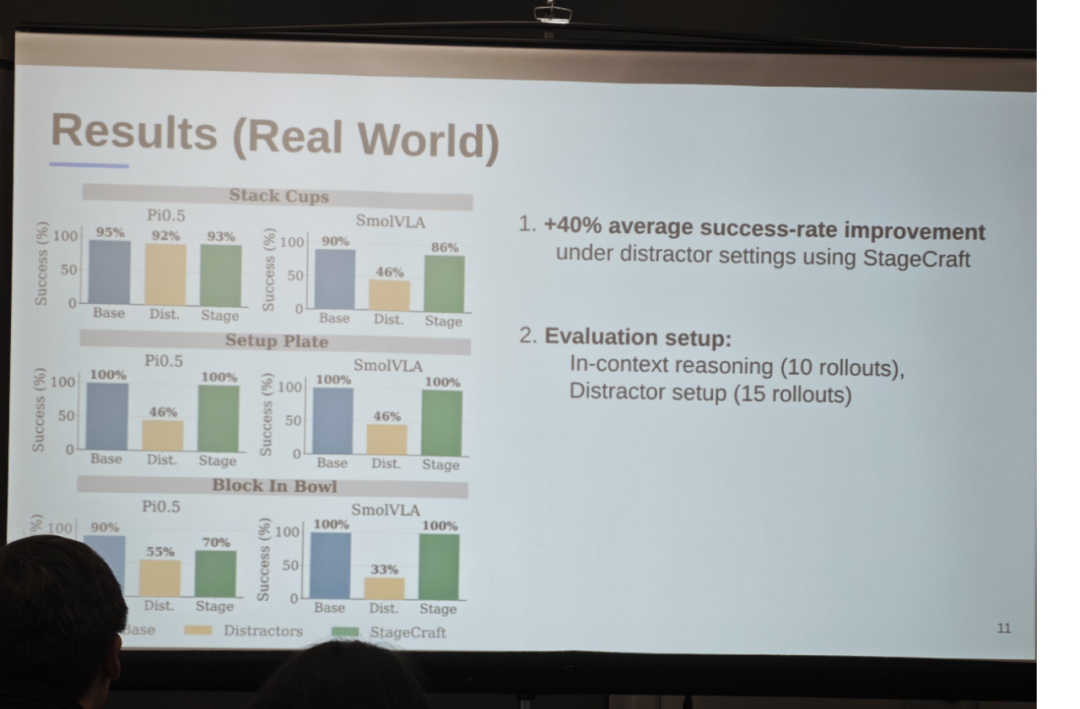
真机实验结果表明,在存在干扰物的复杂场景下,该方法能将机器人任务平均成功率提升约40个百分点,测试场景涵盖叠杯子、餐盘摆放、积木入碗三 项典型机器人操作任务,效果提升显著。
该项研究由亚利桑那州立大学团队独立完 成,由 Kartikay Milind Pangaonkar、Prabin Kumar Rath、Omkar Patil 三位学者共同一作,亚利桑那州立大学计算机科学系助理教授 Nakul Gopalan 指导完成。
报告结束后,我们和论文共同一作 Prabin Rath 进行了一场深 入对话。
以下是42号电波与 Prabin Rath 的对话实录,略经编辑。
从本体迁移到环境变化
42 号电波: 能否简单介绍一下你的学术背景?
Prabin Rath: 大家好,我是 Prabin Rath,目前是亚利桑那州立大学的二年级博士生,在 Nakul Gopalan 教授的指导下开展科研工作。
我的研究主要关注如何整体提升机器人的学习能力,视觉语言动作模型(VLA)是我们研究中使用的一类机器人学习模型。
我过去的研究关注如何让策略在不同机器人本体之间迁移,也就是让这些模型在不重新训练的情况下,从一台机器人泛化到另一台。最近我还在研究策略记忆,机器人模型如何在更长的上下文里持续工作,记住过去发生的事情,并据此作出正确决策。目前的 VLA 还不具备这些能力,我的研究就是探索如何把它们整合进最新的模型。
42 号电波: 和你此前关于机器人行为和本体的研究相比,转向 StageCraft 这样的环境变化研究,最大的挑战是什么?
Prabin Rath: 机器人本体迁移问题和这项工作研究的问题很不一样。
本体迁移在某些方面更难。工业界可用的机器人本体并不多,市面上能买到的机器人类型有限。如果我们只在一台机器人上训练,策略可能无法泛化到其他机器人。
StageCraft 处理的环境问题与本体问题几乎是相互独立的方向,但它同样是很大的挑战。我们没有足够的机器人数据用于训练,而当策略从训练环境被移到一个从未见过的新环境时,它往往表现不佳。这是同一类模型面临的不同问题,最终我们希望同时应对它们,在不同问题场景下整体提升模型。
42 号电波: 论文的特别之处在于,你们没有修改原有的 VLA,也没有重新训练策略,而是在任务执行前调整环境。是什么促使你们选择改变环境,而不是改变模型?
Prabin Rath: 这个问题有两部分答案。首先,StageCraft 并不是说那些直接改变模型的方法不好,那些方法当然也很重要。
策略可能以两种方式失败。第一种是模型本身没有能力控制机器人完成任务。比如任务需要灵巧操作,机器人必须拿起一个很难抓的物体,这属于技能问题,模型并不具备所需的技能,这种情况下调整环境也帮不上忙。
另一种失败由环境引起。 这时候策略可能本来已经具备完成任务的能力,只需要对环境稍作调整,任务对它就会容易一些。策略本身就有能力,只是需要一点辅助干预。
另一个原因是,在很多部署场景中重新训练这些模型并不现实。想象一家公司给你一台配有自家 VLA 的机器人,你可能完全不知道它用什么数据训练过。机器人被部署到厨房,在台面上遇到一个从未见过的物体,不断采集数据、微调模型并不现实,因为微调需要时间。人工采集数据要投入精力,相较于强化学习(RL)等其他 VLA 优化方案,StageCraft 的样本效率要高得多,仅需要少量策略试跑,就能够理解问题成因并处理故障。这是因为视觉语言模型(VLM)具备很强的推理先验,能够理解失败背后的原因。
从执行记录判断「干扰物」
42 号电波: 你们用过去成功和失败的执行记录,推断当前环境里哪些物体可能导致失败。这个过程最难的是什么?系统如何判断某个物体可能是失败原因?
Prabin Rath: StageCraft 遵循蒙特卡洛估计的思路。作为推理主干的 VLM 会查看 VLA 的多次执行记录,我们让 VLA 在策略可能遇到的不同环境里运行。
想象你家厨房里有一台机器人正在尝试完成一项任务,有时它失败,有时成功。结果标签由我们提供,失败时告诉系统它失败了,成功时告诉它任务完成了。VLM 的工作是推理环境中的哪些物体可能与失败有关。
这种推理在 VLM 的上下文中进行。积累足够的执行样本之后,提示词中的算法会把环境拆分成不同的物体集合,再根据这些集合寻找与失败相关的最小物体集合。
举例来说,如果水瓶出现在摄像头前时策略总是容易失败,VLM 就可能推断水瓶与更高的失败概率相关,并建议移走水瓶,或者把它挪到干扰较小的位置。这是 VLM 为了提升 VLA 表现作出的推测。
42 号电波: 你们不会移走环境里所有潜在的干扰物,只处理可能导致失败的物体。这样做主要是为了保留原有任务结构,还是为了避免干预引入新的失败?
Prabin Rath: 第二个原因才是主要的,我们希望避免引入新的失败。
干预过程中可能会影响到任务本身涉及的物体。比如演示里的叠杯子任务,杯子就是任务物体。对环境改动越多,引入新失败的可能性就越大。
所以,只有当模型相当确定某个障碍物或干扰物很可能导致 VLA 失败时,我们才会调整环境。模型仍然是在作估计,但会采取保守判断,不希望它做超出必要范围的操作。我们只想采取帮助 VLA 成功所必需的最小干预。
论文中使用了两种不同的 VLA,Pi0.5 和 SmolVLA。SmolVLA 相对较弱,Pi0.5 更强,能够在有更多干扰物的情况下工作。当干扰物增加到五个、六个或七个时,工作空间会变得非常杂乱,只有到那时,我们才会看到 Pi0.5 开始失败。如果它本来就能应对一两个干扰物,我们又何必动环境呢。未来如果 VLA 变得更强,不再受干扰物影响,StageCraft 就应该相应调整,不做任何环境改动,它应该能判断出底层 VLA 已经足够有能力。
适用场景与未来方向
42 号电波: 现在提升 VLA 能力的主流做法,是扩大模型规模、采集更多机器人数据并进行后训练。你们把一部分问题交给环境调整来解决,根据你的研究,什么类型的问题最适合这种方法?
Prabin Rath: StageCraft 专门用于处理源自环境本身的失败,另一个出发点是让这种方法无需训练。
它尤其适用于不常见的情况。比如你家里的机器人突然遇到一束花,你平时不一定天天有花,可能只是在某个特殊场合收到花。如果机器人突然看到这束花,而花对它来说属于分布外事物,它的表现可能开始变差,尽管它平时在家里工作得很好,花只是它没见过的新事物。
你不希望机器人仅仅因为出现了分布外的新物体就表现不佳。泛化能力更强的 VLM 可以帮助 VLA 理解这个新物体可能导致失败,并作出简单调整,让策略继续保持良好表现。我们的出发点是避免本来可以避免的失败。
42 号电波: 假设未来的 VLA 能理解当前环境、预测自身的失败风险、识别哪些物体可能导致失败,并在任务开始前把它们移开。到那时,你们的机制还需要作为独立系统存在吗,还是最终可以成为整合进通用 VLA 的基础能力?
Prabin Rath: 这是一个很好的研究方向。未来我们当然希望模型变得更智能,遗憾的是它们目前还没有达到那个程度。但即使模型变得更智能,我们可能仍然需要更强的机制来监督它们如何运行。
StageCraft 目前提出的是一种处理 VLA 失败的方法。未来问题可能会转向 VLA 的安全性,即使模型能力更强了,它们是否足够安全。届时监督机制可能关注安全,也可能关注个性化干预,对一个人重要的事情,对另一个人未必重要。
因此我们可以改变问题的表述。总体目标是由更高层的监督机制,帮助 VLA 这类以动作为中心的模型处理任务细节,让它们不必自己承担全部高层推理。高层推理可以交给更强、也更适合处理这类问题的模型。