
对话 TacVLA 论文团队,触觉该在什么时候更巧妙地发挥作用?
「这种思路谁都有,但是怎么加入进来?」
在 IROS 2026 现场聊到给 VLA 增加触觉时,张恒反复关注的并不是「要不要 touch」,而是另一个更具体的问题:机器人到底应该在什么时候使用触觉?
现在给机器人装上 tactile sensor,再把触觉信号和视觉、语言一起送进模型,已经不算一个特别新的想法。
真正麻烦的是,一条 manipulation trajectory 里,触觉并不是从头到尾都有同样的价值。
机器人还在 free-space motion、尚未碰到物体时,触觉信号几乎没有多少有效变化;真正发生 contact 以后,vision 可能只发生很小的变化,contact force 却开始快速改变。
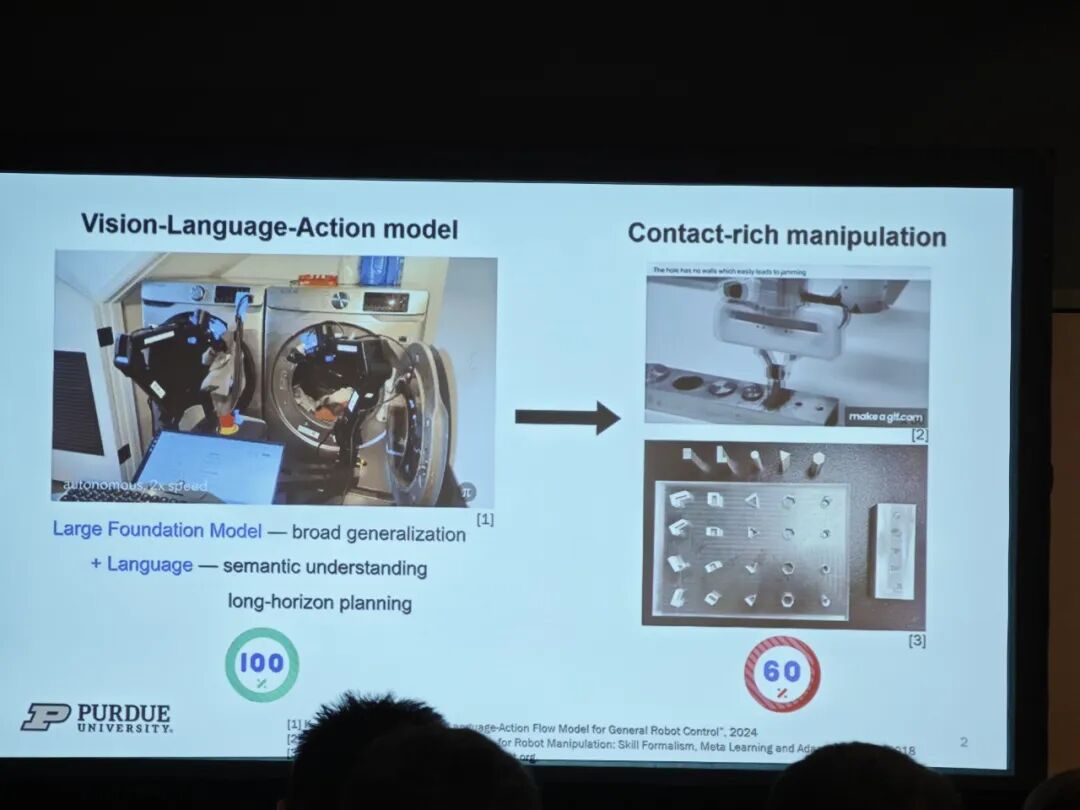
这正是 IROS 2026 接收论文《TacVLA: Contact-Aware Tactile Fusion for Robust Vision-Language-Action Manipulation》想解决的问题。
论文由张开迪和张恒共同一作,意大利技术研究院 iit 的 Arash Ajoudani 和普渡大学的 佘宇 指导。
张恒今年夏天完成博士阶段研究,目前在 Carnegie Mellon University(CMU)从事博士后研究。博士期间,他主要研究 learning-based method for contact-rich manipulation,导师为 Arash Ajoudani;博士期间他曾在普渡大学的 佘宇 团队开展访问研究,也由此与论文共同一作博士生张开迪一起发表了这篇 TacVLA。
他此前长期关注的正是机器人能不能自主的根据当前任务和状态,知道什么时候应该柔顺、什么时候应该施力,施加多大的力,机器人如何安全地与环境接触。
随着 VLA 快速发展,这个问题被带进了另一套模型框架里。
张恒回忆,在很很早期的时候,自己在本地部署相关模型时发现,视觉和语言已经能让模型越来越好地理解场景和任务,但是很多状态依然难以稳定地从视觉中获得,尤其是真正进入 physical contact 后。为此,他推出了 CompliantVLA-adaptor 让 VLA 的动作加上刚度调节机制,使得原始动作可以随着任务状态调节柔顺度。
「在很多时候只有视觉是不够的。」
在张恒看来,这也是 tactile 应该尽快进入机器人学习系统的原因之一。
于是他前往普渡大学 佘宇 教授指导的 MARS lab 访问学习,和张开迪一起完成了这篇工作。张恒说到,MARS lab 在触觉领域一直做着领先的前沿研究,本次 IROS 大会课题组展示了 10 篇 paper。
在 TacVLA 这篇文章里,作者探讨如果触觉并不是时时刻刻都有用,模型能不能只在它真正有信息的时候,再让它参与 action generation?这样既能拓宽和提升 VLA 的性能,又尽量避免额外模态信息带来的计算负担。
门控机制:先给触觉加一道「开关」
TacVLA 使用的是一块 tactile-array sensor,它包含一个 15×8 的触觉阵列,用来描述接触在传感器表面的分布。
与将 tactile map 编码成高维 image-like representation 不同,TacVLA 用一个轻量 MLP encoder,把这 120 个读数编码成 36 个 tactile tokens,再和语言、视觉等信息一起送入 VLA。
理由很直接:如果把 tactile 当作稠密图像处理,大量 pixels 会快速拉长 token sequence,增加 Transformer 的计算负担。
这一点和 《CONTACT:CONtact-aware TACTile Learning for Robotic Disassembly》里对 tactile representation 的讨论形成了某种呼应。两篇工作解决的问题并不相同,但都在处理同一个现实约束:更多 tactile information,并不等于所有信息都值得进入 policy。
解决了 tactile representation 之后,TacVLA 又进一步追问:这些 tactile tokens 应该在什么时候参与模型?为此,团队设计了 contact-aware gating mechanism。
系统首先用一个固定阈值判断 contact:当超过预设压力阈值的 taxel 数量超过一定数量后,contact flag 才从 0 变成 1。
这是一个二值判断。没有检测到 contact 时,模型会通过 attention mask 屏蔽 tactile tokens,同时将对应的 tactile embedding 置零;真正发生接触以后,这些 tactile tokens 才重新参与 cross-modal interaction。
不过,这道门只开关 tactile tokens。视觉、语言和其他信息并不会因为 gating 被一起切换。TacVLA 做的并不是动态决定「现在视觉重要还是触觉重要」,而是更具体地决定现在是否应该让 tactile 信息进入模型。
TacVLA 当前实现的是, 没有 contact 时屏蔽 tactile tokens,检测到 contact 后,再允许它们参与 cross-attention。
有触觉,不等于会用触觉
团队设计了两组真实机器人实验。
第一类是 四个约束锁定式拆解任务 :从紧配合的轴上取下物体、按下卡扣后取出物体、先扭转 90 度再拉出物体,以及先向内滑动再拉出物体。完成拆解后,机器人都要把物体放进碗里。这些任务需要很多的 fine-grind manipulation 操作,因为外观相似仅靠视觉难以区分任务。
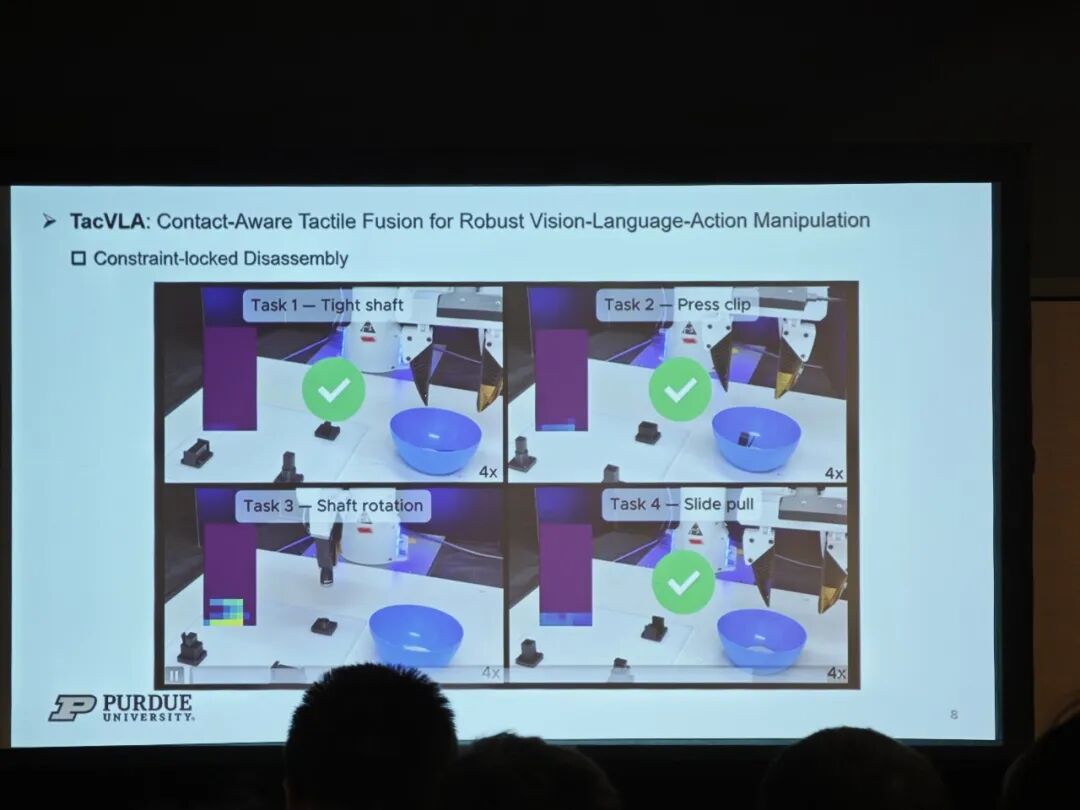
也就是说,接近并抓住物体,只是操作的一部分;机器人还要完成解除约束所需的动作,才能顺利取出零件。
为了区分触觉输入与门控机制各自的作用,团队比较了三种配置:不含触觉输入的微调 π0.5、加入触觉但不使用门控的版本,以及完整 TacVLA。
在四个任务上的平均成功率分别是:fine-tuned π0.5:63.75%;加入 tactile、但没有 contact-aware gating:71.25%;完整 TacVLA:83.75%。
只看平均值,很容易得出一个简单结论:加 tactile 有帮助,再加 gating 更好。
但拆到单个任务,结果没这么整齐。Task 3 上,vision-only 的 fine-tuned π0.5 成功率为 65%;加入 tactile、但不使用 gating 后,反而下降到 60%;完整 TacVLA 则提高到 70%。
也就是说,触觉并不是加进去就一定会变好。不过,每种配置在单个任务上只测试 20 次,因此 Task 3 的 60% 和 65%,实际对应 12 次成功和 13 次成功,只相差一次。
团队还观察了失败行为。不使用门控时,机器人可能在接近物体的阶段对不准,反复重抓、停在中间状态,或者抬起失败。论文推测,无条件参与融合的触觉 token 可能干扰了稳定接触建立之前的视觉定位。
第二类是 箱内取物 。前置相机看不到盒子内部,腕部相机进入盒子后又受到遮挡和有限光照的影响。机器人需要在视觉信息受限的情况下寻找、抓取物体,并将其取出。
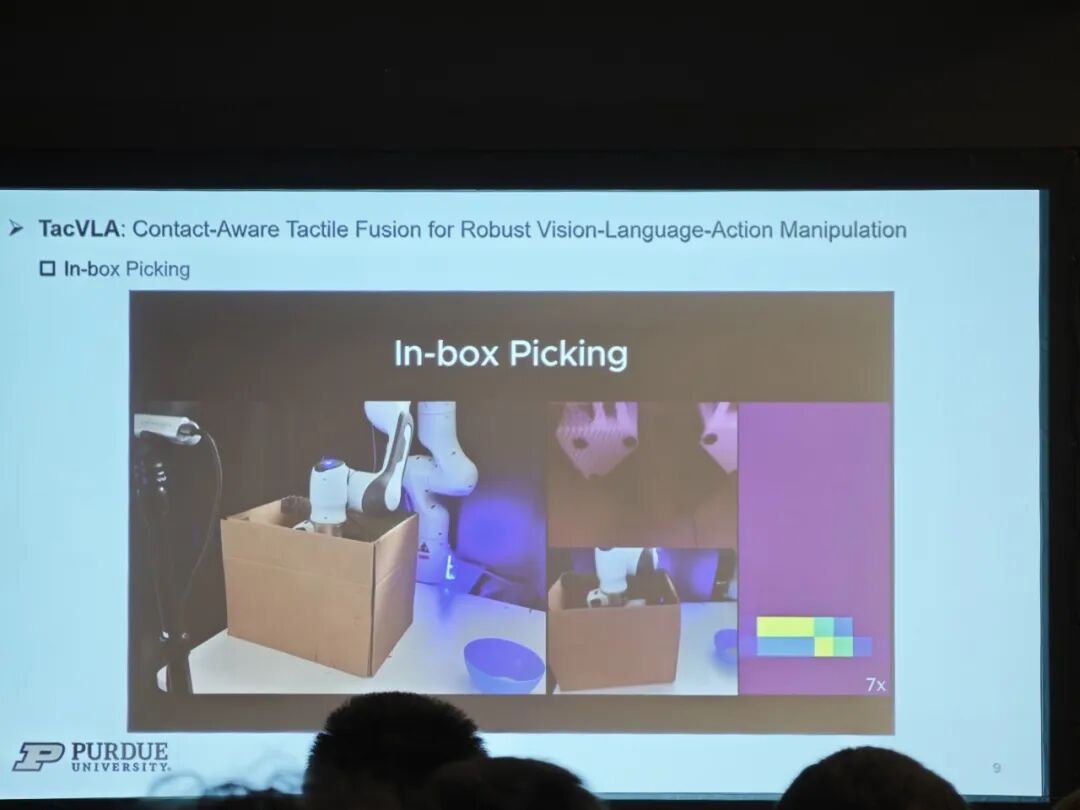
在这个任务中,TacVLA 最终做到 70% 成功率,fine-tuned π0.5 则只有 10%;两种 diffusion-policy baseline 分别为 0% 和 5%。
这两种 diffusion-policy baseline 同样使用了 tactile input,并不是无触觉模型。区别在于,它们主要依赖对应任务的数据从头训练,而 TacVLA 建立在 pretrained π0.5 backbone 之上。
论文因此将这里较大的性能差距,主要解释为预训练带来的先验,而不是简单归结为「TacVLA 有触觉」。
除了正常条件下的任务执行,团队还遮挡前置相机,测试视觉受损后的表现。
在遮挡条件下,微调 π0.5 的平均成功率约为 30%,TacVLA 为 62.5%,约为前者的 2.1 倍。但 tactile 并没有替代 vision,因为 TacVLA 自己也从无遮挡时的 83.75% 降至 62.5%。
团队还在现场展示了一组加入人为扰动的测试。机器人已经把物体抓起来并开始往箱外移动时,人突然把物体重新推回箱子。TacVLA 没有继续机械地 replay 原来的动作,而是重新探索、重新建立接触,再次抓取。微调 π0.5 未能恢复。
综合这些实验,TacVLA 展示了, 当视觉不足以完整描述 physical state 时,接触反馈可以帮助 policy 根据当前状态继续调整动作;而这些信息在真正发生接触时介入,效果又明显好于整条 trajectory 一直使用触觉。
这也是论文所强调的 contact-aware tactile fusion。论文摘要将这一设计描述为:只在检测到接触时选择性激活 tactile tokens,在避免无关 tactile interference 的同时,让视觉、语言与触觉共同进入 Transformer。
融合之外,还要考虑反馈的速度
实验跑通以后,问题并没有结束。
张恒认为,tactile VLA 面临的一个核心难点,是不同 modality 本身并不处于相同的信息和时间尺度。
视觉可以提供场景理解和较高层次的规划依据;接触建立之后,力与触觉的变化可能要求机器人更及时地修正动作。他在采访中用「两个回路」描述这种差别。
「接触之后,这个力的变化,触觉的变化……它其实相当于是两个回路,这个频率是不一样的。」
因此,对于未来 touch/force 怎样进入更大的 foundation-model-style system,张恒区分了两种可能的架构。
一种方式,是让相对 high-level 的 VLA 负责 semantic understanding 和 planning,下游再增加更高频的 tactile/force feedback layer;
另一种则像 TacVLA 当前尝试的方向,将触觉直接融合进模型,在注意力层与视觉、语言共同参与动作生成。
哪一种会成为最终架构,现在仍然很难判断。
在 42 号电波此次 IROS 的其他触觉采访中,这个问题也反复出现。
张志远谈到过 high-level visual reasoning 和更高频 contact refinement 的分层;CONTACT 共同一作 Adeesh Desai 也倾向于让较慢的 high-level model 与更快的 low-level controller 交换信息。
可见,当 tactile 开始真正进入 foundation-model-style policy 后,研究问题已经从「要不要触觉」继续往下走到了:触觉应该以什么 representation、什么时间尺度、在模型的哪一层发挥作用?
触觉「开口」之后
而回到 TacVLA 自身,它的实验边界也很明确。四个拆解任务和一个箱内取物任务,分别微调模型,再进行评估。
论文也列出了三项局限。首先,门控依赖二值阈值规则,不能连续地、通过学习调整模态权重;其次,触觉阵列的空间分辨率有限,限制了对精细接触几何的推理;最后,评估集中在短时程、以接触为主的任务,向更长时程、更复杂任务扩展仍是未来工作。
这些边界也不禁让人思考, 从几个任务中的有效方法,走向覆盖几百、几千种任务的 tactile VLA,还需要补上什么?
张恒没有把答案简单归结为「触觉数据不足」。
「我们不能单纯谈触觉。」他认为,TacVLA 建立在更广泛的 VLA 研究基础上,当前工作使用 π0.5,未来有更好的基础模型,触觉研究还要继续探索怎样与其结合。基础模型能力、触觉表征、训练方法和多模态融合,都有需要改进的部分,是相辅相成的。
另一边,tactile 本身的数据基础确实明显薄弱。张恒提到,很多已有机器人数据集,本身就没有 force/tactile signal。过去大量用于训练 VLA 的数据主要建立在视觉和 robot state 上,这意味着触觉学习从一开始就面对与视觉不同的数据基础。
即使未来数据开始大量增加,什么 tactile data 才真正「好」,也没有简单答案。
「并非是完美的数据是最好的。」
张恒甚至提到,一些看起来不够完美、带有噪声的数据,未必一定是坏数据。他举了一个从 A 点把物体搬到 B 点的例子。人的直觉可能偏爱顺畅、干净的动作轨迹;一些不那么顺畅、看起来「歪歪扭扭」的过程,也可能增加数据变化,帮助模型获得更好的鲁棒性与泛化。
要让 tactile VLA 的范式真正走向 scaling,还要回答一系列基础问题。
在张恒看来,VLA 已经把机器人推向更强的通用泛化;再往后,dexterity、contact 和 safety 会越来越成为绕不开的问题。
这也是他此次 IROS 的一个直接感受。
谈到机器人进入家庭的愿景,张恒对时间保持谨慎,认为可能还需要很多年。但他很肯定,类似机器人拿起杯子或草莓时,不能只有「知道要做什么」,还需要知道怎样接触施加多大的力完成相应操作。
TacVLA 给了一个具体起点,而围绕这一步,问题也自然延伸到反馈频率、触觉数据规模,以及不同 modality 最终应该以怎样的架构协同。
对张恒来说,下一步则很清楚:「从研究角度来说,我们一直都觉得下一阶段就是灵巧操作和触觉。」
科研之外
在谈到接下来的职业规划时,张恒说,一方面寻找教职是一个路径依赖的选择,可以考虑;另一方面,他也在积极接触投资人寻找创业机会。在他看来,历史的进程和自己的专业所学已经交叉在了一起,加上自己多年以来的 connection,理应考虑如何为社会创造更大的价值。
谈到具体的创业方向时,他没有透露具体细节,但肯定是在 physical AI 领域。长期来看,他最想做的是 Robot Scientist 方向。他想打造成千上万的机器人科学家,7*24 h 不间断的探索,基于底层的 AI Agent 系统,结合真正的机器人执行实验,为人类知识发现的大爆发贡献一点力量。
几年前,他曾和多伦多大学的博士生张鹏松就此进行了深度的思考,相关细节在他们共同发表的 position paper:《 Scaling Laws in Scientific Discovery with AI and Robot Scientists 》。
他激动地说到, 「 人类花了四百多年建立起现代科学研究范式,推动了物理、化学、生物、医学等领域的飞速发展,正是因为这些知识和发现,才有现在的文明和福祉。而我们相信,现在,真正由 AI 与机器人驱动的科学大发现时代(Age of Autonomous Discovery)才刚刚开始。 」
未来,机器人和 AI,让科学发现本身进入前所未有的加速时代。谈到未来的梦想,他笑道, 机器人是一方面,自己更希望成为电影导演拿奥斯卡。
而我们不妨拭目以待。