Robota-Embed: Joint Action and Visual Encoding for Robot In-Context Learning
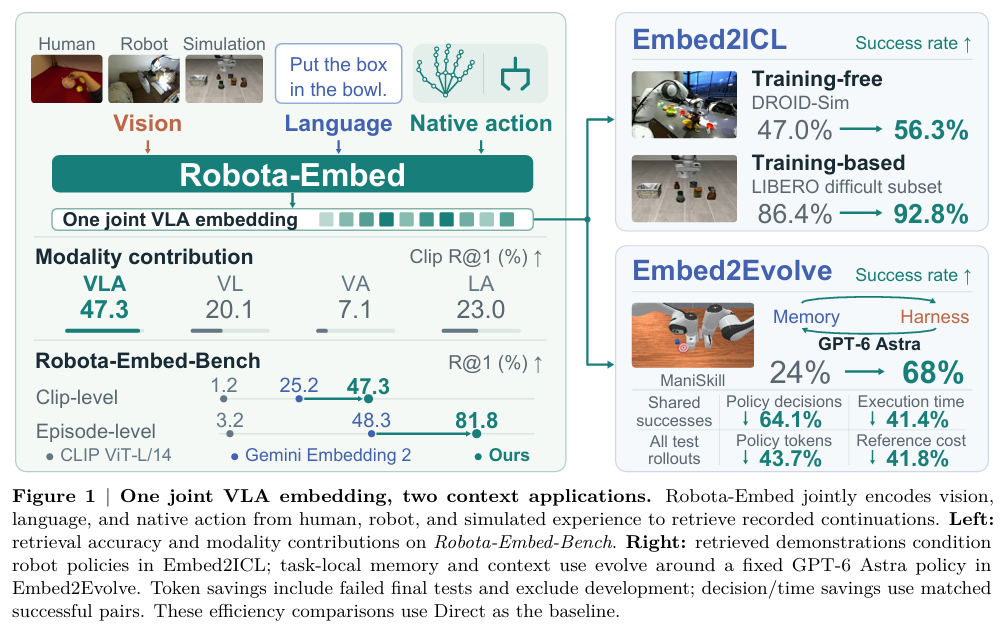
A joint team from NVIDIA, MIT, UC Berkeley, Oxford, and CMU introduces Robota-Embed, a unified VLA embedding that incorporates action data into experience retrieval. The model significantly improves robot in-context learning by matching future behavior logic rather than just visual similarity.