
对话 CONTACT 作者:从任务到表示,机器人需要什么样的触觉?
过去几年,机器人研究关注的问题正在发生变化。
随着 sensing、learning 和 foundation model 的结合不断深入,新的问题开始出现:机器人感知到的信息,究竟哪些真正能够帮助它完成动作?
触觉正处在这个转折点。过去相当长一段时间,tactile sensing 的研究重点之一是传感器设计与感知能力提升;如今,随着机器人学习的发展,触觉开始更多进入 dexterous manipulation、robot learning、VLA 和 world model 等方向。
但增加一种新的 sensing modality,并不意味着机器人一定获得更好的操作能力。
IROS 2026 主会论文《CONTACT: CONtact-aware TACTile Learning for Robotic Disassembly》正是在回答这个问题。论文由 Yosuke Saka、Jyun-Chi Hu、Adeesh Desai、张志远等人完成,通讯作者为佘宇。
不过相比简单讨论「机器人需不需要触觉」,CONTACT 更关注两个问题: 第一,什么样的 manipulation task 真正能够从 tactile sensing 中获益?第二,对于 policy learning,什么样的 tactile representation 更有效?
42 号电波在 IROS 期间与 CONTACT 作者张志远和 Adeesh Desai 进行了交流。两位作者围绕 contact-rich manipulation、tactile representation,以及多模态策略如何真正利用触觉信息分享了他们的思考。
张志远目前在普渡大学 MARS Lab 从事机器人学习研究,研究方向包括 3D policy learning、vision-tactile multimodal learning 和 world models for contact-rich manipulation。早期他主要关注 vision-based tactile sensing 和 sensor design,并参与开发 GelRoller。进入普渡大学后,他逐渐把关注点从「如何获得触觉」转向「机器人获得触觉之后,如何真正使用这些信息完成操作」。
Adeesh Desai 曾参与普渡大学 MARS Lab 的相关研究,是 CONTACT 论文共同一作之一。他的研究关注 tactile learning、contact-rich manipulation 和 physical interaction。在 CONTACT 中,他主要参与探索不同 tactile representation 如何影响 policy learning,以及结构化接触信息如何帮助机器人完成复杂操作。
他们的研究路径也对应了 CONTACT 想回答的核心问题: 机器人需要的并不只是更多 sensing,而是与任务相关的 physical information。 这也是 CONTACT 和很多单纯增加传感器模态的研究不同之处。它并没有继续追问「机器人还需要更多 sensor 吗」,而是提出了另一个更基础的问题:对于一个具体任务,policy 真正需要理解的 physical information 到底是什么?
触觉的价值具有明显的 task dependency
CONTACT 选择 disassembly 作为主要研究场景,并不是偶然。
许多已有 tactile manipulation 工作集中在 insertion,例如 USB insertion 或 peg-in-hole。这类任务非常重要,但 contact-rich manipulation 并不只有几何对齐。拆解过程中,机器人还需要面对 friction、shear、deformation、卡扣释放以及局部接触状态变化等问题。
例如,一个零件可能因为摩擦而无法拔出,一个 barb 可能尚未 disengage,卡扣可能需要先被压下,弹性结构也可能必须形变到某个状态之后才能释放。论文将这类过程概括为 force-dependent state transitions:任务成功不仅与 geometric alignment 有关,也与接触力和物理约束如何随动 作变化有关。
为此,CONTACT 设计了 10 个不同复杂度的 disassembly tasks,其中 5 个为 simulation tasks,5 个为 real-world tasks。任务从相对简单的 rigid extraction,逐渐扩展到包含 lid、barb、push tab 和 vertical clip 等更复杂的接触与形变过程。
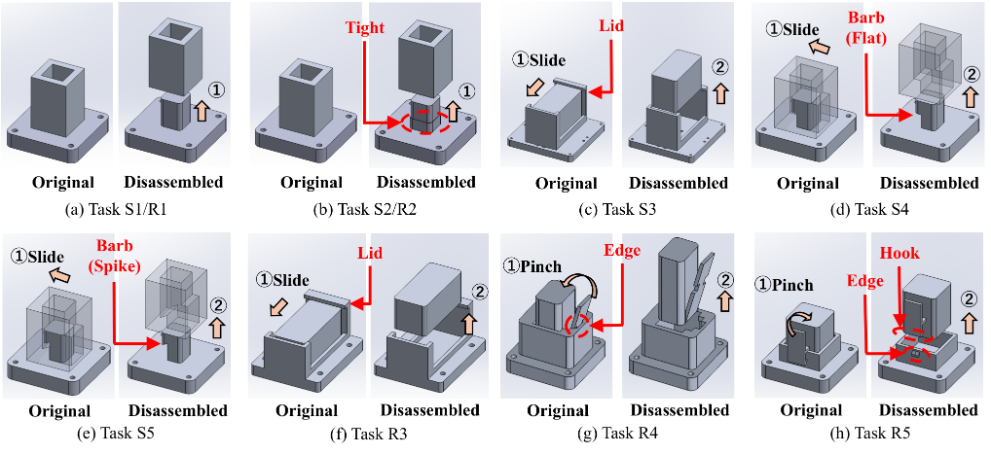
这一组任务使研究者能够比较:当任务从主要依赖 geometry,逐渐转向更依赖 contact state 时,不同 sensory representations 的作用如何变化。
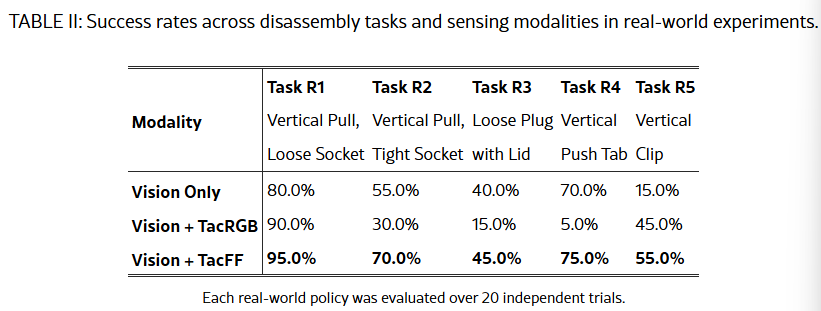
实验结果表明,在 CONTACT 所测试的任务中,触觉带来的收益具有明显的 task dependency。例如在真实任务 R1 中,Vision Only、Vision+TacRGB 和 Vision+TacFF 的成功率分别为 80%、90% 和 95%;在 R2 中分别为 55%、30% 和 70%;在更复杂的 R3 中则分别为 15%、45% 和 55%。
这些结果并不意味着「任务越难,触觉就一定越重要」。更准确地说,当任务主要依赖 geometric alignment 时,视觉往往已经能够提供较强的状态信息;而当机器人需要判断 friction、shear、deformation,以及一个结构究竟处于「卡住」还是「释放」等 physical state 时,触觉能够提供视觉难以直接观察的信息。
论文中一个直观的例子是 centered grasp 与 tilted grasp。由于 low contrast 和 self-occlusion,两种抓取状态在外部 RGB camera 中可能非常接近;但 tactile signal 会呈现明显不同的局部接触模式。TacRGB 能反映不同的 surface deformation,而 TacFF 中则可以观察到 tilted grasp 下更不对称的 shear distribution。
因此,视觉和触觉并不是简单的替代关系。视觉更擅长描述外部几何与场景状态,而触觉能够在接触发生后提供局部 physical interaction information。
为什么结构化 force field 在 CONTACT 中更有效?
CONTACT 的另一组核心实验关注 tactile representation。
团队使用 GelSight 获取触觉信息,并将其处理为两种形式。一种是 TacRGB,即较为原始、稠密的 tactile image;另一种是 TacFF,将接触进一步表示为空间分布的 normal force 和 shear force,形成更紧凑、更结构化的 force-field representation。
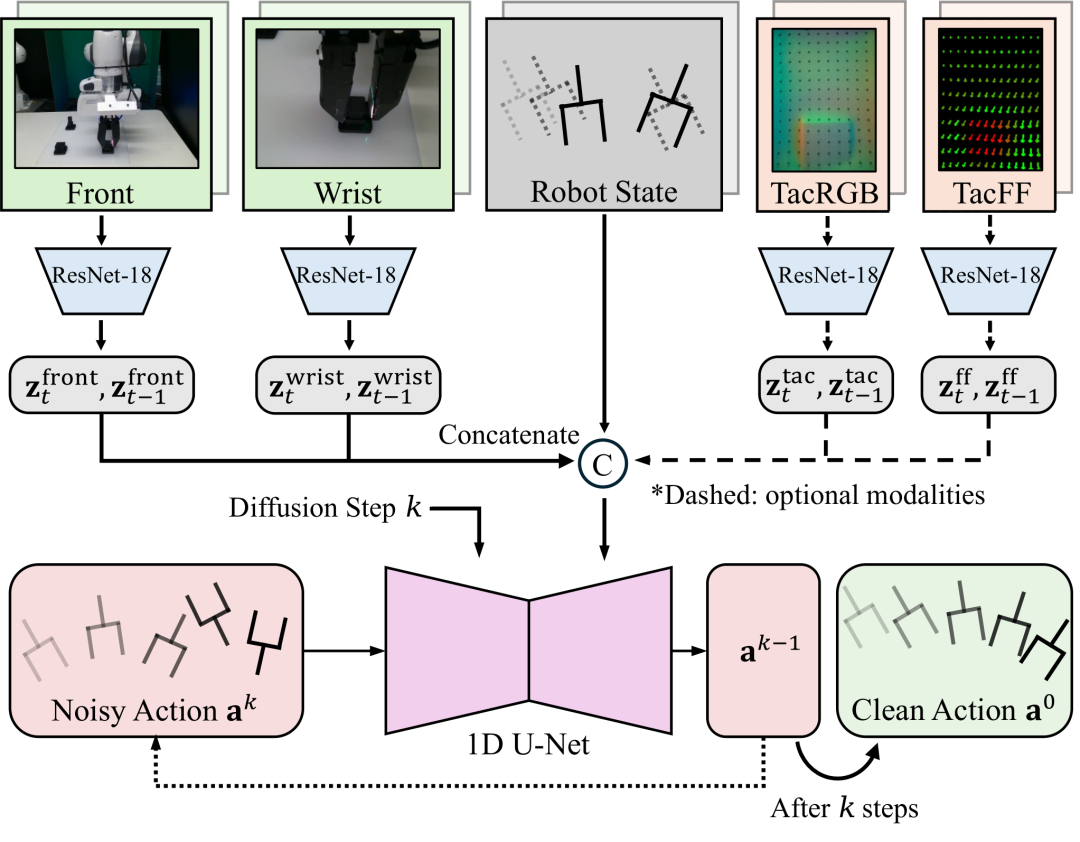
在 CONTACT 的 5 个 simulation tasks 和 5 个 real-world tasks 中,Vision+TacFF 整体取得更好的表现,而 TacRGB 的效果则具有更明显的 task dependency。例如真实任务 R2 中,Vision Only 为 55%,Vision+TacRGB 为 30%,Vision+TacFF 为 70%。
为什么会出现这种差异?
一个关键点在于,不同 tactile representations 保留的信息并不相同。TacRGB 保留丰富的 appearance、surface deformation 和 texture cues;如果任务目标是 material recognition 或 texture classification,这类高维信息可能非常有价值。但在 CONTACT 所关注的 disassembly tasks 中,policy 更需要理解的是 contact dynamics,例如接触方向、局部受力、shear 以及结构是否已经释放。
从这个角度看,TacFF 可以被理解为一种 task-relevant inductive bias。面对 raw tactile images,模型需要从大量像素变化中自己学习哪些信息与 action generation 有关;而 force field 已经将与 contact interaction 更直接相关的物理量显式组织出来。
但这个结果并不意味着 force field 是普适最优的 tactile representation。更准确地说,在 CONTACT 的 contact-rich disassembly tasks、当前数据规模和 policy architecture 下,TacFF 提供了更适合当前任务的结构化表示。
这里还有一个更基础的区别:两者并不是对同一份 physical information 的简单不同编码。
在 GelSight 传感器中,shear force 通常通过追踪凝胶表面 marker 的横向移动获得。而 CONTACT 使用的 TacRGB 是 markerless tactile image,主要记录凝胶被压入后的形变,并不直接包含这类 marker motion。
因此,在 CONTACT 的设置下,TacRGB 与 TacFF 的差别不仅来自 representation 形式,也来自可观测信息本身的不同:一部分 shear information 在 markerless TacRGB 输入中本身就难以获得,而 TacFF 则显式提供了 normal force 和 shear force 的结构化表示。
这也意味着,不能简单认为只要扩大 TacRGB 数据规模,模型最终就一定能够恢复与 TacFF 等价的信息。最终结果还取决于 sensor observability、data diversity、model capacity 和 training objective。如果某类 physical information 本身没有进入 observation,更多同类数据也无法凭空补充这一部分信息。
当然,raw tactile image 并非没有价值。TacRGB 保留了丰富的 appearance、surface deformation 和 texture cues,在 material recognition、texture perception 或更大规模学习场景中仍然可能发挥重要作用。随着数据规模和模型能力提升,未来不同 tactile representations 如何结合,也仍然是开放问题。
更多模态,并不自动意味着更好的 policy
如果 TacRGB 和 TacFF 包含不同的信息,那么把二者同时输入 policy 是否会更好?
CONTACT 的实验给出了一个值得注意的结果:并不会自动更好。在 R3 和 R5 的实验中,简单同时加入 TacRGB 和 TacFF,并没有超过单独使用 TacFF,部分情况下反而明显下降。
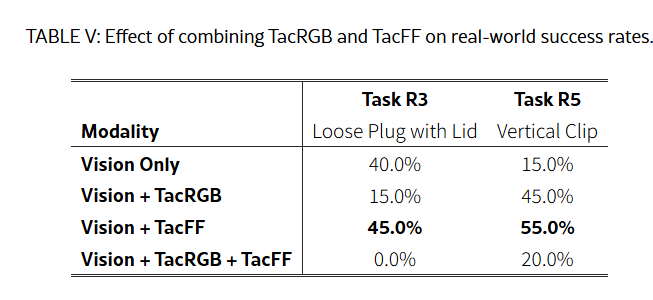
这个结果首先说明了一件事:heterogeneous sensory inputs 的有效融合并不会因为「信息更多」而自然发生。更多 observation dimensions 可能同时带来冗余、不同统计特性的输入,以及更复杂的 representation learning 问题。
不过,需要区分实验观察与可能的机制解释。CONTACT 直接观察到的是 naive multimodal fusion 没有带来额外收益;至于性能下降究竟来自输入冗余、encoder capacity、fusion architecture,还是有限数据下的 optimization difficulty,还需要进一步研究。
这也自然引出了后续方向:真正有效的 multimodal policy 可能需要 modality-aware attention、针对不同模态设计的 specialized encoders,或者根据当前 interaction state 动态决定哪些 sensory information 应该进入 policy。
因此,CONTACT 想强调的并不是「少给机器人传感器」,而是对于 manipulation policy,信息量本身并不是唯一目标,task relevance 和 representation quality 同样重要。
从感知到动作修正
除了成功率,CONTACT 还观察了不同 sensory configurations 下的行为差异。
值得注意的是,TacFF 并不总是让机器人完成任务更快。在部分成功 rollout 中,带有 force feedback 的 policy 会经历更长的 interaction time。一个可能的原因是 tactile processing 带来额外计算开销;另一方面,持续变化的 force cues 也为 policy 提供了进一步调整动作的依据。
这与 contact-rich manipulation 的特性有关。接触发生之前,视觉 observation 会随着机器人运动不断变化,而 tactile signal 可能接近常量;真正发生接触之后,外部视觉变化有时反而较小,而局部 tactile signal 会快速变化。
dim-light experiments 进一步展示了视觉与触觉之间的互补关系。在 R5 中,Vision Only 从正常光照下的 15% 降至 dim-light 下的 0%,而 Vision+TacFF 在两种条件下都保持 55%。但在 R1 中,低照度仍然会让所有配置的表现明显下降。
因此, 触觉并不是视觉失效后的通用「补盲」工具。 更准确地说,两种模态描述的是不同层面的状态:视觉提供 global geometry 和 scene context,触觉提供 contact-local physical interaction information。
CONTACT 最终提出的并不是增加更多传感器,而是重新审视 robot policy 应该如何选择、表示和利用 physical information。
触觉 scaling 的关键,不只是数据量
当 robot learning 进一步走向大规模数据和 foundation models,触觉还面临一个视觉领域没有那么突出的困难:真实 tactile data 很难直接从互联网获得。
互联网中存在海量 RGB image 和 video,但这些数据通常没有同步的 contact force、shear、deformation 或 tactile state。因此,tactile learning 很难直接复制视觉模型依赖 web-scale data 的 scaling path。
张志远目前关注的一条方向是 tactile imagination:利用真实 paired vision-tactile data 学习视觉与触觉之间的关系,再让模型从视觉 observation 中预测 task-relevant tactile representation。如果这种跨模态预测足够可靠,就有可能把原本只有视觉的数据转化为对 physical interaction 更有用的 representation。
Adeesh Desai 则进一步强调,预测出来的触觉与真实测量到的触觉,并不一定是替代关系。
在 TacImag 中,对于接触敏感类任务,由模型生成的想象触觉力场已经展示出接近真实触觉传感的效果。但视觉感知依然难以处理隐藏或突发情况:比如被遮挡的接触、摩擦、滑移起始时刻,或是锁扣是否真正弹开。
因此,他更倾向于把触觉模型预测当作先验信息,传感器实测值作为修正项。如果模型预测出的 tactile state 与真实测量之间出现较大差距,这种 discrepancy 本身也可能成为重要信号:它意味着真实世界中发生了模型没有预料到的 physical interaction。
从这个角度看,随着 tactile prediction 能力提升,真实 tactile sensor 的角色可能也会发生变化:它不一定始终作为主要的信息来源,而可能更多承担发现模型预测错误、修正 physical understanding 的作用。
另一条值得探索的路线是 egocentric human manipulation data。人类能够非常自然地完成大量 dexterous interaction,但如何从第一视角视觉、手部运动以及有限的 tactile measurements 中提取可以迁移给机器人的 physical interaction information,仍还需探索。
这样来看,CONTACT 提出的问题并没有停留在「机器人需不需要触觉」。
当 tactile learning 继续 scale 时,更重要的问题可能是:什么样的 physical information 值得被感知?什么样的 representation 能够保留与任务相关的 interaction state?这些信息又应该在什么时候、以什么方式进入 policy?
对于 contact-rich manipulation 来说,真正需要 scale 的或许不仅是数据量,也包括机器人如何表示、预测并利用 physical interaction 的能力。
参考资料 :
CONTACT : https://vict0rhu.github.io/CONTACT-Website/
TacImag:https://tacimag.github.io/