
理想汽车基座模型团队提出 ME-Dex 1.0,让触觉和画面一起预测未来
ME-Dex 1.0 让机器人在输出动作前,预先计算下一步会产生的接触状态。理想汽车基座模型团队将视觉、触觉、动作三路专家模块整合进同一个去噪框架;触觉与图像一样,被视作需要预测的未来观测。团队还借助手部模板,把不同灵巧手、夹爪的触觉信息对齐为同一组区域特征,最终提升了高接触密度双手任务的表现。
9 月 18 日,理想汽车基座模型团队发布论文《ME-Dex 1.0: Bringing Heterogeneous Tactile Sensing into World Action Modeling》。论文共 10 位作者,Xuancheng Zhang 为第一作者,Yu Liu 为项目负责人。
世界动作模型将视频模型的预判能力引入动作生成:模型先预测未来画面变化,再据此输出动作。触觉直接反映物理接触,过往大多仅作为附加输入,接入策略或世界模型的输入端。ME-Dex 1.0 的核心思路是,触觉和视频同样用于描述世界状态的演变,二者应并列作为未来观测,同步预测。
该路线需要攻克三大难点:触觉数据稀缺、不同传感器与机械手本体格式不统一、三种模态在同一个模型内联合学习。团队针对性设计了自动数据补全平台、手部模板搭配共享自编码器,以及三路专家共享注意力的架构。
01 接触的变化值得预判
机器人精细操作过程中,接触状态通常分阶段逐步建立。这意味着动作必须跟随接触进度动态调整,仅依靠视觉单路信息并不足够。
插入电源插头时,手部先触碰插孔边缘,再完成对准,最后向内按压,每一步受力都存在差异。装配机械结构,需要一只手固定工件,另一只手送入销钉。抓取纸杯,用力过大容易捏扁杯体,用力不足则提起时发生滑脱。这类过程由指尖受力表征;图像只能捕捉物体轮廓变化,是否发生接触、姿态是否偏斜、夹持是否稳定,都需要依靠触觉信号判断。
过往将触觉接入策略的方案,读取的是当下时刻的受力数值,将其作为条件输入,和图像、语言一同送入模型。DECO 就是这类方案的典型代表,它利用交叉注意力把触觉特征接入已训练完成的视觉策略,冻结原有参数,仅训练新增的触觉通路。
这类方案虽然能让模型使用触觉信息,但存在局限:模型不会预测后续数帧接触状态的演变。抓取、插孔这类任务中,作用力会随接触状态动态变化,只有插到位之后,才需要松开夹持。模型真正需要的是接触状态后续的演变趋势,当前受力仅仅是起点。团队设置对照实验,将同一套触觉特征接入 π0.5 与 Fast-WAM 两个基线模型。在 RoboTwin 的 Random 配置下,Fast-WAM 加入触觉后成功率提升 1.00 个百分点,π0.5 加入触觉后反而下降 3.08 个百分点。可见,把触觉直接放在模型输入端,收益高低取决于基线自身架构。
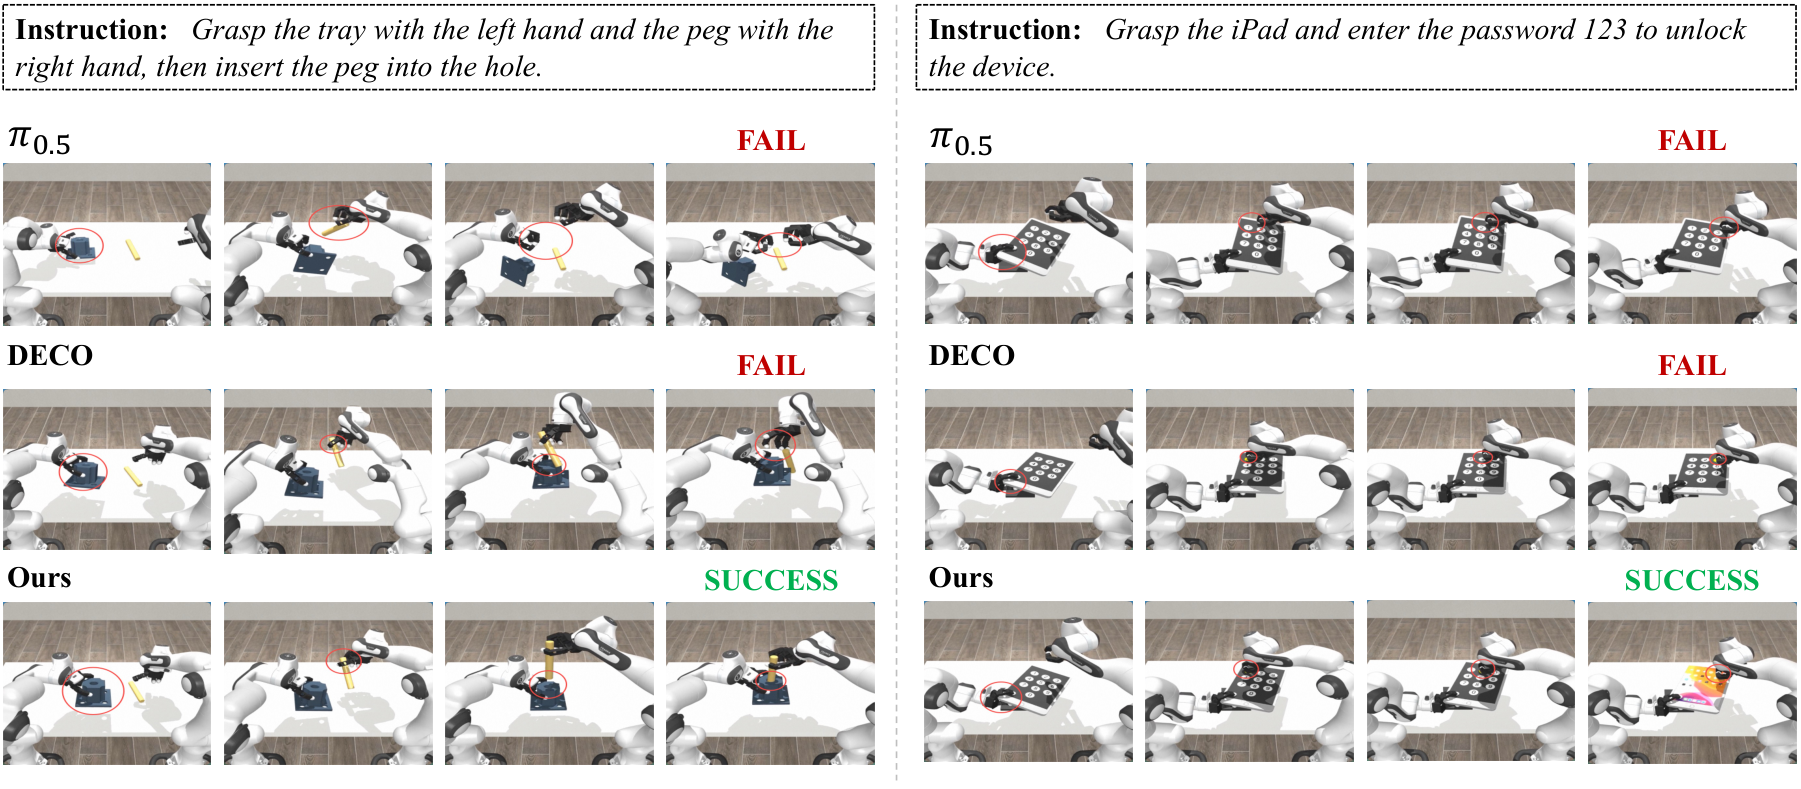
理想汽车基座模型团队提出的方案,是将触觉提升至和图像并列的层级,二者都作为待预测的未来观测。落实在模型内部,动作生成在每一轮去噪过程中,都可以读取未来画面与未来接触的预估结果。这条路线最直观的验证来自高接触密度任务:在 DexJoCo 的装配、平板解锁两项任务中,机器人需要一边固定物体,一边完成精细交互,双手同时产生触觉。团队公开的 rollout 结果显示,ME-Dex 1.0 在这两项任务上的双手协同表现,比 π0.5 与 DECO 更加完整。
02 一套表示装下五种手
触觉数据和图像数据并不相同。图像的格式统一,而触觉数据格式依附于机械手搭载的传感器,更换机械手就会得到一套完全不同的数据。团队首要目标,就是让异构触觉数据能够送入同一个模型。
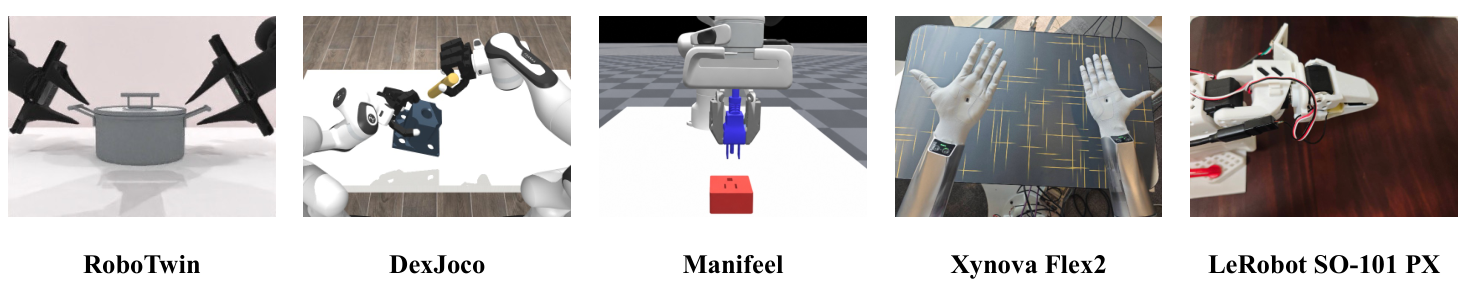
RoboTwin 与 ManiFeel 采用夹爪,DexJoCo 与 Xynova Flex2 采用灵巧手,真机还搭载装在 LeRobot SO-101 夹爪内的 Paxini PX6AX 传感器。这些传感面输出法向加两个切向的三轴力场,布局、分辨率与覆盖范围各不相同。力场输入前需要预处理:团队为每一块传感面配置布局掩码,标记传感器的有效位置;受力信号先经过平滑死区处理,再压缩大数值,完成归一化与裁剪,法向分量限定在 0 到 1 之间,切向分量限定在 -1 到 1 之间。
团队以人手为模板,搭建一套名为 Canonical Hand Model 的手部区域模型,将各类机械手视为人手形态的变体。左右手预先定义好手指与手掌的对应区域,灵巧手的各个指节、掌心都映射至模板对应位置。针对 RoboTwin 夹爪的处理更为细致:它的两片传感面对应映射到大拇指与食指区域,每片再切分为四块有序补丁,夹爪闭合时的受力就拥有固定落点。
不同硬件本体仅能覆盖模板中的部分区域,团队借助区域掩码区分两种情况:「这个区域没有传感器」和「有传感器但当前无接触」。二者在后续预测中的含义完全不同,前者代表数据不可获取,后者代表检测到接触状态为空。
完成空间映射对齐后,力场还需要压缩为统一特征。团队训练一个共享触觉自编码器,参数在全部传感面之间共用,逐帧独立处理,输出一组携带区域标记的区域特征。编码器依靠残差卷积提取局部受力特征,在单块传感面内执行窗口注意力,并基于有效位置做掩码池化;夹爪传感面在四块补丁内分别池化,灵巧手则整体池化,再按照模板区域顺序放入固定位置。
解码器取回各传感面特征,以局部网格位置作为查询执行交叉注意力,再通过残差网络与卷积还原表面特征。模型设置两个预测头:力头预测法向与切向分量,接触头预测接触概率;最终还原的力场,由两项预测结果与有效位置掩码相乘得到。
训练这套自编码器一共使用四项损失。力损失在接触位置监督接触门控前的预测,在背景位置监督门控后的重建。接触损失采用平衡二元交叉熵,标签取自死区处理前的力值大小。变化损失对齐相邻帧的力差值,对接触产生、接触松开的场景加大权重。潜在损失将无接触有效区域的特征,向同布局零输入的结果收敛。四项损失联合训练完成后,自编码器被冻结,为联合模型提供当前触觉条件以及未来触觉目标。
RoboTwin 与 DexJoCo 原生不具备触觉传感能力。团队搭建一套自动化数据平台,回放两个平台已有的动作轨迹,直接读取仿真环境力传感器数据,生成和图像、动作对齐的触觉序列;同时生成并执行全新轨迹扩充数据集。RoboTwin 上补充 50 个任务、27,500 条 Clean 与 Random 轨迹。DexJoCo 按照官方多任务设置补充 11 个任务、1,100 条演示样本,包含六个单臂任务、五个双手任务。ManiFeel 自带三维触觉力场,四个插入任务各使用 50 条演示数据,单独训练策略。
03 三路专家一起预测
ME-Dex 1.0 的主体由三路专家模块拼接而成,视频、触觉、动作各占一路,全部采用加噪还原框架。三路模块各自保留独立处理链路,在网络中间层共享注意力,动作生成模块在每一步去噪过程中,都可以读取另外两路对未来状态的预估。
视觉分支沿用 Wan2.2-5B 结构,共 30 层,隐藏维度 3072。动作分支 30 层,隐藏宽度 1024;触觉分支 30 层,隐藏宽度 512。视觉与动作分支,使用 Motus 在大规模机器人数据集上预训练的权重初始化;触觉分支采用随机初始化。训练阶段,视觉分支接收编码后的首帧图像与添加噪声的未来画面特征;动作分支接收本体状态与加噪的真实动作序列;触觉分支接收编码后的当前触觉帧与添加噪声的未来触觉特征。未来画面、动作、触觉的真实值,分别作为三路的监督信号。
触觉分支将触觉视作和视频同构的时间序列。一段未来触觉包含 T 帧,每一帧描述双手在该时刻的受力情况。冻结的触觉编码器逐帧编码,输出带有空间结构的特征序列;触觉分支的任务就是从噪声中还原这组特征序列,再交由冻结解码器还原为力场。
三路之间的信息交互,仅限定在网络中间的部分层级。团队借鉴 H-Bridge 的方案,在这几层将三路特征投影至同一个注意力维度,对视觉、触觉、动作的标记统一做注意力计算,再将输出映射回各自原始维度。信息交换集中在中层之后,每个模态在输入、输出阶段保留独立处理逻辑,跨模态注意力所需层数更少。动作分支就能依靠这几层,读取视觉与触觉对未来的预判。
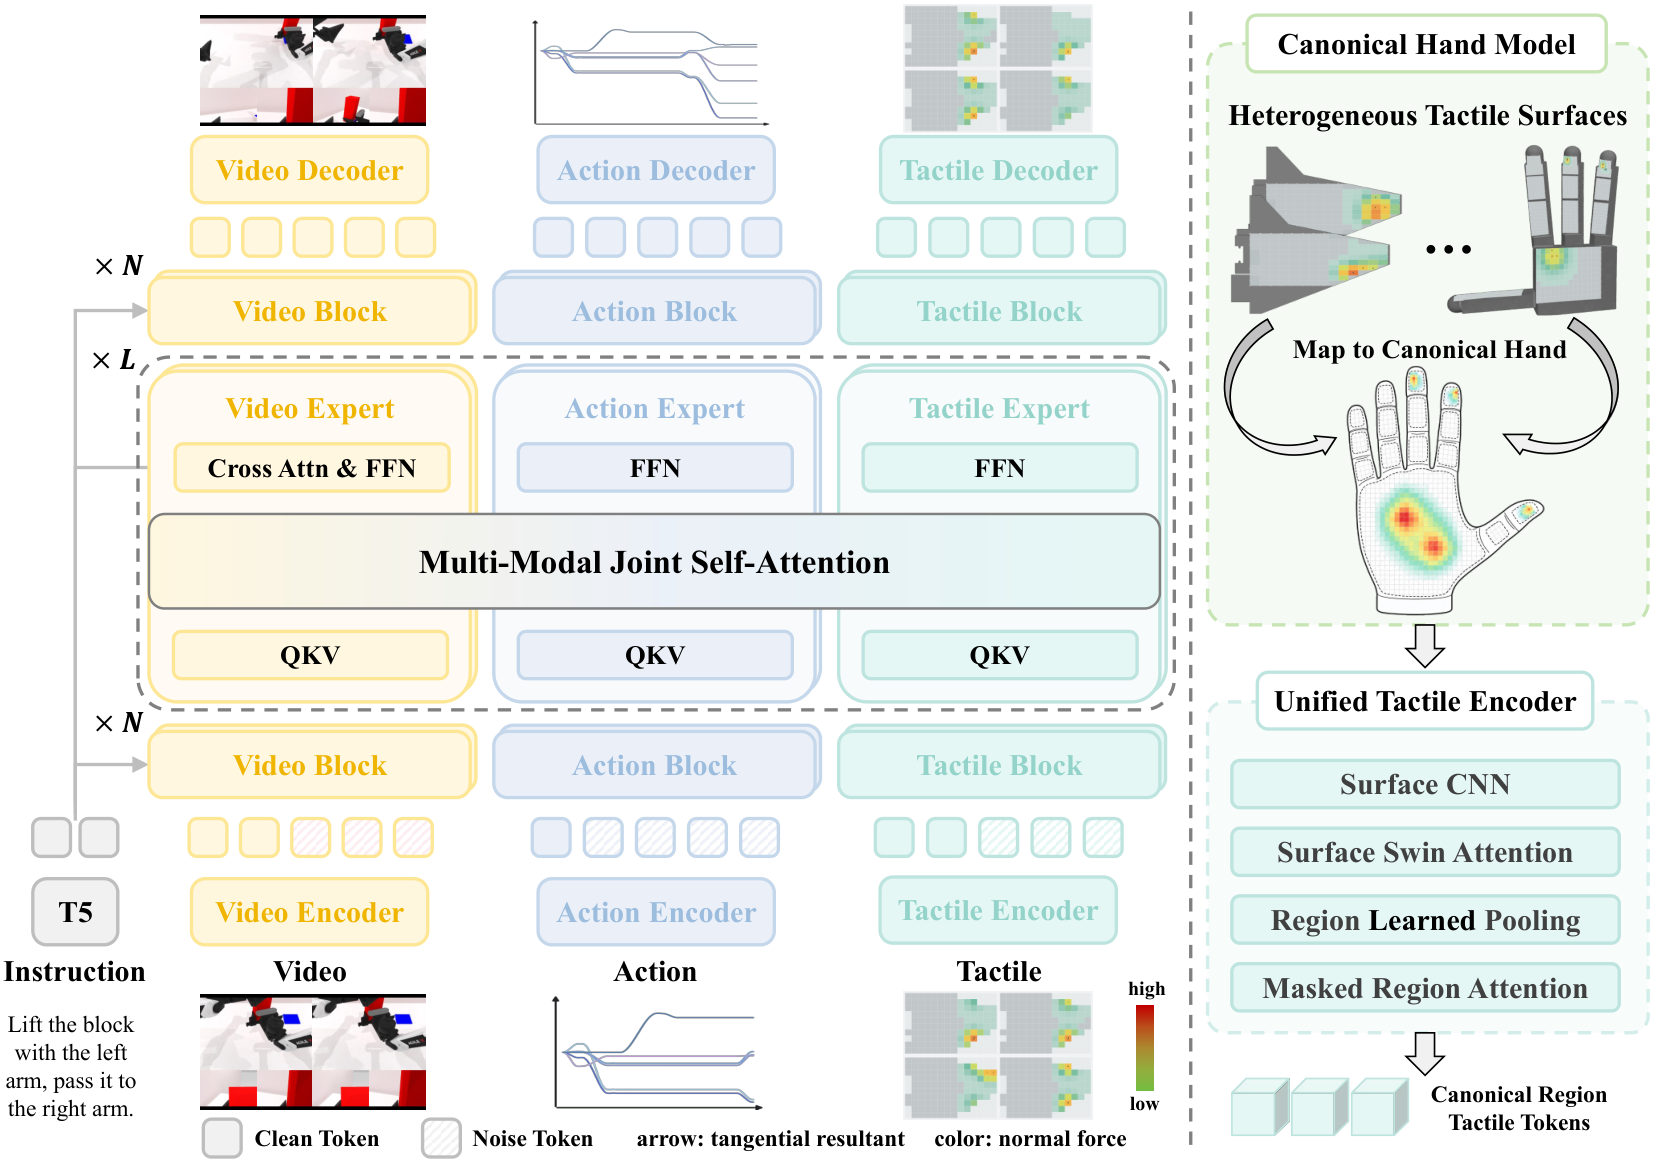
三路全部采用条件流匹配训练。每一路单独采样噪声等级,给干净的未来目标叠加对应噪声,再让模型预测从噪声指向目标的向量。视频与动作分支使用均方误差;触觉分支使用加权平方误差,对触觉特征变化幅度更大的帧分配更高权重。三份损失加权求和,统一反向传播更新参数。
推理阶段,未来画面特征、未来触觉特征与动作全部从高斯噪声起步,共同从噪声等级 1 迭代至 0;共享层在每一步迭代中交换信息。动作模块作为控制输出,冻结的视觉、触觉解码器可还原出对应的预测画面与力场。
04 三个平台上的成绩
评测结果来自三个仿真平台与两套真机实验。评测指标为机器人完整跑完单条任务的执行成功率,判定标准沿用各平台官方规则;多任务实验均只使用单个训练种子。
DexJoCo 平台的性能差距最为突出。在 11 项任务的多任务训练设置下,ME-Dex 1.0 平均成功率 65.3%,DECO 为 56.4%,DECO.p 为 57.8%。其中五项双手任务,ME-Dex 1.0 平均成功率 48.8%,DECO、DECO.p 均为 39.6%。逐项来看,模型在装配、微波炉两项任务上优势最大:装配任务的基线模型成功率仅在 0 到 6.0% 区间,ME-Dex 1.0 达到 28.0%;微波炉任务从 DECO 的 64.0% 提升至 88.0%;解锁平板、河内塔任务分别取得 48.0%、32.0%,为同组最高。单臂任务中,抓水桶、夹钳子两项均达到 92.0%;夹钳子任务差距显著,DP-T 仅 6.0%,DECO.p 为 60.0%。
插入类任务是另一项重要观测维度。在 ManiFeel 的四项插入任务中,ME-Dex 1.0 平均成功率 70.0%,相比官方基线 55.0%,提升 15.0 个百分点。插电源插头任务成功率从 58.0% 上涨至 88.0%,插销、USB 插入任务各自提升 18.0 个百分点。四项任务分别独立训练策略,每项任务使用 50 条演示样本、50 次评测。
在 RoboTwin 平台,采用 Clean 与 Random 混合数据训练时,ME-Dex 1.0 在 Clean、Random 两个配置下分别取得 91.56%、91.92% 的成功率,高于 Fast-WAM 的 2.34、2.70 个百分点,也高于搭载触觉条件的 Fast-WAM+Tac 的 1.34、1.70 个百分点。团队在此设置下完成逐层消融实验:仅将当前触觉条件接入视觉动作模型,Random 任务成功率从 86.90% 提升至 89.54%;再加入未来触觉预测,上涨至 90.60%;最后将逐层联合注意力替换为中层共享注意力架构,达到 91.92%。这一组阶梯式增长证明,性能提升来自触觉监督与跨模态信息交换两者共同作用。
仅使用 2,500 条 Clean 演示样本训练时,ME-Dex 1.0 在 Clean 配置取得 89.6%、Random 配置 68.1%,均值 78.9%,优于表格内最强基线 OLA-Sem 的 71.3%。
真机实验中,团队将 Paxini PX6AX 传感器装入 LeRobot SO-101 夹爪,完成电源插头在两个插孔之间的转移操作;另一组实验采用 XR5-10-FS 机械臂搭配 Xynova Flex2 灵巧手,完成黄色罐子堆叠任务。两组真机实验仅做定性验证,用于确认模型可以依靠视觉、触觉观测完成实体操作。研究还单独对触觉表征模块开展测试,共享自编码器在 RoboTwin、DexJoCo、ManiFeel 三类触觉数据集上,接触判断 F1 分数分别为 96.56%、90.05%、99.69%;接触发生与松开状态切换的转移 F1 分数分别为 89.73%、68.73%、66.96%。
05 写在最后
ME-Dex 1.0 最核心的改动,是重新定义触觉在模型链路里的位置。触觉不再只是输入端的条件信号,而是和图像并列的预测目标。动作生成模块在每一轮去噪过程中,都能够读取未来接触状态的预估结果。这一改动,把触觉的使用逻辑从「读取当下受力」升级为「预测后续多帧接触变化」。
对于灵巧操作领域,这套方案提供了可复用的技术接口。依托手部模板加上共享自编码器,夹爪、灵巧手的异构触觉信息可以统一转化为同一套区域特征;触觉数据还能够在仿真环境中通过轨迹回放自动生成。接触密集型双手任务、插入类任务最先显现收益,ME-Dex 1.0 在这两类任务上,相比基线拉开了明显差距。