
清华赵行团队与北大刘珂团队发布 SkelWAM,用骨架让策略零样本跨十种机械臂
SkelWAM 实现了在一台机器人上训练好的操作策略,可以直接部署到其他不同结构的机器人身上。研究团队设计了一套统一手臂骨架的公共几何表征。模型接收视觉画面,读取本体状态,预测后续动作,全部基于这套表征。策略只在 Franka 上训练,迁移到十种从未见过的机器人时,模型权重完全不用改动。
9 月 18 日,北京大学先进制造与机器人学院、擎羽科技与清华大学交叉信息研究院团队发布论文《SkelWAM: A Skeleton-Guided World-Action Model for Zero-Shot Cross-Embodiment Manipulation》。论文共 5 位作者,Pengjun Niu 与 Yujia Xie 为共同第一作者,清华大学交叉信息研究院助理教授、MARS Lab 负责人赵行与北京大学先进制造与机器人学院助理教授刘珂为通讯作者。
世界动作模型把视频模型的预判能力引进动作生成,模型先预判未来画面变化,再据此输出动作。但把这类模型跨机器人迁移,会遇到双重障碍。视觉侧,新机器人外形、尺寸、成像几何全都不一样。动作侧,控制坐标、运动冗余度,还有同一个工具点位对应多种手臂姿态的特性,也各不相同。
过去处理视觉侧,多半是把源机器人的样子画进目标观测,或者训练时合成机器人外观与视角的变化;处理动作侧,多半把输出统一成末端位姿,再让目标机器人做一次反向运动学重定向。这套做法能对齐工具位姿,却管不到实现这个位姿的全身姿势。
团队给出的答案是一条 25 维的骨架状态,视觉观测、机器人状态、动作目标共享同一套表征。训练全程只用源机器人的示范数据。
01 控制接口随本体一起变
跨本体迁移的核心难点在控制接口上。同样让夹爪抵达同一个空间点,6 自由度机械臂和 7 自由度机械臂输出的关节角度完全不同;带冗余自由度的机械臂,甚至可以保持工具不动,单独调整手臂整体姿势。如果换成擎羽科技 A03 这种绳驱柔性臂,控制输出直接变成曲率参数,和刚性臂的关节角完全不是一套东西。
团队把跨本体的差异拆成两处缺口。视觉一侧,外观、身形与相机里可见的几何随本体改变,同一个杯子在两种机器人的相机里是两种画面。动作一侧,控制坐标、冗余度与可实现工具位姿的全身配置也随本体改变。两处缺口同时存在,只补一侧不管用。
现有方法大多只解决其中一侧。Mirage 会在目标画面里渲染源机器人本体。RoVi-Aug 通过数据扩充,在训练时合成多样的机器人外观与视角,二者都聚焦视觉。动作侧常用方案是统一输出末端位姿,再交由目标机器人做逆解,或是学习跨本体动作隐空间。它们可以识别画面,让夹爪抵达目标位置,但手臂整体姿态交给目标控制器自行求解。
SkelWAM 的思路,是让观测和动作共用同一套骨架表征。工具末端位姿和整条手臂的姿态,由同一套数据流描述。源机器人训练好的模型迁移到新设备,只替换标定参数和运动学解算器。目标机器人只提供几何标定、相机参数和运动学控制器。模型训练、策略学习全部在源机器人上完成,目标侧不使用任何示范样本。
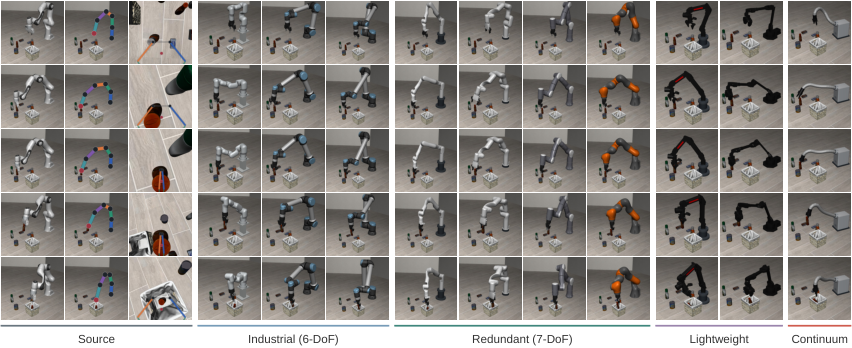
团队在 10 台目标机器人上做验证,9 台刚性机械臂,覆盖 6 自由度、7 自由度、轻量化机型,再加 1 台绳驱柔性臂。测试沿用 LIBERO 基准里的物体、语言指令、重置条件与成功判定,指标是完整跑完一条任务的成功率。
02 一套骨架写清姿态
SkelWAM 的核心是一段固定长度的数值,团队将其命名为骨架状态,总共 25 维。研究人员沿手臂中心线,从基座到工具中心点完成六次采样,最后一个采样点落在工具中心点。系统取前五个采样点相对末点的偏移量,再用采样得到的中心线长度做归一化,这十五维用来描述手臂构型。剩下十维承载任务相关信息,三维代表工具中心点在任务坐标系内的位置,六维是工具朝向的连续旋转表达,还有一维对应夹爪指令,数值为正代表张开,数值为负代表闭合。
身体偏移量会依据中心线长度归一化,把手臂姿势和本体总长、全局位置解耦。六自由度臂和七自由度臂,就可以转化为同一套数值描述。两套归一化逻辑相互独立,身体偏移以采样中心线长度为基准,工具位置映射到任务坐标系。之后基于源数据拟合一组逐维归一化参数,训练完成后参数固定,部署到目标机器人时不再改动。
模型接收的视觉画面,同样由这套几何结构生成。团队抹去原图里原有机器人的像素,补全背景,再将骨架投影回图像。外部视角绘制六个采样点连成的中心线,让模型感知手臂在工作空间中的走向。腕部视角依托绑定在工具坐标系上的相机,渲染透视平行夹爪轮廓,方便模型观察工具周边物体几何和夹爪状态。外部视角保留场景全局信息,腕部视角聚焦工具附近区域,两种视图都由同一套骨架定义,视觉信息和动作目标在时间轴上保持对齐。
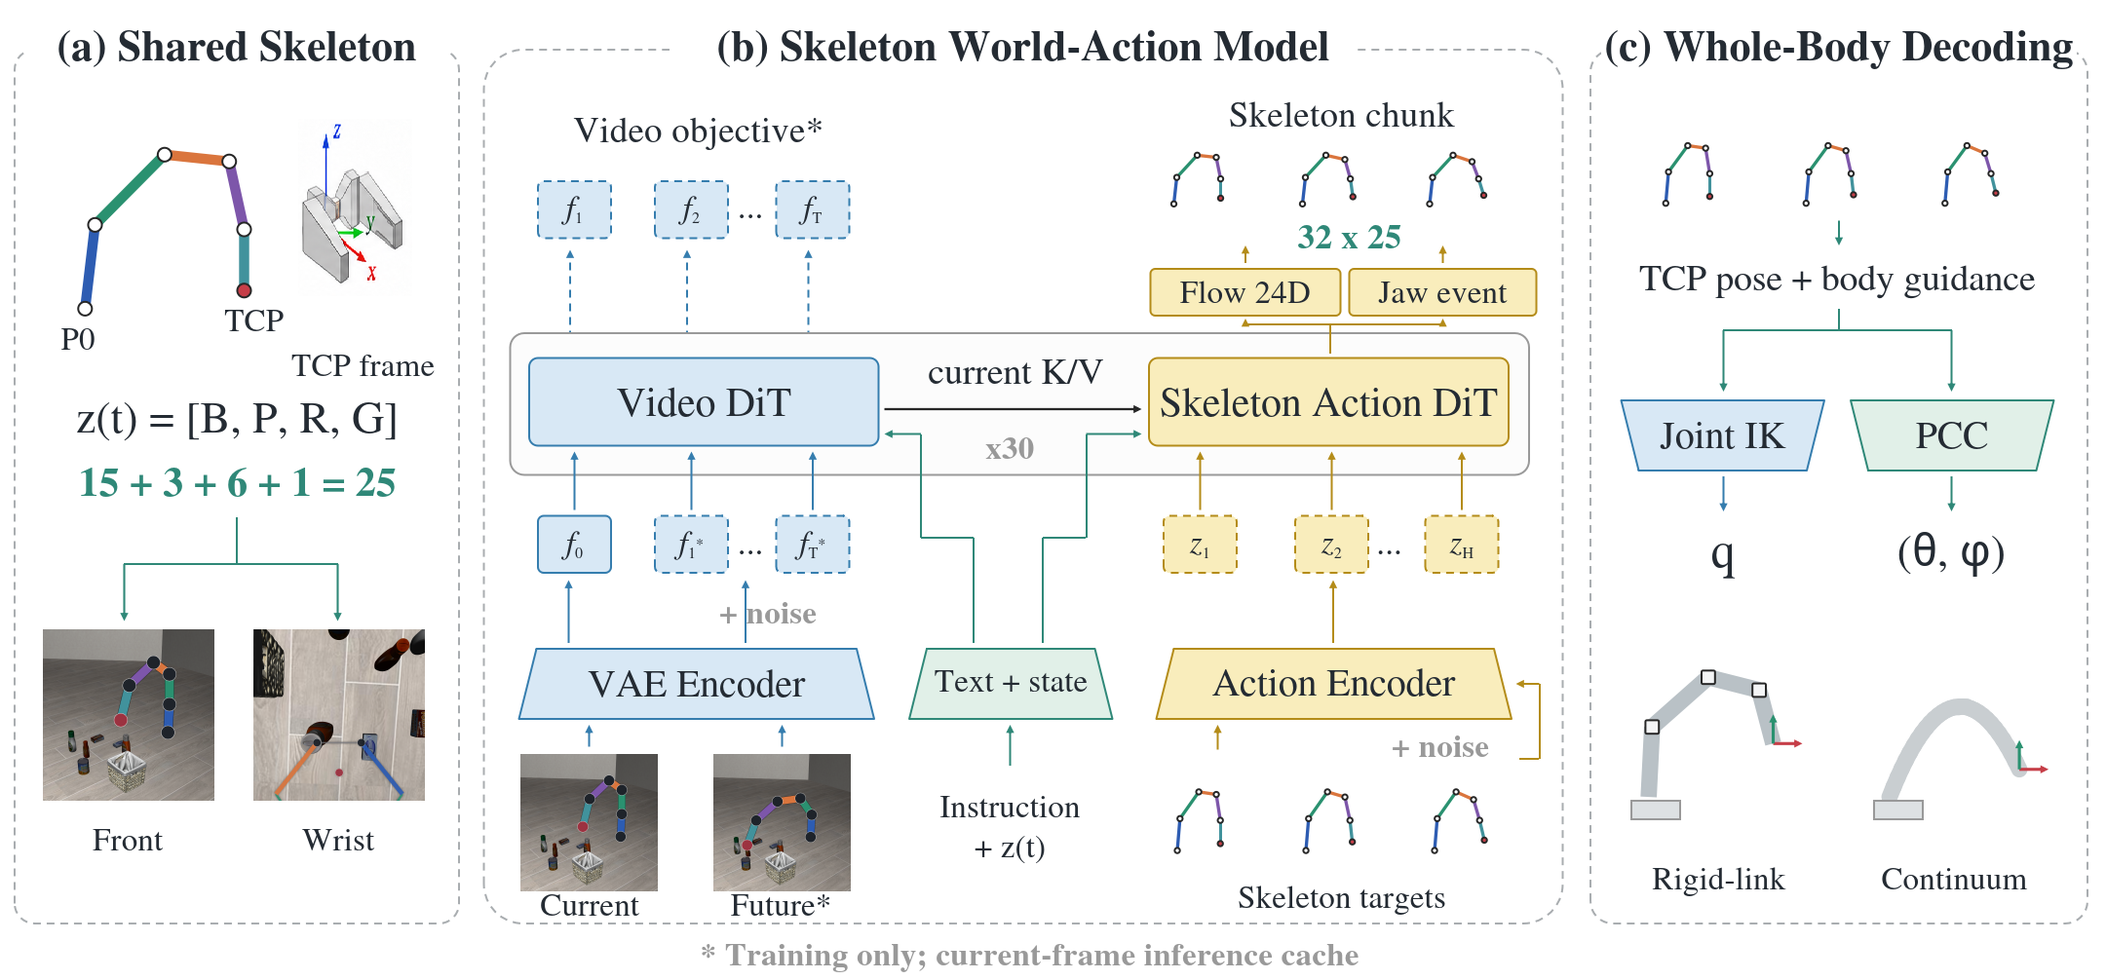
策略输出仅为骨架层面的动作意图,真实执行交由各个目标机器人自带的解算器处理。解算器优先保证工具位姿和夹爪指令满足要求,骨架中心线只作为软性姿态约束。目标函数由四项加权偏移项,叠加一步相邻时序连续性项构成,并不强制中心线每个采样点严格匹配。刚性机械臂采用带约束的关节逆运动学求解,绳驱柔性臂则使用分段常曲率参数。仿真环境内开始解算前,会先做尺度对齐,按照目标机器人的采样中心线长度,重新缩放身体偏移,再叠加任务坐标系里的工具位置。
状态变量中还融入交互反馈。仿真桥在没有预先给定意图的情况下,从实测几何信息启动计算。刚性臂保留上一帧的身体意图,依靠实测得到的工具位置、朝向以及夹爪指令更新下一帧状态。柔性臂同时保留身体构型和交互朝向的意图,只更新实测工具位置与夹爪反馈。解算器求取可行解时,使用的是目标机器人实时测得的构型。整套控制采用滚动时域方案,执行一段动作之后,利用新获取的观测结果重新规划。
03 视频与动作两位专家
模型主体包含两个独立专家模块,各有 30 层,分别负责视频和动作。二者都基于扩散 Transformer 模块搭建,权重从 Wan2.2 的视频骨干初始化。25 维状态编码器、动作输入输出投影层和夹爪事件头为全新初始化,仅使用源机器人的示范样本完成训练。
在每个配对模块内部,动作查询只会读取当前帧视频的键值和其余动作标记,未来帧的视频标记不会参与动作注意力计算。训练阶段,视频支路提供预测监督,视频专家学习推演后续画面变化,场景里的动态信息由此融入动作学习。进入推理阶段,这条视频支路不再参与生成流程。推理时模型只对当前观测编码一次,缓存当前帧视频键值,动作专家采样时可以直接复用缓存内容。
训练分为两个阶段,全程只用源机器人数据。
第一阶段进行 6k 轮更新,联合训练视频专家末尾四个模块、视频输出头以及动作专家,优化目标是未来画面预测损失加权,搭配 25 维骨架动作损失。
第二阶段冻结视频专家参数,使用 24k 轮更新单独训练动作通路。连续的 24 维几何量采用流匹配方式优化。夹爪开合交由因子化事件头处理,模块预测当前步是否出现状态切换,以及首次切换发生的时间。把夹爪事件从连续几何变量里拆分出来,开合这种离散语义就不会被平滑处理掩盖。
推理过程中,模型通过 20 步流匹配一次性输出 32 步绝对骨架状态。每个动作块最多允许一次夹爪切换,超出次数的切换放到下一轮规划。模型执行前 10 步动作之后,会重新采集观测、生成新的动作块,以此形成闭环控制。
04 十种机器人上的成绩
团队基于原有 LIBERO 任务体系,搭建了全新的跨机器人评测基准 LIBERO-Cross10。这套基准完整保留原有场景物体、语言指令、重置规则与任务成功判定标准,仅替换机器人本体、夹爪结构、安装方式与相机配置,形成十组差异化测试环境。整体包含十项固定任务,覆盖空间交互、物体操作、定点目标、长程执行四大任务子集,其中空间、物体类任务各三项,定点、长程类任务各两项。
测试选用十种差异化机器人,覆盖行业主流机型与新型结构。其中九款为刚性机械臂,细分三大品类,工业臂包含 JAKA mini2、UR5e、UR10e,高冗余臂包含 Kinova Gen3、xArm7、Rizon4、IIWA,轻量化臂包含 ARX-L5、ViperX300,最后一款为擎羽科技 A03 绳驱柔性臂,实现刚性与柔性机器人的全覆盖测试。实验基于 MuJoCo 与 robosuite 仿真环境开展,每款机器人完成 100 轮测试,十种设备累计完成一千个测试回合,数据样本充足且均衡。
模型训练全程仅依赖单一源设备数据,仅使用 Franka 机械臂在十项任务中完成的 467 条成功示范。数据集按回合拆分,其中 447 条用于训练,20 条用于验证。单条训练窗口包含两组 224×224 标准视角图像、语言指令、实时 25 维骨架状态与未来 32 步动作状态。训练分为两个阶段,首轮完成 6k 次参数更新,次轮完成 24k 次参数更新。模型筛选仅依托 Franka 验证集表现,最终选用第二阶段 23k 步的权重模型参与评测。
本次实验对比了四类主流机器人算法,覆盖当下主流技术路线。包含 Diffusion Policy 经典模仿学习算法,π0.5、OpenVLA-OFT 视觉语言动作模型,Fast-WAM、LaWAM 世界动作模型,以及 Mirage、RoVi-Aug 跨本体视觉适配方案。其中视觉适配方法均基于 Fast-WAM 搭建底层策略,所有对比算法统一接入目标机器人末端逆运动学求解模块,遵循相同测试协议与初始状态标准,仅保留各自原生的图像处理与动作输出逻辑,且全部无法使用骨架图像、中心线状态与身体姿态监督信息。
千轮测试结果显示,SkelWAM 平均任务成功率达到 43.3%,95% 威尔逊置信区间稳定在 40.3% 至 46.4%。所有基线模型中,效果最优的是搭载末端逆运动学的 RoVi-Aug,平均成功率仅 7.1%,SkelWAM 整体领先基线 36.2 个百分点。细分机型表现来看,SkelWAM 在十款机器人中九款取得最优成绩,UR10e、Rizon4 成功率均为 62.0%,JAKA mini2、擎羽科技 A03 成功率均为 59.0%,ARX-L5 为 56.0%,Kinova Gen3 为 49.0%,ViperX300 为 32.0%,IIWA 为 22.0%,xArm7 为 19.0%。仅 UR5e 机型被基线小幅反超,RoVi-Aug 成功率 15.0%,略高于 SkelWAM 的 13.0%。
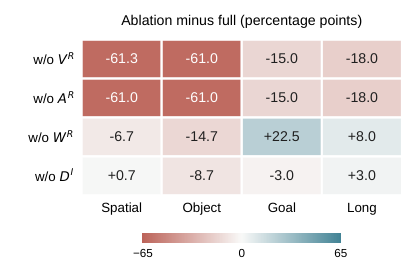
模型表现随任务类型、机器人品类呈现明显差异。任务维度上,空间交互、物体操作类简单任务表现突出,成功率分别为 61.3%、61.0%,定点目标、长程连续执行类复杂任务难度更高,成功率回落至 15.0%、18.0%。机型维度上,工业臂平均成功率 44.7%,轻量化臂平均 44.0%,高冗余臂平均 38.0%,擎羽 A03 柔性臂单机型成功率达 59.0%。其中高冗余七自由度机械臂个体差异极大,成功率区间覆盖 19.0% 至 62.0%。
多组消融实验精准验证了核心模块的必要性。完全替换骨架视觉、改用源机器人原生彩色图像训练,模型成功率直接归零。移除十五维身体姿态监督,仅保留末端目标约束与解算器,成功率仅 0.1%,足以证明骨架视觉与全身姿态监督是模型能力的核心支柱。单独移除腕部视角,整体成功率仅下降 0.3 个百分点,但不同任务表现波动极大,四类任务增减幅度从 -6.7、-14.7 到 +22.5、+8.0 不等,适配场景具有明显差异化特征。移除解算器身体约束项、保留完整模型权重,整体成功率下降 2.4 个百分点,物体操作任务降幅达 8.7 个百分点,长程任务反而提升 3.0 个百分点,说明身体约束对不同任务的适配性各不相同。
真机测试进一步验证跨本体迁移可行性,实验更换了完全不同的训练与部署设备。团队采集 277 条 JAKA mini2 刚性机械臂遥操作数据,拆分出 249 条训练样本、28 条验证样本,构建 10 Hz 频率的骨架训练窗口。仅微调动作专家与视频专家最后两层网络,完成 6k 次参数更新,模型筛选仅参考源设备验证效果。训练完成后全程冻结模型权重,直接部署至结构完全不同的擎羽科技 A03 绳驱柔性臂,开展玩具收纳、套环、插销三项桌面实操任务。目标设备仅更换标定参数与曲率解算器,全程无需采集 A03 设备的任何示范数据。
真机测试的视觉跟踪依靠传统视觉算法实现。团队结合静态区域特征匹配与 RANSAC 算法,搭配前后向 Lucas-Kanade 光流计算,辅以颜色阈值锁定工具关键点,有效解决画面遮挡、骨架点漂移等跟踪问题。通过任务坐标系、工具结构与相机的精准标定,实现数值化骨架信息与双视角相机画面的精准对齐,工具中心点统一规范为夹爪接触中心。
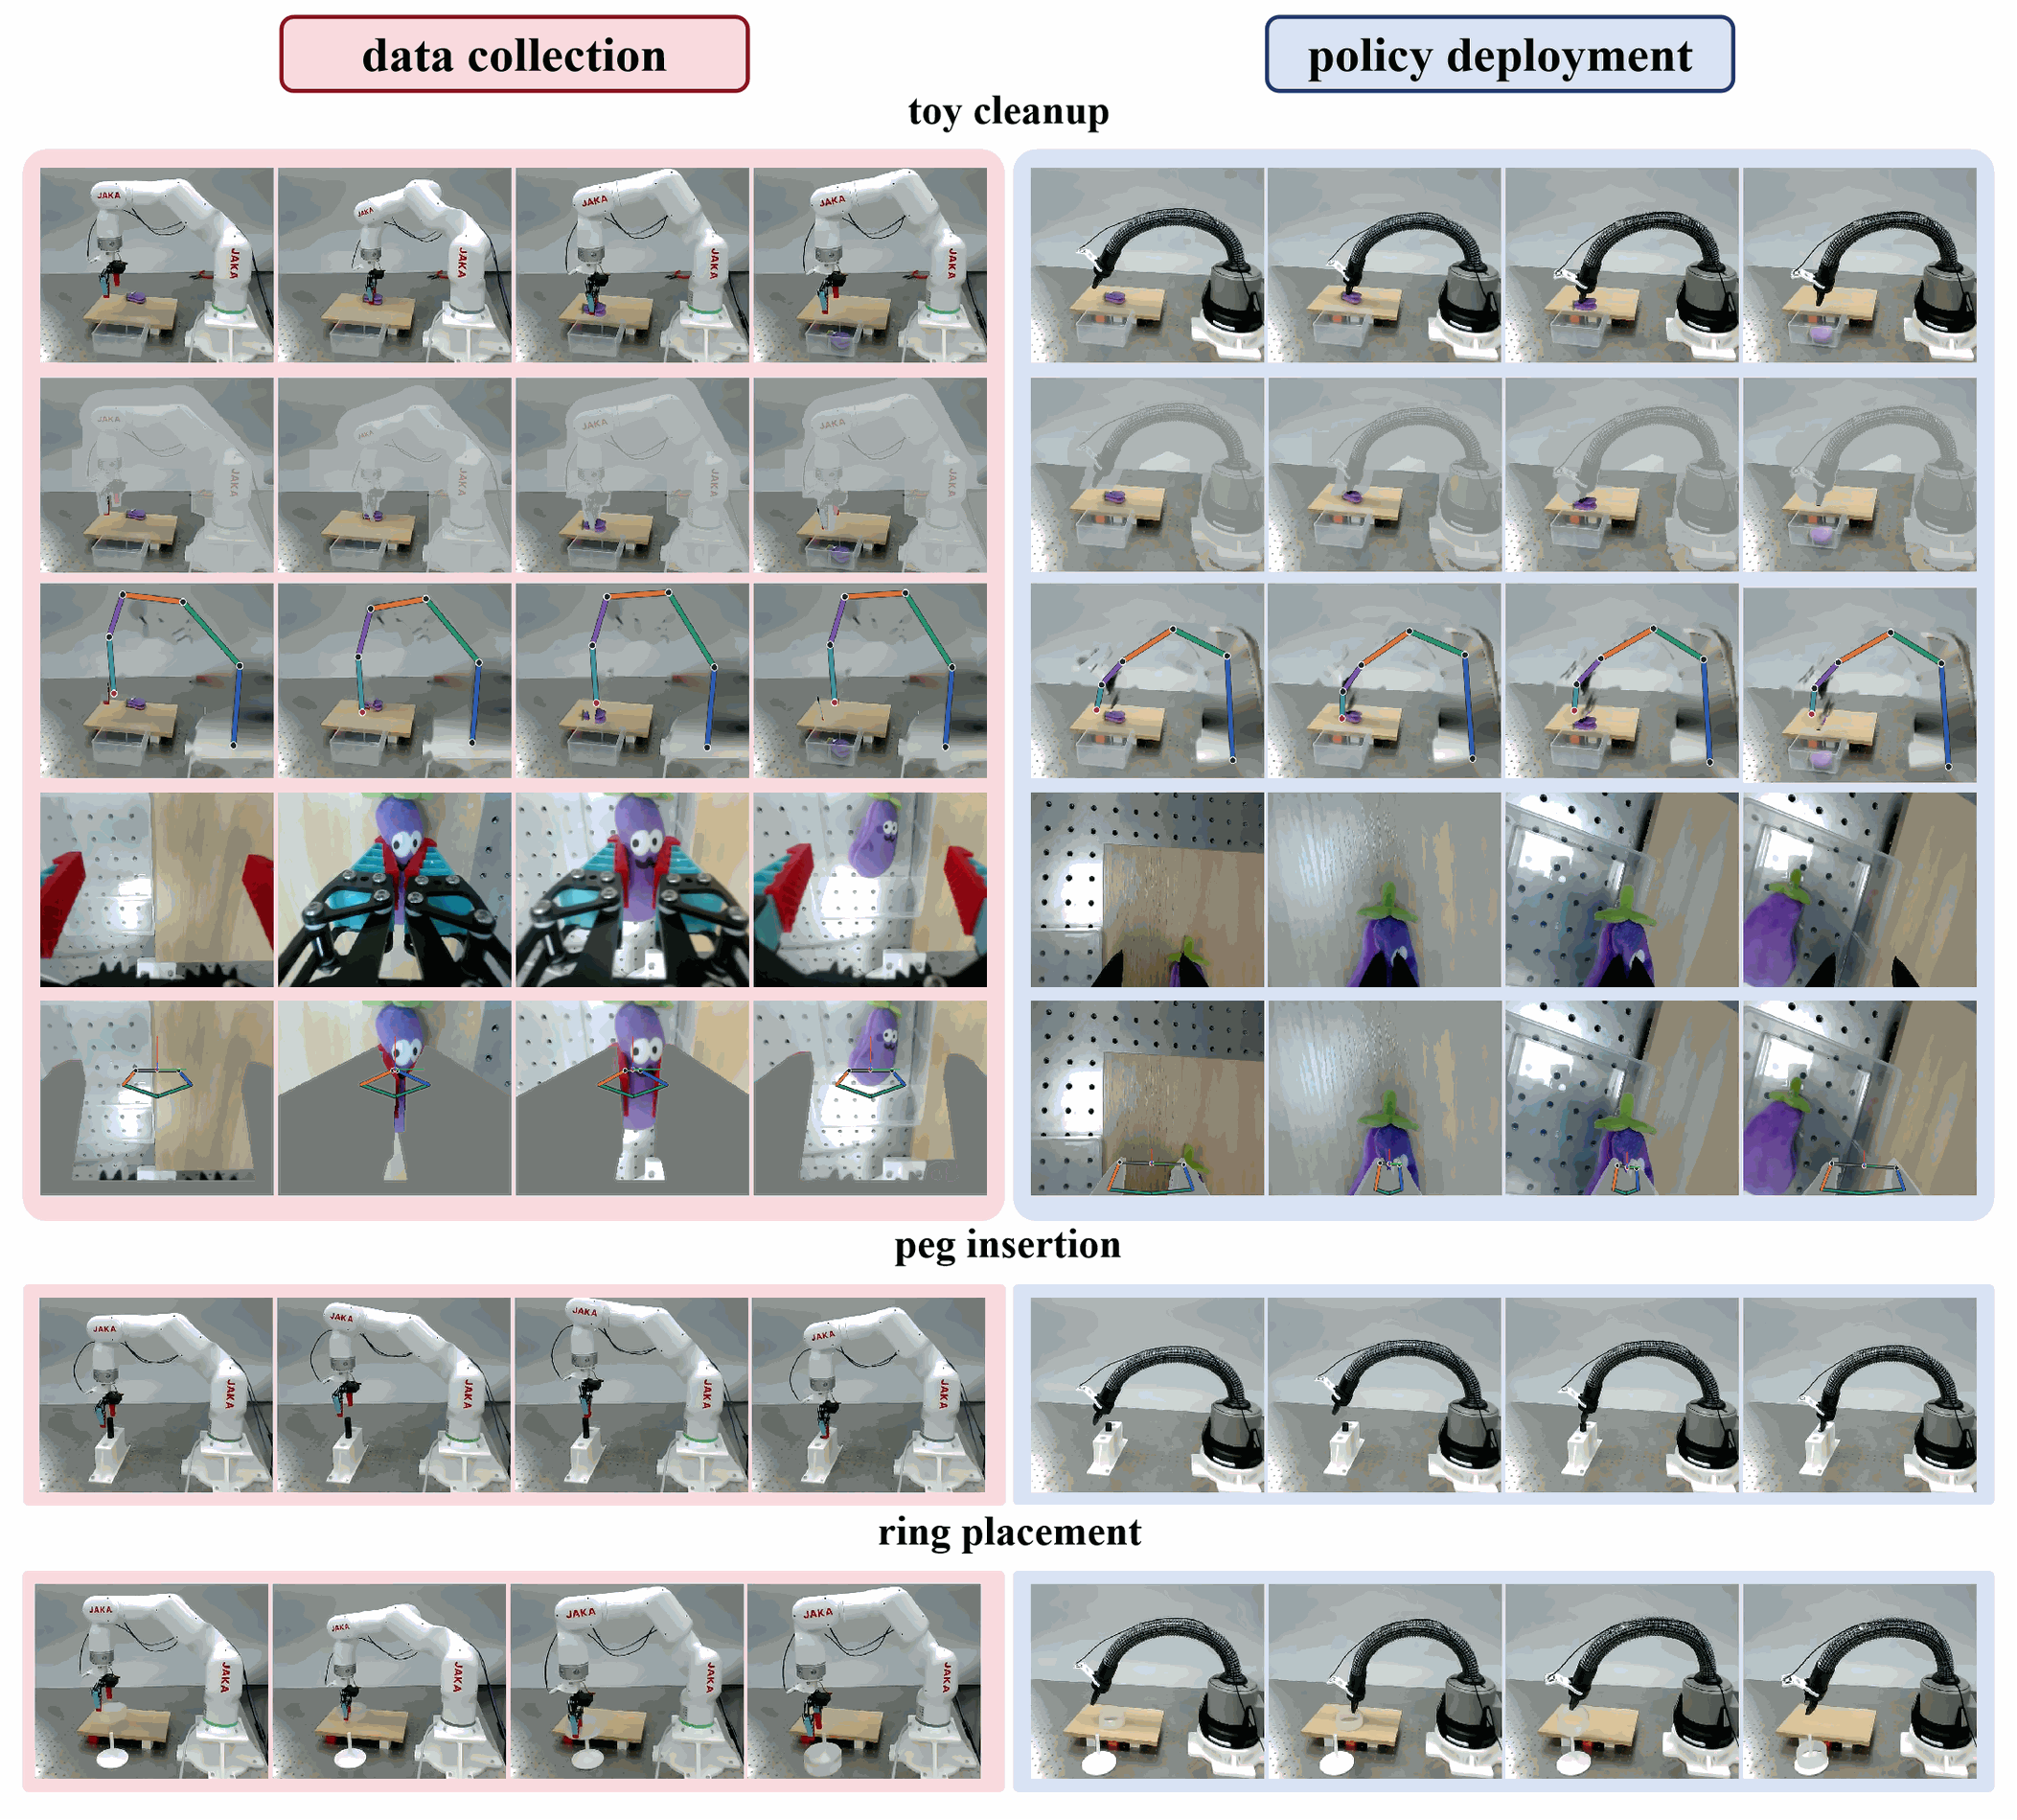
该部分真机实验仅做定性验证,核心目的是证明刚性臂训练的策略,可无损迁移至结构差异极大的绳驱柔性臂并稳定执行任务,团队未统计真机量化成功率。
05 写在最后
这项工作的核心突破,是将机器人视觉观测、本体状态、动作预测全部统一至同一套骨架几何表征。观测信息依托骨架生成,设备状态依托骨架定义,动作目标依托骨架输出。彻底摆脱了传统跨本体迁移对关节结构一一对应的硬性要求,全新机器人无需重复采集数据,也无需重新训练模型,真正实现零样本迁移部署。
对于具身智能领域而言,这套方案提供了通用可复用的技术接口。模型仅需在单一 Franka 机械臂上完成训练,就能在十种未知机器人上取得最优级别仿真成绩。真机场景中,刚性臂训练的策略可直接适配柔性臂,跨设备部署仅需替换标定参数与运动学解算器。机器人本体类型越多、场景越丰富,这套公共骨架表征能节省的数据采集、模型迭代成本就越高,为通用机器人智能策略落地提供了高效可行的新路径。