
对话 Shallow-π 作者:压缩 Transformer 层级,具身模型竟做得更好?
一个圆柱、一块正在转动的孔板,足以让两种机器人模型拉开差距。
在 Shallow-π 的真实机器人实验中,任务要求机械臂拿起圆柱,插入移动中的小孔。层数更多的大模型,可能在等待计算结果的过程中错过位置;一个层数更少、输出接近它的小模型,却能更快地根据新画面调整动作。
这项由 Boseong Jeon(全普成)、Yunho Choi 和 Taehan Kim 合作完成、署名单位为三星研究院的工作,提出了一套面向基于流的视觉—语言—动作模型(VLA)的知识蒸馏方法。它把视觉语言主干和动作生成头的 Transformer 深度同时从 18 层缩减到 6 层,让较小的「学生」学习大型「教师」的动作生成能力。
在标准操作基准上,Shallow-π 实现了超过两倍的推理加速,成功率绝对降幅小于一个百分点。在 ALOHA 平台和 Jetson Orin 上,端到端真机部署的计算时间从 364 毫秒降至 110 毫秒;在插销入孔任务的 10 次测试中,教师完成 7 次,学生完成 10 次。对于安装灵巧手的 RB-Y1,团队也在 Jetson Thor 上验证了垃圾分类、开盖并放置圆柱等任务。
这些结果提出了一个问题:机器人模型的能力,究竟该如何扩展?当环境持续变化,离线评测中的动作质量与真机上的任务表现之间,还隔着一段计算时间。
围绕这个问题,一些研究者认为补全架构、扩大参数量,并通过更多的数据训练来 Scale Up,可能会使模型取得更好的泛化表现,也有研究者围绕模型的不同范式、基准,将「大脑」与「本体」之间的关系约束到紧凑的空间表示当中。
全普成团队的研究似乎另辟蹊径 —— 他们对 π 模型的 Transformer 层级进行了压缩。在标准操作基准上,Shallow-π 的推理速度提高至原来的 2 倍以上,成功率的绝对下降幅度小于 1 个百分点,在压缩后的 VLA 模型中取得了当前最优的表现。
为什么要对模型进行压缩?IROS 大会现场,42 号电波采访到了该项研究的第一作者全普成,就 Shallow-π 的技术选择展开对话。
Boseong Jeon(全普成),Shallow-π 第一作者。2017 年获首尔大学机械与航空航天工程学士学位,2022 年获机器人学博士学位,师从 H. Jin Kim,随后加入三星研究院,开展世界模型研究。研究方向涵盖机器人运动规划、端侧生成式 AI、机器人基础模型与世界模型,重点探索通过知识蒸馏加速视觉—语言—动作(VLA)模型,推动其在边缘设备和真实机器人上的部署。
Yunho Choi,首尔大学电气与计算机工程学士,2024 年获该校博士学位,师从 Songhwai Oh。曾任 Sequor Robotics 人工智能机器人研究员,现任三星研究院机器人智能团队 Staff Engineer。研究方向聚焦基于视觉的机器人学习,尤其关注具身智能体决策与强化学习,面向人形机器人的视觉—语言—动作(VLA)模型等。
Taehan Kim,延世大学机械工程学士,2022 年至 2026 年在三星研究院担任机器人研究工程师,2026 年 8 月加入 Ludo Robotics,任人工智能与机器学习研究工程师。研究方向聚焦基于学习的机器人操作与人形机器人,涵盖 VLA 模型、模仿学习及强化学习微调,面向精细操作、双臂装配和人形控制,当前致力于构建支持人形机器人社交互动的基础模型。
关键在延迟
42号电波:能否先介绍一下您的学术背景?为什么后来选择研究 VLA?
全普成: 我最初的背景是传统机器人学,而不是人工智能或机器学习。博士课题主要是传统的运动规划方法,后来这个领域变化非常大。
在三星研究院,我开始研究扩散模型等生成模型,并参与将 AI 图像擦除功能应用到 Galaxy 智能手机中。我希望把这两方面的背景结合起来,研究基于机器学习的运动规划。我还希望让这类模型在设备上运行得更快,以支持更广泛的应用。这就是我选择研究 VLA 的原因。
42号电波:具体到 Shallow-π,是什么让您把研究重点放在「模型太慢」上?
全普成: 我认为,在边缘设备上部署人形机器人或其他机器人时,一个主要瓶颈就是推理太慢,无法实现实时运行。
42号电波:您如何判断问题确实出在延迟上?
全普成: 我们需要考虑摄像头画面的更新频率。例如,如果每秒收到 10 帧彩色图像,而运动规划的运行频率低得多,规划就无法反映最新的观察。这样,动作依据的就是较早的画面,表现自然会受到影响。
另外,如果计算很慢,机器人动作本身也会显得不自然:先动一下,再等下一个动作算出来,然后再动。它会走走停停,动作也不够流畅。这就是我希望降低推理延迟的原因。
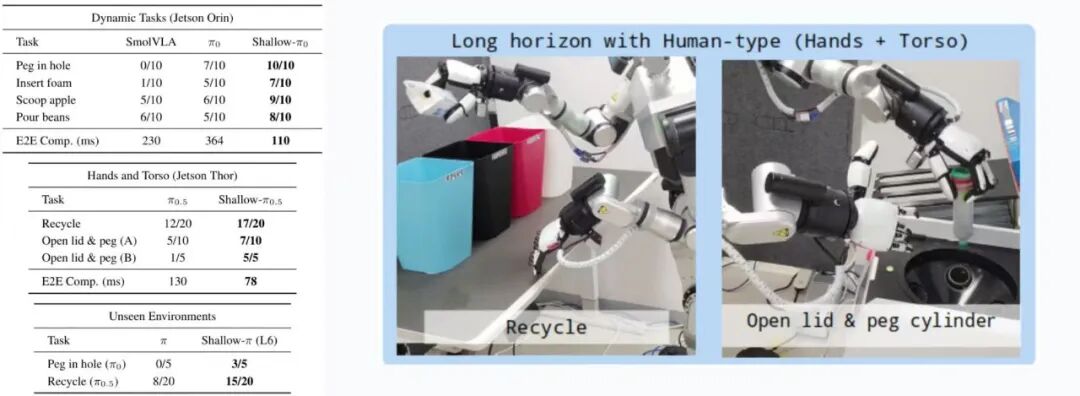
42号电波: 在 Jetson Orin 上,Shallow-π₀ 的端到端计算时间为 110 毫秒,教师 π₀ 为 364 毫秒;插销入孔由 7/10 提高到 10/10,舀取苹果由 6/10 提高到 9/10。垃圾分类由 12/20 提高到 17/20,计算时间由 130 毫秒降至 78 毫秒。 我们看到,在这些真实任务中,学生模型反而超过了老师。 这种提升有多少来自蒸馏后的动作质量,又有多少来自更快地处理观察信息?
全普成: 这个问题其实就是论文最想传达的观点。如果学生模型的输出与老师接近,同时运行得更快,那么部署到真实机器人上时,它就可能比老师表现得更好。
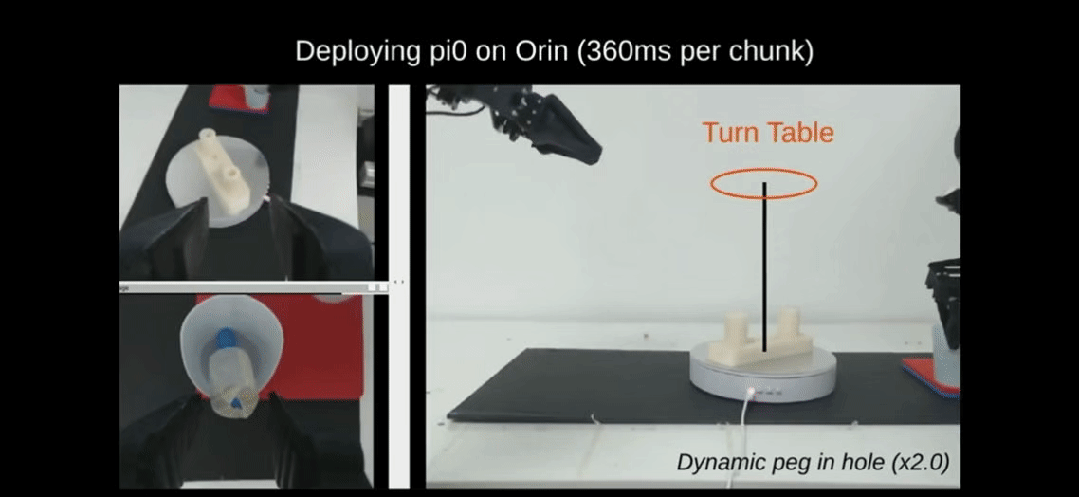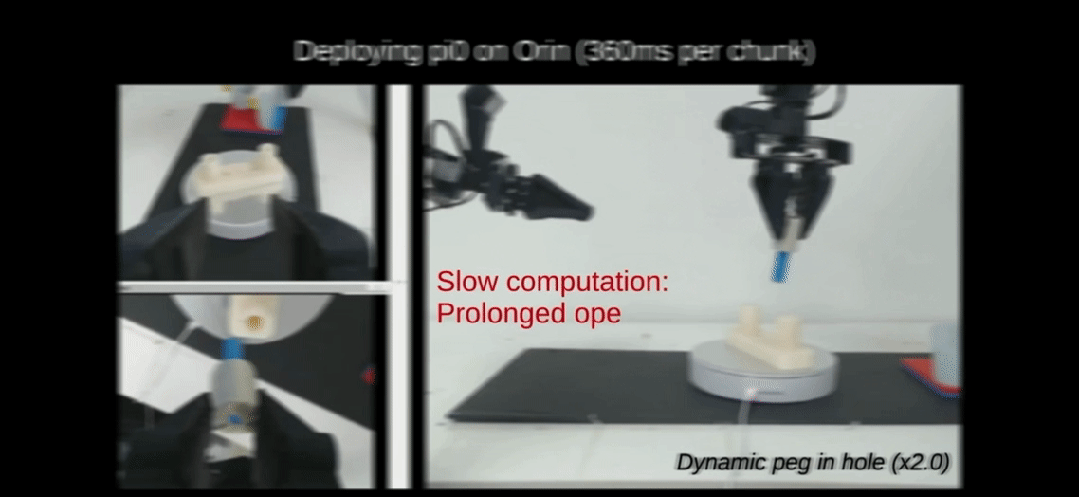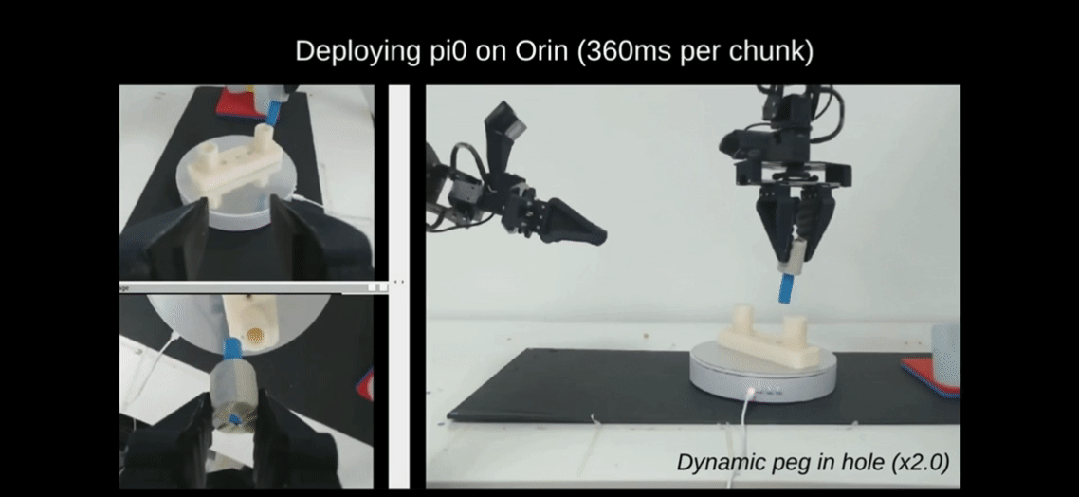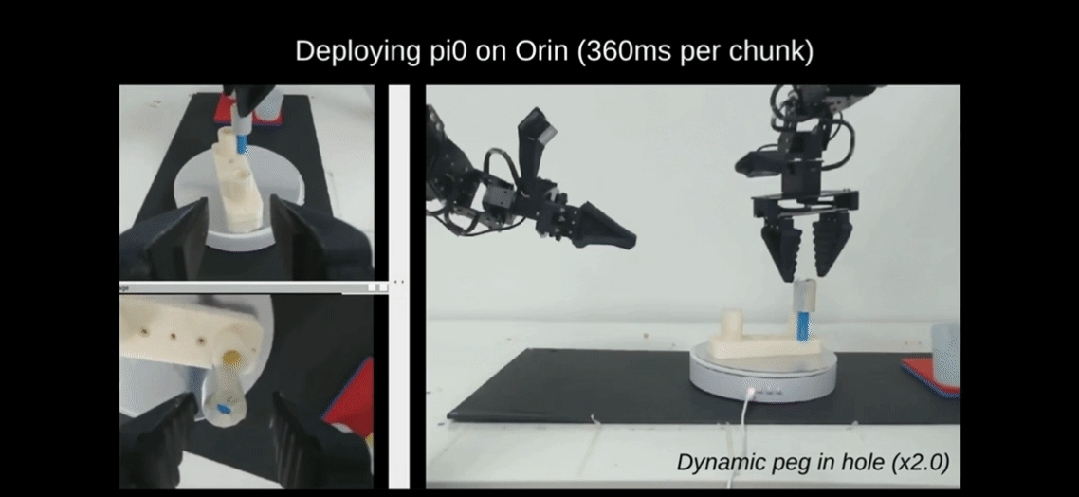
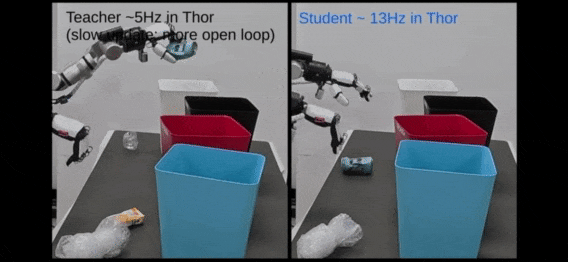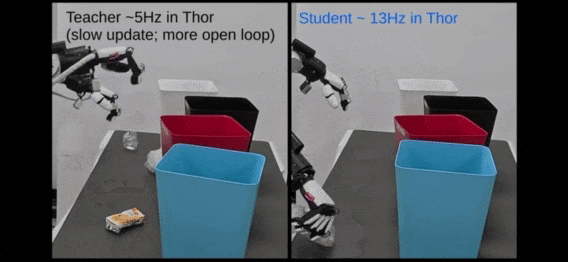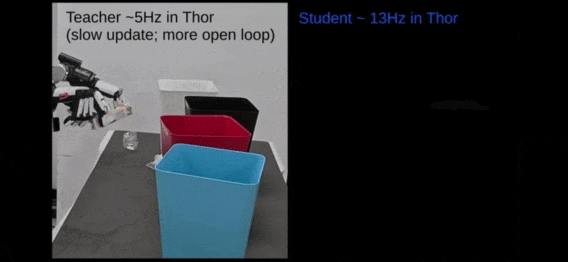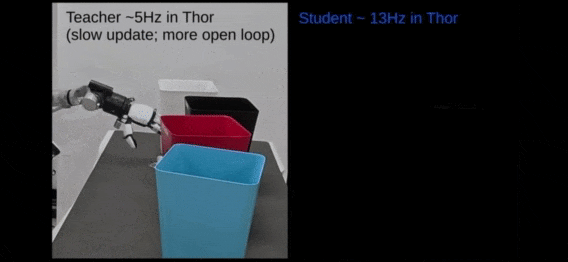
在这个动态场景中,有一个正在转动的转盘。这边的机器人用老师模型,那边用学生模型。老师计算动作花的时间更长,动作依据的是较早的观察。
因为速度较慢,它来不及更新动作所依据的观察,所以没能把圆柱插进去。相比之下,学生能够更快地依据新观察更新动作,所以表现比老师好。这是我主要想说明的事情。
执行一部分动作后,我们会请求新的一组动作。如果新轨迹与前一段差异很大,在两者之间做平滑处理时就可能出现问题。新的动作块到来时,我们需要把它和之前的动作块平滑地衔接,保证运动连续。但如果两段动作差异太大,平滑处理反而可能让结果变差。
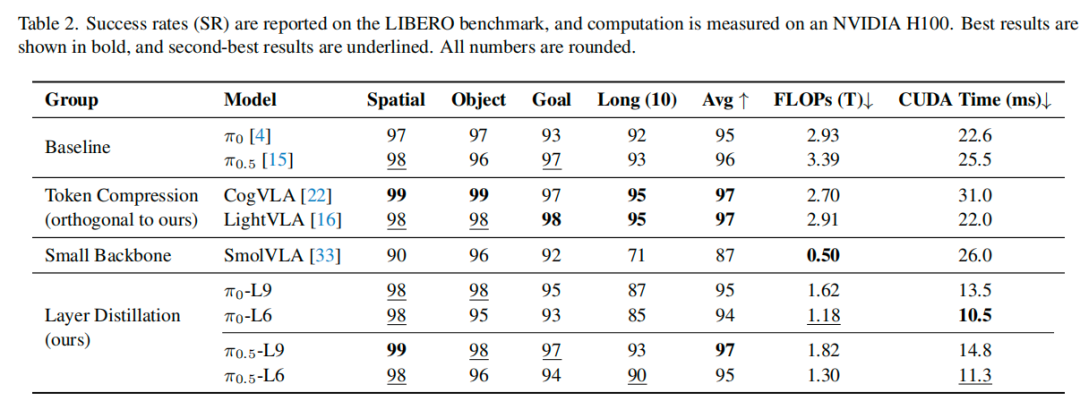
如果两段动作比较接近,效果会更好,而更快的推理能够更有利于这种情况。所以正如演示的那样,我认为,使用学生模型后,整体操作精度可以得到提高。
「压繁为简」
42号电波: 我们知道 VLM 负责处理图像与语言,动作头则利用这些信息生成机器人动作。π 模型的 Transformer 架构在各层之间传递条件信息,削减层数可能会影响模型性能,但你们还是选择把视觉语言主干和动作生成头都从 18 层压缩到 6 层。 这是个关键的选择,为什么要同时压缩这两部分?出于怎样的考虑?
全普成: 我们需要减少视觉语言模型的计算量。像 π 这样表现较好的 VLA 模型,有一种紧密连接的结构,即视觉语言模型和策略头在每一层都有连接。由于它们彼此连接,只从其中一部分删除层会比较别扭。
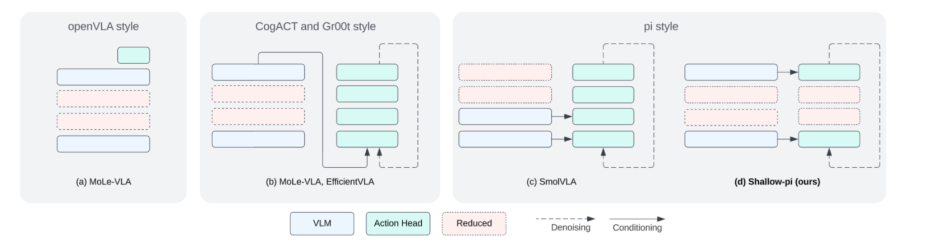
我们希望同步删除两部分的层,而不是只删其中一部分。有些其他算法只删除主干网络的上部,但那些层可能包含很有价值的信息,删除之后可能造成较大的信息损失。
这些连接本身也很重要。同步压缩两部分时,如果能够保留这种连接结构,表现可能会更好。所以我希望保留这种信息传递结构。
连接结构保留下来之后,还需要让浅层模型学会使用它。因此,论文的训练方案分为三部分:依据真实动作进行监督,让学生匹配教师预测的速度,以及让动作词元对视觉语言信息的中间层进行注意力的对齐。
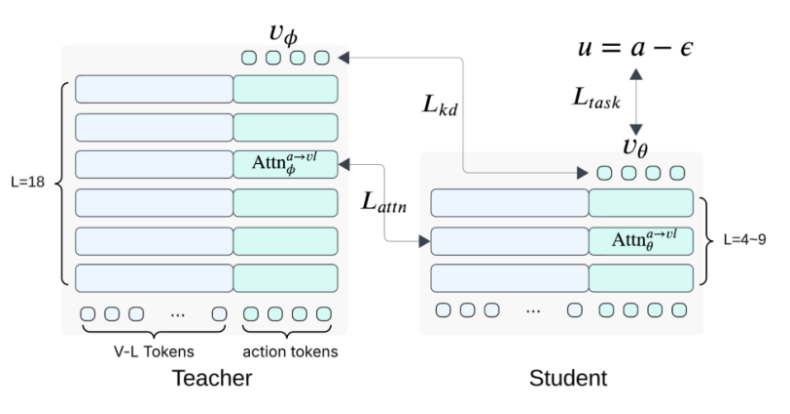
其中,注意力对齐只针对动作词元,并且放在中间层。对 6 层模型,仅使用任务损失时成功率为 93.0%;加入教师输出监督后为 93.9%;再加入注意力蒸馏后为 94.6%。这些结果为「保留信息传递」的设计提供了进一步证据。
42号电波:初始化学生模型时,你们为什么采用均匀选层?
全普成: 因为它简单,而且效果好。我也试过其他层初始化方法,比如根据特征相似度,以及其他论文提出的方法。那些方法的解释很精巧,但最后只要训练步数足够,结果就会变得接近。
用启发式规则挑选初始层,还会把事情搞复杂,不利于使用。
42号电波:不利于什么的使用?
全普成: 模型的易用性。我更倾向于简单的设计。我在企业工作,不倾向于过分复杂的方法。我希望无论使用者是什么背景,都能使用这个项目。这就是我的设计理念。
42号电波:这是否意味着原模型中有很多冗余层?
全普成: 对。我在论文中展示了跳过某一层之后成功率的下降情况。你可以看到,跳过有些层时,成功率完全没有下降。这说明存在冗余。我发现,层间相似性会随去噪时间变化,相似程度也不能可靠代表功能重要性。即使优先删除单层敏感性最低的层,随着删层数量增加,任务成功率仍会急剧下降。Shallow-π 的做法是先均匀抽取层来初始化学生,再通过训练恢复能力;并不是把 18 层直接裁成 6 层,就能得到相同结果。
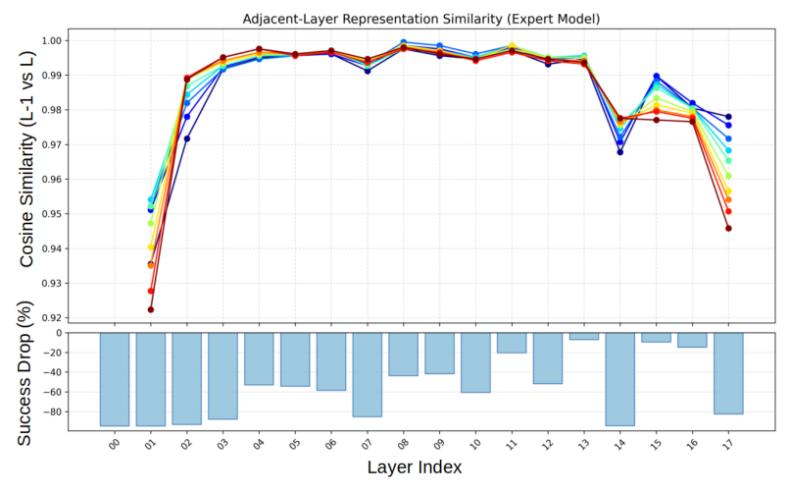
另外一些曲线展示了特征在不同 Transformer 层之间如何变化。在早期层,特征变化很明显;到了中间层,变化就不大了。这两类观察都提示存在冗余。
为什么会有冗余?我的猜测是,模型先在很大的数据集上预训练,之后却只用于一小组任务。因此,其中有些能力没有被充分使用,这是说得通的。
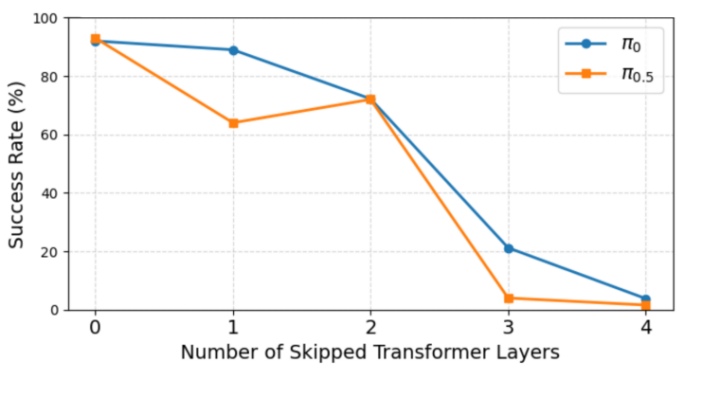
当然,「简单」也不等于跳过训练。在训练步数足够时,我们依据层敏感性挑选初始化层,但没有带来额外收益。所以省去没有显示出额外收益的选层复杂度后,我们就把后续的工作重心放到蒸馏上。
42号电波:你们为 ALOHA 和 RB-Y1 分别训练了教师与学生模型。对于希望统一不同机器人平台的模型,这套蒸馏方法是否也能使用?
全普成: 我认为这种蒸馏方法比较容易应用到那类情况,较新的模型正在尝试用一个模型统一不同机器人平台。我们的蒸馏方法并不对这种情况构成限制,我认为它能够扩展到那些模型上。
42号电波:如果继续减少层数、视觉词元、动作生成步数,并降低数值精度,把这些压缩手段结合起来,您认为哪种能力可能最先受影响?
全普成: 视觉理解。
在算力有限的小型边缘设备上部署时,学生模型最终的动作精度或闭环稳定性实际上可能更好。但对于小模型来说,视觉理解会比较困难。
谈到压缩的代价,全普成又把问题转向蒸馏能否保留教师模型的不同选择。他以一个包含两种可能结果的分布作解释。
全普成: 假设老师模型的分布有两个模式。蒸馏过程中,一种可能是学生只选择较大的那个模式。这样,学生就没有覆盖另一个模式。这是蒸馏的一个局限。
在我们的操作场景里,可选方案较少。相比图像或视频生成,蒸馏可能更容易奏效。图像和视频有很多可能的结果,例如让模型生成一张猫的图片,猫的外观可能有上百万种。
如果让夹爪拿住这个手机,它只需要把手机拿住,不一定非要用这种、那种或者另一种抓法。
训练成本同样没有消失。由于蒸馏时需要同时加载教师与学生,训练开销高于直接跳层的做法。未来的研究中,我们可能会选择性地冻结部分组件、筛选信息量更高的训练样本,并结合视觉词元与扩散步数压缩,继续提高推理效率。
走向真实世界
42号电波:随着大模型能力提升,机器人会不会走向分层系统,由大模型负责规划,小模型负责实时控制?
全普成: 这个讨论其实已经持续了几个月。核心是如何处理真实世界机器人部署的复杂性:我们应该更多依靠视觉语言模型、大语言模型,还是依靠 VLA 本身?
使用工具调用时,工具应该比较轻量。另一方面,大模型,比如世界—动作模型或者 VLA,也需要在边缘设备上运行。为了设备端应用,同样需要蒸馏。
进入工业应用后,我认为模型应该在设备上运行,而不是依赖云端。因此,不论走哪条路线,知识蒸馏在未来都会很有必要。
42号电波:您怎么看这项研究未来的应用前景?
全普成: 先开发一个大模型,再针对计算资源有限的客户,把它蒸馏成一个小模型,是很自然的流程。我认为机器人行业也可以提供这两种形式的产品。
42号电波:您的意思是,机器人也可以有两个版本,一个基于大模型,另一个基于小模型?
全普成: 没错。比如说 iPhone 就有 Pro 版,还有 Plus 这类其他版本,这套逻辑也可以套用在这上面。在我看来,这是迈向商业化的必然路径:先做大模型,再针对特定技能子集做轻量化调整,让它适配具体的应用场景。
42号电波:在我们看来,这项工作对于实际部署很有启发。在中国,行业越来越关心如何落地,而不只是模型本身。
全普成: 正如你说的,实际部署和仿真基准很不一样。在仿真里,环境步进可以等待动作生成,动作没有到来之前,环境不必继续往前走。但在真实世界中,新动作还没有生成时,机器人仍然需要继续执行动作。
这意味着它会处于开环执行状态,也就是根据较早的观察继续运行,可能导致表现变差。所以在真实世界中,我们需要更快地得到下一组动作。这对实际应用很重要。