
上海交通大学与蓝箭航天团队联合发布 DynaForge,让失败的演示变成能用的训练数据
DynaForge 让动态操作的演示不必再靠人手一条条去采集。机器人可在仿真环境自主试跑,从失败回合中学习修正量,把原本失败的轨迹转化为可供策略训练的有效演示。
9 月 22 日,上海交通大学自动化与感知学院联合蓝箭航天空间科技股份有限公司团队发布论文《DynaForge: Planning-Guided Residual Learning for Dynamic Manipulation Demonstration Generation》。论文共 4 位作者,Yiyang Jin 与 Yu Zheng 为共同第一作者,上海交通大学自动化与感知学院教授、博士生导师王贺升担任通讯作者。
动态操作是机器人落地无法回避的任务类型。物体可能滚动、滑移、旋转,机器人必须在极短时间窗口内完成感知、运动与接触的协同。现有的大规模数据集和自动化演示管线,大多面向静止或准静止场景,能够体现机器人与运动物体交互的演示样本仍然稀缺,模仿学习、视觉语言动作模型很难获取充足的动态交互数据。人工遥操作很难在短暂的接触窗口稳定完成操作,采集成本高昂;从真人视频做动作重定向,又会遇到本体形态差异、接触时序无法对齐等问题。近年一些自动化方案依靠状态机、目标更新、轨迹重建适配动态场景,虽然能借助规划、重定向提供几何层面指引,但执行端的修正无法从多次失败中自主学习,在接触边界这个关键位置短板突出。团队将运动规划作为结构化先验,由规划负责全局运动构建,学习模块承担执行层面的修正,基于这一分解思路提出 DynaForge。
01 接触边界决定成败
接触边界,正是动态操作最容易失效的环节。运动规划能够求解一条无碰撞的全局路径,却很难判断物体滚动到特定位置时,机械臂应当提前或是延后闭合夹爪。物体持续运动,有效的接触时机窗口极窄,规划在这个时段出现微小偏差,就会造成整条任务轨迹失败。
还有一类方案,强制机器人动作对齐预设好的物体运动轨迹,对接触动力学做简化处理。任务虽然可以跑完,但机器人并不会根据物体的实时运动动态调整动作,生成的经验样本对策略训练参考价值有限。
团队将问题拆分为两层。全局无碰撞运动交由运动规划处理;接触附近、需要实时响应的环节,则依靠学习得到的残差做修正。整个任务按相位切分,每个相位都对应物体坐标系下的目标、成功判定条件、控制模式以及残差开关。
研究设置九项仿真任务,涵盖动态抓取、接取、点击、放置、插入,包含滚动物体、移动容器、旋转工装,物体速度区间从近静止到 1.5 米每秒。仿真环境采用 Isaac Lab,机器人为 Franka Research 3 机械臂,场景资产取自 RoboTwin 和 DOM。
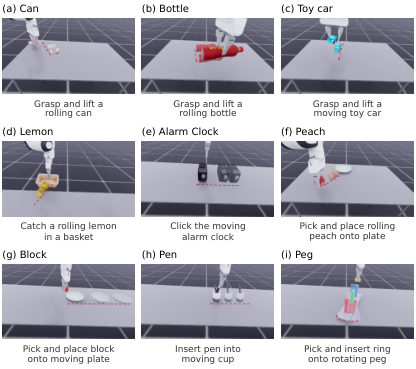
评估时每个任务采用三组随机种子,每组一百个回合。演示生成成功率,指成功产出有效演示的回合占总尝试的比例,后文所有生成指标均沿用这一口径。
02 规划做先验,残差补接触
DynaForge 在每个控制步里执行的动作由两部分合成,一部分是规划给出的名义动作,另一部分是残差策略补上的修正量,两者相加再过一个动作限幅。
规划按相位分为两种模式。处于稳定自由空间阶段时,规划器仅在相位起始处求解一次目标,生成一整条无碰撞轨迹,持续执行,直到满足该阶段的成功判定,全局重规划仅在相位切换时触发。如果进入物体运动或是接触敏感阶段,目标会跟随物体实时更新,每一步都根据物体最新位姿求解逆运动学。
目标位姿在物体坐标系中保持固定,世界坐标系下的末端目标位姿,由物体实时位姿换算得到。物体一旦移动,末端目标随之同步迁移,机械臂动作持续跟随物体新位置。
逆运动学只能求解几何层面的目标,无法处理接触区域存在的时序误差与交互误差。这部分交由残差策略在对应相位接管。策略接收一小段机器人与物体的状态历史以及规划动作,采样高斯分布,输出残差动作。残差仅在需要动态响应的相位生效,其余相位通过门控机制关闭;进入评估、正式生成演示阶段时,探索噪声也会移除。

训练过程在仿真环境内完成。残差策略可以获取机器人与物体的全部状态信息,这类信息属于训练阶段的特权信息,真实部署场景无法直接获取。
03 只学半成功半失败的组
残差策略基于强化学习训练。模型不设置逐步稠密奖励,只在整条回合结束后判定任务成败,同时依靠任务进度检查点补充部分奖励。单条回合的回报,由任务是否成功,以及失败时抵达的检查点共同决定。
如果随机采样环境条件,任务难度和残差修正效果会互相混淆,组内差异无法归因。研究团队依据物体速度、扰动幅度等参数划分难度层级,每一层分配同等数量环境。同一组内的环境共享初始化与扰动参数,仅动作采样相互独立,保证组内差异来源于执行过程本身。
梯度更新只选取特定样本组。一组样本全部成功,代表当前条件已经掌握,不存在需要修正的失败案例;一组全部失败,则代表难度超出能力范围,无法形成成败对照。这两类样本组都会直接跳过。只有组内同时存在成功、失败样本,才参与梯度计算。如果一个批次没有符合条件的样本组,本轮更新直接跳过。
随着策略能力提升,这种成败共存的样本组会自动向更高难度条件迁移,学习持续聚焦在模型当前能力边界。研究没有人工预设难度序列,难度随筛选机制自然提升,这套方法称为隐式课程。优化算法采用 DAPO 非对称截断,下界 0.20、上界 0.28。
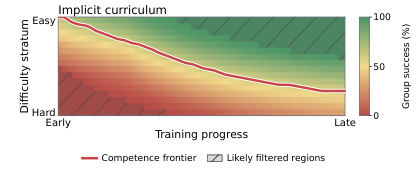
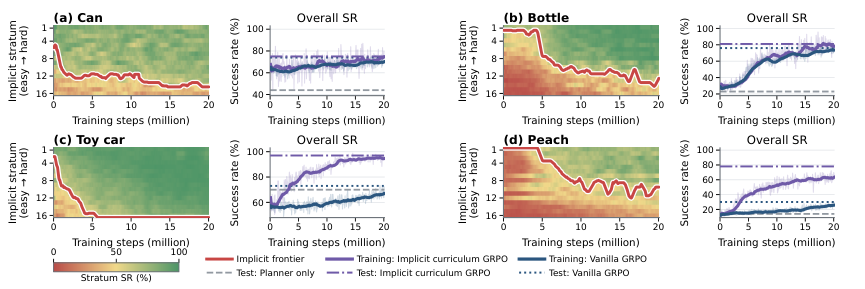
研究也记录了能力前沿推进的全过程。每个任务都生成分层成功率热力图,配套两条训练曲线,分别对应隐式课程与标准 GRPO。热力图直观展示,随着训练推进,成功率向更高难度层级扩散,能力前沿不断向前拓展。
04 生成成绩与真机迁移
先看演示生成效果。在九项仿真任务中,仅依靠规划先验的平均成功率为 41.30%,叠加残差策略后提升至 78.37%,平均提升 37.07 个百分点。不同任务涨幅差异明显,柠檬抓取提升 12.00 个百分点,瓶子抓取涨幅最高,达到 57.67 个百分点;玩具车、闹钟、积木等任务成功率突破九成。难度最高的插销装配任务,成功率也从 7.67% 提升至 28.00%。
两组基线方案表现更低。DynamicVLA 的状态机采集器,在其支持的五项任务上平均成功率 29.07%,剩余四项超出状态机覆盖范围,标记为不适用;DynaMimicGen 在全部九项任务上平均仅 13.41%。
团队选取五项共有任务,估算各方案的准备成本。DynaForge 预估人工投入约 50 分钟,机器耗时 6.5 小时,其中残差训练 2.5 小时、数据采集 4 小时。作为对照,DynamicVLA 预估人工 100 分钟、机器时长 26.9 小时;DynaMimicGen 预估人工 52.5 分钟、机器时长 25.4 小时;仅使用基础规划的方案预估人工 75 分钟、机器时长 10.4 小时。团队特别注明,人工预算为假设估值,并非实测结果。
生成数据的价值,通过下游策略做验证。每个任务使用 800 条演示样本训练 3D Diffusion Policy,两组实验保持表征方式、预处理流程、训练步数完全一致,仅替换数据源。基于 DynaForge 数据集训练的策略,九项任务平均成功率 49.11%;DOMINO 数据集训练的策略平均只有 7.07%。闹钟、玩具车任务差距最为悬殊,插销装配则对两组数据集而言都属于高难度任务。
消融实验单独验证隐式课程的作用。四项任务中,仅用规划的平均成功率 37.75%;采用标准 GRPO 训练达到 63.25%;启用隐式课程后提升至 82.75%。相较于标准 GRPO,隐式课程在四项任务上分别高出 1、5、24、48 个百分点,优化步数仅为标准 GRPO 的 0.73 倍,训练时间为 0.62 倍。
研究进一步迁移到真机环境。团队直接部署仿真训练完成的 3D Diffusion Policy,开展三项物理实验:抓取从右侧滚来的易拉罐并提起、按压持续旋转的闹钟、将香蕉放入转盘上的碗。每项任务、每种数据源各测试十次。DynaForge 数据训练的策略分别成功 3 次、6 次、5 次,对应成功率 30%、60%、50%;DOMINO 数据训练的策略成功 0 次、0 次、1 次,对应成功率 0%、0%、10%。

这里需要厘清两者分工。DynaForge 是前置的数据生成工具,在仿真环境批量产出动态交互演示;真机上运行的,是用这批演示训练得到的扩散策略,DynaForge 生成器本身并不部署在机器人本体上。
05 写在最后
DynaForge 以运动规划作为先验,依靠学习模块修正接触边界的时序误差,把原本失败的轨迹转化为有效的演示样本。这套方案最核心的价值,是实现动态操作演示的批量自动生成,不再依赖人工在极短的接触窗口里逐条采集。
对具身智能研究者而言,这是一套可复用的数据管线。动态操作演示生成率从 41.30% 提升至 78.37%;用生成数据训练的策略,仿真环境下平均成功率由 7.07% 提升到 49.11%,真机测试取得 30% 至 60% 区间的成功率。需要覆盖的动态技能越多,这套自动生成管线能够节省的采集成本就越显著。