
中科院自动化所与高德团队提出 DreamTrue,将机器人动作统一渲染为画面条件,实现高精度未来视频预测
DreamTrue 将机器人动作渲染为画面内的机器人作为训练条件,为世界模型补充示范数据中缺失的失败动作,并依托人工标注训练得到的奖励模型开展强化学习。当动作执行失败时,模型能够如实预测对应的结果,它在 AgiBot 平台上将交互缺陷率从 48.12% 降至 6.25%。
10 月 8 日,中国科学院自动化研究所模式识别国家重点实验室联合高德团队发表论文《DreamTrue: Action-Faithful Robot World Model with Counterfactual Post-Training》。论文共有 9 位作者,Junyan Li、Ruizhi Li 为共同第一作者;模式识别国家重点实验室助理教授范略、中科院自动化所研究员张兆翔担任通讯作者,高德的 Yu Liu 与范略共同担任项目负责人。
世界模型可以作为机器人的虚拟仿真环境,用来替代一部分真机试错,它需要满足两个核心要求:动作时序匹配,物体对动作做出合乎逻辑的反馈。现成机器人数据集包含动作与实拍录像,但训练过程会遇到两大难题。
其一,这类录像大多缺少精准标注,相机参数残缺,将动作渲染到画面后会和原始录像错位,模型学习的基础条件本身存在偏差。
其二,数据集以成功示范为主,几乎没有夹取落空、物体滑脱这类失败场景。
这就导致模型容易默认所有动作都会成功,即便夹爪从物体上空划过,生成画面里的物体依旧会随之抬起。这种偏差会高估动作成功率,误导依靠世界模型筛选策略的研究者。
DreamTrue 正是针对这两个痛点进行优化:一方面从原始录像反推相机标定参数,另一方面借助反事实动作与奖励模型,补齐训练数据里缺失的失败样本。
01 从录像里反推相机标定
该方法面向多视角视频预测任务:输入多组同步视角初始观测、任务指令与动作序列,预测后续多视角视频。
整套方案分为三个环节:基于已有录像完成离线几何标定、第一阶段有监督训练、第二阶段反事实后训练。在这三步中,标定是保障动作条件与画面精准对齐的基础。
离线几何标定专门解决渲染画面和实拍录像错位的问题。团队依托记录的机器人状态与一组初始相机参数,将机器人 URDF 模型渲染至画面,把机器人几何结构投影到录像像素空间,建立渲染模型与实拍画面里机器人的像素匹配关系。为构建完备约束,除这一组匹配外,团队额外引入两组约束:
-
渲染机器人与录像机器人,校验动作条件和画面匹配度
-
跨帧静止背景,约束相机在时序上保持一致
-
同步多视角画面,约束不同相机之间的相对几何关系
匹配点由 RoMaV2 提取;机器人相关匹配限定在机械臂区域,依靠在机器人分割数据集微调后的 SAM3 生成掩码划定范围。
三组匹配关系共同参与联合优化,求解参数包含相机内参、外参、畸变系数以及机械臂安装偏移量。渲染机器人与实拍机器人的匹配用于降低重投影误差;跨帧背景、跨视角场景点采用射线共面约束:观测同一点的两条相机射线,需要和两个相机中心连线保持共面。两类约束联合优化,最终得到相机参数与机器人安装位姿。
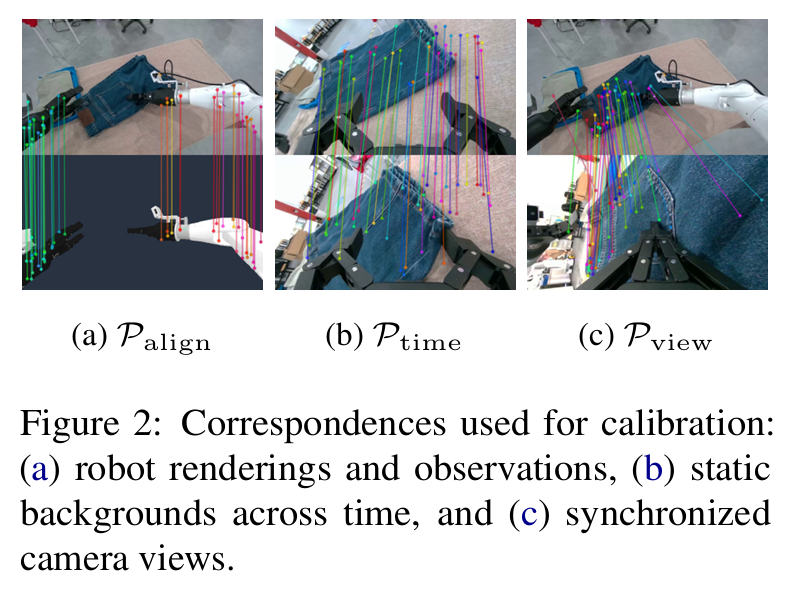
处理真机数据集时,团队依据采集元数据,对数据集内回放片段分组,分组维度包含采集人员、相机、机器人编号。每组选取一条回放完成标定,再使用得到的参数在同组其余回放做评估,对齐效果较差的分组补充标定。AgiBot、RoboMIND 采用固定初始化;DROID 相机外参差异较大,使用 32 组初始化方案。RoboMIND 与自研 Piper 数据集额外优化机械臂安装偏移;RoboTwin 以及迁移进来的 WidowX250 直接使用仿真器内的真实几何参数。
团队对外开源这套标定结果,覆盖 AgiBotWorld-Beta、DROID、RoboMIND 2.0 经过筛选的真机回放,合计 153,666 段,总时长 1,660.31 小时。其中 AgiBotWorld-Beta 占 1,225.60 小时,DROID 为 239.73 小时,RoboMIND 2.0 为 194.98 小时。每条记录附带相机内参、外参与畸变参数;DROID、RoboMIND 2.0 的数据还额外包含机械臂安装偏移与标定质量指标。
02 把动作渲染成画面条件
在通过标定确立精准的渲染几何基准后,该方法进一步解决跨机器人、跨数据集的动作统一适配难题。不同机器人的关节定义、坐标系规则、末端执行器表征方式各不相同,通用的动作编码无法实现跨场景复用。为此,团队创新性将动作信息转化为画面表征,依托机器人URDF模型与已标定的相机参数,将完整动作轨迹逐帧、逐视角渲染为图像,让所有动作条件统一对齐至像素空间,彻底规避异构机器人的适配壁垒。
在每一时刻、每一个观测视角下,模型的输入条件由五路渲染信息共同构成,全方位还原机器人动作状态与空间信息:
一是机器人RGB图像,将连续动作具象为画面中动态变化的机器人形态,直观呈现运动轨迹;
二是深度图像,精准输出机器人各部位表面到相机的空间距离,保留三维空间尺度信息;
三是机器人全局遮罩,清晰勾勒出机器人在画面中占据的所有像素区域,实现主体精准分割;
四是夹爪开合状态,通过线性映射转化为背景RGB强度变化,以红通道表征左手、绿通道表征右手,量化抓取动作状态;
五是相机射线信息,编码为稠密Plücker图像,精准标记画面中每个像素对应的空间观测方向。
这五路条件通过VACE分支接入视频扩散Transformer模型。其中,渲染的机器人RGB图像与归一化深度图像,分别经由预训练视频VAE完成特征编码;遮罩图像与Plücker射线图像则输入三维卷积几何编码器。多路特征完成融合拼接后,形成VACE分支的上下文输入信息,最终以残差形式注入DiT对应网络层。针对多视角任务,模型将不同视角的画面潜变量按固定顺序沿宽度维度拼接,动作特征同步匹配对应布局,同时将初始多视角观测画面作为参考帧,保障时序与空间一致性。
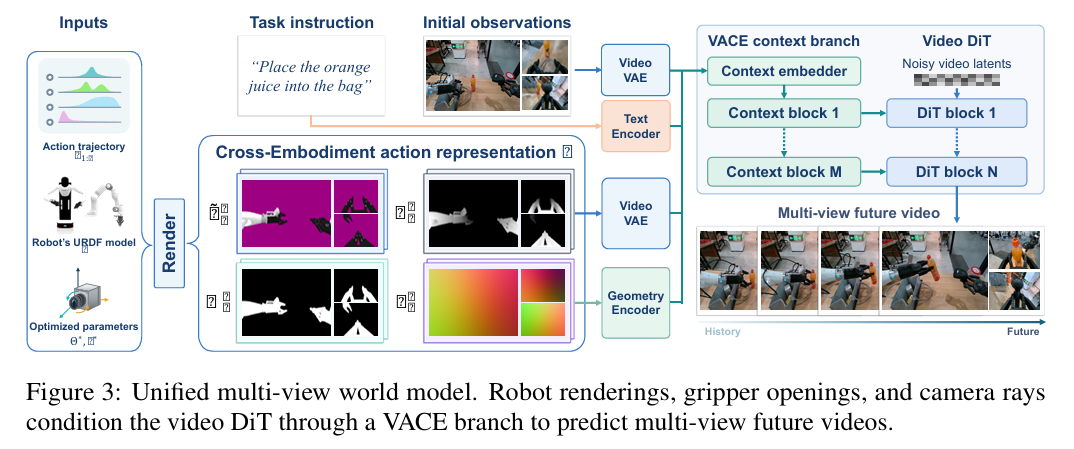
模型生成器基于Wan2.1-VACE-14B初始化,支持单次处理101帧画面、三路同步观测视角,单视角分辨率为240×320。模型以各视角首帧RGB图像与任务指令作为基础条件,预测后续100帧的连续视频画面。在相机配置上,DROID数据集采用两台外部相机+一台夹爪相机的组合,其余数据集均采用一台主相机+两台腕部相机的配置。
第一阶段训练聚焦DiT网络、VACE的LoRA分支与三维卷积几何编码器,可训练参数规模约7亿,LoRA秩设为128。本阶段以配对的真实未来视频作为监督信号,输入初始观测画面、任务指令与标准化动作条件,通过流匹配算法将噪声逐步还原为真实多视角视频潜变量,以预测速度与真实速度的平方误差作为损失函数,引导模型学习动作与画面变化的对应规律,精准跟随机器人动作逻辑生成画面。
该阶段训练数据覆盖AgiBotWorld-Beta、DROID、RoboMIND 2.0、RoboTwin 2.0四大数据集,经过严格筛选后,累计包含2232小时的多视角轨迹数据,涵盖五类机械臂设备,同时兼容真机采集与仿真场景数据,保障模型的通用性与泛化能力。
03 用自造的失败样本做后训练
第一阶段训练完全依托真实数据集里的成功交互样本,模型只能学习有效动作对应的画面变化逻辑,缺失失败场景的学习经验,容易出现“动作失误却预测成功”的偏差。为此,研究团队增设第二阶段反事实后训练,在不额外采集真机数据的前提下,自主构造大量失败动作样本,并训练专属奖励模型,为模型生成的视频画面精准打分纠错。
团队以真实录制的成功演示轨迹为基础,批量构建反事实失败动作。具体方式为:对演示轨迹的末端位姿施加 SE(3) 空间扰动,从固定初始位姿插值至扰动后的异常终点,再通过逆运动学求解对应的机械臂关节序列。整个过程保持初始观测画面与任务指令完全不变,仅替换动作序列,同时过滤掉所有不满足运动学可行性的无效样本。依托固定的初始场景,单段原始视频可衍生出多组动作不同、结果各异的分支样本,让模型在同一场景下学习不同动作对应的不同结局,补齐失败场景数据短板。
由于自主构造的失败动作没有对应的真实未来视频作为真值,无法通过常规损失函数判别对错。团队转换优化思路,不再比对画面真值,而是检测生成视频中可观测的物理与交互缺陷,针对性修正模型偏差。研究人员基于多款主流世界模型,分别在标准录制动作与构造的反事实动作条件下生成视频,人工统一标注出三大类典型缺陷。
三大缺陷维度涵盖模型生成的核心问题:
一是机器人本体缺陷,包含机器人重影、消失、结构错乱、材质异常等问题;
二是物体缺陷,包含目标物体消失、形变、外观错乱、纹理与材质失真等问题;
三是交互缺陷,包含接触关系错位、运动逻辑不符、交互行为违背物理规律等问题。
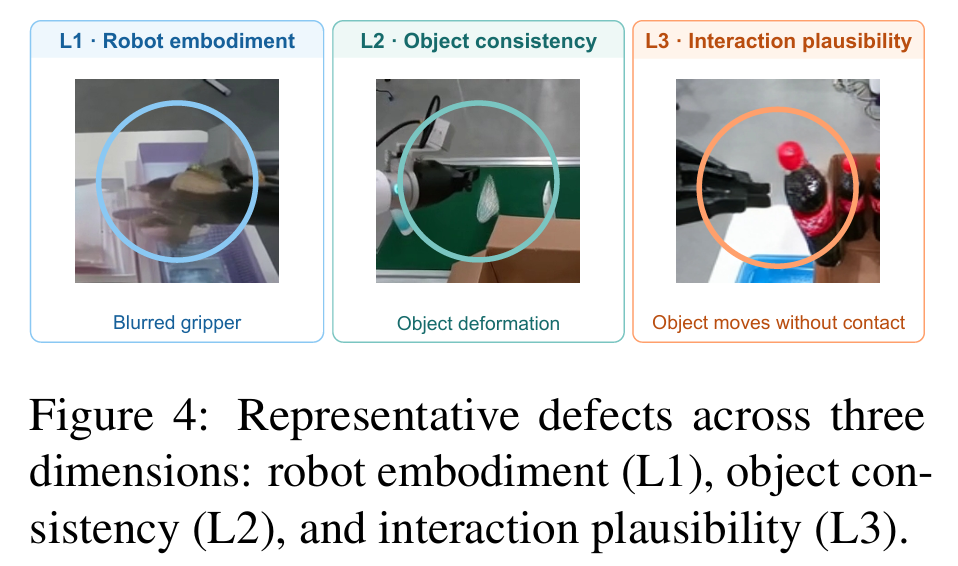
本次人工标注累计覆盖 44900 段原始视频、30400 条缺陷标签,经过筛选清洗后,最终保留 36493 段有效数据用于奖励模型训练与验证。其中训练集包含 31600 段、验证集包含 4893 段,严格按照原始回放编号完成划分。为保证奖励模型的泛化能力,标注语料不仅来自本方法生成的视频,还涵盖 DreamDojo、Ctrl-World、EnerVerse-AC、Genie Envisioner、GE-Sim 2.0、Cosmos Predict 2.5、IRASim 七大外部世界模型产出内容,同时引入 Bridge 数据集辅助训练与验证。
团队基于高质量标注数据,微调 Qwen3.5-9B 视觉语言模型,使其可同步输出本体、物体、交互三个维度的缺陷概率。研究以缺陷概率的负值作为奖励分数,画面缺陷概率越低,模型获得的奖励分数越高,以此引导模型生成贴合物理规律、交互逻辑准确的视频画面。
第二阶段后训练基于一阶段预训练模型迭代优化。训练过程同时输入真实录制动作与自主构造的反事实动作,生成器在两类动作条件下分别采样未来视频,并由冻结的奖励模型完成打分。其中,真实录制动作生成的视频,额外增加与真值画面比对的 PSNR 奖励约束。
所有维度奖励经由 GDPO 完成组内归一化,加权求和后再进行批次级归一化,计算最终优势值,依托 DiffusionNFT 算法更新生成器参数。本阶段采用冻结策略,固定基础生成器、几何编码器与奖励模型参数,仅更新 DiT 网络与 VACE 的 LoRA 分支。三类缺陷奖励权重均设置为 1,录制动作对应的 PSNR 奖励权重设置为 0.5,训练学习率设定为 5×10⁻⁶。
04 预测成绩与策略评估
实验在 AgiBot 上评动作跟随、画面质量与交互合理性,在 DROID、RoboMIND 2.0、RoboTwin 2.0 上评跨本体与跨环境,另外单独量了策略结果评估、几何标定和奖励模型的效果。
评测对象包括本方法的完整模型、去掉强化学习后训练的一阶段模型,以及 DreamDojo、GE-Sim 2.0、Genie Envisioner、EnerVerse-AC 四个基线,各用原生的条件接口。动作跟随用 EWMBench 的 nDTW,画面质量用 PSNR、SSIM 与 LPIPS,另用 WorldArena 的 EWMScore-P,它汇总六个质量维度的 15 项指标。交互合理性由三位标注员独立判、按多数表决计缺陷率,AgiBot 的反事实评测用 160 个条件、覆盖 54 个任务。
录制动作下,完整模型的 nDTW 为 0.8772,高于 EnerVerse-AC 的 0.8058、Genie Envisioner 的 0.8124、GE-Sim 2.0 的 0.8063 和 DreamDojo 的 0.6578,反事实动作下为 0.8831。画面质量上,PSNR 23.06、SSIM 0.936、LPIPS 0.094。加上反事实后训练,交互缺陷率 48.12% → 6.25%,物体缺陷率 31.88% → 3.12%,动作跟随 nDTW 从 0.8711 微升到 0.8772。作为对照,GE-Sim 2.0 在同一场合同一指标上,交互缺陷率是 7.50%、物体缺陷率是 3.75%。
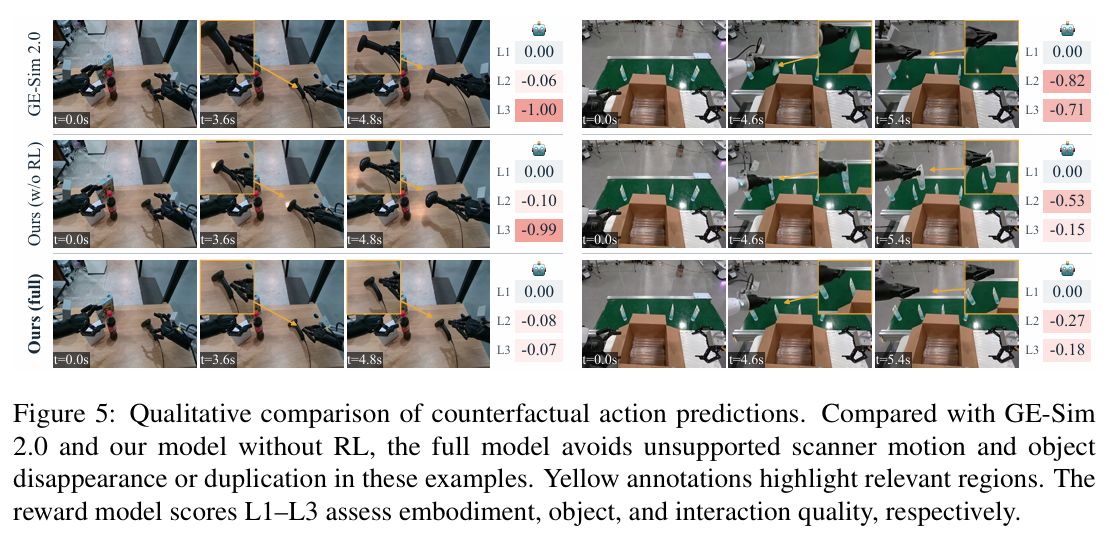
缺陷率降下来,对应到画面上的变化是,模型不再把没抓到的动作画成抓到。夹爪抓空时它让物体留在桌上,对比模型容易让物体消失、复制或者跟着升起。把初始场景固定、只换动作,模型能按动作给出不同后果,被抓住的物体跟着夹爪走,没抓住的留在原地,单臂操作里只有一只手抓到时也能分开。
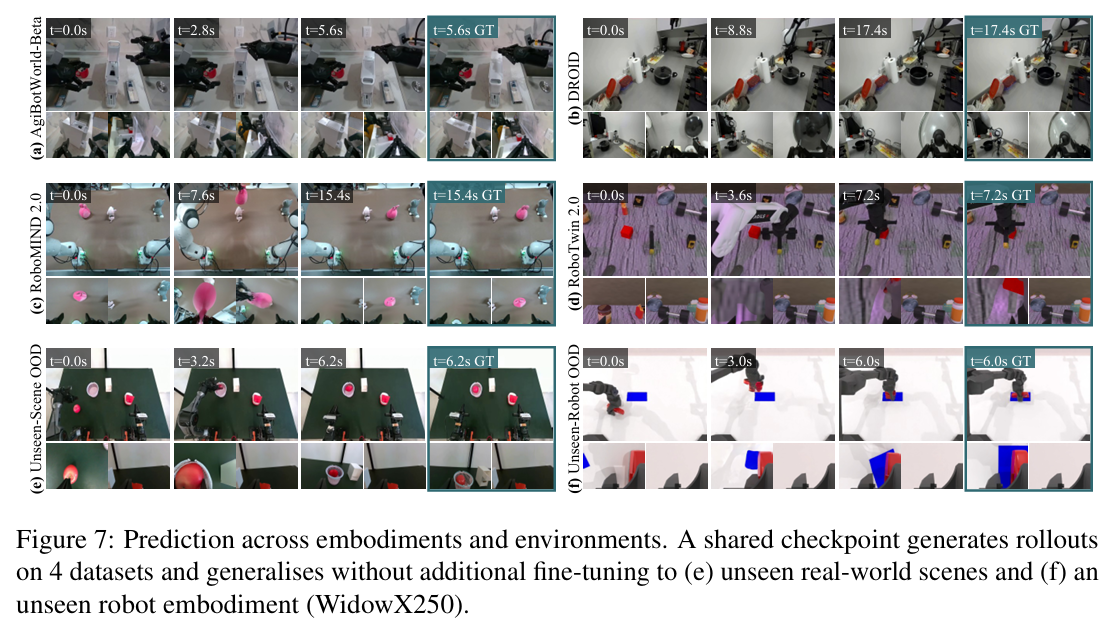
AgiBot World Challenge 2026 的世界模型赛道里,本方法综合分 0.829,动作跟随 0.9651,视觉质量 0.6246,排在参赛队伍第一。跨本体上,同一套权重在 DROID 的 PSNR 为 22.95,高于 Ctrl-World 的 22.00,LPIPS 0.073 低于其 0.162,RoboMIND 2.0 的 PSNR 23.84,RoboTwin 2.0 的 PSNR 27.35。把没参与训练的 WidowX250 放进 RoboTwin 2.0,再换到没见过的真实场景里采的 Piper 数据上,不做微调也能给出预测。
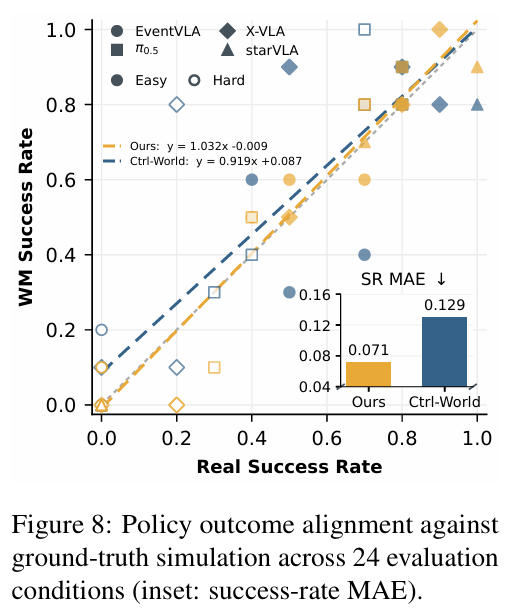
策略结果评估用 RoboTwin 2.0 的三个双手任务,beat_block_hammer、handover_block 和 place_dual_shoes,本体是 Aloha-AgileX。团队用 EventVLA、π0.5、X-VLA、starVLA 四款开源 VLA 策略,在 60 个固定场景里各跑一遍,得到 240 条动作回放、24 组任务-策略-设置组合,再让世界模型按动作预测结果,由标注员判成功与否。完整模型预测的成功率与真机仿真的平均偏差是 7.08 个百分点,对照 Ctrl-World 的 12.92 个百分点,整体偏置 +0.42 个百分点,秩相关 0.937。在低成功率区间,Ctrl-World 的误报 26 → 12 次,精度 76.15% → 87.63%,准确率 90.42%。
几何标定的效果用渲染机器人和 SAM3 遮罩之间的面积加权 IoU 来量。相对数据集自带的标定,本方法在 130,182 段 AgiBot 回放上把平均 IoU 提高 0.228,在 63,061 段 DROID 回放上提高 0.212,分别在 97.1% 和 91.6% 的回放上有改善。DROID 上只用 RGB,就在 38,356 段回放中的 75.5% 上压过依赖立体深度的 PointWorld。把这套标定接进预测,只在推理端用就涨了 PSNR,训练端也用上后,AgiBot 和 DROID 的 PSNR 分别再涨 1.28 和 1.30 分贝,末端位置的同步误差同步下降。奖励模型在 4,893 段留出视频上,三类缺陷的平均判别准确率 86.33%,宏平均 F1 74.21%,其中本体一项 96.69%,物体和交互两项分别是 79.24% 和 83.08%。