
对话 IROS 最佳论文奖入围团队,揭开机器人「晕玻璃」的秘密
9 月 27 日至 10 月 1 日,第 39 届 IEEE/RSJ 智能机器人与系统国际会议(IROS 2026)在美国宾夕法尼亚州匹兹堡 大卫·劳伦斯会议中心( David L. Lawrence Convention Center)举行。
本届大会预计超 4,000 人参会,近 2,000 篇论文将在会上宣讲,145 家机构参展。这是匹兹堡时隔 31 年再次举办 IROS,大会主席由 CMU 机器人研究所教授 Howie Choset 担任。
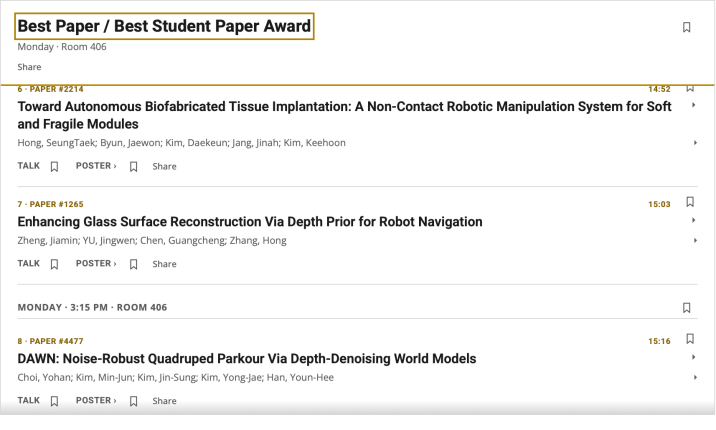
最值得关注的是本届 IROS 2026 Best Paper 奖项入围论文。本届大会共收到 4,348 篇论文投稿,再创历史新高;最终录用 1,585 篇,录用率约 36%,为近年来最低,Best Paper/Best Student Paper Award 奖项入围论文仅有十篇。
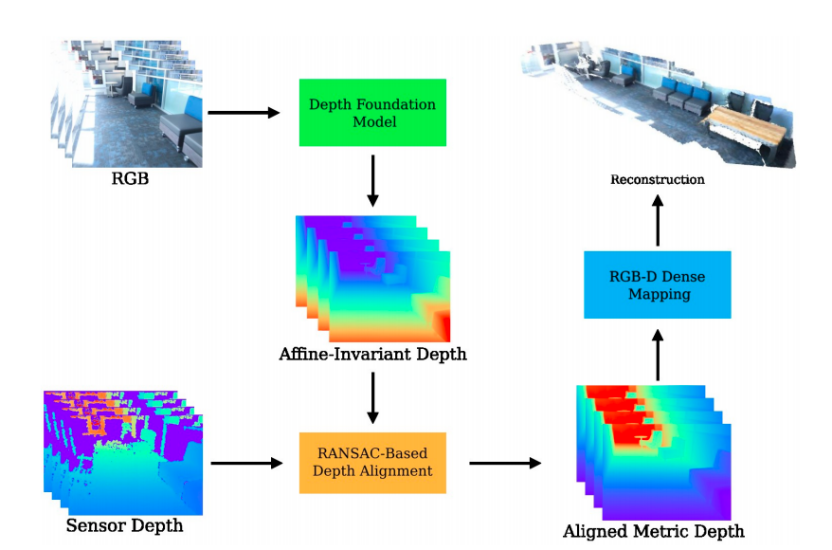
南方科技大学张宏院士团队聚焦玻璃表面重建、以实现安全的机器人导航工作,便是其中入选的十分之一。其核心成果在于提出了一套无需训练的框架,以深度基础模型作为结构先验,采用基于 RANSAC(随机抽样一致算法)的鲁棒局部对齐方法,将其与原始传感器深度进行融合。
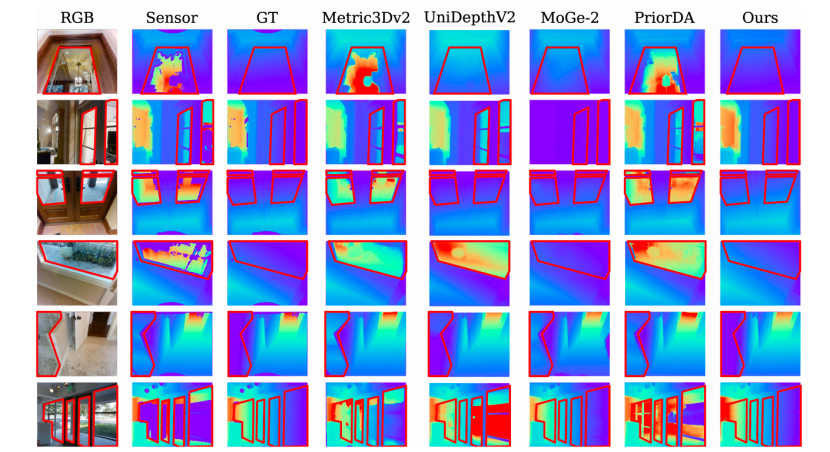
该方法可自然避免错误的玻璃测量结果带来的干扰,还原出准确的度量尺度。此外,全新设计的 GlassRecon RGB-D 数据集专门适配机器人导航,能够通过几何推导得到玻璃区域的真值。这项技术有着可观的应用前景,能够让机器人清楚地识别玻璃表面或玻璃材质的物体,并使其在日常行驶中绕过这些障碍物。
该项研究的核心成果在于补全现有传感器的缺陷。由于玻璃表面干扰室内机器人导航,深度传感器的测量结果通常严重失真。尽管 Depth Anything 3 这类基础模型能够提供出色的几何先验,但它们缺乏绝对的度量尺度。共一作者于靖文认为, 该研究能入选 IROS 2026 Best Paper/Best Student Paper Award ,很有可能在于巧妙地结合了最前沿的深度感知基座模型来解决机器人玻璃避障问题,其思路上的简洁得到了评委会认可。
但为什么识别玻璃平面对机器人导航那么重要? IROS 2026 大会期间,42号电波专访入围团队共一作者于靖文,揭开机器人与玻璃的「不解之缘」。
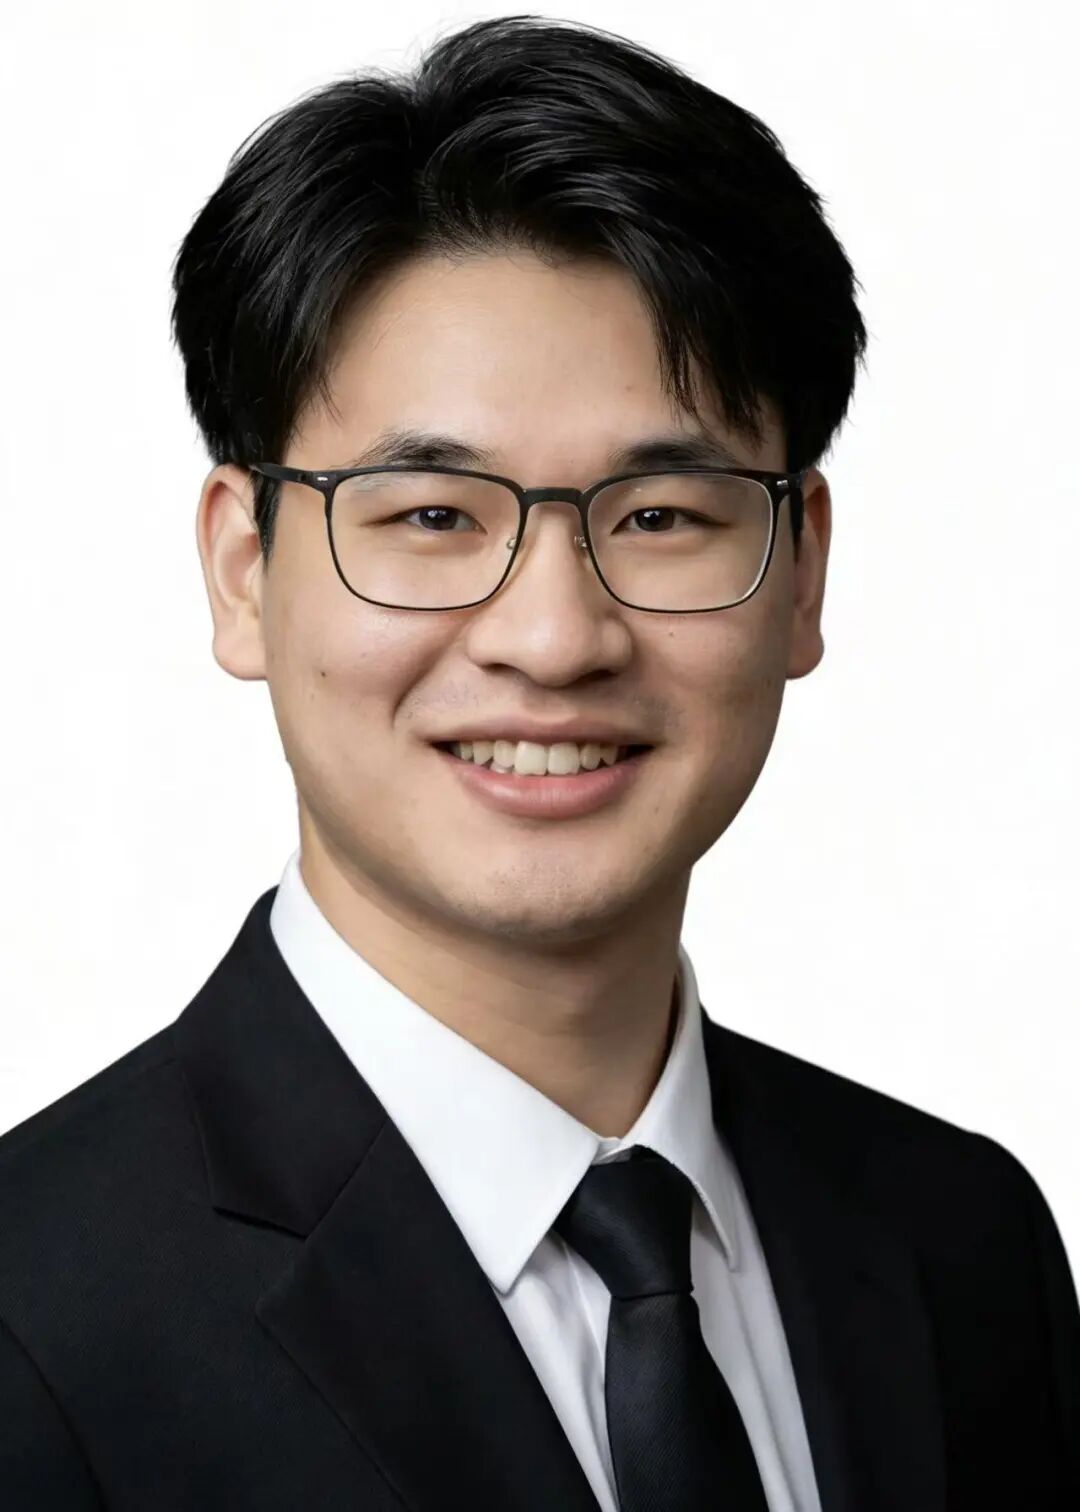
受访者简介:于靖文,香港科技大学郑家纯机器人研究院(CKSRI)博士生,同时是南方科技大学(SUSTech)深圳市机器人视觉与导航重点实验室的成员,本科就读于南方科技大学电子与电气工程系,师从张宏讲席教授和谭平教授。主要研究方向包括视觉导航、三维重建及 SLAM(同步定位与建图)。
起点
42号电波 :能否简单介绍一下您的学术生涯?
于靖文 :我 2017 年进入南方科技大学,2019 年进入南科大的电子与电气工程系,并在 2019 年初接触到机器人。2019 年夏天去新加坡国立大学交换时,我接触到一个与自主移动机器人相关的项目,发现对这个方向比较感兴趣。
很巧的是,2020 年,南科大电子系有两位从事机器人方向的老师,其中之一是我后来的导师张宏讲席教授。张老师之前在加拿大工作了 30 年,是加拿大工程院院士。自 2020 年起,我一直跟着他做移动机器人方面的研究。2021 年本科毕业,我跟着他做了一年多,在移动机器人方向算是入门了。在他的推荐下,我进入香港科技大学读博士,师从 3D 视觉方向的专家谭平教授。
读博期间,张宏老师是我的 Co-supervisor,同时我也在南科大的深圳市机器人视觉与导航重点实验室进行科研训练。我们实验室人很多,我有幸跟张老师的一位硕士生合作,也就是这篇文章的共同一作郑佳敏。我指导她做硕士课题,合作完成了今年在 IROS 上入选 Best Paper Finalist 的这项工作。
42号电波 :这项研究产生的契机是什么?
于靖文 :约在 2024 年底,郑佳敏联系我,希望我能够跟她一起做个课题,并给她提供一些指导。这篇论文另一位作者陈广诚也是课题组成员,他当时一直在做反射表面的物体重建。
42号电波 :这个反射指的是玻璃的反射吗?
于靖文 :反射表面的物体跟玻璃还不太一样,比如陶瓷的表面也是反射的,跟陶瓷是什么颜色没关系。陈广诚用了一种特殊的传感器、偏振相机去做重建。 玻璃是日常生活中比较特殊的材质,光线穿过玻璃时会被折射或反射。 在讨论中,我们逐渐想到,或许可以在玻璃上做点文章。
在这个契机下,我们开始做这个方向。它也是从之前的课题衍生出来,具有现实意义。这就要提到美团。
42号电波 :你们在致谢中确实感谢了美团研究院,团队和美团之间是什么关系?
于靖文 :我们主要跟美团的无人车配送部门合作,已有大概 3 年了。他们用一种比较小的机器人,在机场或者大商场里面送外卖。目前这个项目已在深圳宝安机场落地了。
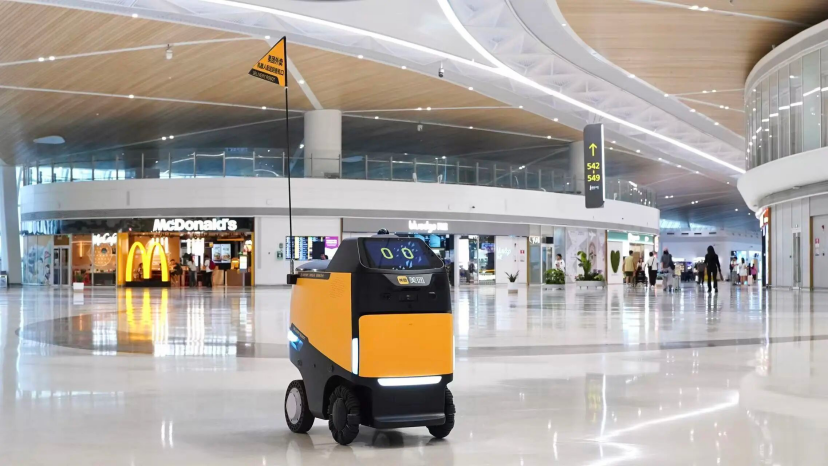
在平地、同一层落地之后,他们想让机器人像酒店里送东西的机器人一样能够上下楼。但机场不像酒店,并不是每台机器人都能很容易地拿到大厦电梯的控制权,所以需要机器人自主进电梯去做一些操作。
我们在这个过程中发现了一个问题。电梯里很多都是反光的金属面。在这样的环境下,深度相机感知不太准。我们也是从美团的实际问题出发,发现可以先解决玻璃这个相对来说更直接、更简单的场景,最终促成了这个研究课题。
42号电波 :现在这项研究成果是已经落地了吗?
于靖文 :论文里的方法还没有落地。我们之前做过一些相关的落地研究。
42号电波 : 玻璃会拦住机器人,这件事情很反直觉。 从人的角度,我们以为识别玻璃和玻璃材质的物体并不难。那么,玻璃会给具身智能带来怎样的阻碍?传统传感器在玻璃面前,是根本看不到,还是会错误识别?
于靖文 :我们现有的深度传感器,一类是深度相机,还有一类是激光雷达,它们都是通过光来测距的。 但玻璃表面很特殊,光会被它反射,或者直接穿透过去,所以这些传感器在玻璃表面上就会失效。
我们想得知玻璃表面的深度,即它在三维空间中的几何形状,无论这个物体是一面镜子、一扇玻璃门,还是桌上的一个玻璃杯。而目前来讲,用现有的传感器来做这件事是比较难的。
因为这会形成两种错误。一种是空洞,就是我们不知道这里有东西;另一种是错误地估计了这个表面的位置。比如,在玻璃很透的情况下,传感器可能会认为这个表面在更靠后的位置。总而言之,它的深度感知不准确。
然后,这就带来两类问题。一类是我们论文的重点,即在导航上,机器人面对玻璃可能会撞上去。另一类是桌面操作,特别是在具身智能的场景下,机器人找不准物体具体在哪里,从而产生操作上的错误。
42号电波 :在所有材质里,玻璃表面和玻璃材质的物体是不是传感器最难处理的?一些其他金属材质也有可能出现反射或折射,但玻璃是这其中最突出的?
于靖文 :可以这么说。这还跟物质材料本身具有的一些反射特性相关。玻璃的特点是它的透射率很高,光很容易就穿过去了。相对来说,金属一定会反光,只是光反射出去之后是漫反射,或者反射之后强度变得不容易预测。
另外,在我们生活中以及机器人的应用场景里,玻璃比较常见。特别当我们想让机器人走进家里或者办公室这类场景,它比特殊材质的金属还常见一些。当然在工业场景下,金属也是一个很重要、有待解决的问题。
简单地接近问题
42号电波 :相比过往的研究,比如 CDM、SILICA,以及 GlassGuard 这些路线,您认为这篇论文最大的创新是什么?是什么让它入围了 IROS Best Paper/ Best Student Paper Award?
于靖文 :我们对比了很多基于数据驱动的主流方法。 但我们实际想做的是补全深度传感器测量中的缺陷。 在这一点上,蚂蚁灵波机器人团队做的 LingBot-Depth 跟我们想要解决的问题非常接近。
这次入选 finalist,一方面是很幸运,另一方面,应该是我们整篇文章的思路保持着简洁、直接。论文所提出的方法其实非常简单,想法也很朴素、很直接,并没有什么花里胡哨的东西,没有特别大的理论创新,但效果很好。我们更多的是尝试用最先进的模型,把它放到我们机器人需要的地方。IROS 的评委会更看重的可能是在大模型和 AI 发展得这么快的情况下,如何把各项技术落地到机器人的应用上,特别是在非常现实的场景里。
现在有很多非常先进的单目深度感知模型。我们将它们有机地跟整个机器人导航系统结合起来。只要能输出 scale-invariant(尺度不变)的单目深度估计图,我们的方法提出的框架可以适配这类模型。
42号电波 :论文提出了一个免训练的模块化流程,特别是局部 RANSAC。能否简要讲讲它的新颖性?有没有试过一些方案,但最终行不通?
于靖文 :我们试了很多方案。首先,可以把问题设定确定下来。我们有一张用 Depth Anything V2 或 Depth Anything 3 得到的深度图,它能估计出玻璃表面的深度。但这类深度图的问题在于,它不知道真实的尺度,估计出来的是相对深度。
在机器人重建上,这样的深度图是不能拿来直接用的。 比如,它给出的是 0 到 255 的深度值,但这并不反映真正从 0 米到 255 米的距离。而我们的传感器是能获得真实尺度的,难点在于它遇到玻璃时会失效。不过,在真实场景中,总会有比较大的区域不会被玻璃占据,这也是我们方法的假设。所以我们就想,怎么去利用这些没有被玻璃影响的、正确的传感器深度来做估计?
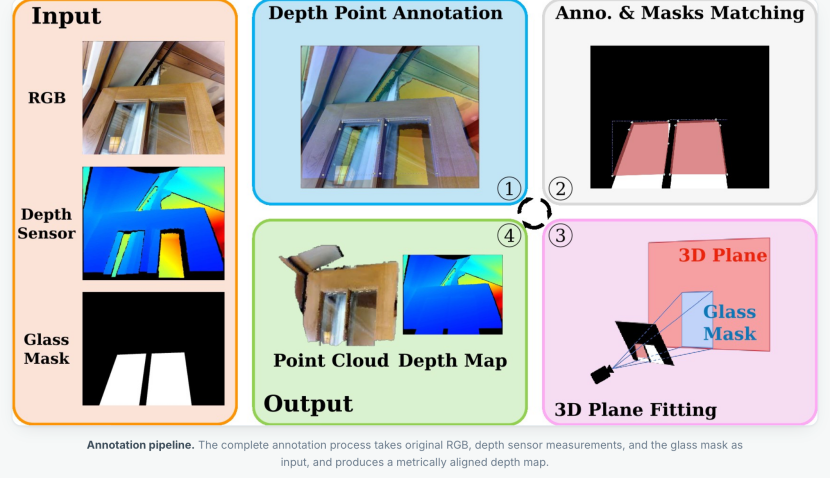
我们采取了一个很简单的思路:先用检测方法把玻璃区域检测出来,再用非玻璃区域的深度去恢复尺度,不就行了吗?这确实可以,只是通过实验发现,训练这种模型需要比较多的数据,而且不同场景下,玻璃的类型还不太一样。
另外的想法是,团队也训一个小网络来估计玻璃区域,但最终还是受限于数据。
42号电波 :数据方面的问题落在了哪里?
于靖文 :因为玻璃标注比较困难。我们的标注是基于一个平面假设:玻璃区域可以通过三个以上的点把它画出来,因为玻璃的深度跟它的边缘是一致的。这个标注过程需要比较大的人力成本,这一块主要是郑佳敏做的。
我们也在尝试基于 VLM 做预标注,也就是伪标注的方法,来加快这个流程。当时,我们的数据集标注了差不多 1,000 张图片,计划用于训练,但中途发现由于这类数据需要标得比较精确,人力成本比较高。我们之前也尝试用数据驱动的方法来做,但效果不太好。
后来想到,其实可以基于 patch 分区的方法来做取样,通过免训练的方法去找到那些不是玻璃的区域。也就是用 RANSAC 来做,默认环境中非玻璃区域占画面的大部分。
42号电波 :论文把 RGB-D 数据集分成了 Easy 和 Hard 两个版本,这对玻璃识别有什么帮助?
于靖文 :你可以简单地理解为,玻璃平面在整张图片中占据范围的大小。玻璃范围小的部分进入 Easy 数据集,范围大的部分进入 Hard 数据集。这些数据可以帮助传感器的玻璃平面重建和识别。
「晕玻璃」
42号电波 :你们最终产出的 3D 稠密建图,在具体场景中是怎么指导机器人规划运动轨迹的?
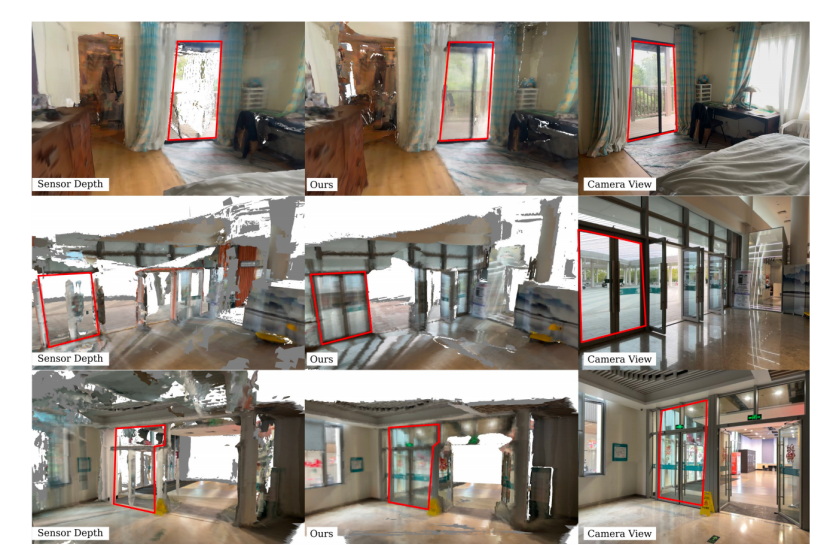
于靖文 :论文里列举了几个场景,特别是有玻璃门的情况。如果地图中玻璃处的深度缺失,机器人就会认为这个区域可以通行,那它就会撞上去。这块我们有一些视频,但论文里没有放这个 Demo。我们做过一个真机实验,挺搞笑的,机器人会一直撞上去。所以目前主要还是静态避障。
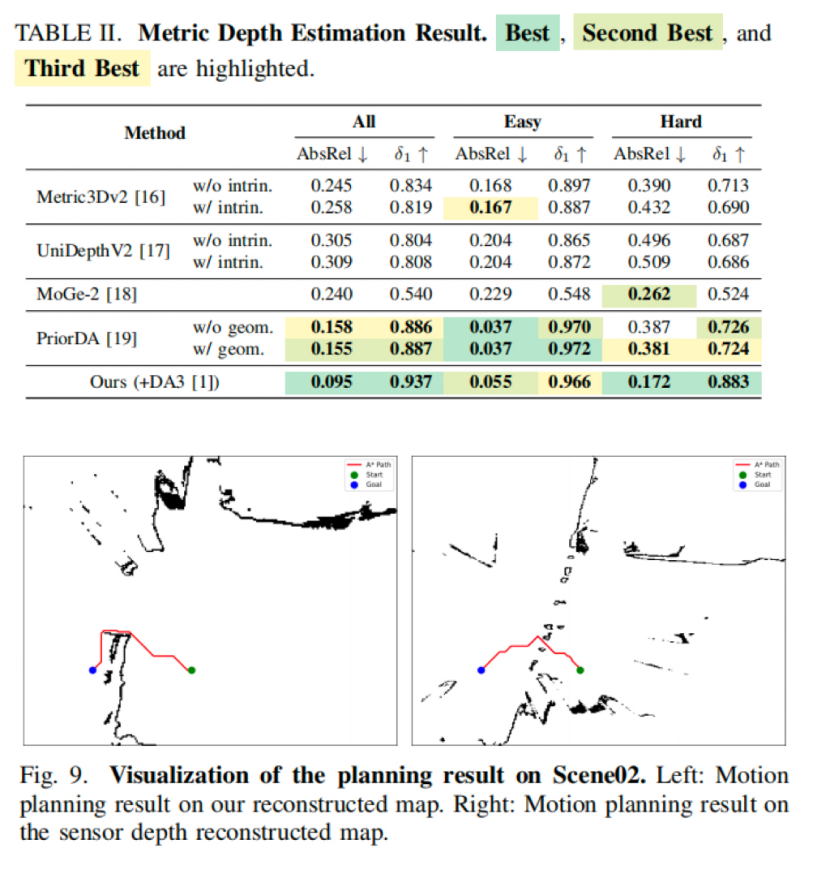
42号电波 :研究的实验结果以及演示效果都很好,深度测试的效果均较过往研究有显著提升,在真实场景下,传感器也能够进行绕过玻璃门的导航规划,但也提到存在一些失败案例。那么目前在 Glass Recon 的应用上,团队观察到哪些局限?
于靖文 :我们面临的失败场景,是玻璃区域比较大的情况。当一张图里玻璃区域占的范围比非玻璃区域小时,我们的方法有效。
42号电波 :如果进入类似于镜像迷宫的环境,是不是就彻底失效了?
于靖文 :对,那就彻底失效了。Glass Recon 基于深度先验形成,文章标题里就有 via Depth Prior,这个 Depth Prior(深度先验)本身就是一个神经网络。它失效的情况下,我们的方法也工作不了。
42号电波 :还有我不知道没有其他局限?
于靖文 :另一局限是,我们仍比较依赖一个预训练好的、能估计相对尺度深度的模型。我们尝试把一个大模型落地到实际机器人中,并为此设计了一个方法。如果未来有新的方法把模型提升了,我们的方法也会变得更好;但如果模型在提升的过程中还有一些特殊情况解决不了,那我们的方法也无能为力。
团队的下一步
42号电波 :您提到团队可能尝试结合 SAM 3、GPT 这类模型优化玻璃避障识别,这会是你们下一步的计划吗?
于靖文 :对。我们也在做新的工作,比如尝试把 SAM 3 结合进来。SAM 3 是一个通用的分割大模型。或者更简单,直接用 GPT,给它一个提示词,说「把这张图片上的玻璃区域分割出来」,然后再用我们的方法。这是我们正在做的。之后,我们更多可能会尝试把我们的方案放到全景相机上,去做室内的全景视觉导航。
42号电波 :这项技术未来有没有机会在更多真机上集成并进行测试?
于靖文 :我这边在深圳已经有了公司,跟同学一起正在创业。后续在一些具体场景上,我们一方面将把这个方法再做提升,另一方面,做更多的真机实验。我们公司主要面向办公场景,现在的大楼里,玻璃门和大面积玻璃都很常见,我们肯定要继续使用研究中提出的方法。
另外我觉得, 具身智能这个行业,可能也在慢慢「祛火」 。大家也发现,纯粹用端到端的方式不可行。这时候应该更多地回归到经典的机器人架构上,在这个基础上再做一些探索,看能不能支持具身智能更进一步,真正落地到现场。
42号电波 :现在的具身智能有很多技术路线。相较当前的路线来说,您说的经典机器人架构具体侧重什么?
于靖文 :简单来讲,整个机器人系统可以分为感知层、规划层和控制层。 在经典的机器人框架下,是不存在跨本体问题的。
比如,我们的各项工作与 demo 虽然在机器人上完成,但很多建图效果就是用手机拍的。任何一个携带 RGB-D 相机的设备都可以用上我们的方法,不存在哪种机器人构型会对算法产生影响。在经典框架里,规划也是跟本体无关的;控制上,不同机器人会有各自的控制参数。这样就不存在 VLA 范式下的那种跨本体问题。未来大家更注重不同本体下的通用性时,经典的机器人框架可能更为合适。
42号电波 :具身智能的各项技术发展到现在,聚沙成塔般慢慢拼到一起。很多像您这样的研究都在慢慢往模型上、往机器人上集成。您觉得具身智能的未来会是什么样子?
于靖文 :过去这一两年,出现了基于 VLA 的范式、世界模型范式的研究成果。大家看到了大语言模型的成功,都想在机器人上复现类似的成功。我们这个工作也给大家一个启示:机器人的工作场景,实际上远比单纯的视觉问答或跟大模型对话、写作要复杂得多。一些细微的光照变化就可能改变机器人传感器当前感知到的信息。
在这种情况下,我认为单纯靠一个端到端模型,很难完成机器人这一系列复杂工作。按照我们公司创业的技术路线,我们也会把整个机器人系统按照经典的机器人框架来分层,每一层都可能用上最先进的模型,借用 LLM 等模型去处理具体的问题。
通过多年在机器人系统中的研究和落地,我们发现了一些很具体的问题;又发现一些最先进的模型可以帮我们解决这些问题;然后根据我们对机器人系统集成的经验,把它们有机地结合起来。所以实际上,这是一个融合的方法,不需要运行任何网络,是纯计算的方式,可以在很小的机器人上很快落地。