
港大、港科广、北大等五校团队联合发布 AffordanceWAM,靠可供性激活真人训练视频
AffordanceWAM 的核心突破,是将「物体可交互位置与方式」的可供性,纳入世界动作模型的显式预测目标,彻底解决真人第一视角视频难以适配机器人训练的行业痛点,让原本容易造成负迁移的真人数据,转变为可规模化扩展的有效监督信号。
9 月 16 日,香港大学、香港科技大学(广州)、北京大学、香港中文大学、新加坡国立大学与 Knowin AI 联合团队发布研究成果《AffordanceWAM: Affordance-Aware Joint World–Action Modeling for Robot Manipulation》。论文共 14 位作者,Jiadi You、Qize Yu 为共同第一作者,香港大学电气与电子工程系副教授齐晓娟、香港科技大学(广州)人工智能学域助理教授陈颖聪担任通讯作者。
世界动作模型(WAM)将视频时序预判能力引入动作生成逻辑,依靠对未来场景状态的理解输出控制指令。相比于具象、跨本体难以迁移的关节动作,画面变化、交互趋势等未来状态更具备通用性,天然适配跨形态智能体迁移。但在引入真人操作视频训练时,行业长期面临两大错位难题:真人视频不存在机器人关节动作标注,同时人机视角、外观结构、操作节奏差异极大,直接混用极易干扰模型训练。
针对这一问题,团队创新将可供性——即物体可交互区域、可操作方式的物理属性——定义为模型必须预测的未来世界状态之一,实现人机视频数据的统一监督。基于这一设计,真人视频无需动作标注、无需提前进行人机动作重定向,即可直接参与世界模型训练,为机器人学习场景交互逻辑提供有效监督。
01 真人视频与动作的语义错位
真人第一视角视频能够完整呈现手部运动轨迹、物体摆放位置、交互接触点位等场景信息,但完全缺失机器人所需的关节控制指令。同时,人手与机械臂的自由度、运动结构、操作节奏存在本质差异,同一交互任务在人机两端的动作坐标、时序逻辑完全不同。若直接将真人视频混入机器人训练数据集,模型无法获取有效动作监督,反而会因画面表征、运动逻辑的错位产生干扰,拖累训练效果。
过往行业方案只能单向补齐短板:一类方法依靠人手动作重定向,将人体轨迹强制转换为机器人动作序列,训练效果完全依赖动作还原精度与跨本体对齐能力,容错率极低;另一类方法聚焦画面适配,通过视角、外观合成对齐人机观测画面,但仅能解决视觉层面差异,无法修复交互逻辑的底层错位,未对齐的场景信息依旧会成为训练噪声。两类方案都需要人机数据实现高度匹配,适配成本高、泛化性差。
世界动作模型为此提供了全新技术路径。通过共享视频预测与动作生成骨干网络,WAM 依托通用的场景未来状态完成动作推理,相比具象关节动作,场景时序特征更易实现跨本体迁移。不过现有多数 WAM 仅预测未来画面或视觉潜变量,仅能建模外观、视角、背景运动变化,任务核心的物体交互区域、可操作点位等关键信息,依旧隐藏在隐性特征中,无法形成有效、稳定的监督信号。
本次研究的核心革新,就是将可供性从隐性特征提炼为显式预测目标。可供性代表物体客观可交互属性,不受人机本体差异、视角节奏影响,是人、机通用的统一交互逻辑。将其纳入世界模型的预测体系后,真人视频与机器人视频拥有了共同的监督维度,无需繁琐的数据预处理与动作适配,就能高效赋能机器人具身训练。
02 可供性写进未来的世界
AffordanceWAM 将可供性拆解为标量可供性分数图与可供性热力图双分支同步预测,用两套表征互补补齐场景交互信息,打通真人视频与机器人数据的统一训练通路。
标量可供性是一张与原图同尺寸的像素分数图,像素值归一至 0–1 区间,用于逐帧定位任务相关物体与可交互区域。该表征只定义「交互位置」,不约束具体抓取姿态与执行方式,天然规避人手、机械臂之间本体结构、运动习惯的差异,让真人视频与机器人视频能够共用一套统一的交互语义。
标量可供性经由专属可训练编解码器完成建模:编码器将多帧未来可供性分数图压缩为与画面时序分组对齐的潜变量,解码器再还原重建分数图,并通过逐帧均方误差监督训练,精准保留空间层面的交互位置信息。但纯分数图缺少视觉归属关系,孤立的交互区域无法关联对应物体,容易造成模型识别混淆。为此团队增设可供性热力图,通过固定渲染方式将抽象分数图叠加至原始画面,再由冻结视频编码器编码为潜变量,并与画面特征严格时序对齐,让交互区域与所属物体深度绑定,补齐场景外观与语义归属信息。
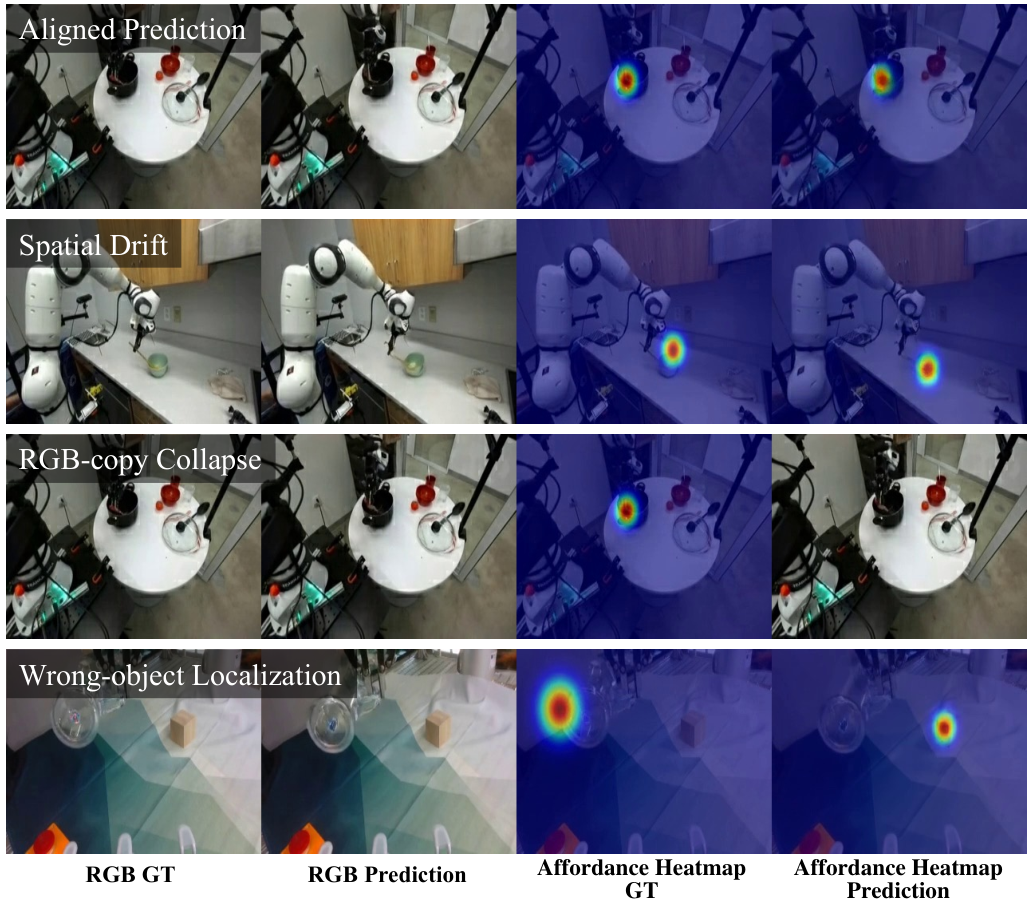
模型对画面、标量可供性、可供性热力图三路未来状态统一施加流匹配约束,三路分支分别注入独立噪声,再通过加权系数融合时序流损失与编解码重建损失,构成完整的世界模型监督体系。训练监督策略做了精准区分:真人视频仅参与三路世界状态预测监督,专注学习通用场景交互规律;机器人轨迹数据则在世界损失之外,额外增加动作监督。依托这套双轨监督机制,可供性成为衔接真人数据与机器人真机数据的核心通用表征,彻底解决两类数据的训练错位问题。
03 双专家架构与单向注意力
AffordanceWAM 主体采用双分支扩散 Transformer 专家结构,两组专家各 30 层,各司其职、解耦协作。其中世界专家基于预训练视频扩散模型 Wan2.2-TI2V-5B 初始化,隐藏维度 3,072,负责统一预测未来多帧画面、标量可供性与可供性热力图三大世界状态。动作专家隐藏维度 1,024、前馈维度 4,096,依托世界专家对应层级的隐藏特征完成推理,最终输出 12 步、每步 7 维的机器人连续控制动作。
双专家通过带掩码的联合自注意力机制实现特征交互,并设置严格的单向流通约束,避免分支互相干扰。画面与标量可供性特征可双向互通,动作特征仅能被动读取画面与可供性信息、无法反向干预世界建模,热力图特征也保持独立受控交换。整套掩码机制核心屏蔽两条干扰路径:一是杜绝动作特征回流影响世界预测,保证场景理解完全纯净;二是彻底阻断热力图特征进入动作分支,杜绝外观偏好带来的推理捷径。
该设计让热力图仅通过梯度参与通用世界特征塑造,而动作专家无法依赖画面纹理偷懒,只能重点学习更稳定、跨本体通用的标量可供性交互逻辑,从结构上提升模型真实场景泛化能力。
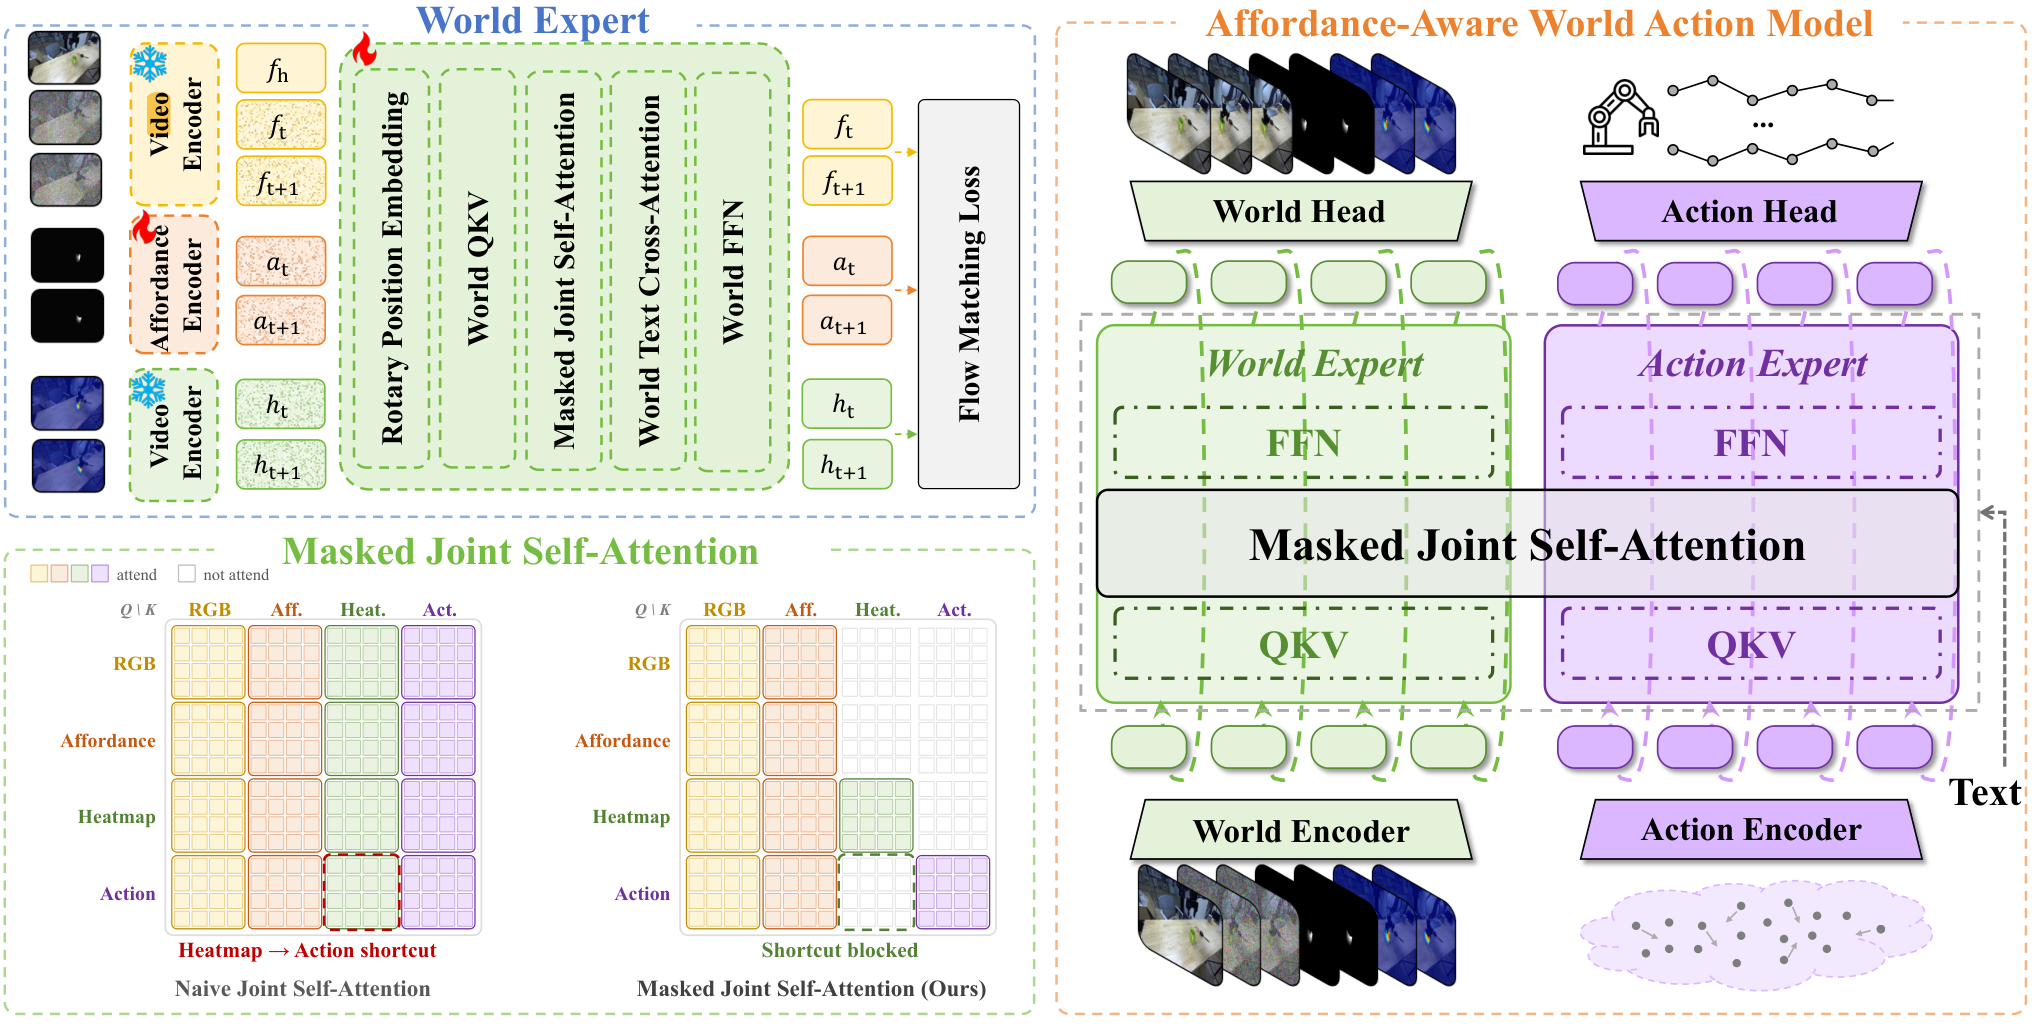
模型训练分为两个阶段。第一阶段为人机异构数据联合预训练:真人视频仅更新世界专家参数,监督三路未来状态预测;机器人轨迹数据在此基础上额外增加动作监督。训练过程穿插纯世界模型热身训练,并渐进式引入动作监督,保障模型平稳收敛。第二阶段为专项微调,冻结完整世界模型权重,仅依靠机器人视觉语言动作数据优化动作专家,总计一万次迭代更新,学习率设置为 10⁻⁵。批次采样采用混合策略,75% 样本使用带噪世界特征训练,25% 样本使用已完成预测的完整世界特征,兼顾生成鲁棒性与最终执行精度。
训练数据全部来自公开高质量数据集,覆盖海量自然人机交互与机器人实操场景。真人视频素材取自 Ego4D-FHO、EPIC-KITCHENS VISOR、HOI4D、H2O、MECCANO;机器人轨迹数据涵盖 RoboInter 旗下 DROID、RH20T 以及 BridgeData V2、InternData-A1、RoboCasa365。研究无需额外训练专用标注模型,直接复用数据集原生物体与交互区域标注,通过高斯核栅格化生成可供性分数图,逐帧峰值归一化;缺失标注区域最多插值两帧补全,遮挡场景仅保留可见区域有效特征,保证标注精准且贴合真实交互状态。
推理阶段采用双阶段生成+修正范式。画面、标量可供性、可供性热力图、动作四组潜变量均由噪声初始化,双专家通过 35 步迭代逐层交互生成世界状态与动作序列。完成首轮生成后固定世界模型输出,再单独对动作执行 8 步、修正强度 0.25 的精细化调优,最终输出可直接执行的稳定动作序列。整套训练基于 64 张 H200 显卡完成,采用 AdamW 优化器与 BF16 精度。单条训练片段总长 17 帧,包含前 5 帧观测输入、后 12 帧未来预测,帧率 10 帧/秒,图像分辨率 256×320。
04 仿真与真机上的成绩
团队在两组仿真基准和一套真机平台上验证这套方案。在 RoboCasa 上,AffordanceWAM 平均成功率为 69.4%,高于此前最优的 Cosmos Policy 的 67.1%,提升 2.3 个百分点;π0 和 GR00T-N1.5 的成绩分别是 62.5%、64.1%。CALVIN ABC→D 测试中,完成一到五项连续任务的成功率依次为 96.1%、92.8%、85.5%、77.8%、69.5%,平均可完成序列长度 4.22,优于之前最强基线 VPP 的 4.01。
一组关键对照实验固定机器人侧监督数据量,仅调整是否启用可供性预测、是否加入真人视频。只用机器人数据训练且不预测可供性时,RoboCasa 得分 57.3%,CALVIN 为 3.75;在相同数据集里加入真人视频后,两项指标回落至 55.1% 与 3.68,真人视频此时会拖累模型效果。开启可供性预测之后,仅用机器人数据训练可以拿到 63.7% 和 3.91;再引入同一批真人视频,两项指标提升至 69.4% 和 4.22。在 RoboCasa 上,有无真人视频带来的性能差距达到 7.9 个百分点。
保持机器人数据与训练流程不变,逐步增加带可供性标注的真人视频,RoboCasa 的成功率从 63.7% 单调增长至 69.4%。前 60% 的真人视频仅贡献 1.5 个百分点的提升,最后 40% 带来 4.2 个百分点,约占全部增益的 74%。
消融实验量化各模块贡献。移除可供性热力图分支,RoboCasa 成绩从 69.4% 下降到 65.4%,CALVIN 从 4.22 降到 3.99。放开热力图到动作分支的注意力,允许动作专家读取热力图特征,成绩进一步降至 63.5% 和 3.85。更换专家耦合方式同样造成性能下滑:仅在网络末端做一次特征融合时为 65.9%、4.00;先生成完整世界预测再单独运行动作专家为 64.5%、3.90;第二阶段训练取消对预测世界特征的暴露,结果是 66.6%、4.06。所有对照实验都采用三个随机种子,RoboCasa 每个种子运行 1,200 个评测回合。
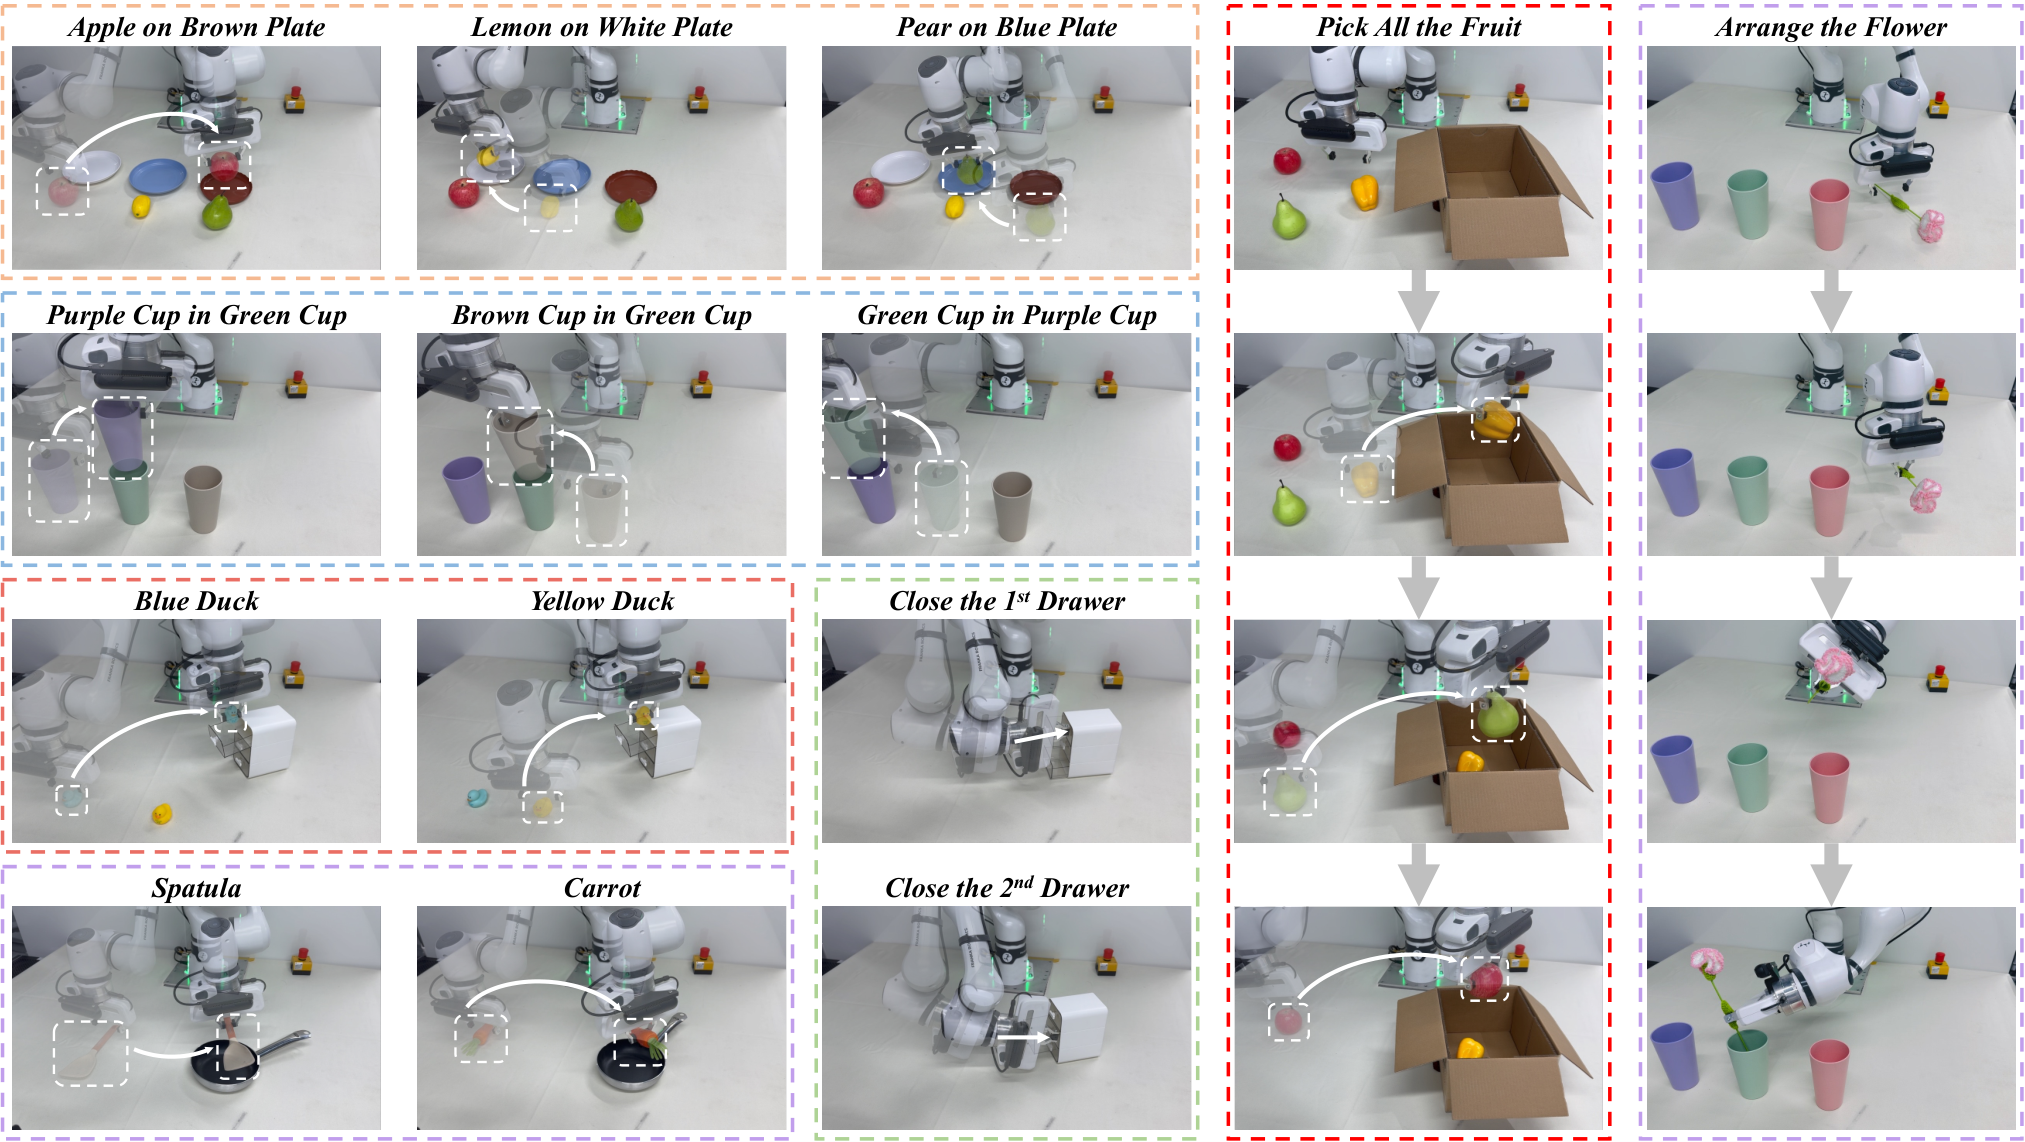
真机实验在同等条件下对比 AffordanceWAM 与 Cosmos Policy。两个模型都用每个任务 50 条示范样本微调,每项任务评测 15 次。五项基础任务要求按物体类别、颜色、形状拣选目标并完成放置,AffordanceWAM 平均成功率 74.7%,Cosmos Policy 为 42.7%。三项更复杂任务中,关抽屉任务成功率从 46.7% 提升至 80.0%;捡水果任务分档结果为 86.7%、73.3%、53.3%;插花任务 20.0% 对比 6.7%。
05 写在最后
这项研究最核心的改动,是为真人视频与机器人视频找到一套共用的预测目标。过往想要利用真人操作数据,要么把人体动作重定向成机器人关节动作,要么对齐两边的视觉画面。而 AffordanceWAM 将两类数据统一绑定到可供性预测上,真人视频无需附带动作标注,也不用提前做动作重定向,就可以对世界模型形成监督信号。
它留下了可继续拓展的接口。可供性标注可以直接从已有的物体、交互标注生成。真人视频体量越大,可供性标注覆盖越充分,机器人模型获得的增益也就越高,论文实验里最后 40% 的真人视频,贡献了大约 74% 的性能提升。想要把这套方案拓展到更多任务场景,能够标注交互区域的数据,就是整个链路的入口。