

硅谷争抢第一视角数据,中国 AI 从旧视频里找答案
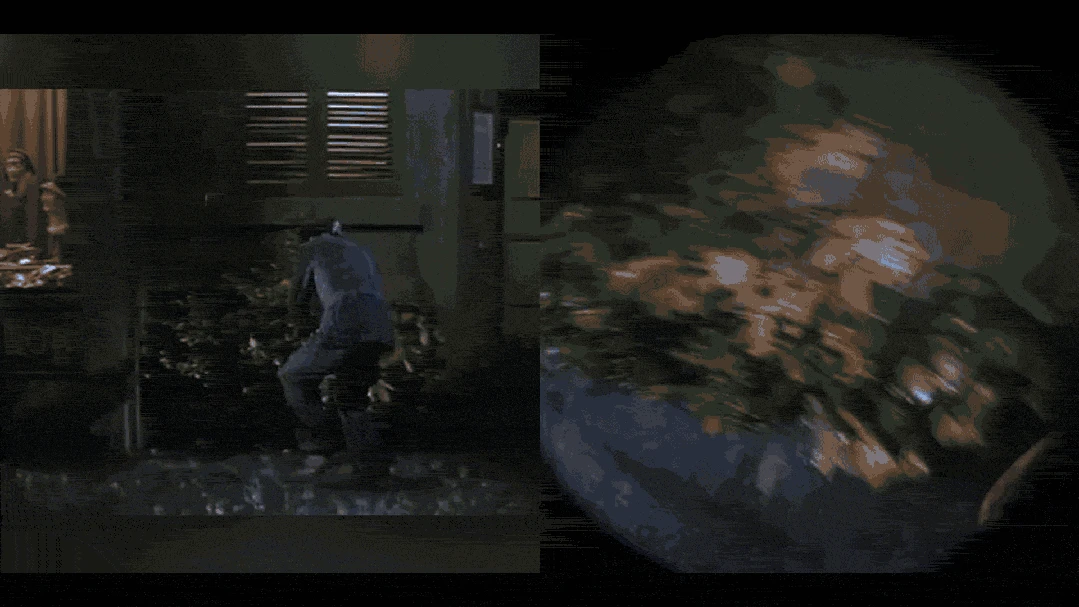
具身智能的数据荒,最近出现了一种新的解题思路:绕过第一视角采集。
过去一年,第一视角人类视频成为机器人公司重点争夺的数据资源。但获得这些数据并不容易。第一视角视频通常需要通过头戴相机等设备采集,随着任务、人员和环境不断扩展,设备投入、采集组织和质量控制的成本也会随之增加。
相比之下,互联网上已经积累了海量第三视角视频,记录着人类在不同场景下的真实操作。这些视频并非为机器人训练拍摄,却可能包含大量尚未被利用的操作信息。
既然第一视角数据如此重要,是否一定要重新拍摄?能不能通过模型,把已有的第三视角视频转换过来?
近半年,几项海外研究从不同方向探索了这种可能。
5 月,得克萨斯大学奥斯汀分校的研究团队提出 EgoExo-WM,从第三视角视频中提取结构化的人体姿态作为动作表示,并据此把视频转成第一视角,用来训练以动作为条件的第一视角世界模型。
8 月,NVIDIA 另一支团队推出 Grounded-Exo2Ego,结合三维几何重建与语义信息,以解决极端视角变化下的空间结构缺失、物体遮挡和生成一致性问题。
不同团队选择了视频生成、动作恢复和世界模型等方向,打通第三视角与第一视角之间的信息差异。跨视角生成不是新课题,但它的价值正在从视频本身,进一步延伸到机器人训练数据的生产。
这一方向最近也开始进入海外商业科技媒体和 AI 技术创作者的讨论。
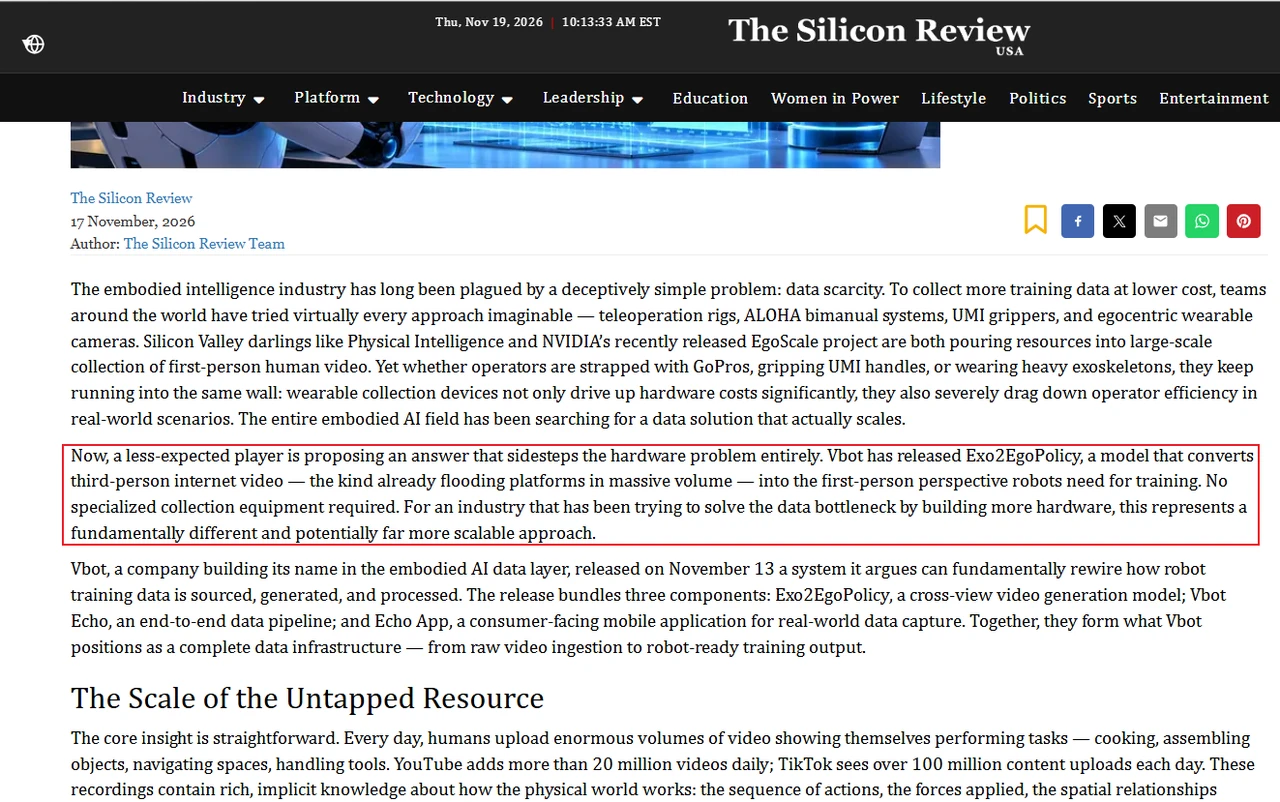
11 月 17 日,美国商业与科技媒体 The Silicon Review 刊发了一篇专题文章,将第三视角视频转换放在机器人数据采集成本的背景下讨论。文章将 Vbot 维他动力称为一个「不太寻常的入局者」。这家机器人公司没有沿着增加专用采集硬件的路径继续寻找数据,而是推出 Exo2EgoPolicy,尝试利用已有的第三视角视频,生成机器人需要的第一视角素材。
在 X 平台,也有 AI 开发者及内容创作者关注 Exo2EgoPolicy 在推理阶段无需额外输入深度数据或相机标定信息即可完成跨视角生成的能力,以及 Vbot 将手机采集与后续数据处理衔接起来的做法。
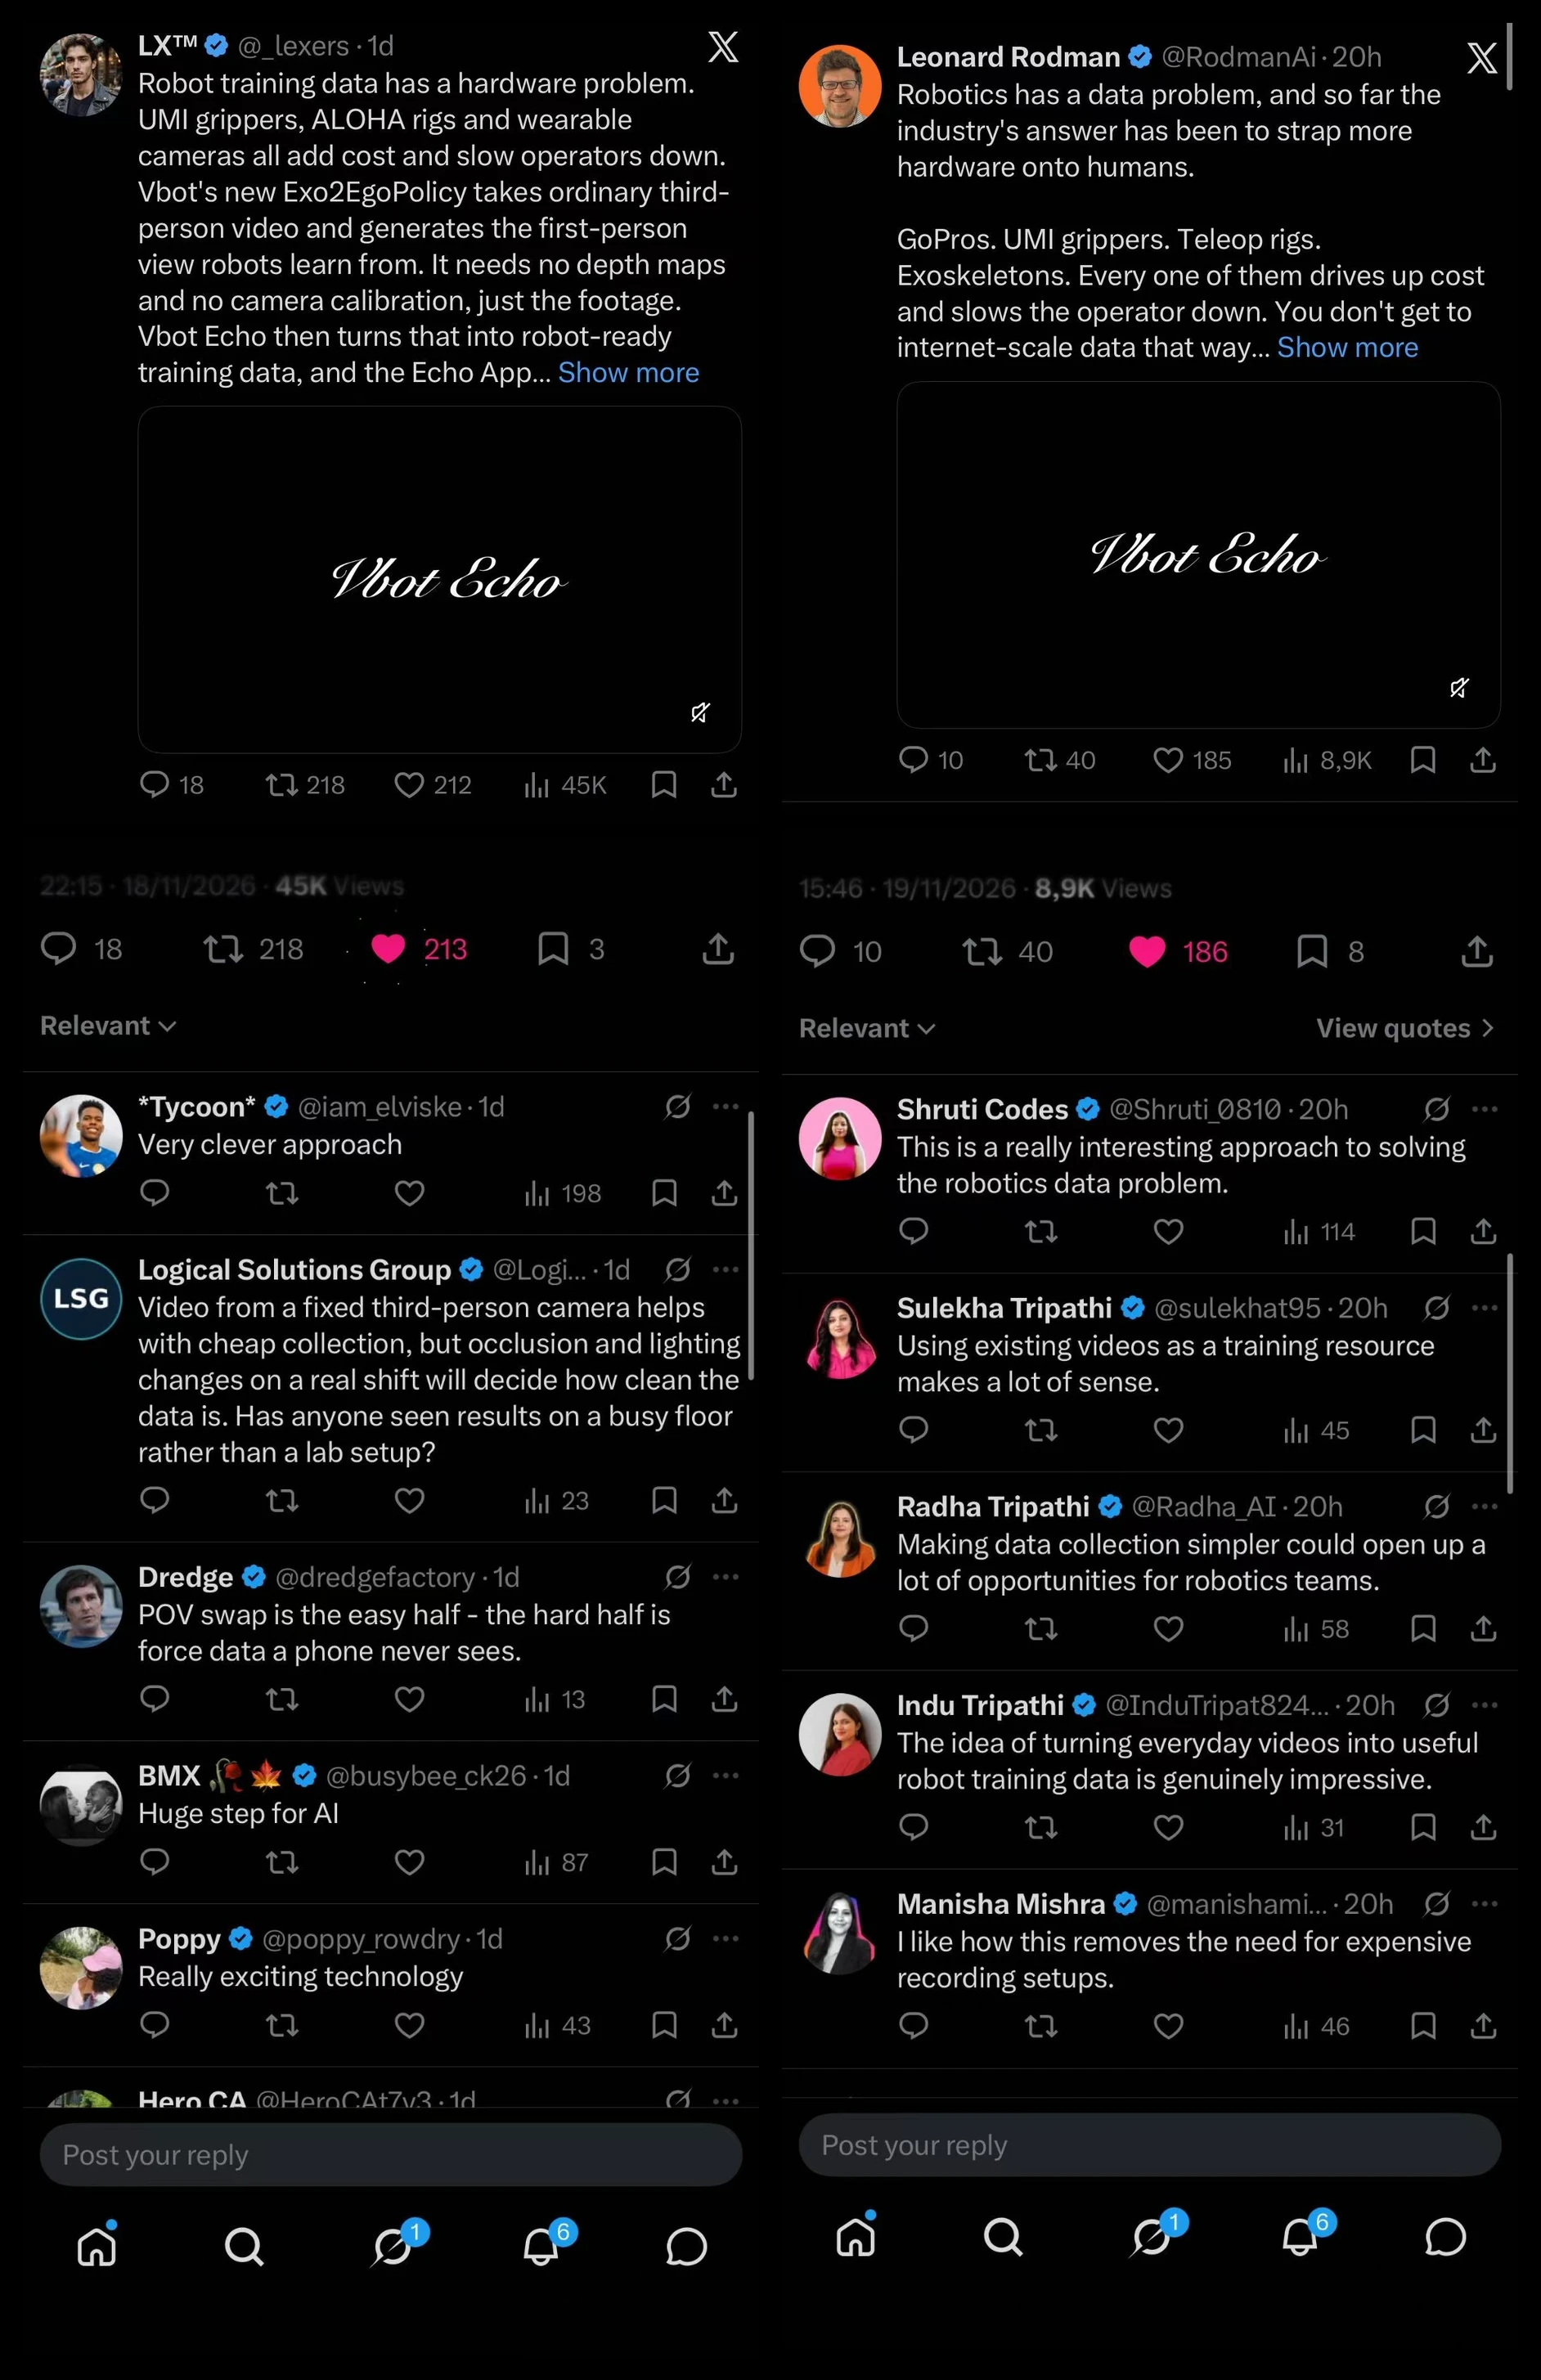
这些海外讨论所关注的,实际上是同一个问题:数据的获取,是否一定要依赖越来越复杂的前端采集设备?
Vbot 给出的方案,是保留第一视角视频这一中间表示,并针对机器人操作所需的手部结构和物体交互信息加入额外监督,再通过 Echo 管线进一步处理动作数据。
这背后是一个值得关注的取舍:过去通过专用设备解决视角和动作信息采集问题,而生成模型尝试将其中一部分成本转移到后端计算和数据处理环节。
这条路线能走多远,仍需验证。不妨先看看这个模型已经做到了什么地步。
从「旁观」变成「亲历」
1925 年,卓别林把一只皮鞋端上了餐桌。
在电影《淘金记》里,这场荒诞的「晚餐」被摄影机从桌子一侧记录下来。观众看见卓别林和同伴面对面坐着,用刀叉对付盘子里的皮鞋。
一百多年后,这场戏有了原片中不存在的另一种拍法。镜头突然来到人物眼前,餐盘占据了视野下方,双手从画面边缘伸出,对面的人变成了正前方的观察对象。
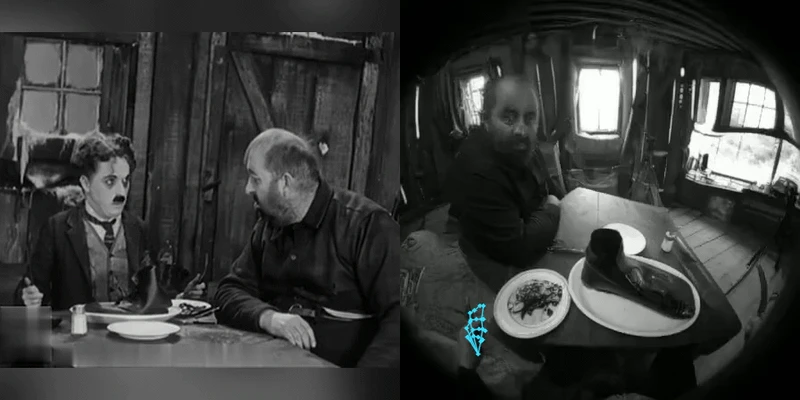
同一场戏,从看着别人吃饭,变成了仿佛自己坐在餐桌前。类似的体验还可以在诸多经典电影里感受。
《闻香识女人》人头攒动的探戈舞池里,原片镜头在全景与近景之间来回切换,生成的第一视角却始终锁住阿尔·帕西诺,他的手部骨骼则不断随着舞步变化。
如果只当特效,这无非是一种新玩法。但放到机器人学习中,这种转换的难度与价值,远不止换个镜头这么简单。
第三视角下,摄像机通常站在人物之外,可以同时看到操作者、周围环境和操作对象。但转换到第一视角后,摄像机需要移动到人物头部附近,场景中不同物体的相对位置、遮挡关系和可见区域都会随之改变。
对于跨度较小的视角变化,传统三维重建可以提供较准确的几何对应。但当镜头从人物正前方移动到其自身视角时,源视频中不可见的区域会大幅增加。模型不仅需要推断新视角下的空间布局,还要生成原始画面中没有直接记录的内容。
这也解释了为什么近年来的跨视角研究越来越多地引入生成模型:几何信息能够提供约束,但大范围不可见区域的重建,还需要利用模型从数据中学习到的场景、物体与运动先验。
Vbot 的 Exo2EgoPolicy 采取了类似思路,但在训练方法和操作信息保留上进行了针对性设计。
模型基于预训练视频扩散 Transformer,在训练中引入配对采集的第一、第三视角视频和相机几何条件,让模型学习不同视角之间的对应关系,再逐步减少对显式相机几何输入的依赖。
这样一来,模型在实际生成时,不再要求额外提供目标视角的相机标定信息,而是根据原始第三视角视频及其操作描述,推断相应的第一视角画面。
不过,视角变化只是其中一道难题。在电影或日常视频中,同一画面可能出现多个人物,拍摄镜头也可能不断切换。如果只依赖视频生成,模型就可能跟错人物,甚至混淆不同操作者的动作。
Exo2EgoPolicy 为此加入了源视频感知与推理机制,对人物、手部、操作物体和动作顺序进行分析。对于多人场景,使用者还可以通过参考截图指定需要跟随的角色。
在训练中,团队还利用同步拍摄的多个第三视角机位,在同一连续动作中切换输入镜头,并以同一个人的第一视角视频作为生成目标,让模型学习如何在拍摄角度发生变化时保持人物身份和动作过程的一致。
但对机器人操作数据而言,更难的是手。
普通视频生成模型能生成一只看起来真实的手,但其关节位置和运动轨迹未必足够准确。这些问题对娱乐视频未必明显,却可能直接影响后续动作数据的质量。
Vbot 因此在视频生成模型中额外引入两类手物交互监督。一类是语义分割,让模型学习识别并区分双手、手臂、操作物体和背景,约束它们在连续画面中的空间关系。另一类则直接针对手部结构。团队利用 ACE-Ego-Hand 模型提取手部特征、关节关键点和运动信息,将其作为视频生成阶段的辅助训练目标,尽可能让生成画面中的手指结构和动作变化保持合理。
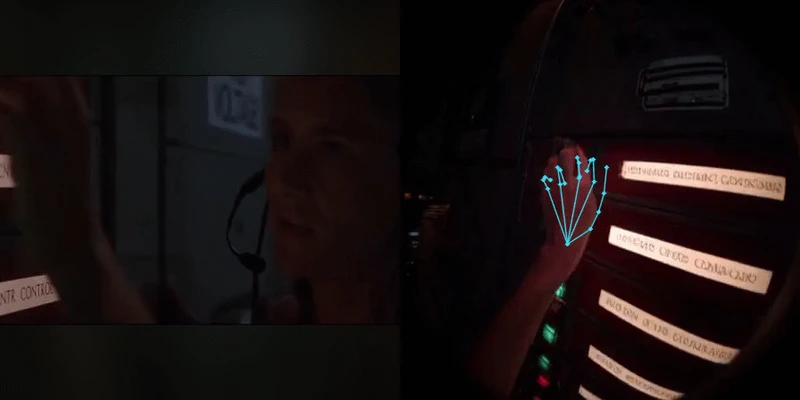
在包含 546 个片段的验证集上,与仅优化 RGB 视频的基线相比,引入 ACE 手部监督后,生成视频的手部关键点 PCK@5% 指标由 11.52% 提升至 20.02%,平均关键点位置误差由 57.09 像素降至 47.42 像素。
这说明在该测试设置下,生成画面中的手部关键点更容易被提取,定位也更准确。论文也指出,第三视角视频中被遮挡的手指、物体表面及头部运动,可能对应多种合理的第一视角结果。模型生成的是一种推断,并非对未被拍到的信息进行真实测量。
这也让 Vbot 与现有研究的差别更加清晰。NVIDIA 的 Grounded-Exo2Ego 更关注几何与语义约束下的生成质量;Amazon 与石溪大学的工作绕过像素生成,直接恢复手—物姿态,并报告了策略层面的结果;Vbot 选择保留第一视角视频这一中间表示,同时加入手部和语义监督。目前,Vbot 公开的评估集中在生成与手部提取层面,策略层面的结果还有待披露。
即便如此,这项尝试把视角对应关系交给生成模型学习的工作仍然很有意义。过去无法直接用作第一视角训练素材的视频,可以通过模型进行转换;而且生成过程不必只追求视觉逼真度,还能针对机器人学习需要保留的动作信息进行优化。
当大模型开始生产机器人数据
但视角转换,从来都不是最终答案。人类视频记录了操作过程,却通常不包含机器人需要的关节角度、控制指令和接触力信息。人与机器人在身体结构、自由度和关节约束上的差异,又使得人的动作无法直接复制到机器人身上。
从观看他人操作,到自己动手,中间仍有一道门槛。
今年 5 月,Vbot 创始人余轶南在凤凰网科技的采访中说,当下流行的数据采集方案是第一人称视角,但第三人称视角同样重要。他的理由是,人本身就会通过观察他人的动作学习,再以自己的视角实践,两种视角应该结合。
Vbot 的做法,是做成一条管线,让各种数据都能为具身所用。Exo2EgoPolicy 先把第三视角的视频转成第一视角的画面;随后,Vbot Echo 管线从画面里恢复出手的骨架,把动作适配到机器人身上,并在仿真里检查它做不做得到。
整套流程完成的,是从第三视角视频到第一视角观测,再到人体动作表示、机器人动作适配及物理一致性检查的多级转换。
这与 Vbot 的模型思路一脉相承。余轶南此前在接受极客公园采访时表达过一个判断:具身智能的世界模型与运动控制、操作模型可以分开训练,再通过隐空间 Token 融合。
类似的分工,在刚刚结束的 CoRL 2026 上成为一个反复出现的讨论。
NVIDIA GEAR 团队负责人 Jim Fan 在大会上介绍了 GR00T 2。这是一种世界—动作模型,被 NVIDIA 定位为 System 1。它能够联合预测未来视频和机器人动作,并与上层推理模型协同:推理模型负责任务拆解、过程检查和纠错,GR00T 2 负责具体的物理操作。
清华大学教授赵行则从不同的时间尺度解释了分层的必要性。在他的框架中,System 2 负责相对慢速的理解与规划,System 1 需要以几十赫兹的频率响应物理交互,System 0 则进一步承担更高频的接触反馈与底层控制。
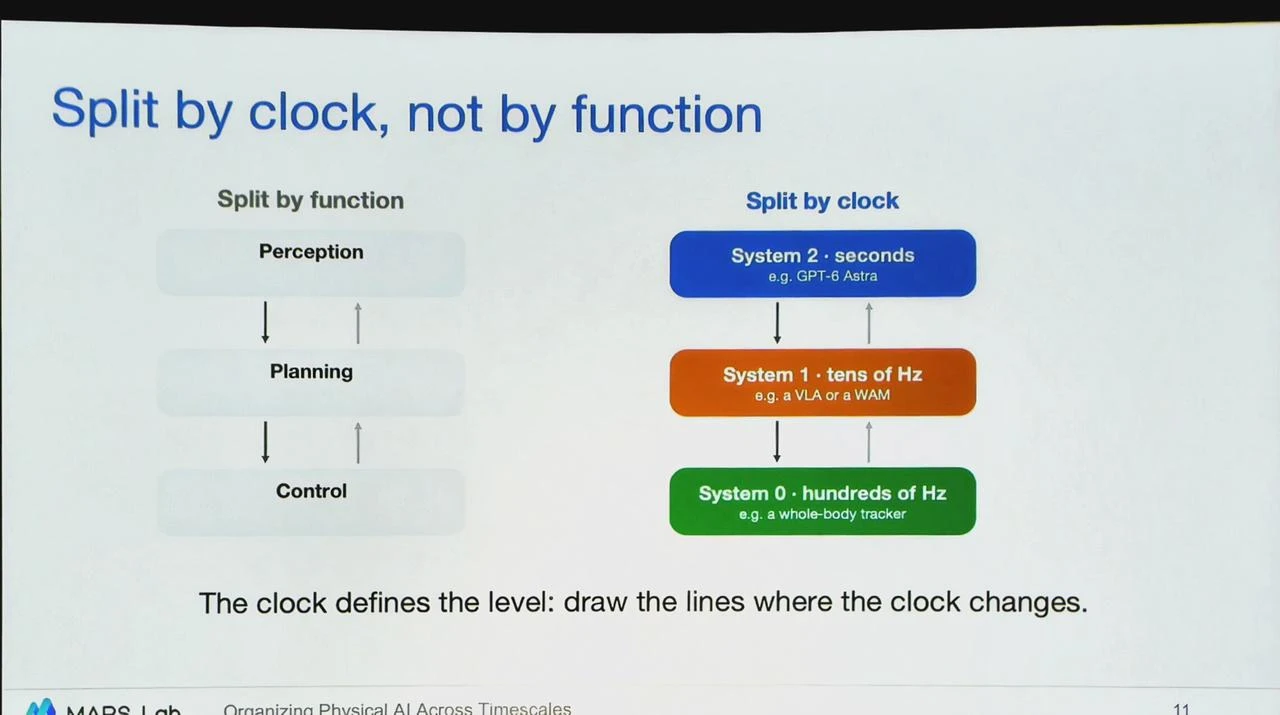
类似思路也已进入产品架构。今年 Figure 推出的 Helix 02 中,System 1 以 200 Hz 输出全身关节目标,System 0 则以 1 kHz 进行底层控制。
几家团队的具体技术架构并不完全相同,却共同指向了一个问题:当通用模型越来越擅长理解任务、制定计划,如何把这些理解转化为快速、可靠的物理执行,正在成为机器人能力提升的关键。
余轶南最近用自动驾驶做了个类比。在他看来,System 2 可以提出高层规划,System 0 负责底层执行,但夹在中间的 System 1 最难:既要理解上层意图,又要完成具体的运动规划,还得持续关注执行过程,及时发现和纠正偏差。
他甚至将 System 1 形容为机器人系统里「最后兜底」的一层。
但 System 1 的能力从哪里来?
环境理解、状态预测可以从大规模人类视频中获得监督,而要让机器人真正执行动作,还需要建立视觉观测与动作之间的联系。这意味着,训练数据除了视频画面,还需要尽可能包含手部运动、物体状态和交互过程等信息。
这也解释了 Vbot 为什么没有止步于第一视角视频生成,而是进一步尝试从中恢复动作与交互信息。它希望解决的不只是视角差异,还有普通视频与机器人训练数据之间的信息缺口。
更值得关注的是,在这套方案里,生成模型开始承担数据生产中的一部分工作。它能把原本难以直接利用的内容,转换成新的训练素材。
同样在 CoRL 2026 上受到关注的 NVIDIA 与 UCLA 联合研究 GRAIL,选择了另一条路径:利用可控的三维场景和视频世界模型生成交互过程,再将生成的人—物运动转换为机器人训练数据,并进行物理验证。Vbot 并不从零生成新的操作场景,而从已有的第三视角视频出发,通过生成模型和后续管线,挖掘其中尚未被充分利用的操作信息。
目前,Vbot Echo 已全面开放,任何团队都可以接入这套管线,将手中的第三视角视频转化为机器人训练数据;也可以通过 Echo App 采集真实场景数据,加入这套生产体系。
不过,跨视角生成需要推断不可见的信息,手部运动恢复可能产生误差,动作重定向与物理校验也会增加计算和处理成本。经过多级转换的数据,最终有多少能够用于机器人训练,仍需要实际检验。
这条路线真正的吸引力在于长期规模。
相比需要持续投入设备、人员和场地的专业采集,存量第三视角视频已经覆盖大量不同场景与任务。如果模型能够在可控成本下提高存量视频的利用率,即便不替代专业采集,也可能为机器人数据生产打开新的空间:存量视频就有望成为数据来源;家庭等难以进入的场景,有机会靠普通手机覆盖。
这也让 Vbot 此时投入数据管线的逻辑更加清晰。这大概也解释了,为什么海外研究者会开始认真测试这个来自中国的模型。
当行业开始更加重视将理解转化为执行,动作与交互数据的价值随之凸显;而第三视角视频虽然尚未成为成熟的低成本数据来源,却提供了专业采集之外的长期扩展空间。
机器人数据的规模化,也许不再只是让更多人拿起相机,还要让已经拍下来的海量人类操作,真正成为机器人能够学习的经验。
发现文章有错?告诉我们