

Chelsea Finn:不必显式世界模型,端到端策略也能做长任务 |CoRL 2026
作者:大吉
11 月 12 日上午,机器人学习会议(CoRL)在奥斯汀 JW Marriott 的 Brazos 房间举行半日工作坊「机器人需要世界模型吗?」(Do Robots Need World Models?)按照工作坊的官方说明,世界模型(world model)被看成一类预测系统,用来让机器人预判自己的动作会怎样改变环境。
争论在于:这种预测结构要不要被显式做出来,以便规划、做反事实推理,并服务于数据效率、安全性和泛化;还是可以被端到端策略(end-to-end policy)吸收进去,由策略把观察和目标直接映射成动作。
斯坦福大学计算机科学与电气工程助理教授、Physical Intelligence 联合创始人 Chelsea Finn 是当天第一场邀请报告,她被分在端到端、隐式策略这一侧。这是主办方分配的立场,不一定代表个人观点。她开场说,自己站在这张桌子的另一侧。工作坊列出的第一项动议,也正是:端到端策略可以内化机器人行为所需的预测结构,而不必试图显式建模世界。
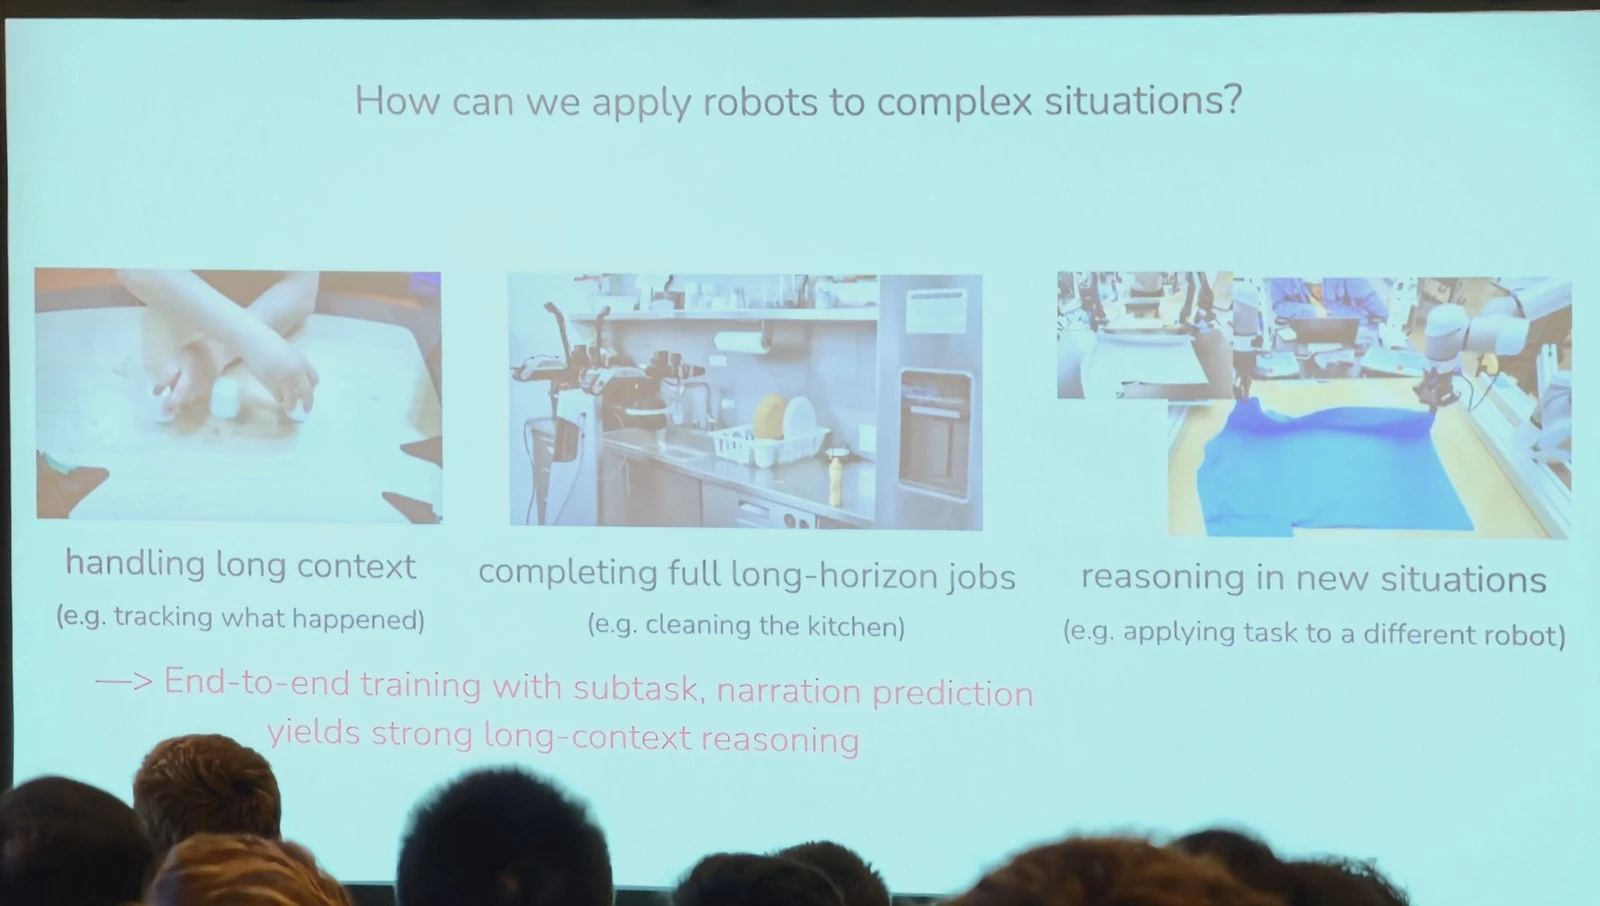
Finn 开场说,尽管她自己有过偏显式模型的旧工作,但经验是:即使没有对世界的显式预测模型,机器人也已经能做相当复杂的事,包括对长上下文历史做推理、完成长时程任务,以及在需要推广行动后果的场景里工作。
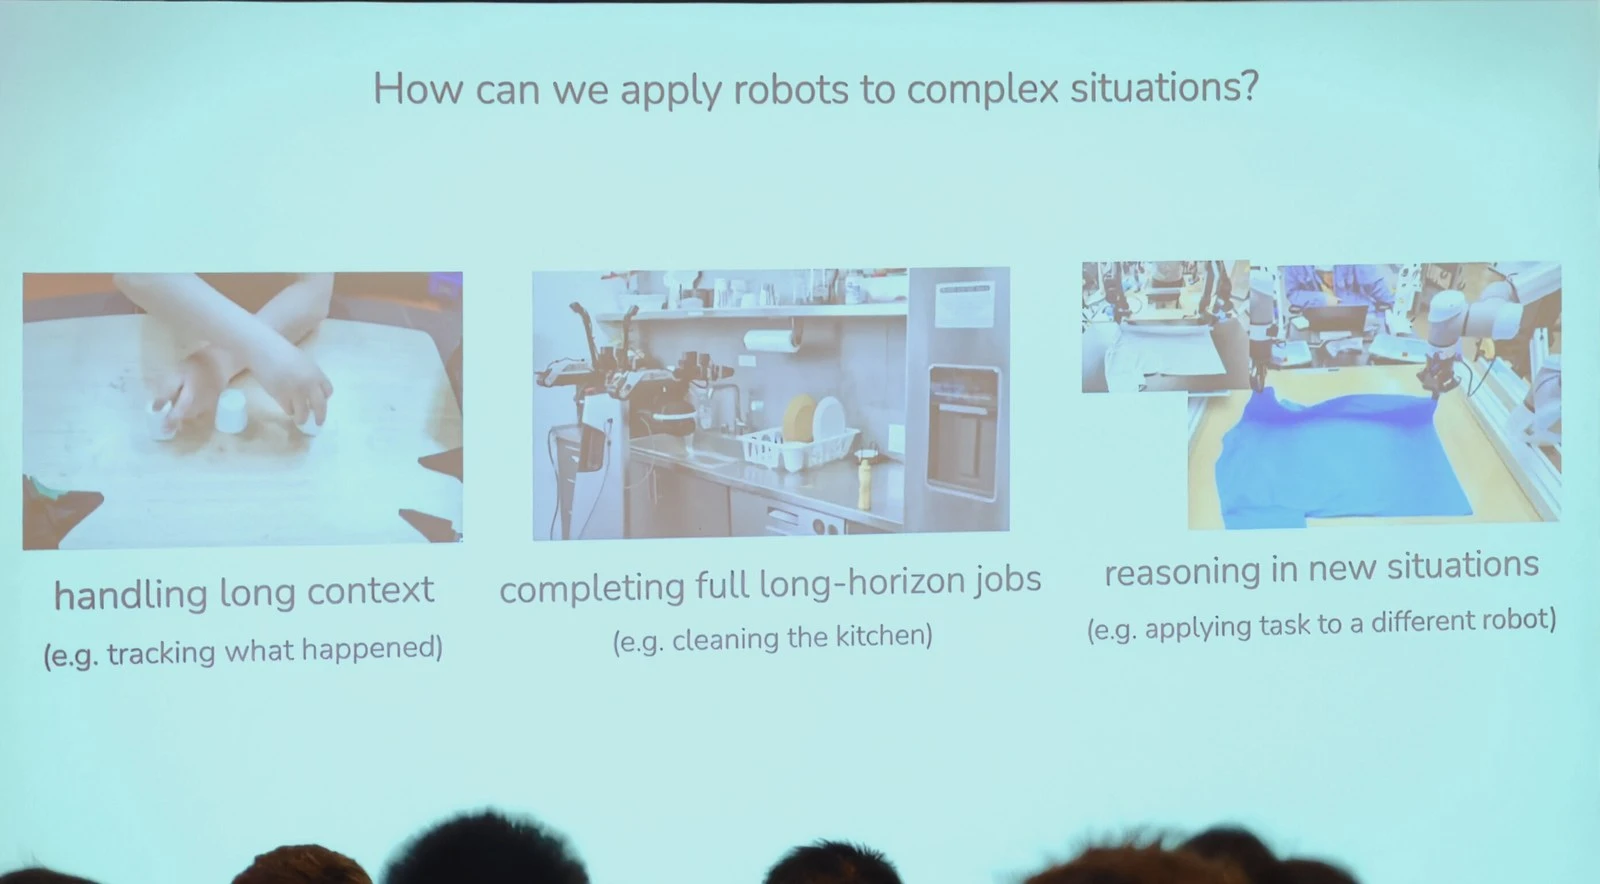
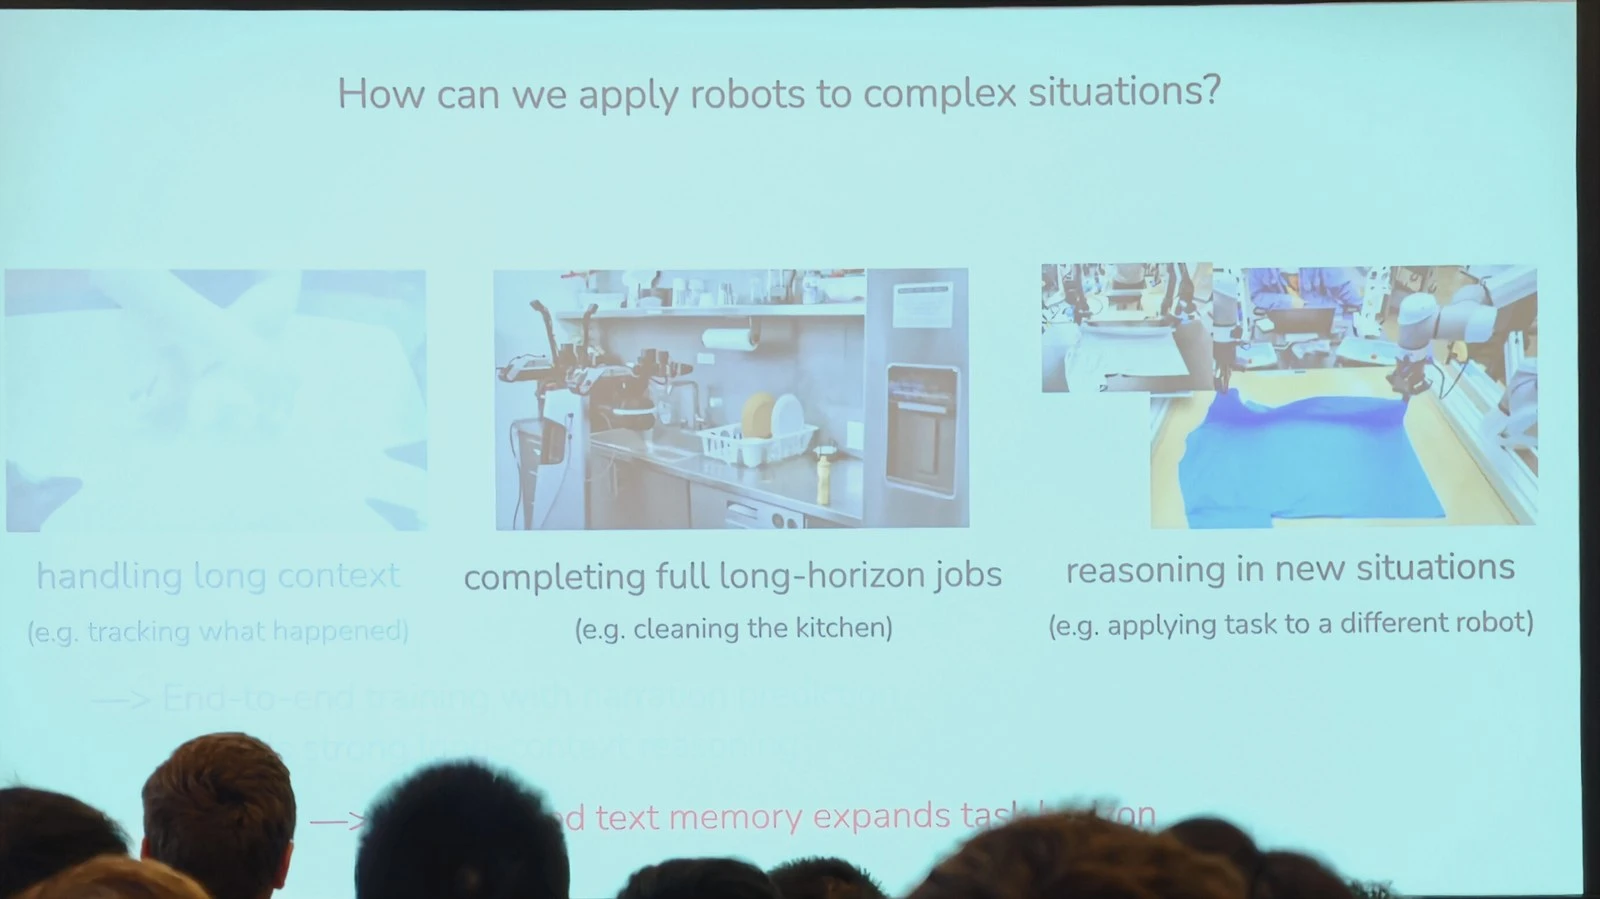
她要问的是,怎样把机器人用到复杂情境里,以及是否真能在不显式建模世界的情况下,学到能处理这种复杂度的策略。
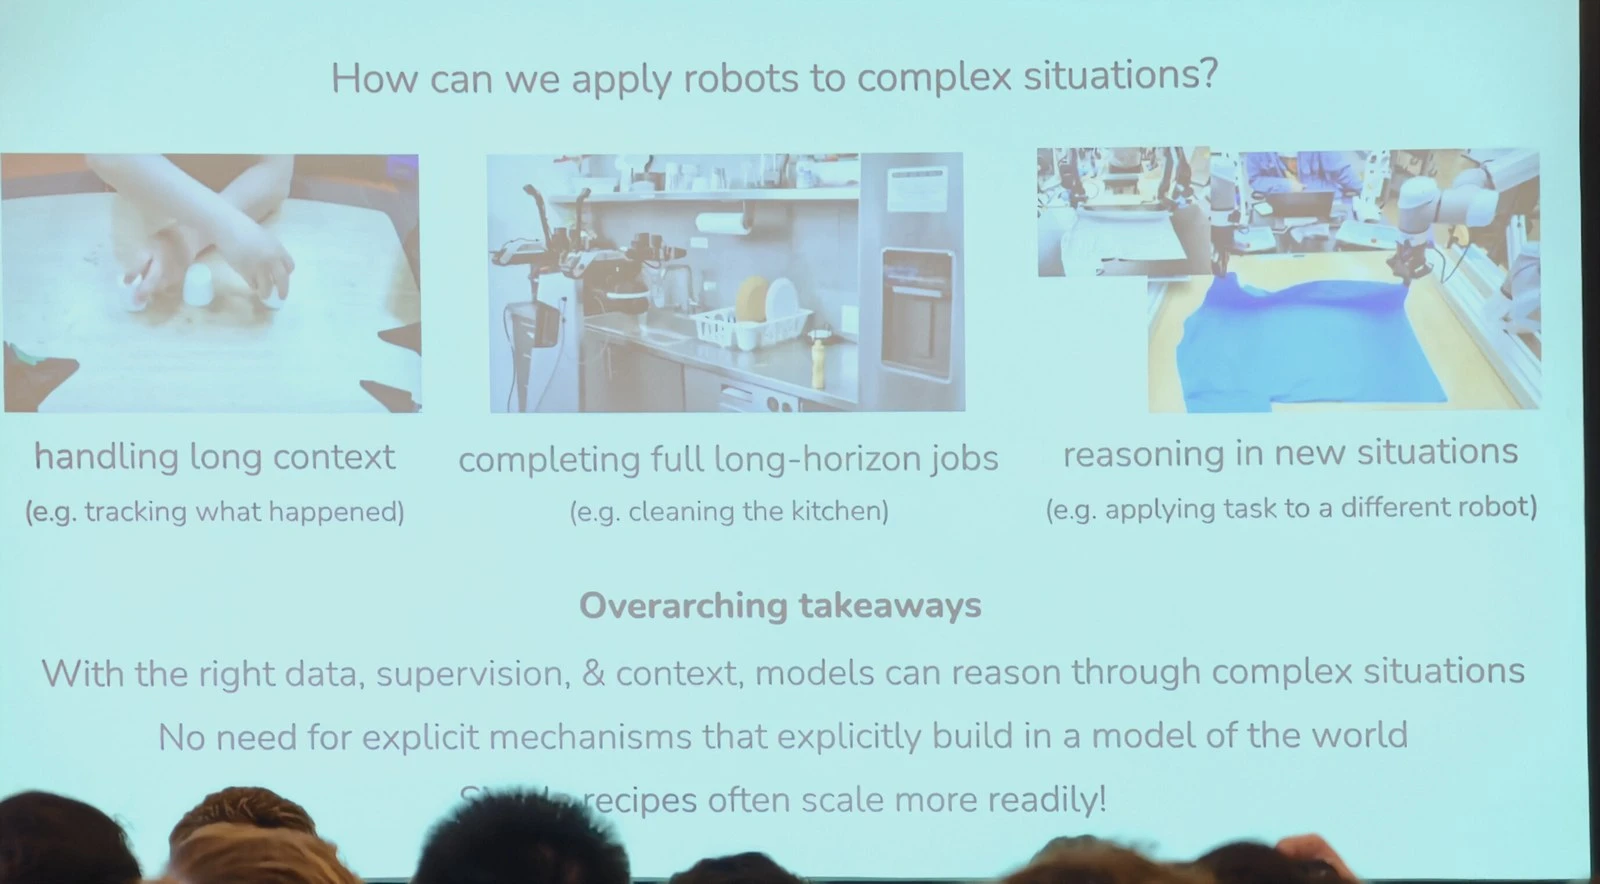
报告分三部分:处理长上下文,例如跟踪已经发生过的事;完成整段长时程工作,例如打扫厨房;在新情境里做推理,例如把已有任务用到另一台机器人上。
加了记忆,有时比没有更差
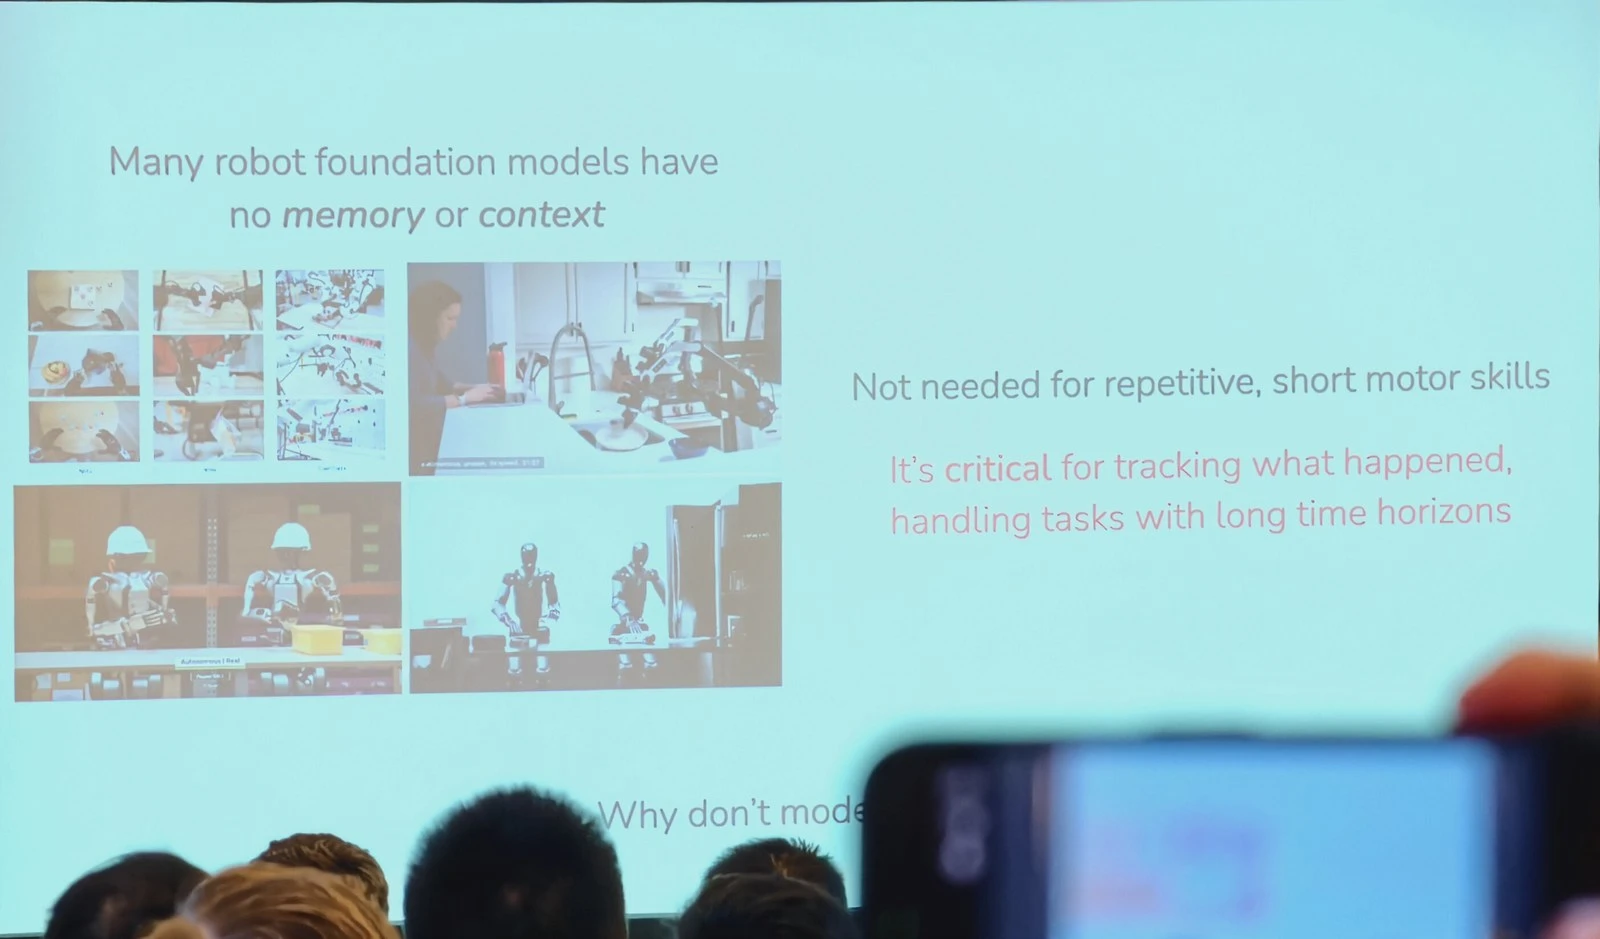
她先指出,很多很强的机器人基础模型其实没有记忆或上下文。对重复性的短时运动技能,这并不需要;可一旦要跟踪已经发生过的事,或处理时程很长的任务,对过去的记忆就变得关键。现有模型却还是常常没有记忆。她讲了两个困难。
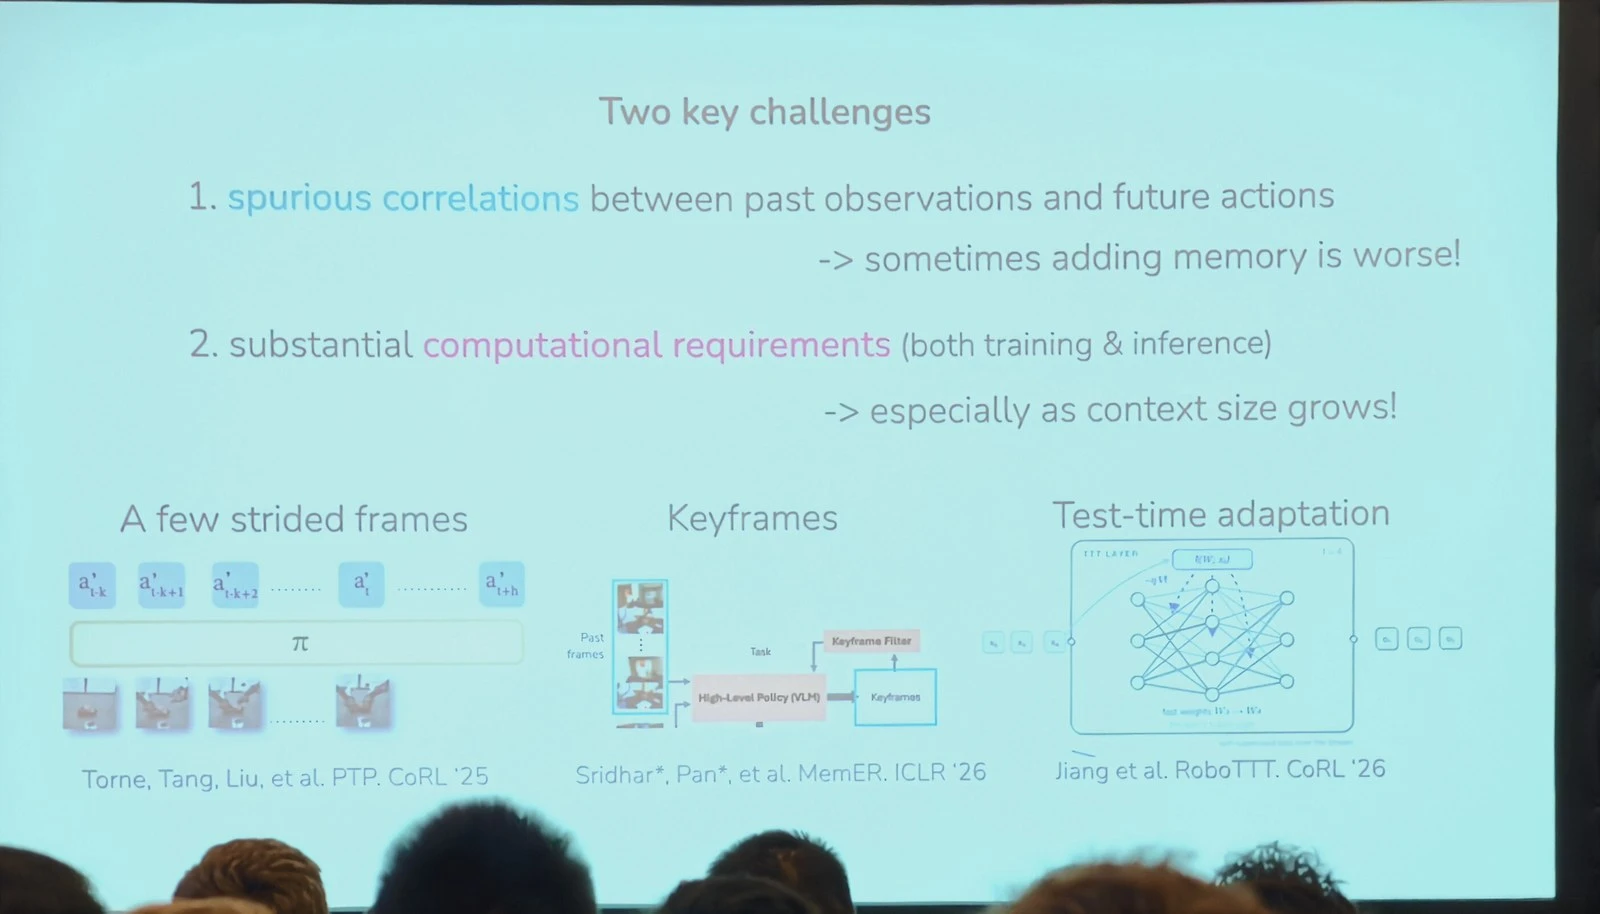
一个困难是学习信号本身。给模型加大量记忆后,过去的观察和未来动作之间会出现虚假相关(spurious correlations)。上下文越长,送进模型的信息越多,输入和输出之间出现的相关也越多,模型就越难学到能够泛化的动作预测。她说,这个问题足够严重,有时加了记忆,表现反而比完全没有记忆更差。
另一个困难是计算,训练和推理都包括在内。训练和推理都不再只送进一两张图,而是希望送进几百张图,计算量会差几个数量级,上下文越大,这个问题越突出。推理还希望实时完成,训练同样更难。已有工作在应对这一点,例如只用少量步进帧(strided frames),对应 Torne、Tang、Liu 等人在 CoRL 2025 的 PTP;用关键帧(keyframes),对应 Sridhar、Pan 等人在 ICLR 2026 的 MemER;以及测试时适应(test-time adaptation),对应 Jiang 等人在 CoRL 2026 的 RoboTTT。
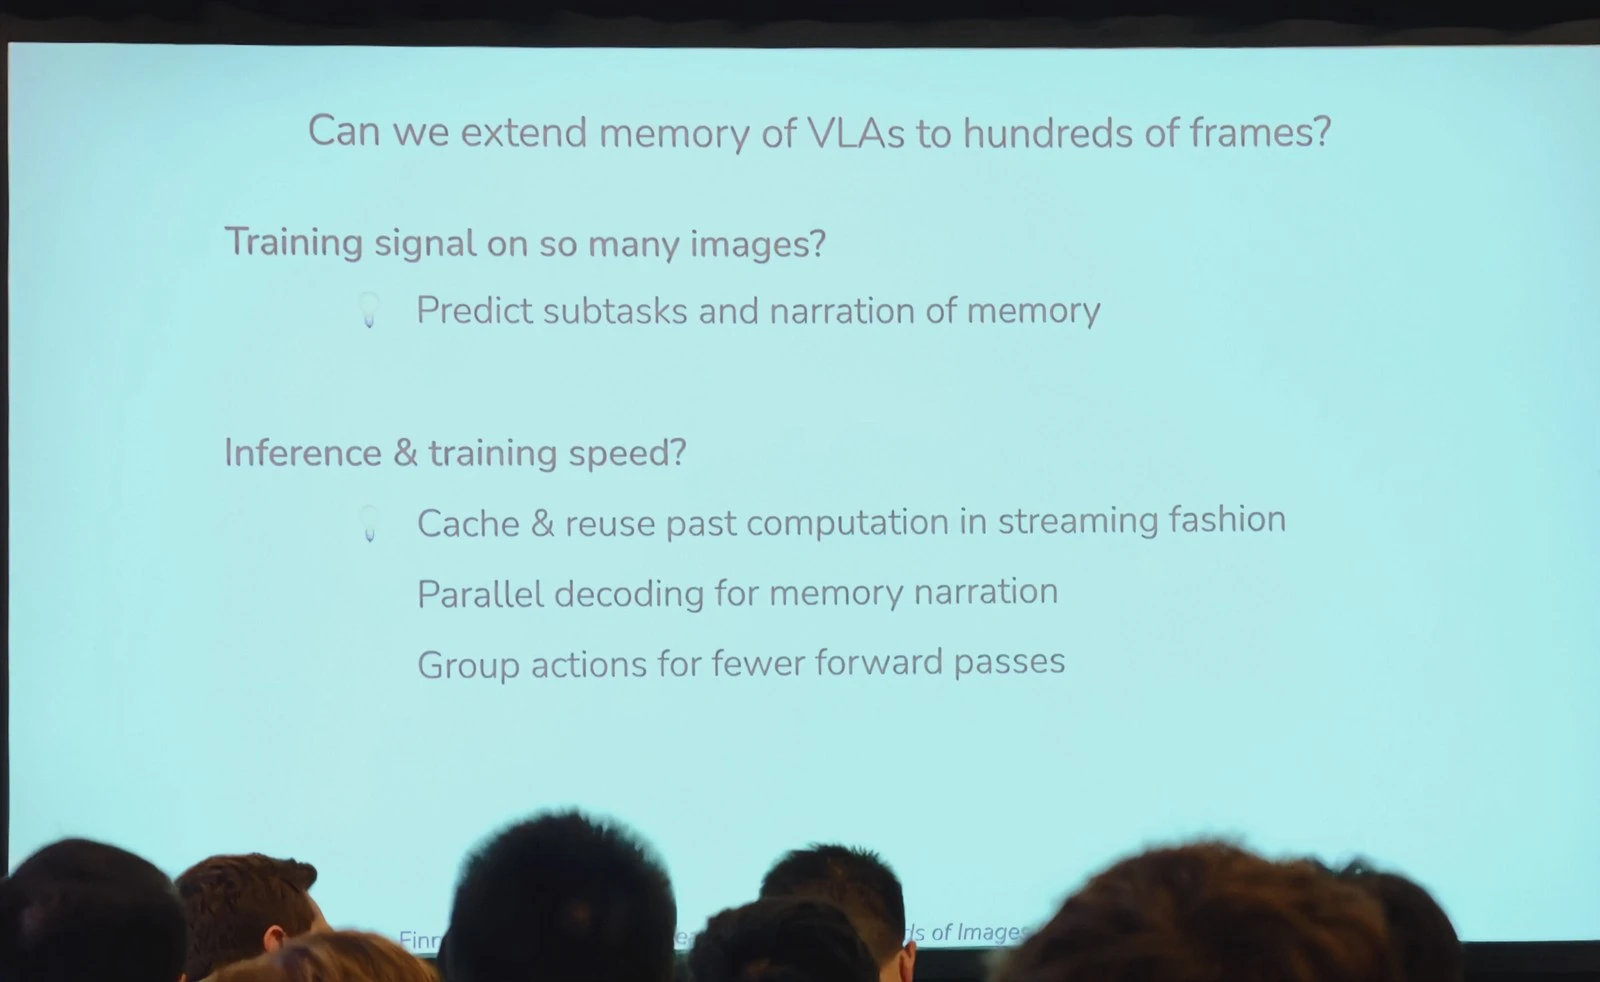
这些工作确实让策略开始能根据过去发生的事采取行动,但某种程度上是在回避计算负担。她认为,长远看机器人仍会需要相当好的上下文。第一部分要问的,就是能不能把视觉语言动作模型(VLA)的记忆扩展到几百帧量级,以及在这么多图像上能不能拿到可用的训练信号。
针对虚假相关、又难以从海量帧里学会的问题,他们发现很有用的做法,是在预测动作之外,再给模型加隐式监督信号(implicit supervision):既预测当前正在做的是什么任务,也对记忆里正在发生的事做叙述(narration)。这种持续叙述能帮助模型学习特征,理解过去的帧和视频。
具体做法是以视觉语言模型为骨干,训练它接收较长视频。骨干是 Qwen3.5-4B(40 亿参数),上下文长度是 26.2 万个标记。模型有三路输出:一路是推理,也就是按时间叙述到目前为止发生了什么,例如「在第 2 秒,球被放到了中间那个杯子下面。在第 5 秒,中间和右边的杯子对调」;一路是子任务,例如「举起左边的杯子」;一路是动作标记。叙述这一路采用并行解码,一次前向计算即可。动作标记采用 OAT,分组为 1、1、2、4、8、16。
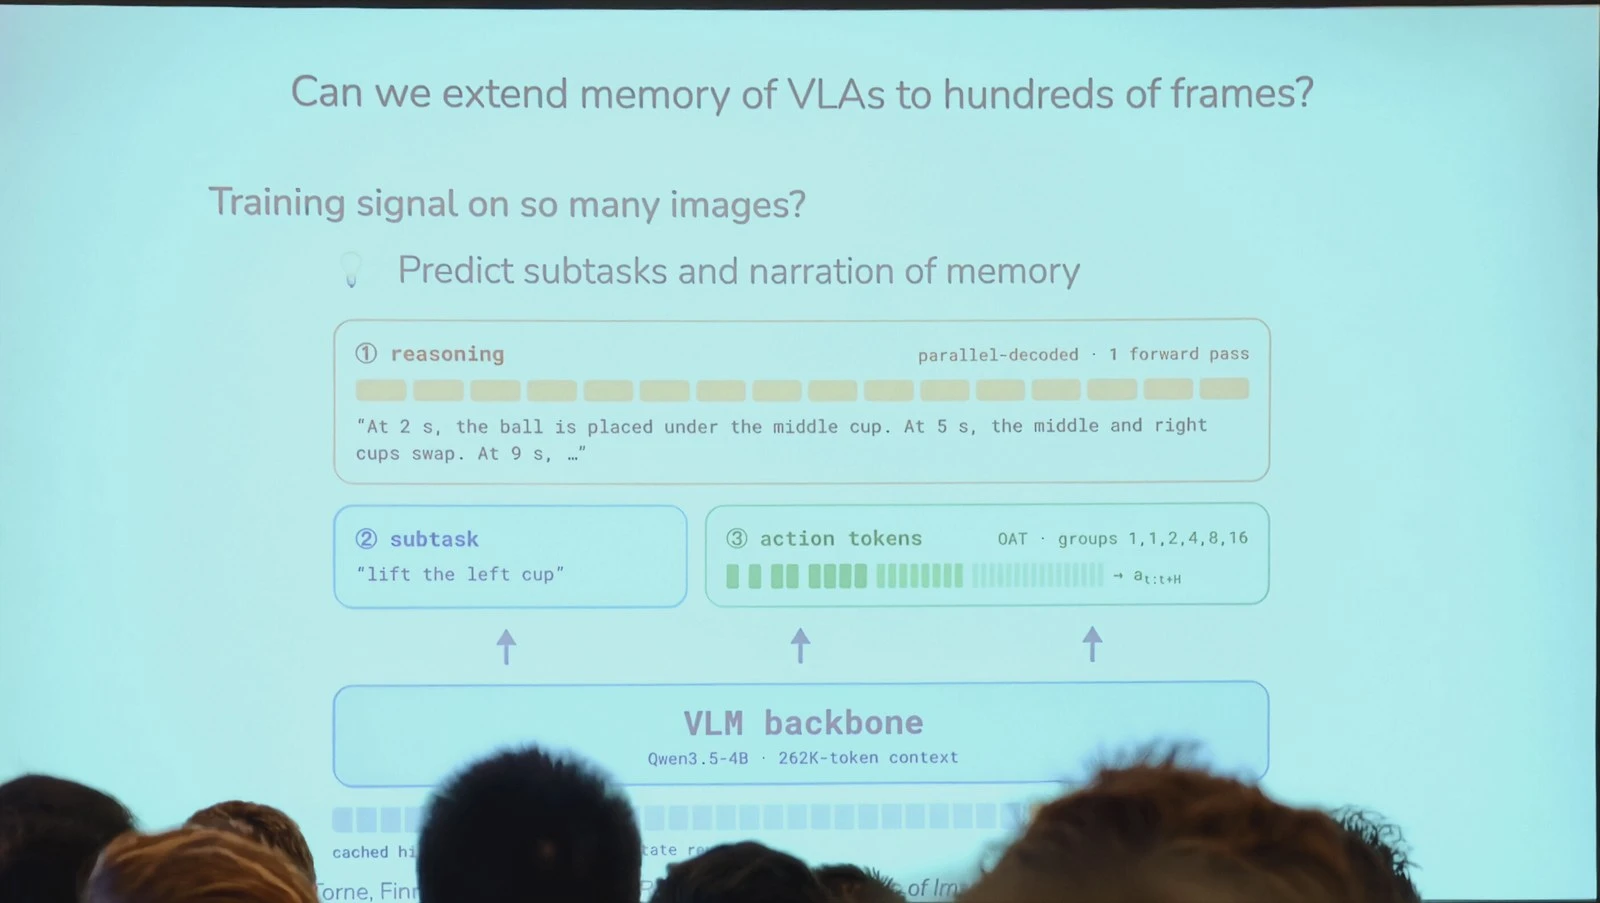
计算上,他们尽量避免把已经处理过的过去反复算一遍。不必每次推理都把过去视频从头算起,可以缓存(cache)已有计算,把视频流式送进模型,从而不必反复重算过去帧的激活。叙述文本如果自回归生成会慢,他们就把叙述解码做成并行,测试时不必先生成叙述再预测动作。动作这一侧使用离散化动作,并把动作打组,以减少前向计算次数。
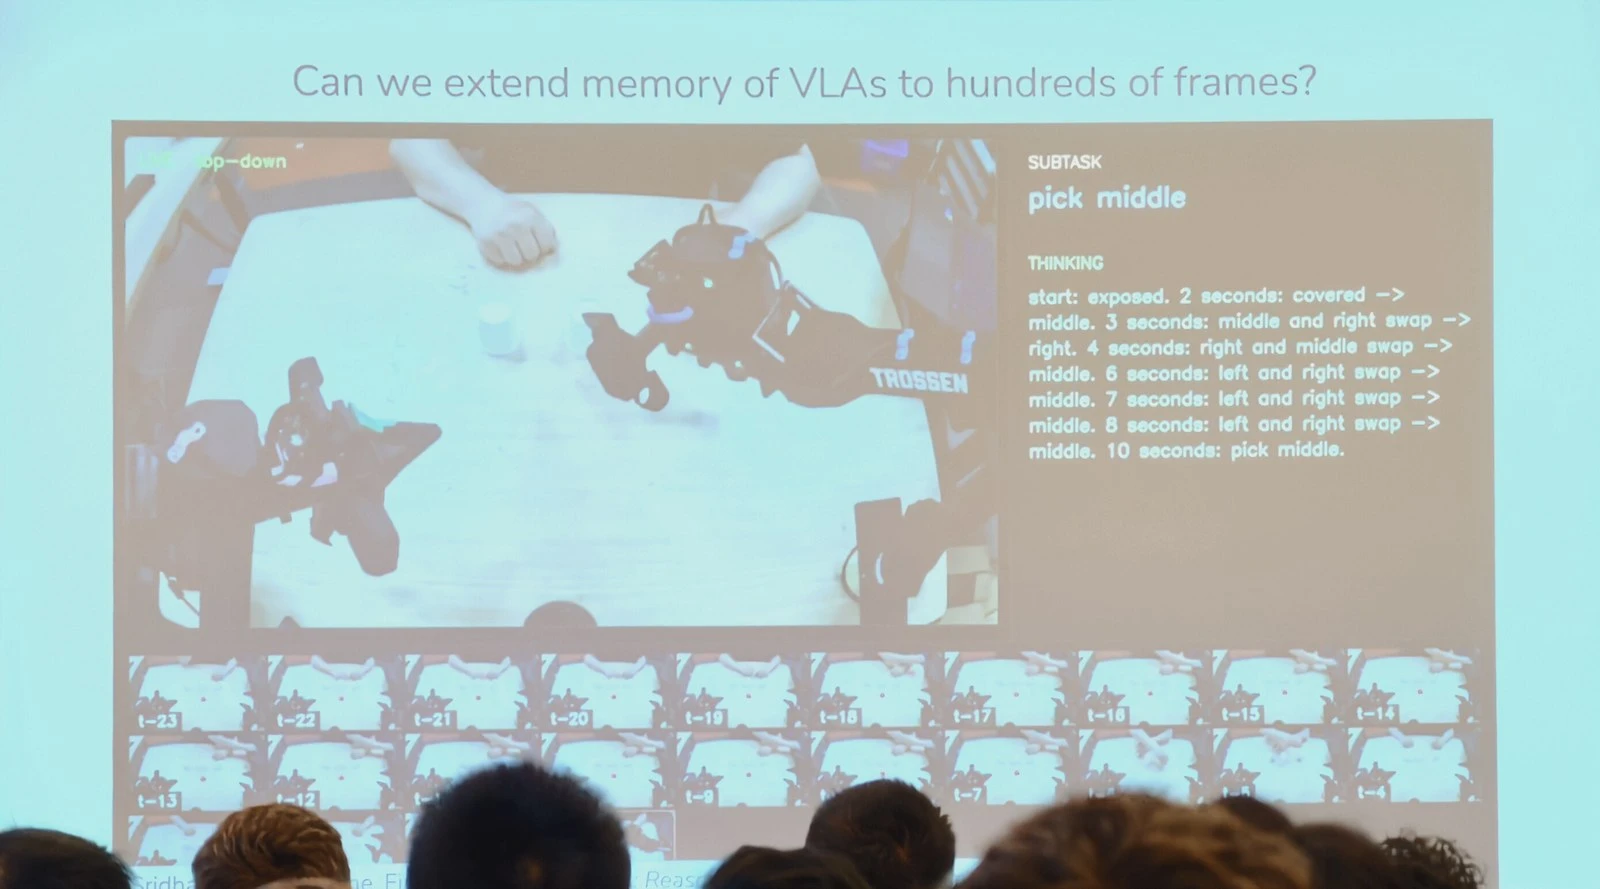
合在一起后,他们在杯子交换这类记忆任务上做了测试,要跟踪物体在哪里。演示里的子任务是「拿中间那个」,模型要按时间记下杯子何时被盖上、哪两只杯子对调,最后才能拿对。她说这不是她最喜欢的任务,因为并不是机器人真正需要做的事,但作为检查很合适:不能只检索某一帧,必须对整段视频里发生的事做推理,才能做对。模型为此任务做了微调,并在训练时没见过的槽位或组合上表现出了泛化。她还强调,这是 1 倍速视频:尽管送进的记忆很长,推理速度并没有拖慢机器人运动,动作仍然比较平滑。
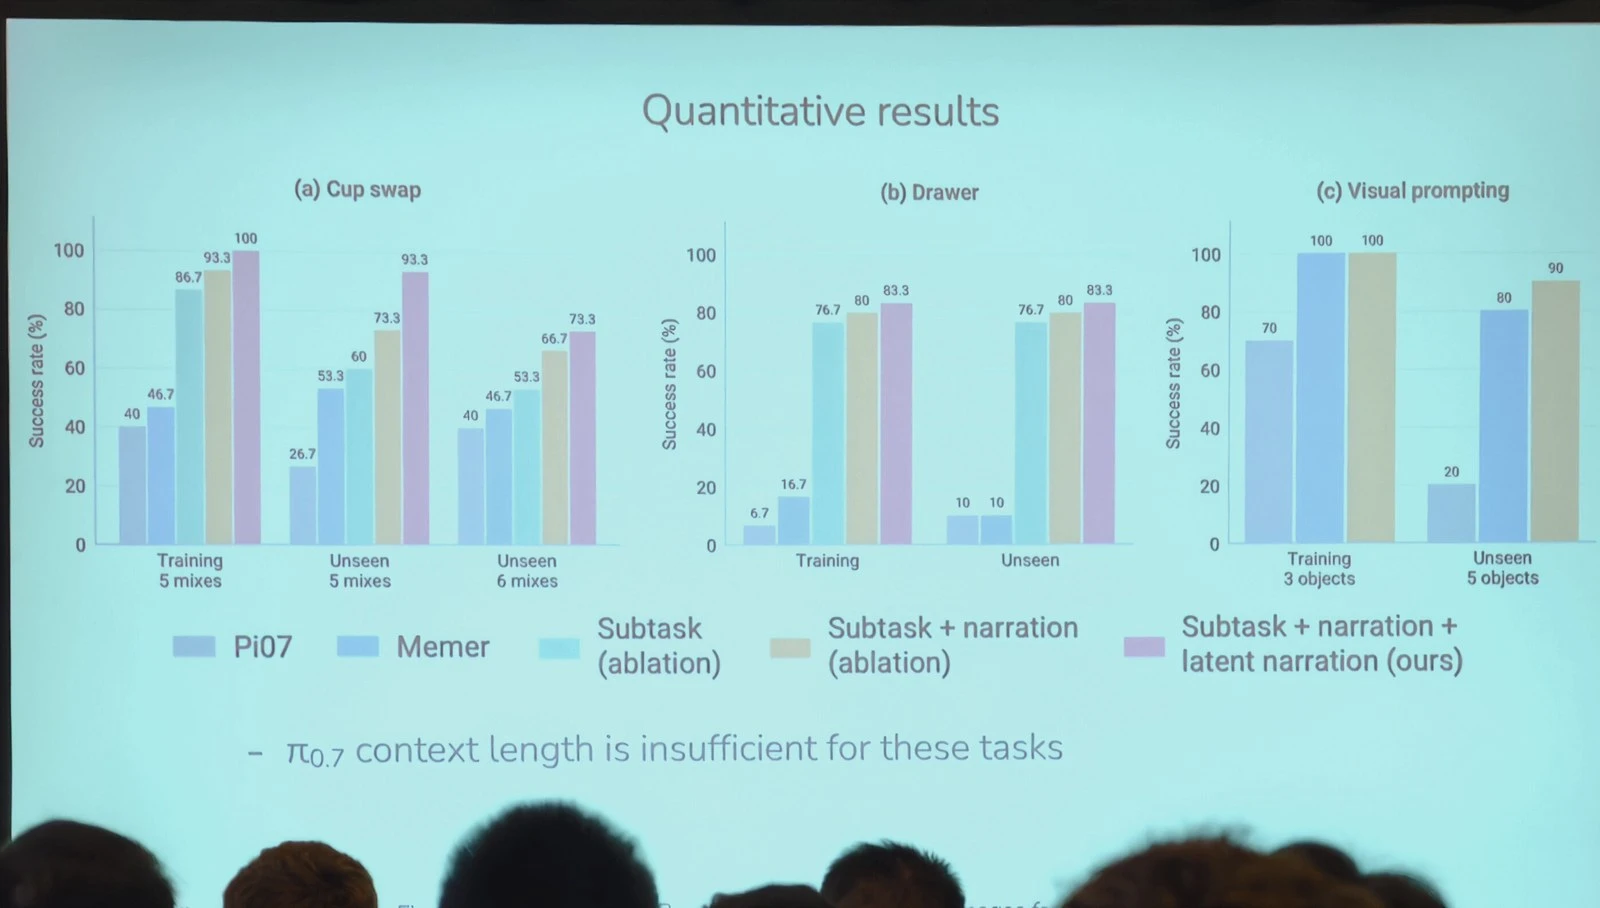
定量结果覆盖三项任务:杯子交换、抽屉,以及视觉提示。对照方法包括 π0.7、MemER,以及只预测子任务、预测子任务加叙述这两项消融。他们自己的方法是子任务、叙述,再加上潜在叙述(latent narration)。π0.7 的上下文长度不够做这些任务。
杯子交换里,训练所见的 5 种混合上,他们的方法成功率是 100%,未见过的 5 种混合上是 93.3%,未见过的 6 种混合上是 73.3%,都高于 π0.7、MemER 和两项消融。抽屉任务上,π0.7 和 MemER 的成功率很低,训练设置里分别是 6.7% 和 16.7%,他们的方法在训练和未见设置里都是 83.3%。视觉提示任务里,训练 3 个物体时,π0.7 是 70%,MemER 和「子任务加叙述」都是 100%;未见过的 5 个物体上,π0.7 是 20%,MemER 是 80%,「子任务加叙述」是 90%。
他们还定量看了上下文标记数量与延迟的关系,对比了 H100 和 B200 上从零计算与使用缓存的曲线。不缓存过去计算时,延迟曲线上升很快;加上缓存后明显改善。900 帧可在不到 0.5 秒内完成推理,对应 6.45 万个历史视觉标记。
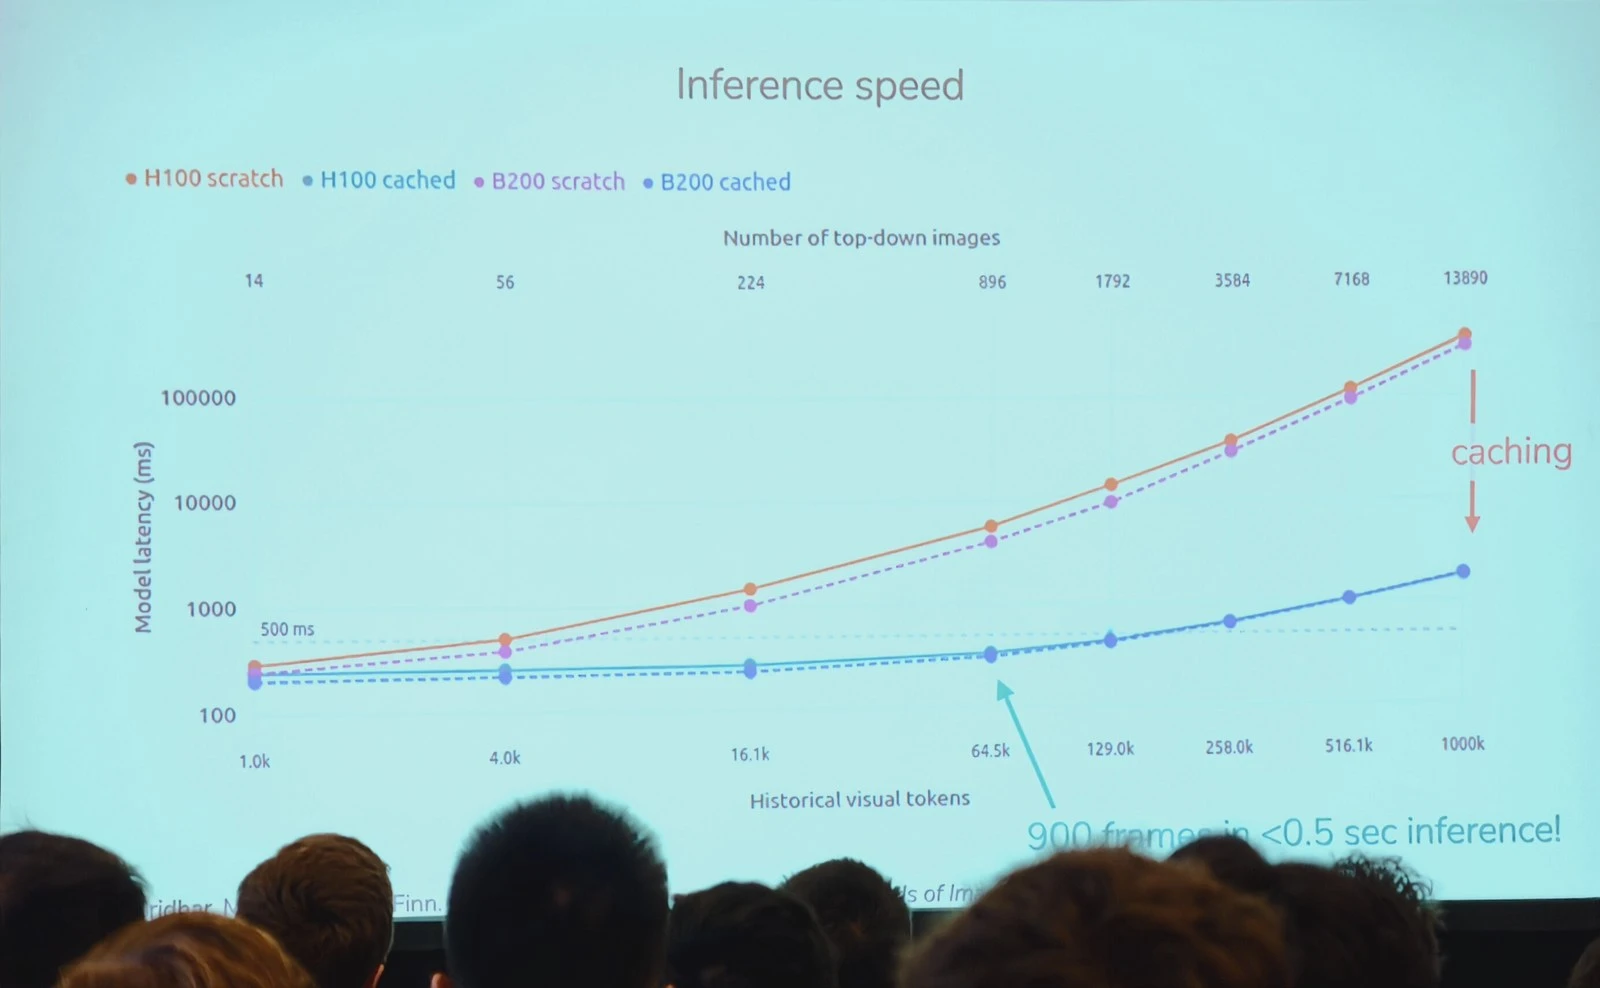
这一部分,她的结论是:在端到端训练里加上任务和叙述类预测,并好好处理计算,就可以在机器人策略里得到相当强的长上下文推理,而不必另建一套显式世界模型。
把一间厨房打扫完
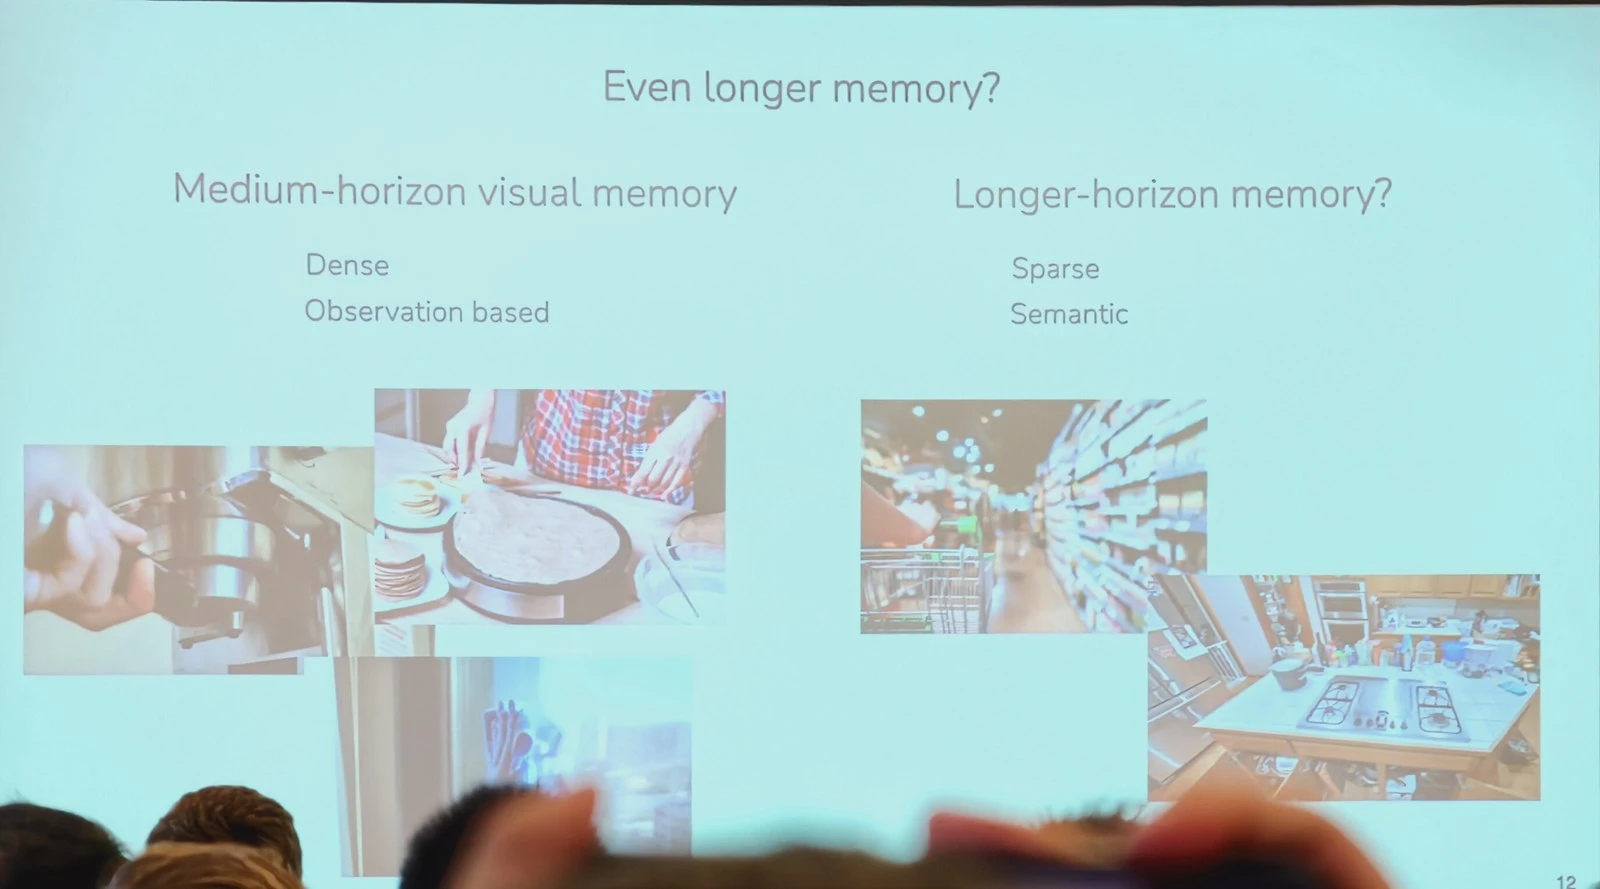
接下来她转向更长的记忆。前面这种偏密集的视觉记忆,对当前许多场景是合理的;但如果要覆盖数小时、数天,未必还想让记忆严格保持视觉,并保持那么密。中等时程的视觉记忆是密集、基于观察的;更长时程的记忆则更稀疏、更语义。
她举的例子包括:记住准备在店里买哪些东西,以及按食谱在厨房里做下去。于是想法是做一个多尺度记忆的模型:短到中等时程用视频记忆,并可沿用前一部分的思路;跨许多分钟的更长时程记忆,则用更压缩的文本来表示。这两种尺度的记忆,都放在端到端策略里使用。
这套结构称作多尺度具身记忆(Multi-Scale Embodied Memory)。上层是视觉语言模型,里面放长期文本记忆,并循环更新记忆摘要;下层是视觉语言动作模型,使用短期视频记忆,再经动作模块输出机器人动作。
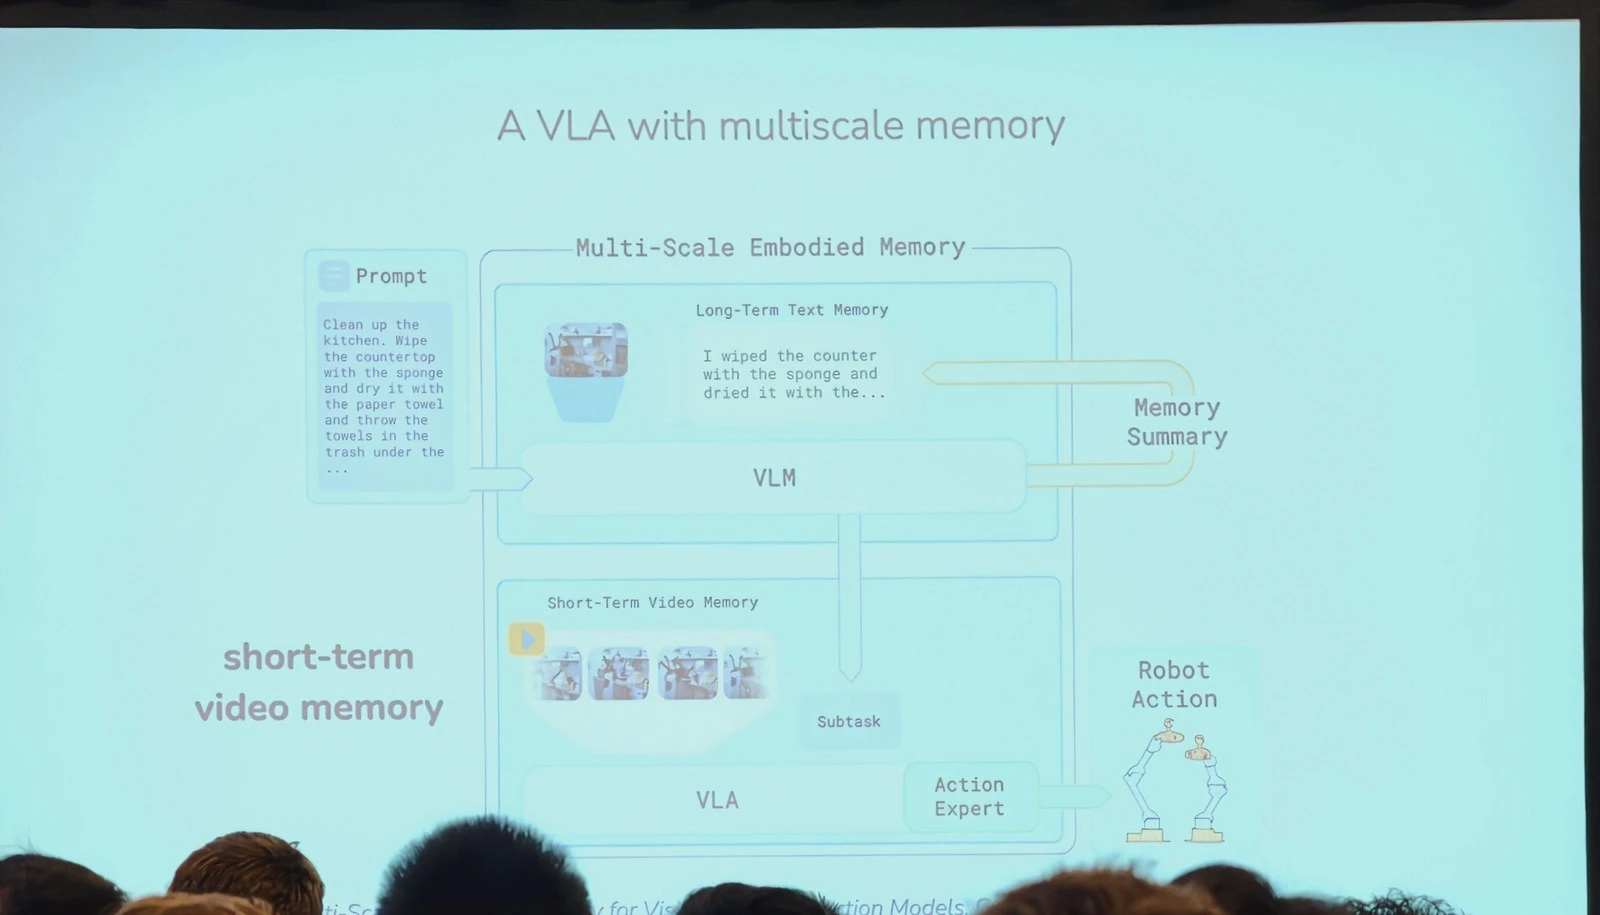
文本记忆,她讲了两种做法。一种简单做法,是把到目前为止已完成或尝试过的子任务(subtask)语言直接送回模型,作为对过去的压缩表示。这种方法很简单,但常常会在训练和部署之间造成分布偏移(distribution shift)——尤其是做事方式、速度与数据里不一致时。比如实际做得更久,某些内容在输入里反复出现的次数就会远多于训练时。
他们发现更有效的做法是:根据上一次摘要、当前子任务,以及当前图像里看到的内容,把已经发生的事压缩、总结成新的摘要,再把摘要送进模型,不再送原始子任务列表。也就是说,模型被训练去更新这段文本记忆,并把它压成摘要。这有助于缓解分布偏移,表示也更压缩,更利于拉长时程。这一部分的预训练视觉语言模型是 SigLIP(4 亿参数)加 Gemma(40 亿参数)。
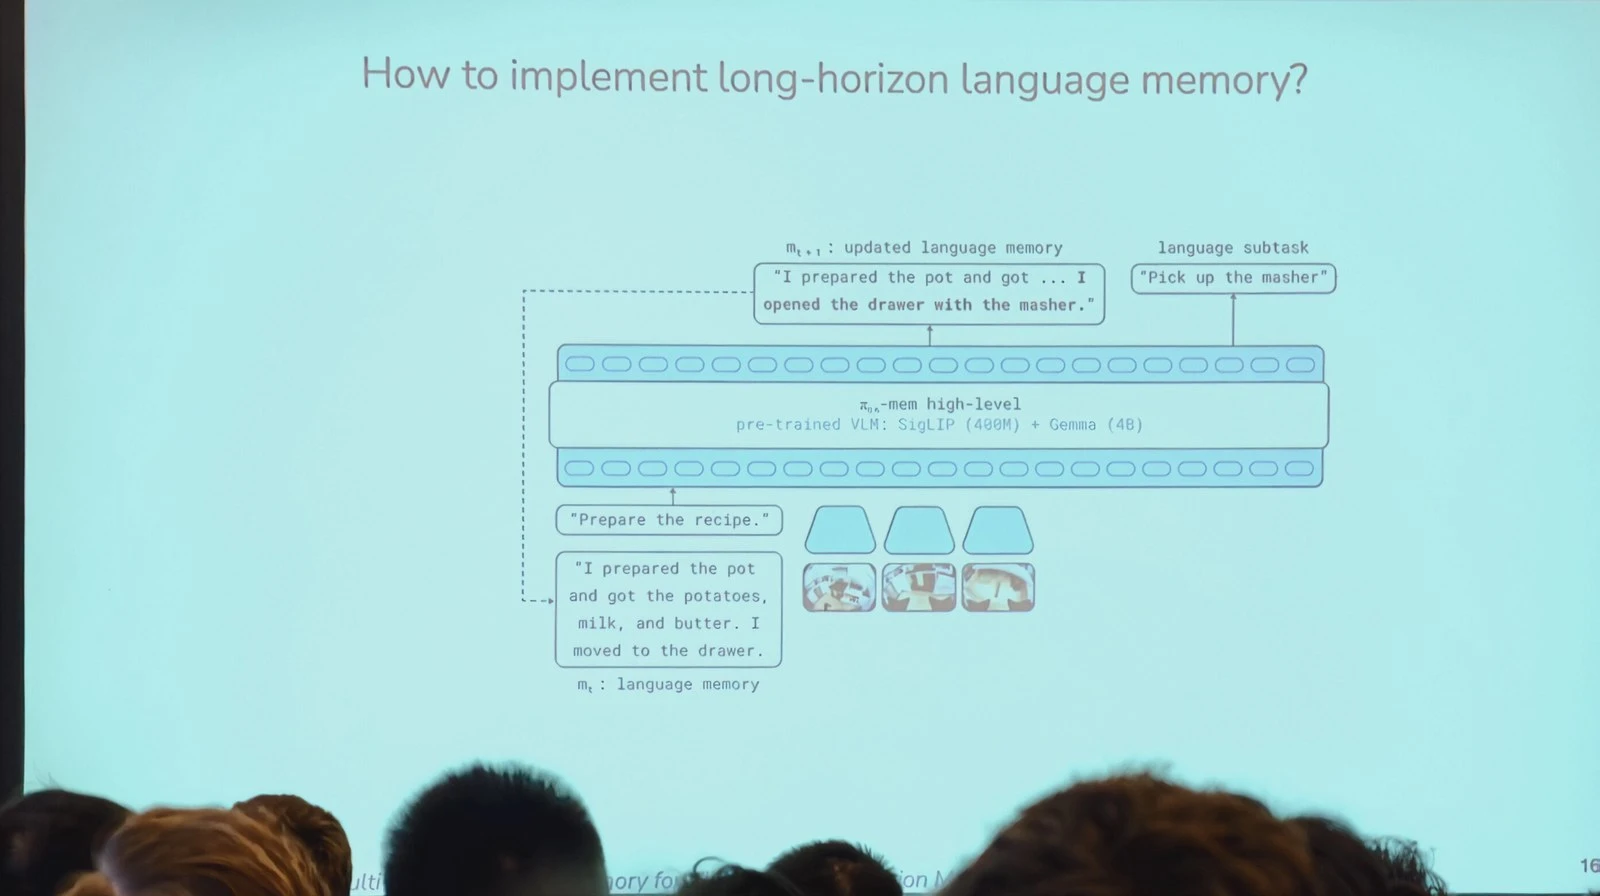
有了这种文本记忆,他们把机器人能做的任务长度扩到了这项工作里的约 15 分钟。任务是打扫厨房,以及准备食谱。她让大家看视频,画面下方可以看到机器人到目前为止做过什么。记忆之所以重要,是因为步骤很多。她描述的过程包括:用海绵擦台面,再用纸巾擦干,更新摘要,再把纸巾扔进垃圾桶,接着把东西放回冰箱,再往后会洗其中一个盘子、把已晾干的餐具收好。她说视频较长,现场来不及完整看完。
定量上,他们评估的是 π0.6-MEM,也就是这种视觉记忆与很长程记忆的混合,对照是没有记忆的 π0.6、朴素的文本加视频记忆、只用视频记忆,以及只用文本记忆。评估任务有两项:准备食谱,以及打扫厨房,指标是任务进度。主要结论是:对这类长任务,尤其是打扫厨房,π0.6-MEM 明显高于没有文本记忆、也比更朴素的文本记忆做法更好。她认为,这种可压缩的摘要还有进一步拉长任务时程的空间。
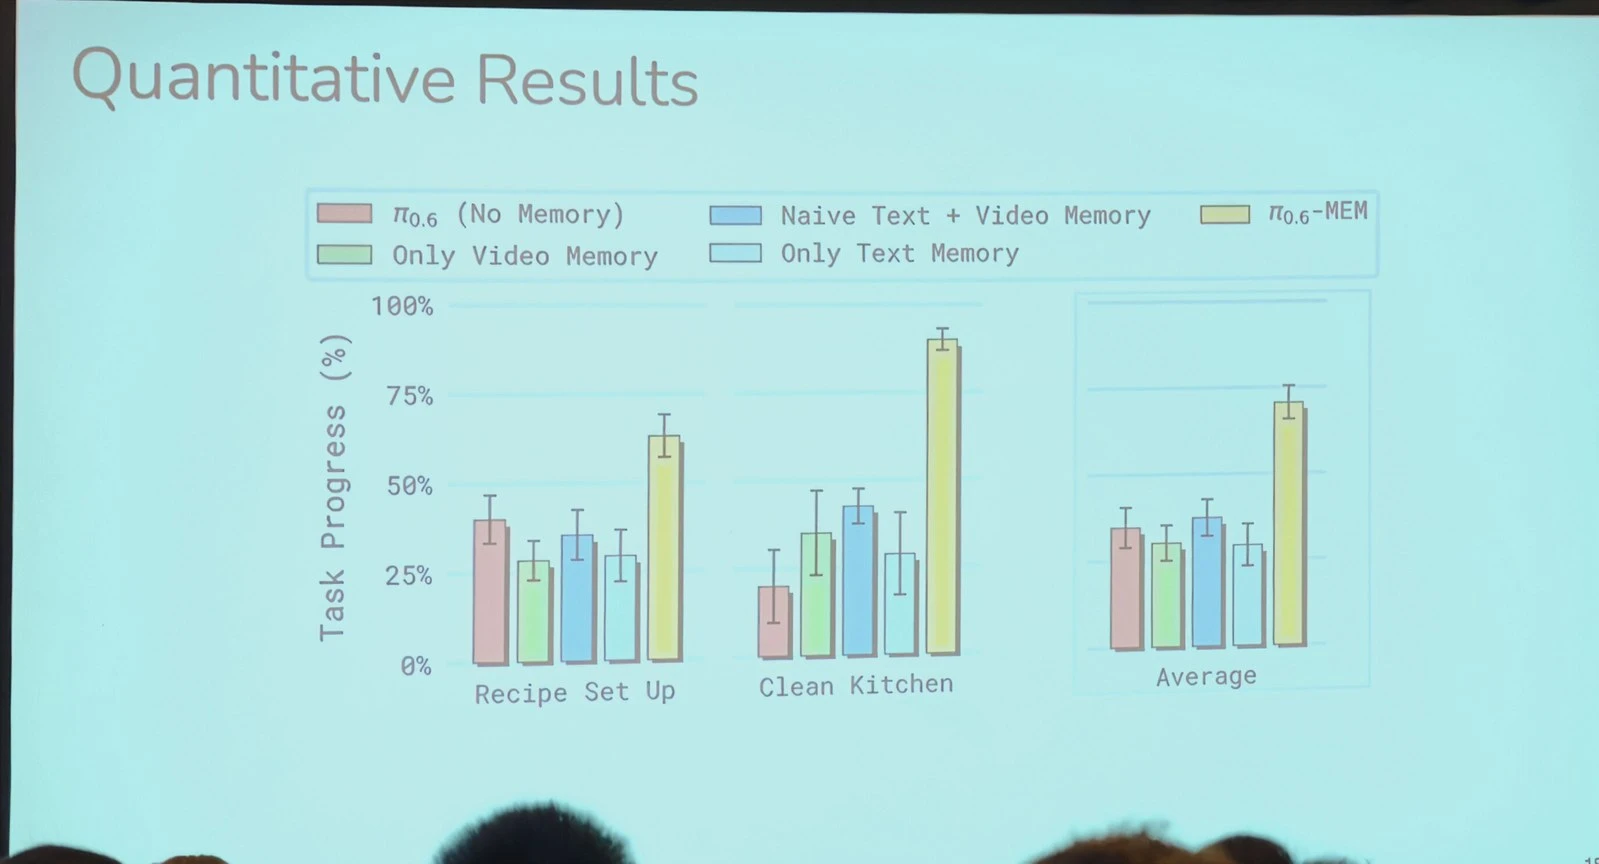
对照后来公开的工作,这一部分与 Physical Intelligence 在 2026 年 3 月发布的多尺度具身记忆(Multi-Scale Embodied Memory,MEM)相符:短时程用视频记忆,长时程用语言摘要,并把打扫厨房作为约 15 分钟的任务来验证。
新情境里的组合泛化
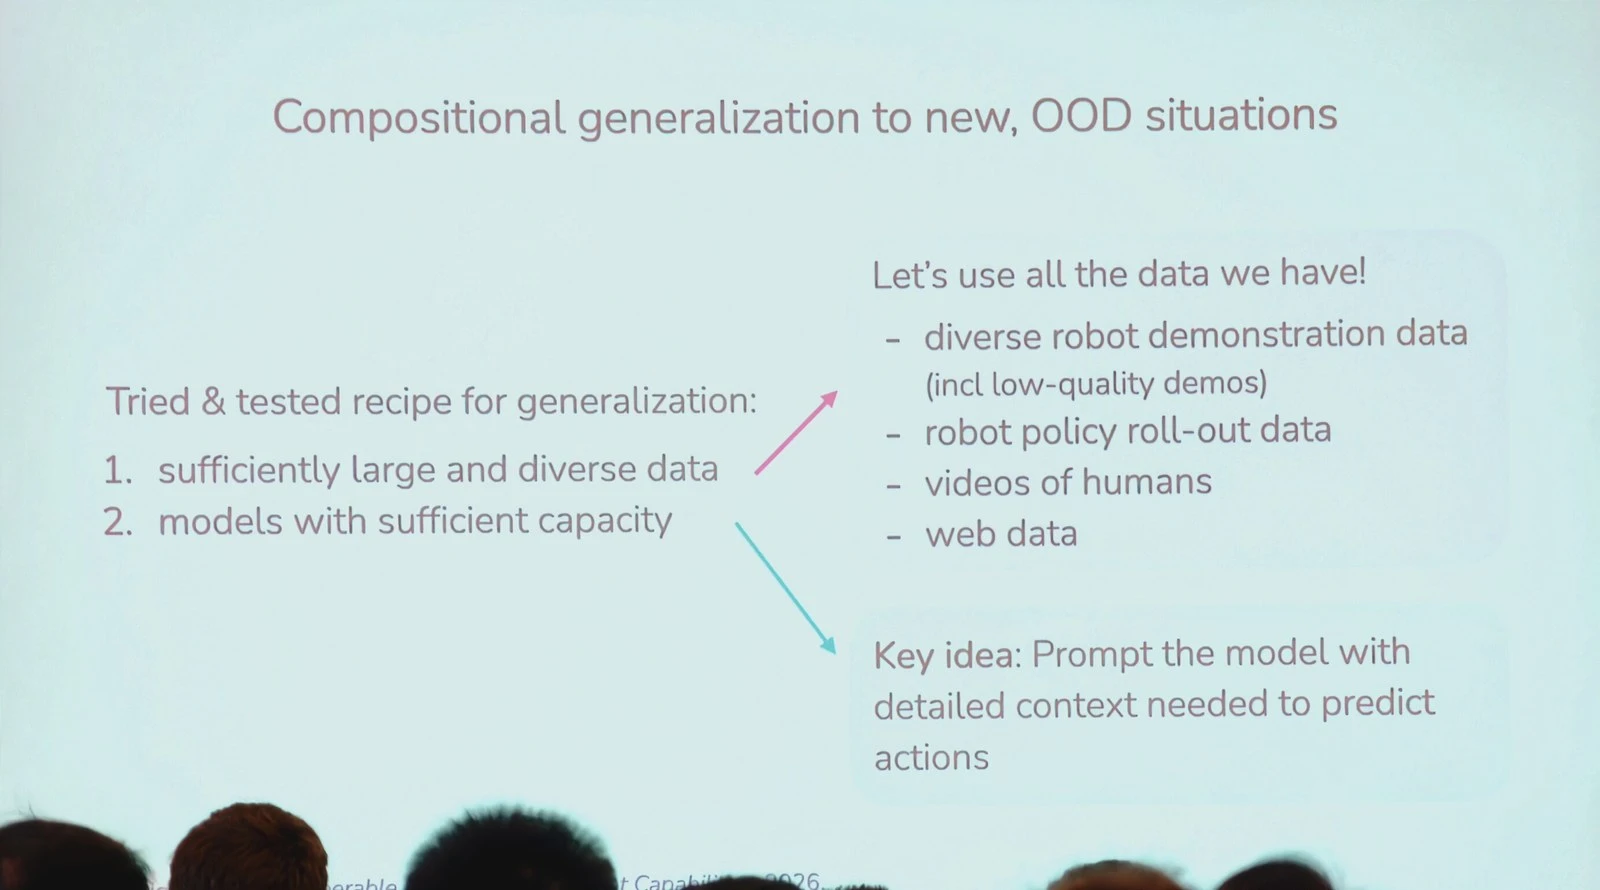
她认为,给机器人模型带来大量复杂性的另一件事,是对新情境、尤其是分布外(out-of-distribution)情境的泛化,特别是组合泛化(compositional generalization)。研究者往往很想把结构写进算法里,好让它更容易泛化。他们想看的则是,这种能力能不能主要从在多样数据上训练一个容量足够的模型里自己长出来。基本配方就是:足够大、足够多样的数据,再配上容量足够的模型。
数据方面,他们尽量用上能用的数据,包括多样的机器人演示数据——也包含低质量演示、机器人策略 rollout 数据、人类视频,以及网络数据。多样数据本身还不够。他们发现非常重要、且效果相当明显的一点,是用详细的上下文去提示(prompt)模型,即使数据质量较低,这种上下文也能帮助它预测动作。低质量演示也可以留在训练集里,但前提是给模型足够信息,让它知道这一次是在做什么、做得怎样、当前这一步具体是什么。
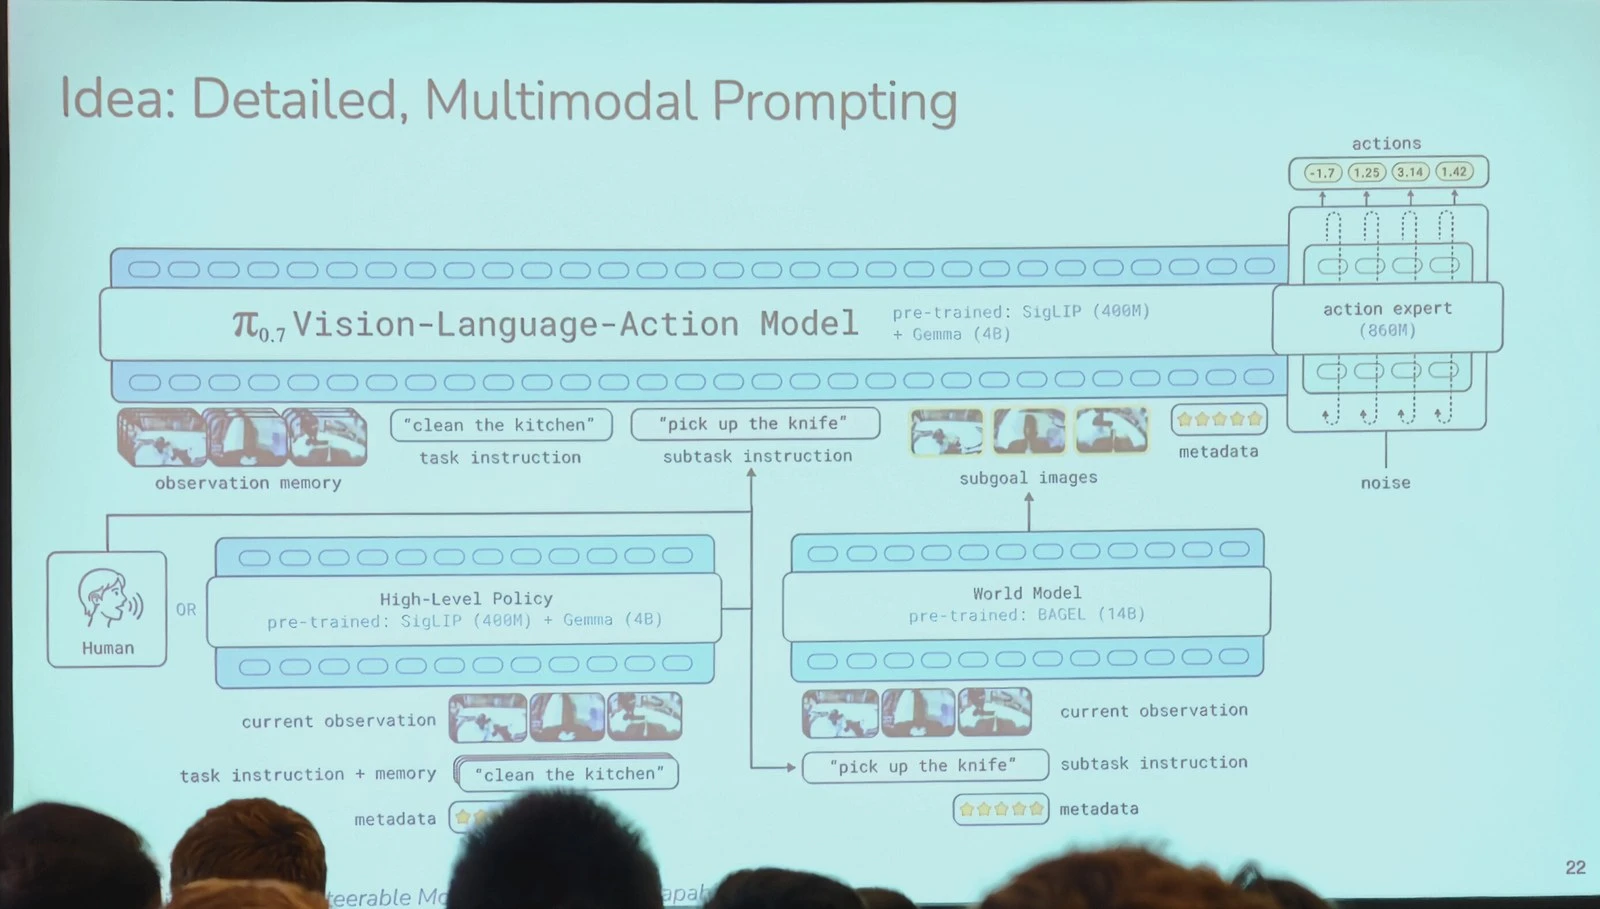
他们用详细的多模态提示来训练 π0.7 视觉语言动作模型。预训练骨干是 SigLIP(4 亿参数)加 Gemma(40 亿参数),旁边的动作模块是 8 亿参数。输入包括:观察记忆;任务指令,例如「打扫厨房」;更细的子任务指令,例如「拿起刀」;子目标图像;以及关于该次执行的元数据,例如质量。测试时,子任务指令可以由人给,也可以由一个高层策略来预测,这个高层策略同样预训练自 SigLIP 加 Gemma。子目标图像由一个世界模型生成,预训练模型是 BAGEL(140 亿参数),输入是当前观察、子任务指令和元数据。
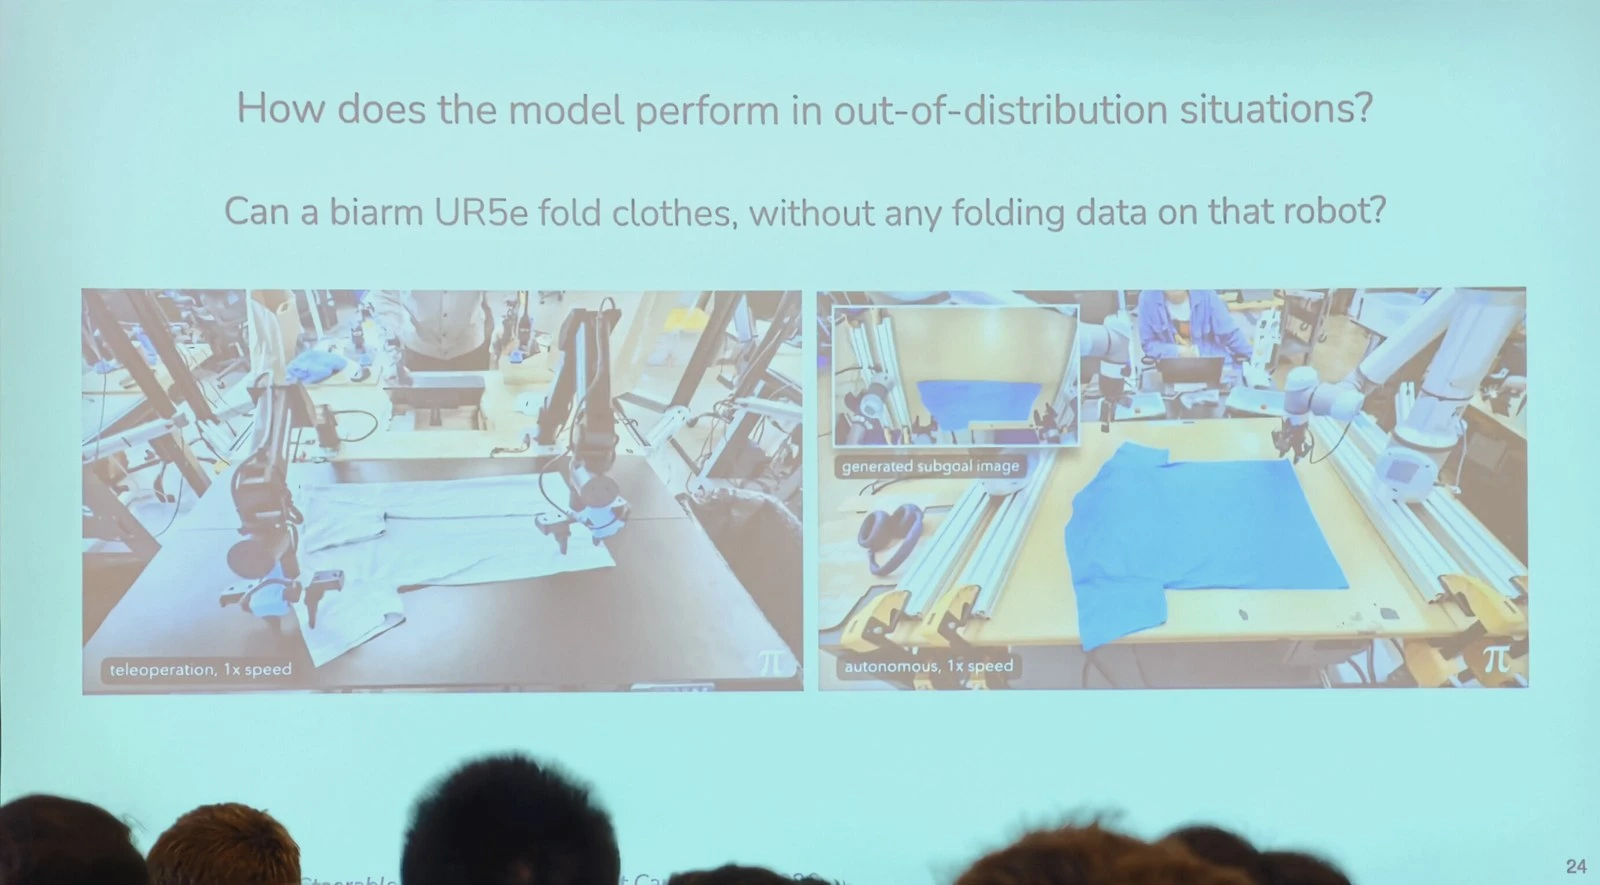
模型在多样数据上训练后,直接就能做一些相当复杂的任务,例如叠一件有纽扣的衬衫、拧入需要精度的螺丝,以及倒垃圾。他们还在分布外场景里测试。她认为最有意思的一个是:让一台从未采集过叠衣服或洗衣数据的双臂 UR5e 去叠衣服。叠衣数据是在一台固定式双臂机器人上采集的,那台有两只朝前的手臂,而且比较便宜。测试则放到双臂 UR5e 上,明显更大,构型也明显不同。尽管这是相当偏分布外的控制设定,模型仍表现出很强的组合泛化,能把在一台机器人上学到的技能推到另一台上。
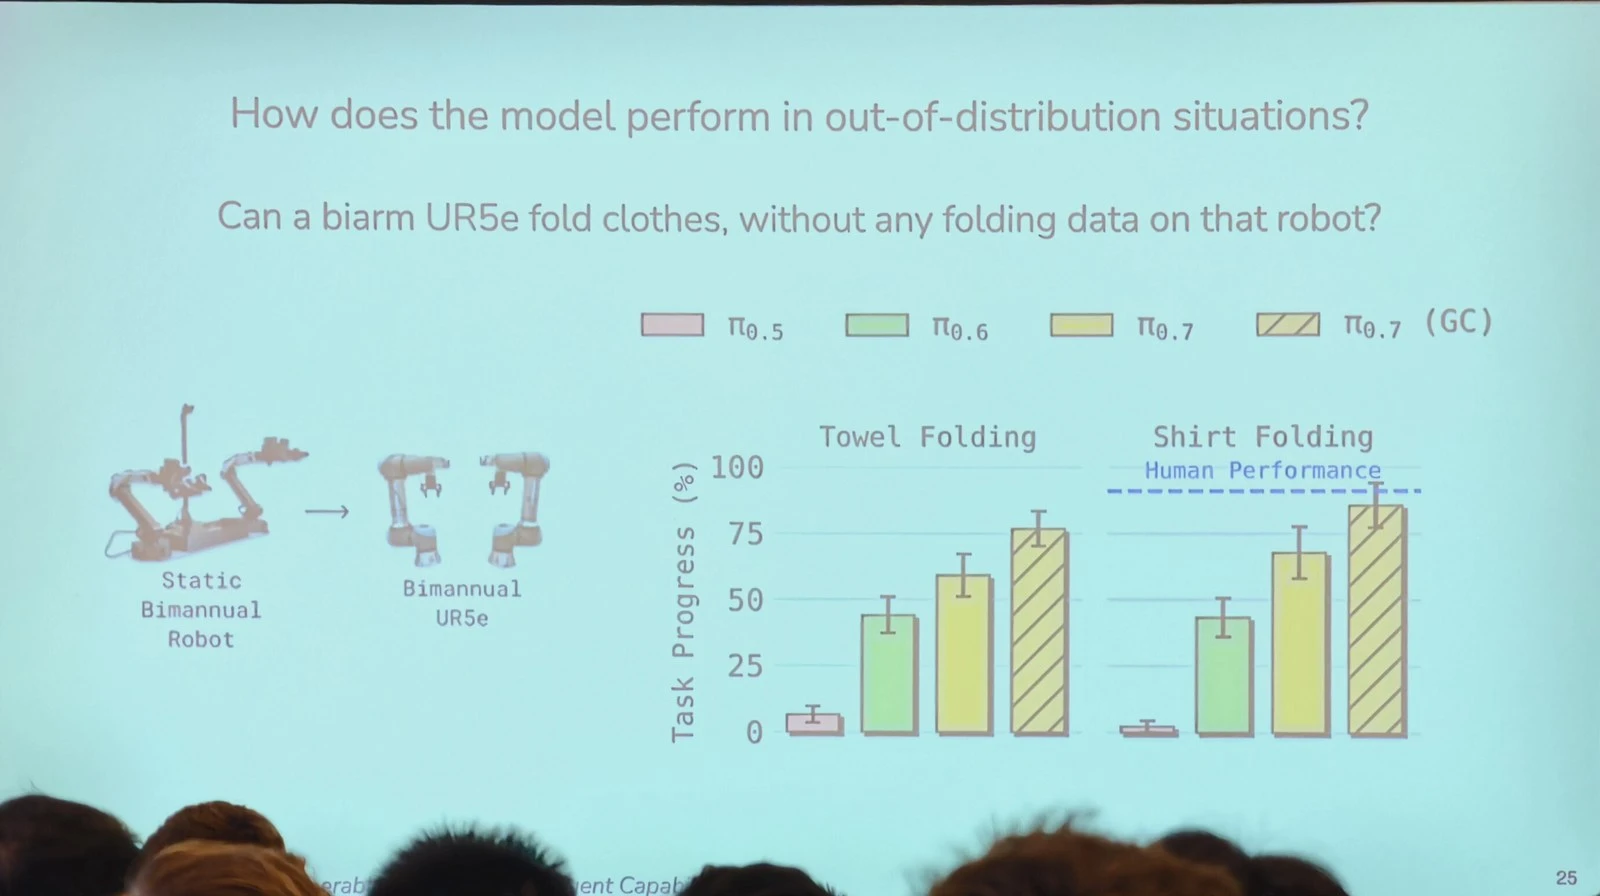
定量上,评估分成叠毛巾和叠衬衫,对照是 π0.5、π0.6、π0.7,以及 π0.7(GC)。π0.5 在两项上的任务进度都接近 0;π0.7 高于 π0.6;π0.7(GC)最高。叠衬衫一项还标出了人类表现的参照线,π0.7(GC)已经接近这条线。尽管没有该机器人上的专用叠衣数据,表现已经接近人类遥操作(teleoperation)。
对照后来公开的工作,这一部分与 Physical Intelligence 在 2026 年 4 月发布的 π0.7 相符:用详细上下文、子任务指令、执行元数据和子目标图像等来训练,并在没有对应叠衣数据的机器人上评估叠衣服。
报告结束后,有人问到:对于跨越更长时程的任务,是否应该通过某种机制去压缩记忆?比方说,今天把盘子放在某个架子上,第二天还要能知道盘子在那个架子上。这个问题正好接到她前面把记忆分成较密的视觉和压缩文本的做法上。
Finn 的回答是:很多场景,尤其是日常、跨天的事情,确实应该压缩记忆。可另一方面,如果有能力把相当密的上下文直接送进去,会非常方便,因为人们常常并不确切知道自己想用什么样的记忆表示。一旦做压缩,往往需要人先决定压缩成什么、怎么压。如果直接把视频再加一些额外监督送进去,模型在如何使用这些信息上会更灵活。监督并没有让人完全摆脱表示和压缩的问题,但能让模型用上所有可用信息,而不只是事先被选定的那一部分。
她最后收成一个判断:只要数据、监督和上下文用对,这类端到端模型可以处理很复杂的情况,包括需要长上下文、需要把一整项长工作做完,以及在新情境里推理;并不需要把世界模型显式做进方法里的机制,也不需要专门去建一个世界模型或物理模型。更简单的配方,往往也更容易扩展到多样数据和复杂情境。她还提到,这些模型已开始进入真实用例,例如物流。
可她同时把更长的时程留给了尚未做完的事。数小时、数天的记忆,她认为不必再保持那么密、那么视觉;跨天记住盘子在哪个架子上,她也认为应该压缩。压缩又往往要人先决定压成什么。真正还需要核验的,是这条不靠显式世界模型的配方,在比厨房打扫更长的工作上、在真正没见过的机器人上,还能不能把该记住的事实记住,并把技能稳定推过去——而不把记忆表示先规定死,也不把显式预测模型再请回来。