Tsinghua University and Galbot Apply 552B Vision-Language Representations to Fine Robotic Manipulation
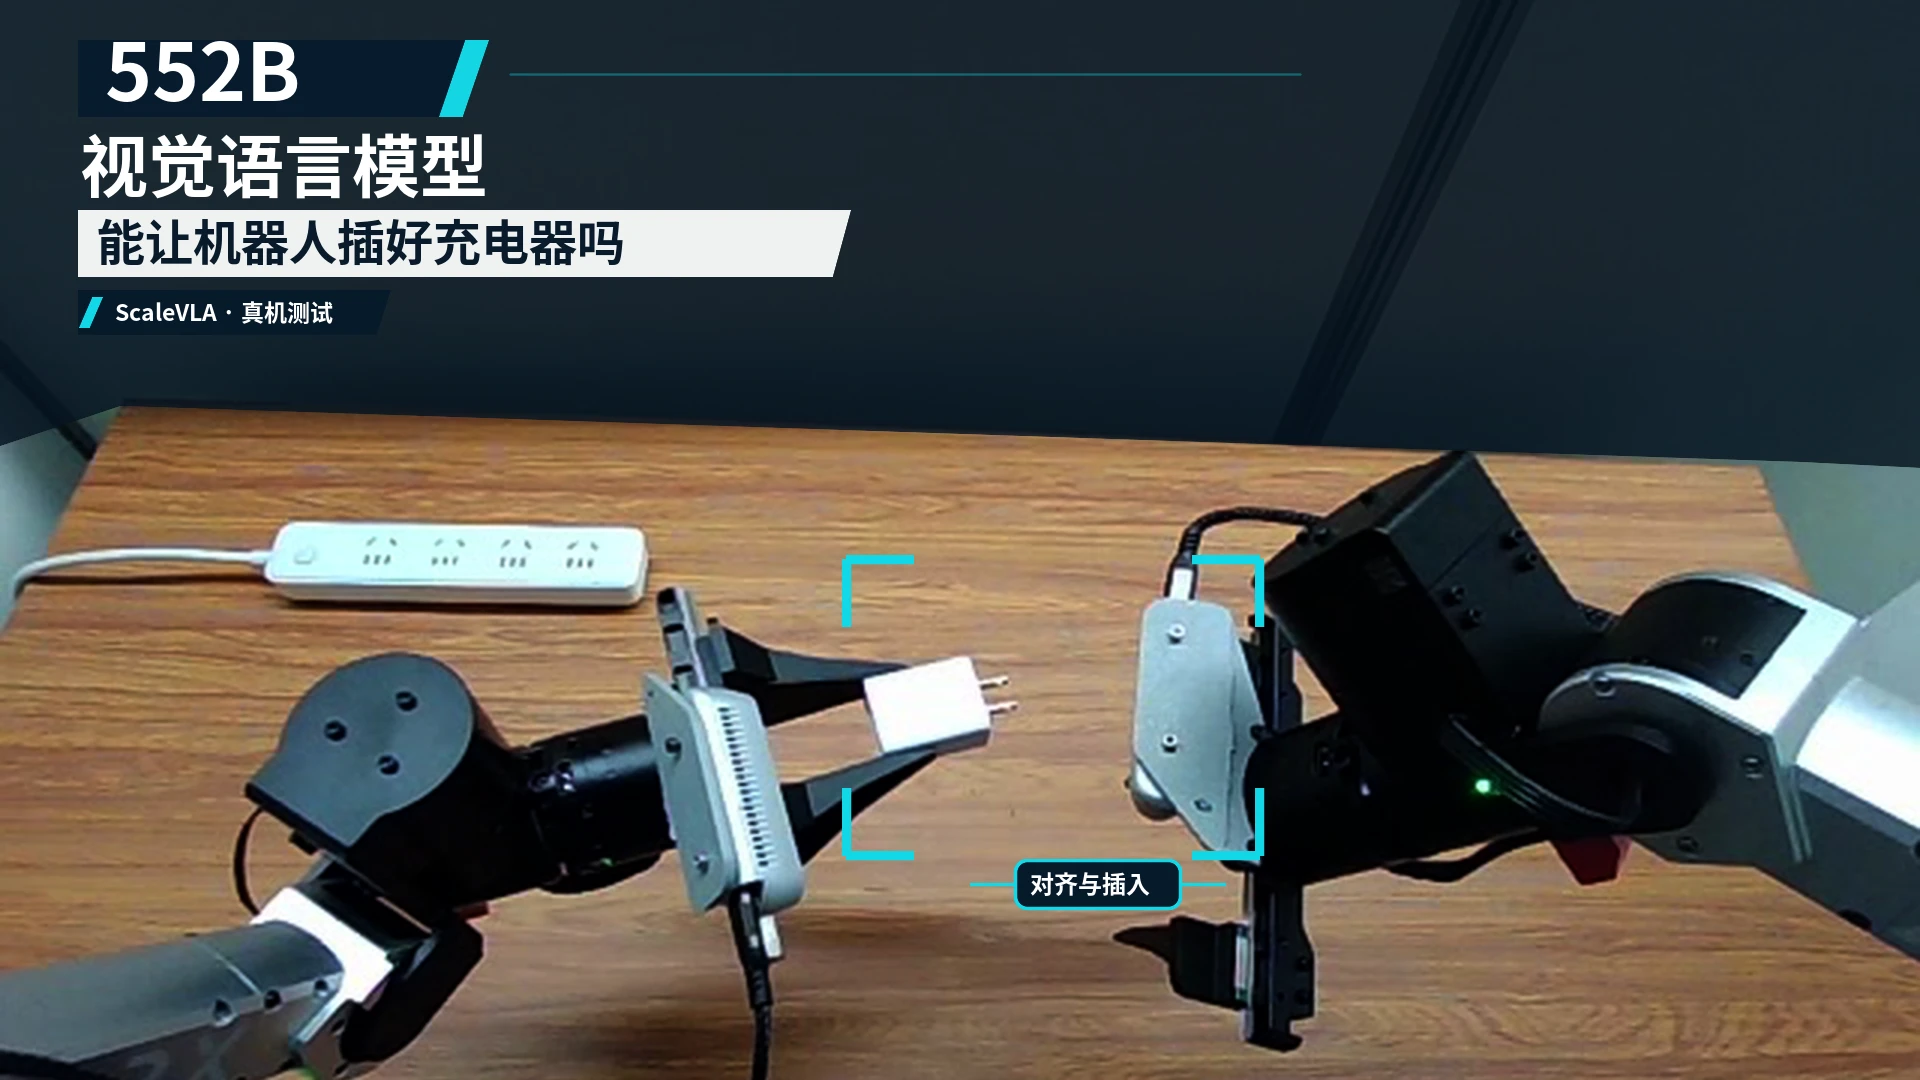
Researchers from Tsinghua University, Peking University, Shanghai Jiao Tong University, and Galbot introduce ScaleVLA, a vision-language-action model that leverages a frozen 552-billion-parameter vision-language backbone to improve data efficiency and fine manipulation in robotic tasks.