

主干
共 21 篇相关内容
清华大学、银河通用将 552B 视觉语言表征用于机器人精细操作
视觉语言模型在大规模图文预训练中积累了物体识别、空间理解和指令处理能力。前沿模型开始展现机器人操作能力,但不少视觉—语言—动作模型(VLA)的视觉语言主干仍然较小。 大模型从图文数据中学到的表征,能否转化成更省示范、更适合精细操作的机器人策…
Chelsea Finn:不必显式世界模型,端到端策略也能做长任务 |CoRL 2026
11 月 12 日上午,机器人学习会议(CoRL)在奥斯汀 JW Marriott 的 Brazos 房间举行半日工作坊「机器人需要世界模型吗?」(Do Robots Need World Models?)按照工作坊的官方说明,世界模型(w…

对话 Copper-Policy 团队:从像素预测走向紧凑世界表征
为了让机器人具备更强的认知与物理交互能力,研究者开始探索世界动作模型(WAM)。WAM 通过视觉动力学预测场景的演化,将「世界应当变成什么样」与「机器人如何实现这一变化」联系起来。即使测试时不生成未来,联合训练的收益仍然存在。 那么,WAM…
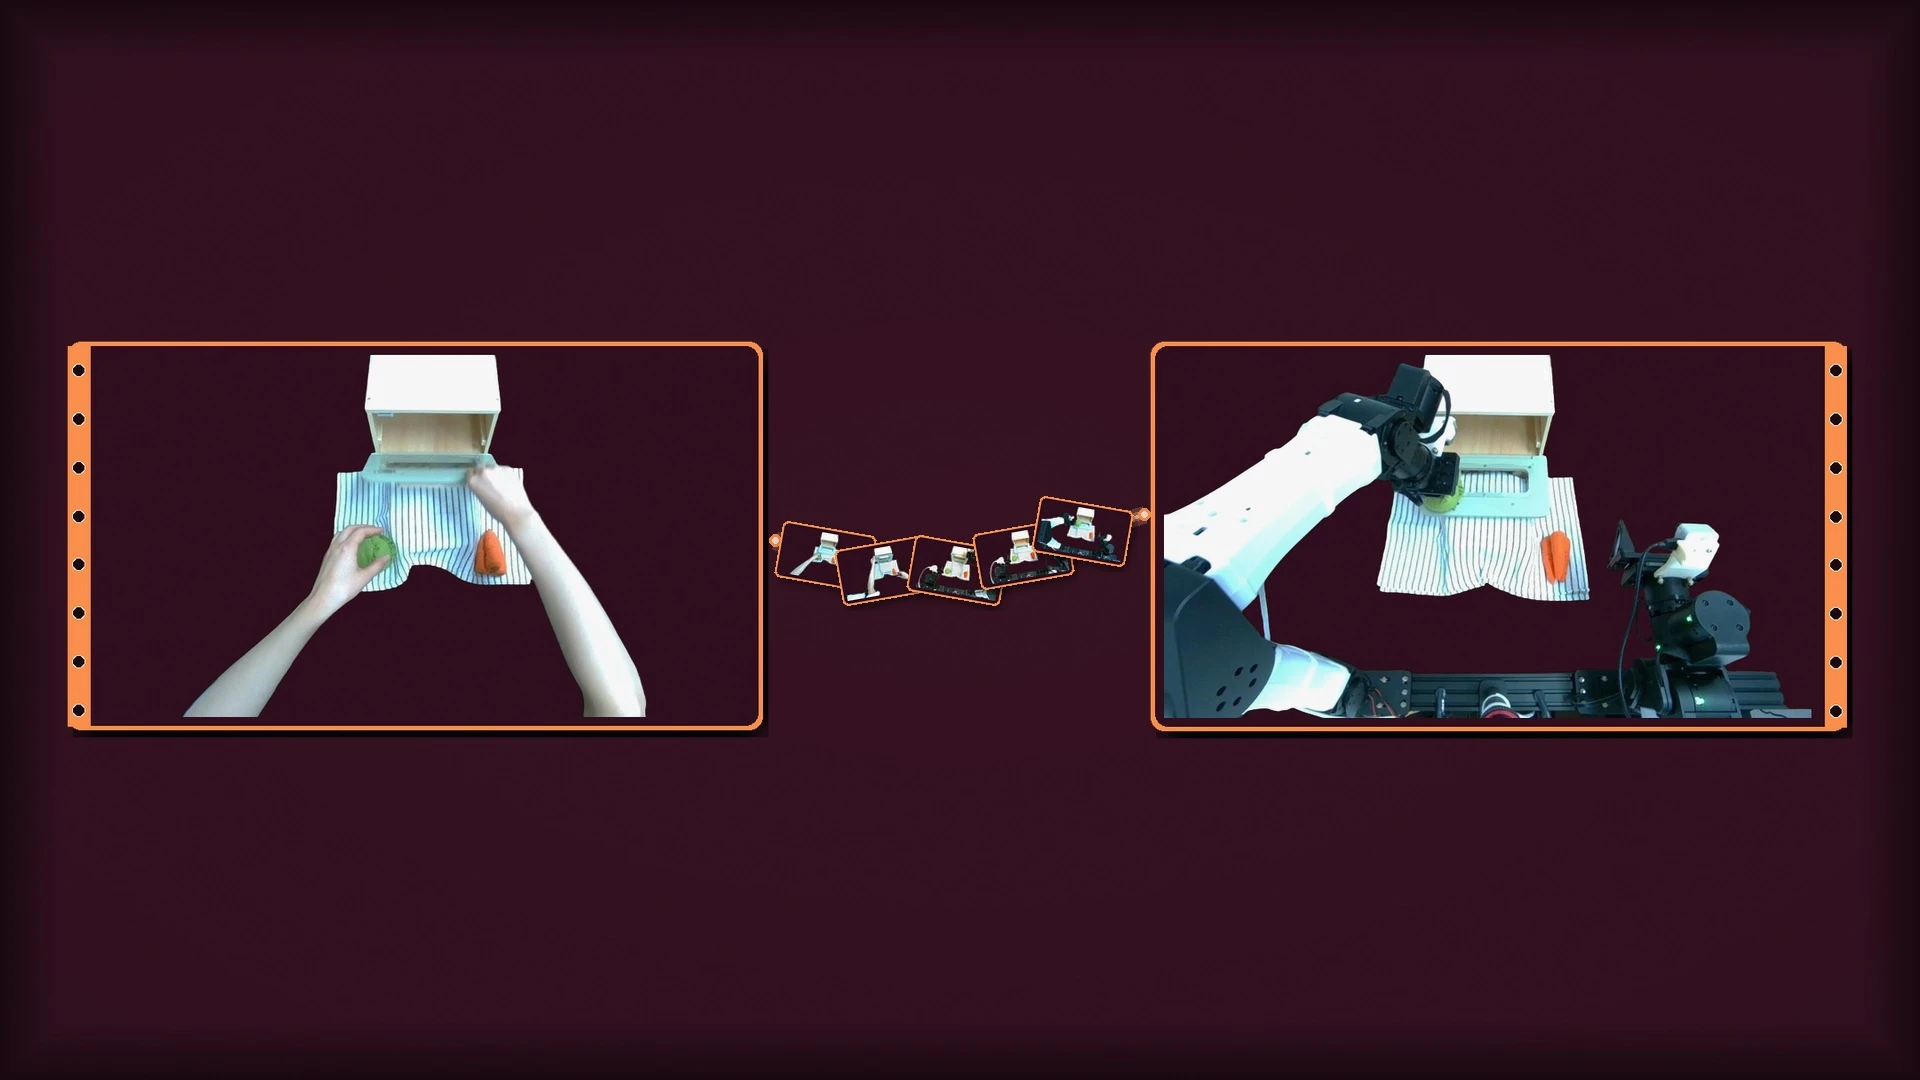
英伟达提出 ThinkWorld,把动作写成链,用想象的未来判对错
机器人演示采集成本高,覆盖的场景和动作有限。互联网上虽然有大量人类第一视角视频,却零散杂乱,也没有机器人可以直接执行的动作标签。VLA 怎样吸收这些视频里的操作经验? 针对这个问题,英伟达联合 KAIST(韩国科学技术院),于 10 月 2…
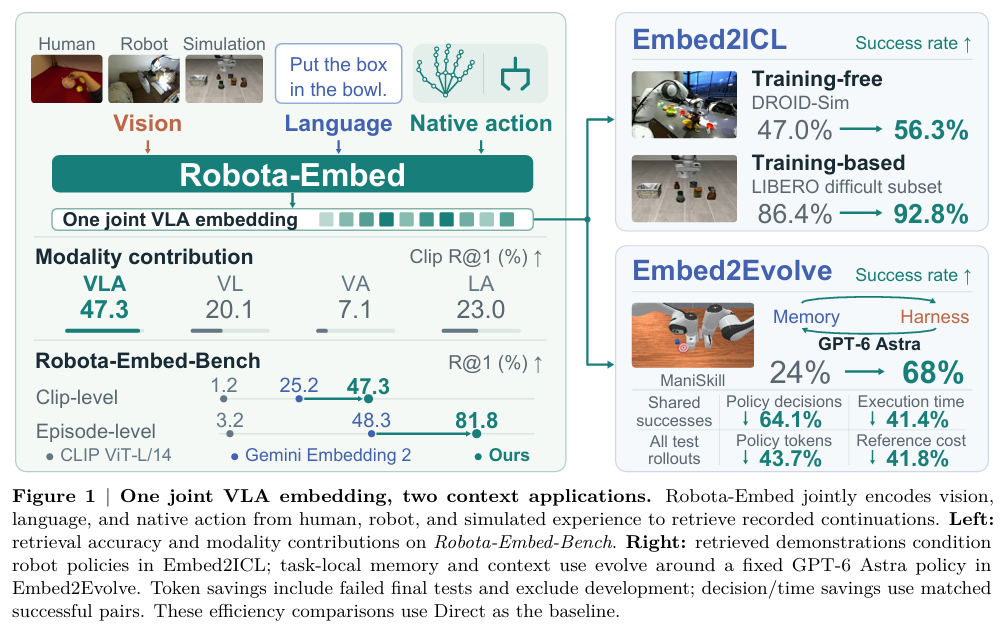
Jim Fan、韩松团队提出 Robota-Embed:机器人检索经验,动作比画面更关键
具身智能机器人想要复用过往操作经验,普遍会检索历史示范视频,模仿曾经成功的操作。 但传统检索大多只比对画面外观:只要桌子、物体看起来一致,就判定是匹配片段,忽略机械手当下的运动方向。同样的纸箱、同一段胶带,封箱和撕胶带两张画面几乎看不出差别…
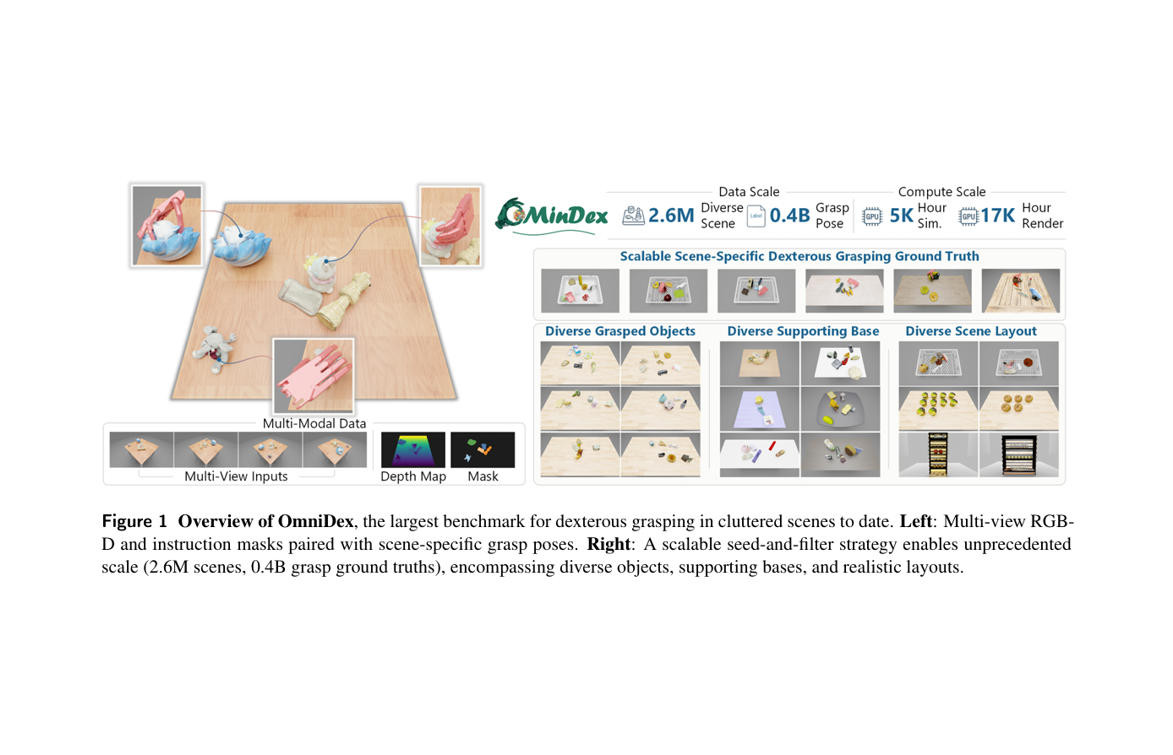
王晓刚、李鸿升团队新作:260 万个场景训练灵巧手
OmniDex 借助可复用种子抓取库搭配碰撞筛选,将杂乱场景下的灵巧手抓取数据集规模从数千个扩充至 260 万个场景、约 4 亿条抓取标注;配套采用软胜者全取学习与物理约束的生成模型,省去推理阶段反复优化抓取位姿的步骤。 10 月 8 日,…

对话 StageCraft 作者,聊一聊 VLA 从本体迁移到环境变化差在哪
今年 IEEE/RSJ 智能机器人与系统国际会议(IROS)于 9 月 27 日至 10 月 1 日期间在美国匹兹堡召开。 本届 IROS 收录的论文接近 1,900 篇,分设三百多个主题报告场次。 作为机器人领域与 ICRA 齐名的两大顶…

对话 Shallow-π 作者:压缩 Transformer 层级,具身模型竟做得更好?
一个圆柱、一块正在转动的孔板,足以让两种机器人模型拉开差距。 在 Shallow π 的真实机器人实验中,任务要求机械臂拿起圆柱,插入移动中的小孔。层数更多的大模型,可能在等待计算结果的过程中错过位置;一个层数更少、输出接近它的小模型,却能…
对话上海交大杨理欣:为什么机器人需要一条「三维时间轴」
机器人会倒水,却可能在放下瓶子后忘了刚才倒过哪一瓶。会执行动作,不等于知道任务该如何推进;机器人还需要把任务意图、行动历史与世界变化连成一条三维时间线。 这类失败不完全是抓取精度问题。今天的视觉—语言—动作模型(Vision Languag…
上交卢策吾、浙大等团队提出 Track4Action:把「动作后的 3D 世界」蒸馏进 VLA
VLA 模型可以把图像和语言指令转换成机器人动作,训练的过程中,研究人员通常只评价机器人的动作像不像专家。至于机器人的动作会怎样改变物体、空间关系和任务状态,通常没有被明确交给模型学习。短任务可能掩盖这个缺口;一旦任务变长,或者视角、背景和…
杨立昆点赞,浙大孙俊涵、清华赵昊等提出 INTACT:免去 JEPA 世界模型的「搜索税」
世界动作模型的核心在于,先预测「下一步发生什么」,并为其设立目标,再让机器人看一眼目标,自己决定执行的每一步该做什么。 然而当前的主流方案有一个别扭的设计:训练时,模型学会「给定当前画面和动作,预测接下来发生什么」;部署时,控制器却从随机噪…
0.04B 通吃异构相机,与地瓜机器人隋伟谈 X-Lens 取舍逻辑
鱼眼相机看得广但画面边缘是畸变弯曲的,针孔相机看得直但视野窄。 一台机器人身上往往同时挂着这两种相机,用于感知环境深度,而像 DAC、MapAnything 等深度估计模型,几乎没有既能同时适配好这两种相机,又能端侧跑起来的方案。 对此,地…