

北大团队提出 Open-HumanWAM,纯人数据训出机器人底座
作者:江思奇
人类视频里有大量拿取、收纳和整理的过程,机器人怎样从这些视频里学到能用的操作经验?
11 月 5 日,北京大学联合新加坡国立大学、麻省理工学院、加州大学圣迭戈分校与英伟达发表论文《Open-HumanWAM: An Open Recipe for Scaling Human and Robot Experience for Embodied Foundation Models》,提出具身模型训练框架 Open-HumanWAM,探索如何把大规模人类视频中的操作经验迁移到机器人任务中。
论文共 34 位作者,Juncheng Ma、Jiaxin Li、Jiankai Tu、Bo Liang 为共同第一作者,通讯作者为北京大学信息工程学院助理教授周大权。
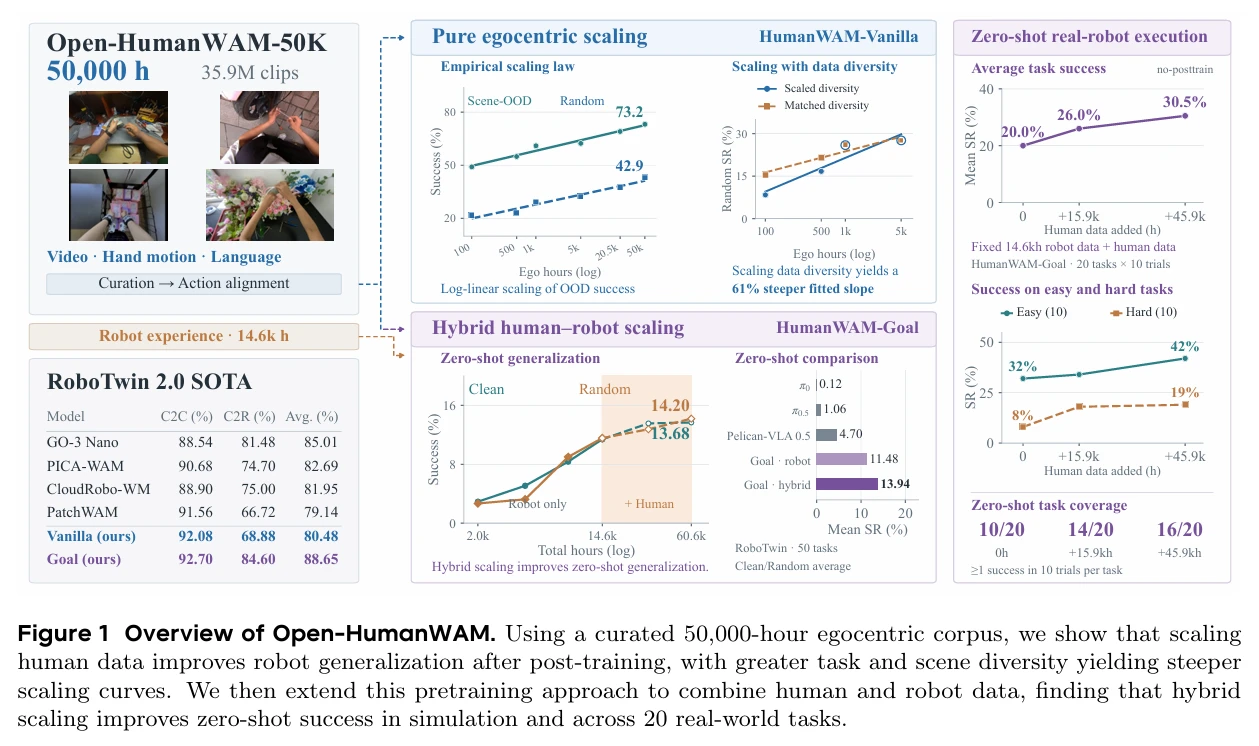
在 HumanWAM-Vanilla 的真机测试中,团队先用 50,000 小时人类第一视角数据预训练模型,再用机器人示范适配具体任务。面对桌布和光照变化的四项测试,模型平均成功率为 67.5%;未经过人类数据预训练的对照组为 2.5%。这组实验检验的是:人类操作经验能否帮助机器人应对训练中未见过的环境变化。
另一组实验中,HumanWAM-Goal 将目标图片作为模型输入,测试图片能否引导机器人完成指定操作。在 20 项真机任务上的零样本测试中,模型平均成功率从仅使用机器人数据时的 20.0% 提高到 30.5%。经过任务训练后,模型还能根据不同目标图片调整抽屉选择、玩具分类和笔记本摆放。
人类视频怎样变成机器人的操作经验?Open-HumanWAM 给出的答案,是先用人类视频预训练,再用机器人数据适配任务。
十万小时视频,筛选出五万小时有效语料
研究团队先汇集来自五个渠道的素材,通过三层过滤留下有效的动作片段,再将全部数据转换为一套统一的动作表达,之后才正式开展预训练。
第一步是汇集数据源。团队合并 HumanNet、EgoSuite‑Open100K、EgoDex、Gen‑HumanEgo、EgoVerse 这五份公开数据集,原始总时长达到 104,289 小时,大约 112 亿帧。其中 HumanNet 是主体,贡献 90,275 小时。它取自互联网筛选后的第一视角视频,配套手腕三维位姿与文本描述。
第二步,数据依次通过三道筛选规则。「手部可见」这一步,会把手部三维末端位置投影到画面上,判断手部是否出现在视野内。如果序列里只有单手可见,片段可以保留,但动作监督与归一化统计只会作用在这只手上。「动作与相机稳定」这一步用来识别轨迹突变,一旦加速度、加加速度或者相邻帧位姿差超出阈值,片段就会在此处截断。「剔除空转」这一步采用 32 帧滑动窗口统计末端位移;如果窗口内手部几乎没有移动,则判定为空转,裁掉这部分区间,倘若有效活动占比不足七成,整条片段直接舍弃。
经过三道筛选,接近一半原始时长被剔除,最终保留 50,000 小时、合计 54 亿帧、3,593 万条片段。其中 HumanNet 从 90,275 小时缩减至 40,744 小时,EgoVerse 从 143 小时缩减至 24.8 小时,衰减幅度最大,也反映出不同数据集之间标注质量差距明显。
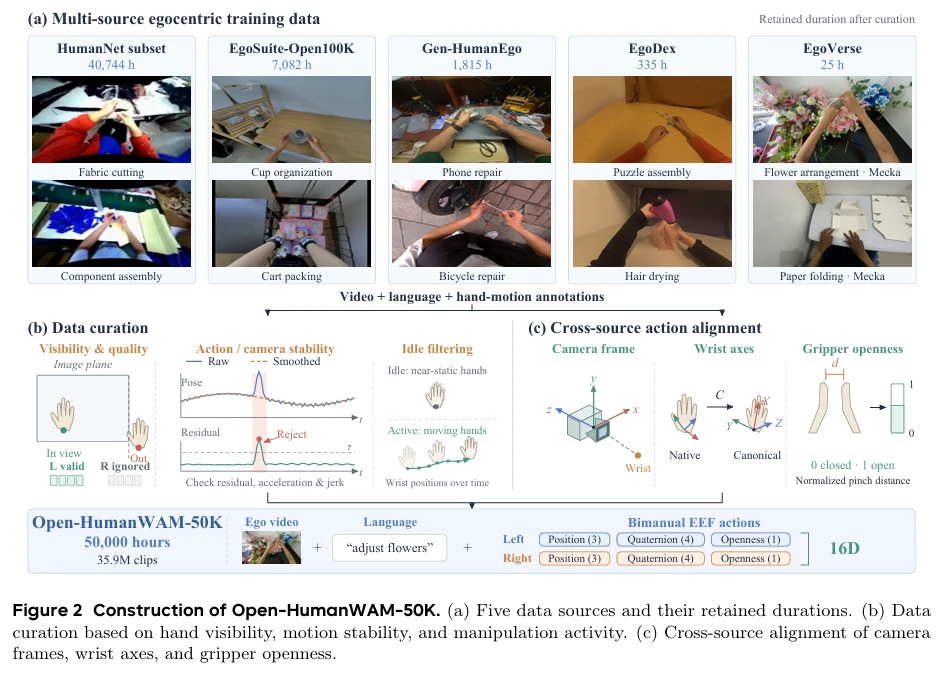
第三步,统一动作表示。人手和机器人夹爪本身结构不同,各个数据集记录手部信息的方式也不统一。同样一个推送动作,在一份数据里可能是一组世界坐标,在另一份里又变成相对前一帧的位移;直接混在一起输入模型,模型无法学到共通的动作规律。
团队将人类与机器人的手部轨迹,全部映射到同一个 16 维双手末端空间。单只手占用 8 维,包含三维位置、四元数朝向以及开合度,左右手合计 16 维。位置与朝向会转换到对应帧的相机坐标系,相机轴向统一规定为右、上、后。手腕本地坐标系以中指根部、拇指方向作为基准;不同来源的数据依靠固定旋转矩阵对齐。拥有三维关键点的样本,采用正交普氏分析完成估计;像 HumanNet 这类仅有单目关键点的数据,则依靠投影轴和符号校正完成对齐。夹爪开合度由拇指、食指指尖距离做归一化处理,闭合为 0,完全张开为 1。
这套对齐方案是这一部分最核心的设计。同一个真实物理动作,在五份原始数据里原本对应几套互不兼容的数值;对齐之后,它们具备一致的几何语义,来自多方的示范数据,才能够一起用来训练同一个动作预测目标。
数据集和标准化接口准备完毕之后,剩下最关键的问题:这些处理好的训练时长,究竟能换来多强的模型性能。
数据每翻十倍,性能能提升多少
整套验证分为七组对照实验:先测试数据时长和任务成功率的关联,再依次验证数据多样性、样本效率、动作对齐、动作监督带来的影响;随后直接对比人类数据与机器人遥操作数据,最后解决多视角接入的难题。
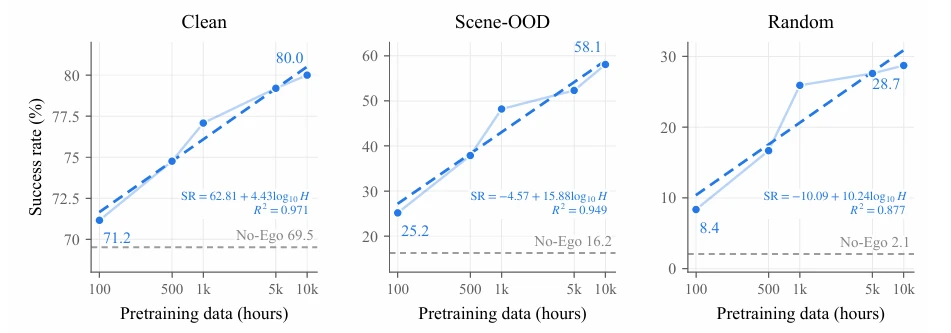
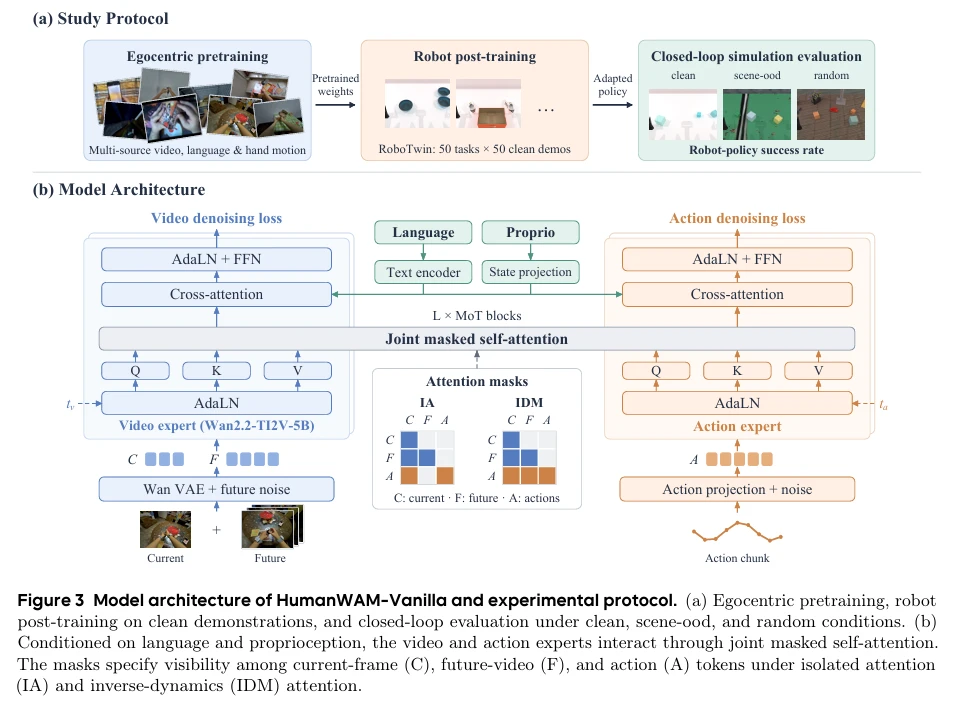
第一组实验,测量规模缩放曲线。团队采用隔离注意力架构,将预训练数据从 100 小时逐步提升至 10,000 小时。每一轮模型,都会先用 RoboTwin 2.0 里的 50 组标准示范做后训练,再分别在三类环境里各跑 50 轮测试:标准干净场景、分布外场景、完全随机场景。干净场景下,成功率从 71.2% 上涨至 80.0%;分布外场景从 25.2% 上涨至 58.1%;随机场景从 8.4% 上涨至 28.7%。作为参照,不经过人类数据预训练的基线,三项指标分别只有 69.5%、16.2%、2.1%。
性能差距主要体现在模型从未见过的场景。三类测试的成功率,都和预训练时长的对数近似呈线性关系,拟合优度依次为 0.971、0.949、0.877。换算下来,预训练数据每扩大十倍,干净场景成功率提升 4.43 个百分点,分布外场景提升 15.88 个百分点,随机场景提升 10.24 个百分点。
第二组,更换注意力机制复核结论。逆动力学注意力允许模型参考后续视频帧推断动作。在这套配置下,干净场景的提升幅度很小:100 小时预训练对应 87.4%,拉到 50,000 小时也仅有 89.0%;不使用人类数据预训练的基线也能达到 87.9%。但分布外场景从 49.1% 升至 73.2%,随机场景从 21.5% 升至 42.9%,拟合优度分别达到 0.969、0.955。两套完全不同的注意力架构,得到趋势一致的缩放规律,说明扩大数据带来的泛化收益,并不绑定某一种特定模型结构。
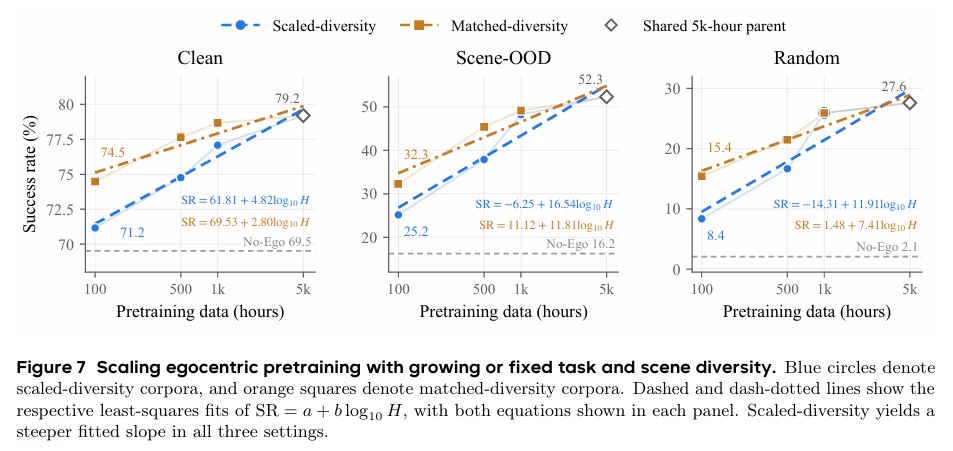
第三组,验证数据多样性的价值。团队基于 EgoSuite‑Open100K 搭建两套数据集:一套随着时长增加,不断扩充任务与场景类型;另一套固定任务和场景范围,只新增不同轨迹。同样是 100 小时的数据,固定范围版本覆盖 2,288 个任务、2,953 个场景;持续拓展的版本仅覆盖 62 个任务、222 个场景。最终拓展组的缩放斜率在三项测试里分别高出 2.02、4.73、4.50。场景和任务覆盖越广,性能随数据上涨的曲线就越陡。
第四组,测试样本效率。团队选取 500 小时、5,000 小时两个预训练档位,分别搭配 5、10、25、50 条示范样本做后训练。只用 10 条示范时,干净场景成功率从无预训练的 34.5%,依次提升至 44.2%、50.1%。经过 5,000 小时预训练的模型,仅靠 25 条示范,分布外场景就能拿到 42.0%,超过 500 小时预训练模型搭配 50 条示范的 37.9%,达到只用一半机器人示范样本就能胜出的效果。
第五组,确认动作对齐的实际收益。研究人员使用同一批 1,000 小时片段,一份统一映射到标准动作空间,另一份保留各个数据集原生的动作表达。经过对齐之后,干净场景成功率从 72.0% 升至 77.5%,分布外场景从 43.2% 升至 52.2%,随机场景从 18.0% 升至 26.4%;预训练阶段动作损失明显下降,视频重建损失基本持平。
第六组,判断是否有必要加入人手动作监督。同样 1,000 小时视频,一组只做视频预测,另一组在一半片段上增加手部动作监督。训练至 20k 步时,干净场景从 70.4% 升至 75.2%,分布外场景从 13.0% 升至 34.8%,随机场景从 3.6% 升至 16.3%;继续训练到 30k 步,只做视频预测的模型几乎不再进步,带动作监督的模型依旧保持上涨。
第七组,直接对比人类视频数据与机器人遥操作数据。在 100 小时规模,机器人数据在分布外场景小幅领先;超过 500 小时之后形势反转。5,000 小时人类数据,干净场景领先 7.3 个百分点,分布外场景 52.3% 对比 45.6%,随机场景 27.6% 对比 22.4%。仅 1,000 小时人类数据训练出来的模型,在三项测试上,全部优于使用 5,000 小时机器人遥操作数据训练的模型。
多视角是最后一道难关。如果直接在后训练阶段给机器人新增两路腕部相机,在隔离注意力设置下,分布外场景成功率从 46.1% 掉到 33.0%–34.1%,随机场景从 22.5% 掉到 12.9%–14.8%。团队借助 EgoPro 数据集补充一段中间训练素材,这批素材同时包含头戴相机和腕部相机的同步画面;模型把三路画面作为条件输入,只预测头部视角的未来视频。调整之后,分布外场景回到 61.2%,随机场景达到 30.7%,超过单视角版本的 28.6%。
这一系列对照里,藏着一个关键的实验设计。每一套数据集,都会保存每 10k 步的模型权重,全部跑完后训练与评测;并且针对每一类测试环境,单独选取表现最优的权重。团队发现,在干净场景里效果最好的权重,未必适配随机场景。分开选取最优结果,才能清晰区分分布内、分布外两条不同的缩放曲线。
完成这整套验证,这套训练配方就可以用来训练正式的基础模型底座。
纯人类数据,训练独立底座模型
底座基于 Wan2.2‑TI2V‑5B 搭建,额外搭配一个和视频骨干网络深度一致的动作专家模块,二者共同组成混合 Transformer。模型采用逆动力学注意力实现动作与视频信息交互:训练阶段,带噪的真实未来视频隐变量作为条件,供动作模块完成去噪;推理阶段,模型先生成未来视频隐变量,再依托它预测一段包含 32 步的动作块。实际部署时,会先执行其中前 24 步,再重新规划后续动作。
预训练阶段仅使用 Open‑HumanWAM‑50K 数据集。动作块长度设为 32,视频按照每 4 个动作步抽取一帧的规则采样,一条样本一共包含 9 帧。优化器选用 AdamW,全局批大小为 8,192;学习率在前 5,000 步线性抬升至 1e‑4,随后通过余弦衰减降至 1e‑6,整体训练共 100,000 步。
多视角输入能力依靠中间训练环节接入。预训练阶段只输入头部视角画面;之后在 EgoPro 数据集上继续训练,将三路相机的当前观测全部作为条件输入,但模型依旧只预测头部视角的未来视频,再进入面向机器人的后训练流程。其中 RoboTwin 使用 2,500 条示范样本训练 24,000 步,RoboDojo 使用 3,500 条示范样本训练 50,000 步;真机实验里,每个任务分配 50 条示范,训练 10,000 步。
研究团队在 1,000 小时数据集上完成多组消融实验,其中两组结果反直觉。将动作表示从相对位移改为相机坐标系下的绝对位姿后,干净场景成功率从 83.56% 提升至 88.48%,分布外场景从 58.08% 提升至 62.00%。而动作专家模块的初始化对比显示:如果从 Wan2.2 的视频权重插值初始化,干净场景、分布外场景、随机场景成功率分别为 89.56%、83.20%、51.52%;若采用随机初始化,对应指标则达到 90.28%、83.92%、54.12%。最终正式版本选择随机初始化方案。
真机实验基于 Cobot Magic 双臂平台,设置四项任务,覆盖多步抓放、可变形物体、铰接物体以及长程整理,分别为纸杯叠放、毛巾折叠、抽屉收纳、桌面整理。每个任务、每种测试条件各重复跑 10 次;分布外测试会同时更换桌布与灯光,制造环境变化。
仿真部分给出了一组有说服力的对标数据。在 RoboTwin 2.0 上,模型 Clean2Clean 成功率为 92.08%,Clean2Random 为 68.88%,两项均值 80.48%,其中 Clean2Clean 指标在对比表里处于最高一档。作为对照,OpenWAM‑α 为 89.4%、48.7%,PICA‑WAM 为 90.68%、74.70%;GO‑3 Nano Preview 则在随机条件拿到 81.48%,在这一项分布外指标上保持领先。
在 RoboDojo 基准上,该模型六个维度的平均成功率为 14.17%,进度分为 19.00,高于表内多款世界动作模型基线,接近 Galaxea G0.5 的 14.60%、20.10%。它的优势集中在精度和长程任务,对应成功率分别是 20.50%、33.00%;而 OpenWAM‑α 在这两项上仅为 9.25%、25.33%。模型短板体现在记忆与开放指令任务,DM0.5 在记忆维度可以达到 47.44%,表现更强。
真机结果同样亮眼:分布内平均成功率从 57.5% 提升到 87.5%,分布外从 2.5% 提升至 67.5%。拆分来看,纸杯叠放的分布外成功率由 0% 升至 80%,抽屉收纳由 0% 升至 70%,毛巾折叠由 10% 升至 60%,桌面整理由 0% 升至 60%。作为基线,没有经过人类数据预训练的模型,在 40 次分布外测试中仅成功一次。仅仅更换桌布、调整灯光,这套从人类操作里学到的先验知识,价值就清晰体现出来。
目标图引导,实现图像驱动操作
只依靠人类数据训练出来的底座,依然离不开针对每项任务的动作示范。如果把机器人自身采集的数据混入训练集,再用一张目标图像指明最终要达成的状态,模型就可以直接完成新任务。
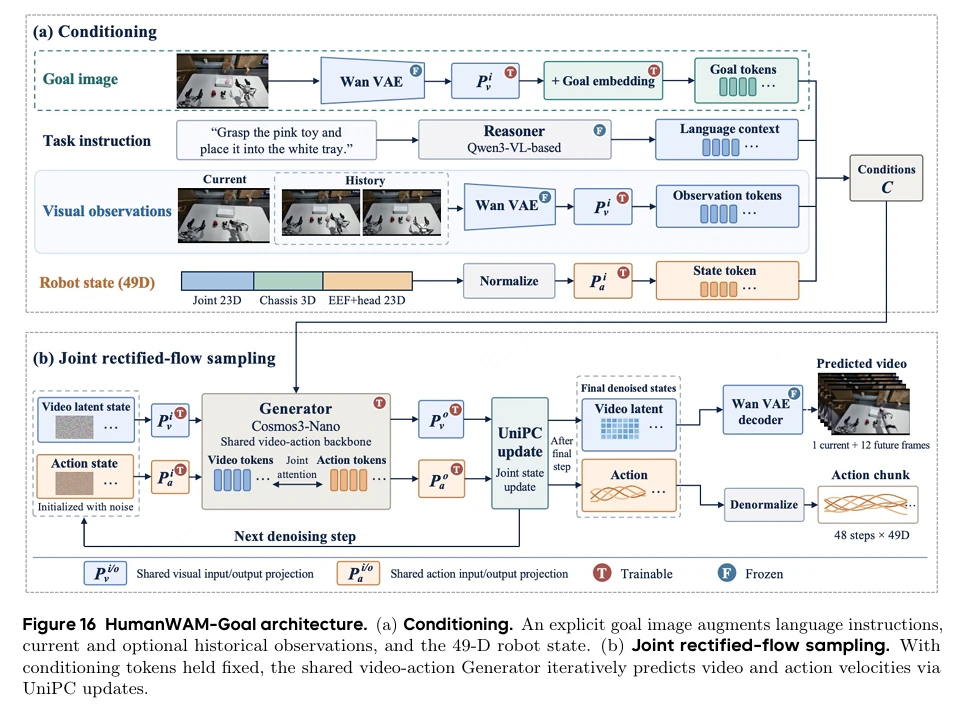
研究团队首先扩充动作空间:在原本 16 维双手末端表征之外,新增 23 维关节、3 维底盘以及 7 维头部位姿,组合为 49 维混合动作表示。夹爪开合度改用绝对物理开口,以 0.12 米作为基准宽度做归一化;人类样本直接采用拇指到食指的距离作为开口大小。末端位移调整为以当前观测为锚点的块内相对位移,投影至锚定时刻的头部相机坐标系,更换机器人本体时不需要重新统计标定参数。对于人类数据缺失的关节、底盘维度,训练依靠有效性掩码屏蔽对应损失;在机器人训练阶段,还会随机遮蔽关节分支,倒逼共享的末端动作通路稳定学到通用规律。
模型主体更换为 Cosmos3‑Nano‑16B,语言部分使用冻结的 Qwen3‑VL Reasoner,视觉与动作输出由一套参数共享的生成器完成。目标图像会单独编码,叠加一个可学习的目标嵌入,作为独立的条件 token 送入生成器,和实时观测做出区分。推理阶段,视频隐变量与 48 步动作块同步去噪,采用联合整流流采样。
这套设计省去了串行采样的开销。纯语言引导的方案,需要先生成完整的未来视频,再基于视频输出动作,是两步串行流程;而目标图已经锁定目标空间构型,研究团队将两个步骤合并,采样延迟直接减半。目标图既是任务指令,也是整个动作因果链的锚点,模型不必先脑补全部未来画面,再开始执行动作。
训练素材分为多组对照。机器人数据规模从 2,005 小时逐步扩充至 4,261、8,475、14,618 小时,覆盖八个真机场景域、合计 110 万条交互片段;人类数据则固定搭配在 14,618 小时机器人语料之上,额外叠加 15,901 小时或 45,938 小时的人类视频,总数据量分别约为 30.5k 与 60.6k 小时。目标图采用在线采样策略:四成取自往后 2–8 秒的画面,两成取自片段末尾帧,两成取自下一个子任务的收尾帧,剩余两成设置为空目标,空目标对应的 token 会直接剔除。
零样本测试首先在仿真环境开展。不针对 RoboTwin 做额外适配,只用机器人数据训练的版本平均成功率为 11.48%;混入人类数据之后,指标提升至 13.94%。单个权重 checkpoint 能够覆盖的任务,从原本 50 项里的 8 个,提升到混训后的 22 个,累计一共可以覆盖 29 项任务。对比基线里的多数模型甚至无法跑通这套评测,缺少动作归一化统计、本体映射与可用预训练权重;能够完成测试的 π0.5 仅有 1.06%,Pelican‑VLA 0.5 为 4.70%。
经过后训练之后,混合数据训练的优势持续体现。随着机器人数据从 2,005 小时增加到 14,618 小时,干净场景成功率从 87.24% 升至 89.84%,随机场景从 59.88% 升至 70.80%;但随机场景的收益在 8,475 小时之后就进入平台期,70.96% 和 70.80% 几乎持平。叠加人类数据之后,这条增长瓶颈被打破,随机场景成功率进一步达到 71.68%、74.36%,而干净场景的性能稳定维持在 89% 附近。
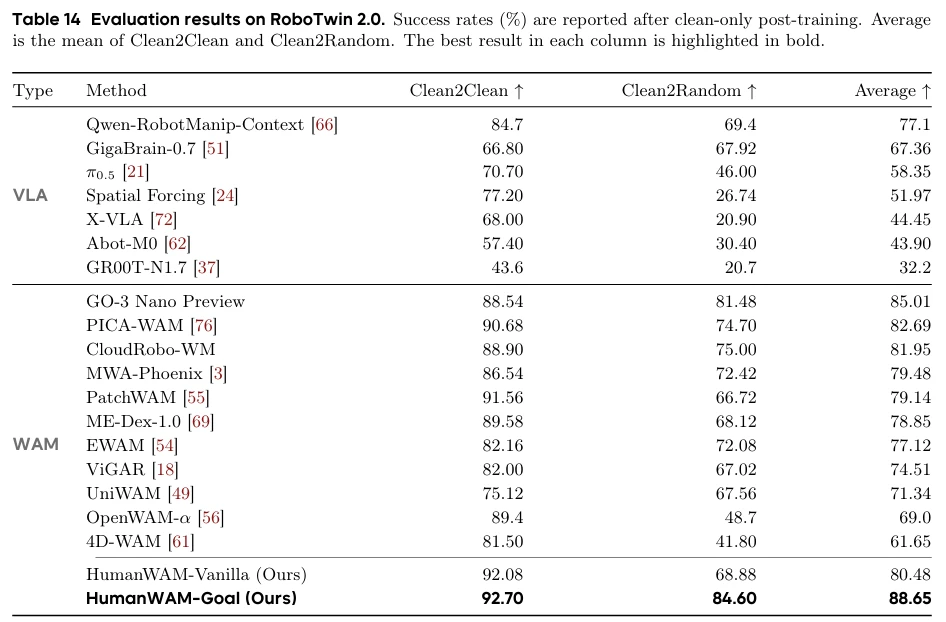
搭配光度增强与后训练配方微调之后,该版本在榜单拿到 Clean2Clean 92.70%、Clean2Random 84.60%,两项均值 88.65%,相比此前领先的 GO‑3 Nano Preview 高出 3.64 个百分点,干净场景、随机场景分别高出 4.16、3.12 个百分点。
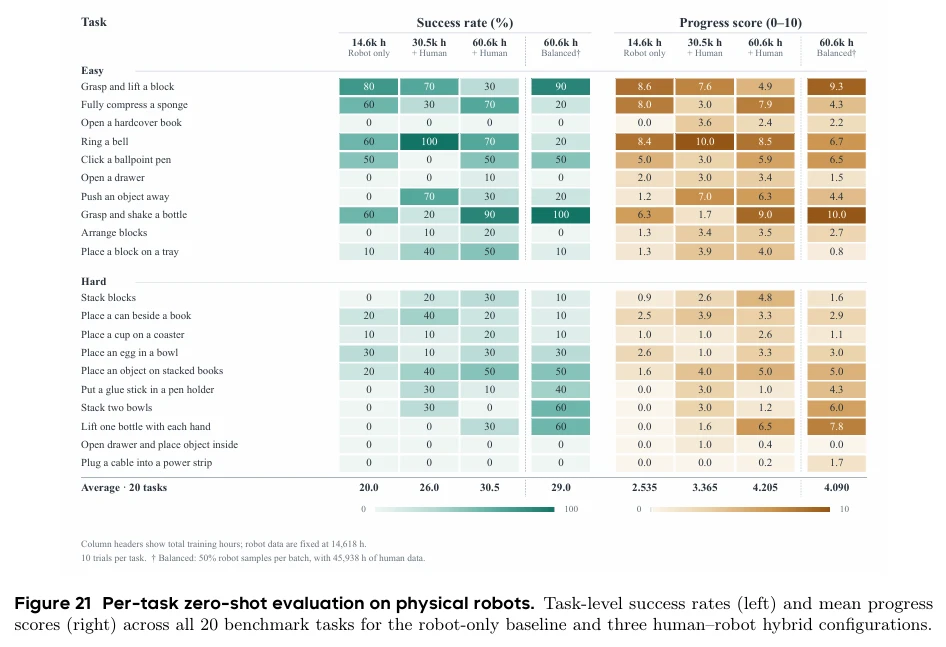
真机实验切换至 Astribot S1,这是一台带轮式底盘与可动躯干的机器人。一共设置 20 项任务,分为 10 项简单任务、10 项困难任务,每项任务重复测试 10 轮。零样本平均成功率,从纯机器人数据的 20.0%,先后提升至 26.0%、30.5%;其中简单任务由 32.0% 升至 42.0%,困难任务由 8.0% 升至 19.0%。困难任务在默认采样配比下容易到达瓶颈:训练混合样本里人类片段占比高达七成六;把批次配比强制调整为一比一后,困难任务成功率从 19.0% 跃升至 27.0%。整体进度分从 2.535 提升至 4.205,能够完成至少一次成功回合的任务数量,从 20 项中的 10 项增加到 16 项。
最有价值的能力是图像引导的上下文学习。使用同一组冻结权重,仅仅更换目标图,机器人就可以把瓶子放到绿色积木前方的桌面,或是放到紫色积木顶端。这套能力在后训练之后依旧保留,并且支持多张目标图输入:它可以交换玩具车和毛绒玩具各自对应的垃圾桶,或是同步修改书本的堆叠顺序与摆放位置,整套动作序列随之对应调整。即便是普通人拍摄、画面里露出人手的目标图,机器人同样可以读懂画面里的空间关系,精准摆放物品,比如先给咖啡杯盖上盖子,再送到显示器旁或是文件架边上。
模型同样可以承接长程任务。桌面整理任务连续走完 14 个阶段:盖上杯盖、归置文具、开合两个抽屉收好卷尺与胶带、把笔记本插进书立,前面摆放好的物品不会被后续动作碰乱。家庭整理任务则跨多个区域执行:先在主桌收好玩具和书本,移步边桌丢弃空瓶子,再到两把椅子上把衣物收进洗衣篮,最后回到桌边,全程由 28 个关键帧串联完成。
Open‑HumanWAM 将原始第一视角人类视频从 10 万小时清洗精简至 5 万小时,依靠一套标准化的动作表征,打通五份来源各异的数据集,形成一套可复现的训练范式。研究团队在闭环仿真环境中测出:模型下游任务成功率,和预训练数据时长呈现对数线性的缩放规律。依照这套方案训练得到的 HumanWAM‑Vanilla 仅使用人类数据,经过后训练,就在 RoboTwin 2.0、RoboDojo 基准上取得具备竞争力的结果;就算在真机测试里更换桌布、调整灯光,模型依旧可以稳定完成操作。
研究最终归纳出两条核心结论。
在数据层面,只有同步拓宽任务与场景的覆盖范围,性能缩放曲线才会保持更高的斜率;在数据源层面,人类视频负责提供广阔的交互先验,机器人采集数据补齐对应本体的控制细节。将两类样本在训练批次里合理配比之后,无论零样本泛化还是后训练微调,性能都还有继续提升的空间。团队同步公开了数据集、训练代码、模型权重、推理脚本以及仿真评测全套工具,供后续研究者在此基础上继续推进。