

8B 负责推理,8B 负责「想象」:达摩院给机器人搭了个什么大脑?
作者:江思奇
主:8B 负责推理,8B 负责「想象」:达摩院给机器人搭了个什么大脑?
副:大模型,开始用视频打草稿
小红书正文
对于机器人来说,脑补被遮挡的物体实在太难了。10 月 23 日,阿里巴巴达摩院团队联合湖畔实验室发表论文《迈向统一具身大脑》(RynnUnify: Towards Unified Embodied Brain),提出了仅 16 B 规模的具身模型 RynnUnify,这个模型可以预测每段任务的末帧再根据末帧开启下一轮推理任务,它不只是输出动作,同时也预判动作带来的场景改变。
论文一共有 23 位作者,Minghao Zhu、Bohan Hou、Kun Xiang、Zixuan Wang、Yinzhou Tang、Yifei Yang、Zhikai Wang、Tianyi Zhang、Kehan Li 为核心贡献者,刘成菊与 Jianfei Yang 为共同通讯作者。参与作者赵德丽是阿里巴巴达摩院首席科学家,也是达摩院具身智能团队的创建者。
达摩院团队的思路,是将环境理解和未来预测放进同一个条件框架,打造仅 16 B 规模的具身模型 RynnUnify,让语言推理和视频生成形成闭环循环,其中推理模块拆解任务、定义下一步动作;视频模块预测场景变化,再拿预测画面的尾帧交给下一轮推理。它不只输出动作,同时也预判动作带来的场景改变。
目前主流的统一具身模型,大多将理解模型和世界模型分成两套独立模块,依靠文本或者坐标信息完成对接。短距离、单步的任务里很难看出缺陷,一旦任务链条拉长,问题就会暴露:模型会沿着上一步出错的画面继续向前推演,愈演愈烈。
而 RynnUnify 模型会把每段预测的末帧交给下一轮推理。它要回答的不只是「现在该做什么」,也包括「做完之后,场景可能变成什么样」。
论文:https://arxiv.org/abs/2610.32965
#阿里巴巴达摩院 #统一多模态模型 #世界模型 #具身智能
封面
摘要
对于机器人来说,脑补被遮挡的物体实在太难了。10 月 23 日,阿里巴巴达摩院团队联合湖畔实验室发表论文《迈向统一具身大脑》(RynnUnify: Towards Unified Embodied Brain),提出了仅 16 B 规模的具身模型 RynnUnify,这个模型可以预测每段任务的末帧再根据末帧开启下一轮推理任务,它不只是输出动作,同时也预判动作带来的场景改变。
论文一共有 23 位作者,Minghao Zhu、Bohan Hou、Kun Xiang、Zixuan Wang、Yinzhou Tang、Yifei Yang、Zhikai Wang、Tianyi Zhang、Kehan Li 为核心贡献者,刘成菊与 Jianfei Yang 为共同通讯作者。参与作者赵德丽是阿里巴巴达摩院首席科学家,也是达摩院具身智能团队的创建者。
统一具身模型的目标,是让同一个模型同时完成三件事:看懂当前场景、预判后续环境变化、把抽象意图转化为具体动作。
目前业界主流方案,大多是把理解模型和世界模型分开部署,一个负责理解输出指令,一个负责生成画面,二者依靠文本或者坐标传递信息。两个模块单独训练的效果都不错,但拼接在一起之后,没有机制让它们为彼此的输出结果负责。
这种分离架构的短板,在长程任务里会集中暴露。理解模型无法校验自己指令对应的画面是否合理,世界模型也不清楚自己生成的内容,要支撑哪一步决策。如果把视频预测做成一次性生成,或是不加区分地要求所有任务都先做虚拟推演,不准确的动态信息、失真的空间几何结构,就会流入下一轮推理。
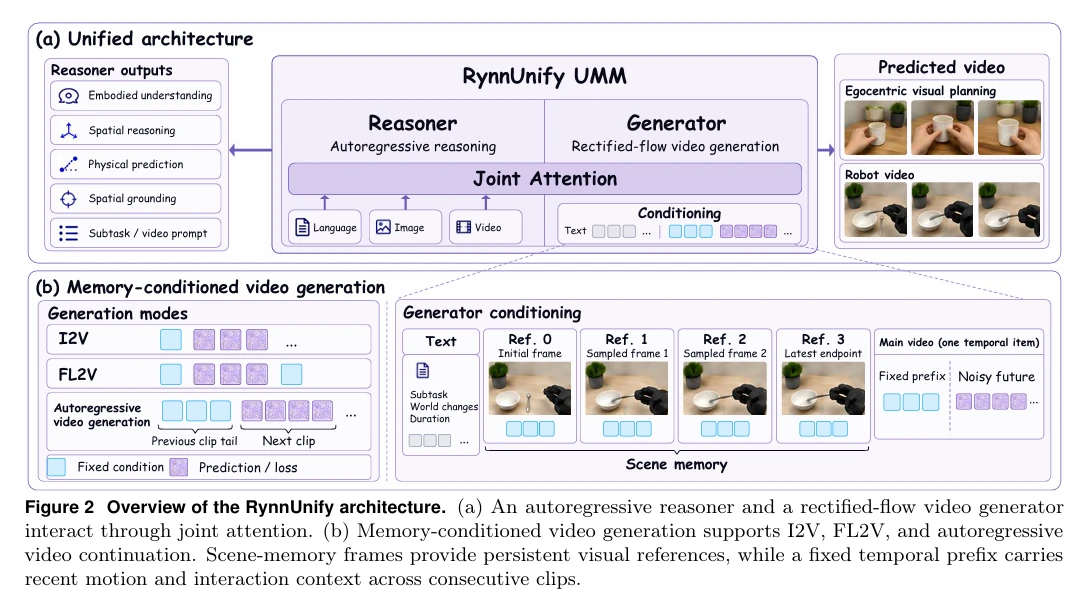
针对上面这两个核心问题,达摩院团队提出 RynnUnify,一款 16 B 规模的统一具身模型。它由 8 B 自回归推理器与 8 B 视频生成器构成,两个模块依靠联合注意力打通。
这套架构,将两项能力同步驱动:
其中,推理器负责输出约束条件,生成器基于这些条件推演视频,视频的尾帧再回传给推理器,作为它新一轮环境观测,循环完成一步步的接续推演。 生成器还额外配套了两组缓存:四帧场景记忆用来保留场景外观与空间布局,上一段视频的末尾信息记录近期的运动和交互状态,就算物体暂时离开相机视野,模型也能够持续追踪目标。
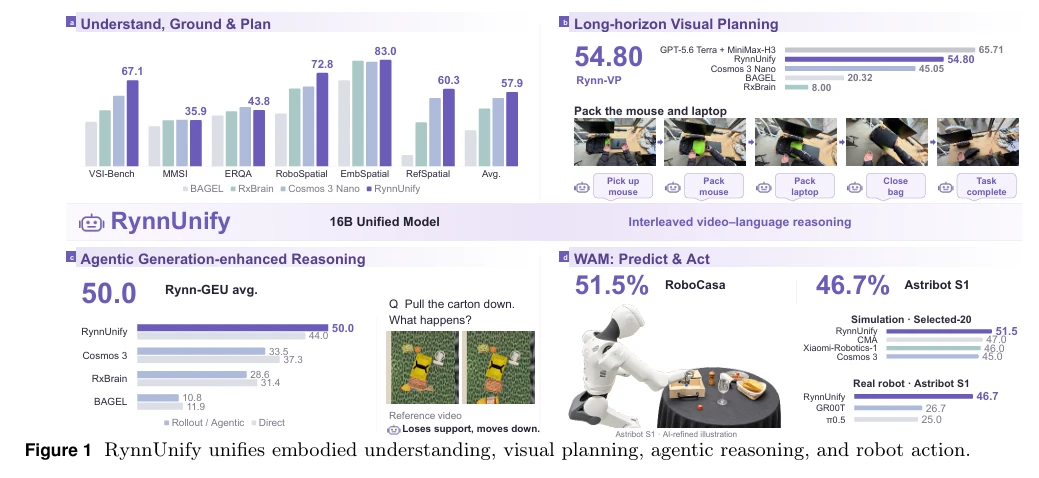
团队还从推理器复刻出一个 8 B 的智能体,借助强化学习自主判断,哪些任务适合先推演视频、哪些任务可以直接给出动作。优化之后,模型在 Rynn-GEU 的平均分从 44.0 提升到 50.0;在自研基准 Rynn-VP 上,总分由 45.05 上涨至 54.80,其中规划智能单项从 30.50 提升至 45.66。 当模型扩展为世界动作模型时,视频特征不需要解码成图像,直接送入动作头输出控制信号。这套方案在 Astribot S1 的三项真机任务里,取得 46.7 % 的平均成功率。
推理器定步骤,生成器画后果
RynnUnify 的基础骨架沿用英伟达 Cosmos 3 的 Mixture-of-Transformers。推理器和生成器两个分支保有独立的 Transformer 参数,仅通过联合注意力完成交互,生成器可以直接读取推理器的表征。推理器本身结构没有改动,团队的调整集中在生成器的条件接口,新增跨片段场景记忆,同时支持首尾帧约束生成。整套架构以 Cosmos 3 为基底,后续的具身微调与能力扩展,都在这个骨架上完成。
推理器每一轮输出三项信息:下一步执行的动作、这一步对应的场景变化、动作大致持续时长。
前两项以文本表达,最后一项为数值,共同作为生成器的输入条件。动作时长不是固定值,因此模型采用 4n+1 帧序列训练,保留原生骨架的三维旋转位置编码与帧率调制。跨片段接续推演时,时长统计只计入新生成片段,不包含前面的历史前缀。将动作目标、预期场景变化、执行时长打包成同一组条件,推理器和生成器就拥有统一的表达基准。
长程接续推演的核心难点,在于记忆机制的搭建。推理器维护四组参考帧:**一帧固定为初始观测画面,两帧选取更早的历史画面,还有一帧取自上一步最新观测。**历史画面不足时,会从已经生成的视频片段中补充;在任务第一步,初始帧会重复填满四个记忆槽位。
四帧参考画面各自通过因果视频 VAE 独立编码,对应的词元序列拼接在文本条件之后、主视频词元之前,边界清晰,不会混入主视频的时间轴。除了稀疏参考帧,模型还接入上一段视频的尾部片段,和新生成序列衔接,交界帧只保留一次。参考帧负责稳住场景外观和空间布局,视频前缀承接近期的运动与交互信息,二者配合,支撑多段连续场景推演。
模型一共支持三种生成模式。
- 以单张起始帧向前推演,属于图生视频;
- 固定首尾两帧、补全中间画面,为首尾帧约束生成;
- 将上一段视频末尾作为前缀继续生成,则是跨片段续接。
三种模式下,场景记忆对应的潜变量、主视频内的条件帧,在整个去噪过程中保持固定,模型只更新待预测区域。训练阶段,损失仅在待预测位置上计算,条件输入、独立编码的记忆项不参与损失计算;归一化操作也只作用于包含预测目标的视觉项,防止条件输入冲淡监督信号。
完成单步规划后,生成片段的最后一帧,会作为新观测传回推理器,开启下一轮循环。
两段训练,学会挑选推演时机
整套训练数据划分为理解、规划两个分支。
理解分支以 RynnBrain 预训练语料的 10% 作为基础,体量约 200 万条,覆盖通用图文、视频理解、时序推理、指令跟随任务;在此之上叠加空间定位、物体可供性、运动轨迹、操作规划相关监督数据,再补充团队自建的 15.3 万条推理样本与 4.3 万条感知样本。
规划分支收录人类与机器人操作示范,其中人类示范 55 万条、机器人示范 60 万条,外加 RoboCasa365 数据集的 8.7 万条样本。用于视频生成的素材合计 108.3 万段片段,总时长约 1,370 小时。示范样本会先裁切为 2 至 10 秒的短片;缺少子任务标注的片段,交由 Qwen3.6-27B 完成时序切分与补标注,再通过 GPT-5.6-Terra 转化为结构化视觉提示,清晰记录场景布局、交互物体、动作流程以及最终状态变化。
同一套结构化提示会双向复用:一方面用来监督推理器输出规范条件,另一方面直接作为生成器的文本输入,保证规划指令和生成画面遵循统一表达格式。
训练流程拆为两个阶段。第一阶段单独训练推理器,采用标准自回归损失,仅对模型输出的回复词元计算损失,学习率设置为 2e-6,批大小 1024。第二阶段冻结推理器权重,只更新生成器,学习率 2e-5,训练 8,000 步,梯度裁剪阈值 0.3;损失函数替换为整流流对应的流匹配损失,并且只针对待预测的主视频区域计算。两个阶段各自只更新一半参数,避免理解模块和视频生成模块互相干扰、目标拉扯。
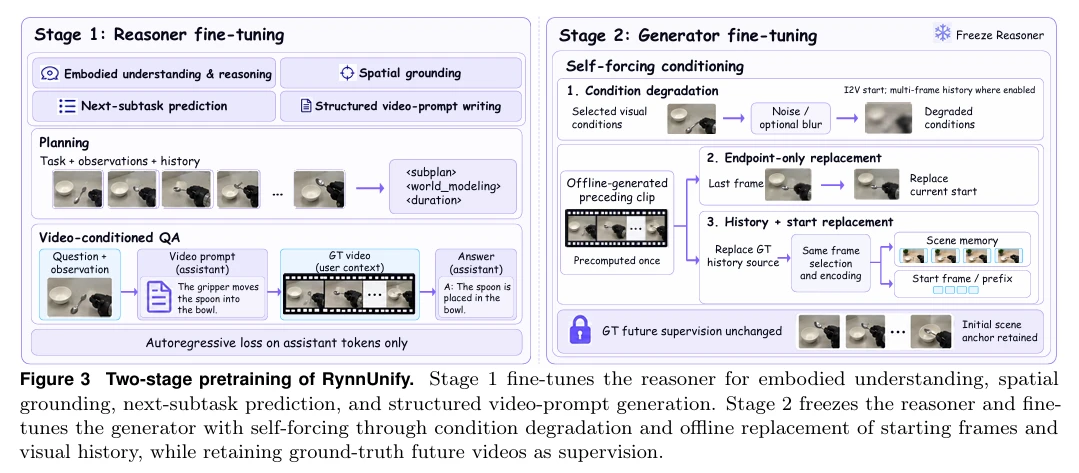
真机推演时有一个现实落差:推理阶段每一段的起始画面,都来自上一轮模型自己的预测;但原始训练全程使用真值画面作为条件。这种不一致,会让部署后的误差持续累积放大。
团队设计了三种「污染条件」的方案来弥合这个缺口。
第一种是条件退化:在像素层叠加高斯噪声,噪声标准差从 0 至 0.15 区间随机采样,施加概率 0.3,另外还有 0.5 的概率执行一次下采样再上采样,模拟画面模糊。
第二种是离线端点替换:提前用固定权重离线生成并缓存前置视频片段,拿它的尾帧替换当前片段的真值起始帧。
第三种会同时替换历史序列和起点:用缓存的生成片段替换真值历史视频,场景记忆、视频前缀依旧从这份生成内容里重建。整个过程的监督目标不变,依旧是向真值序列续写,改动的只有模型接收的起始观测,让模型适应从带有偏差的自研输出上继续推演。
强化学习模块,专门用来解决一个核心问题:什么时候需要先生成视频推演,什么时候可以直接输出动作。
团队从 8 B 推理器复刻出一个独立智能体。每一道测试题目,都会采样 4 条直接作答轨迹、4 条「先推演视频再作答」的轨迹。同一分支内部,依靠序列级 GSPO 算法对比轨迹优劣;两条不同分支之间,则以平均奖励差值作为软路由优化目标,奖励越高,模型就越倾向选择视频推演这条路径。奖励值由格式合规分和答案质量分相乘得到:数值、几何类任务,通过归一化误差映射到 0 至 1;可供性、区域匹配任务,依据对称最近点距离打分;轨迹匹配任务,采用离散弗雷歇距离计算。
本次强化学习训练集包含 22,007 道题目、883 道验证题;每一轮取 64 道题,每题采样 8 条轨迹,一轮合计 344 次参数更新。到推理阶段,模型自主选择分支,选定后就沿着该路径完成输出。
视频想象,究竟能带来多少增益
研究团队在十项公开基准上测试模型的理解能力,包含 VSI-Bench、MMSI-Bench、MindCube、ERQA、RoboSpatial、EmbSpatial、RefSpatial-Bench、ShareRobot 的可供性与轨迹两个子项、Where2Place。所有结果先按照各基准原生指标计算,再归一到 0 至 100 区间,最后取不加权平均分。
长程规划能力,则依托团队自建的 Rynn-VP 基准开展测试。这套基准一共包含 200 个第一视角任务,输入为一张初始图像和一句高层指令;模型可以选择生成视频,或是输出有序步骤图,任务最长允许 15 步推演。评分指标拆成三部分:规划智能权重 0.5、视觉实现权重 0.4、画质权重 0.1。评测依靠 GPT-6-sol 在 Codex 内运行的打分流程完成,另有十位硕士及以上评审,完成 300 次交叉复核,保障结果稳定。Rynn-GEU 基准做了场景隔离,训练集与测试集完全分开,并且会根据「能否借助未来视频信息答对题目」筛选测试样本。
**在理解能力的对比里,RynnUnify 是这批统一具身模型中的第一名,十项平均分达到 57.9。**Cosmos 3 Nano 为 53.2,RxBrain 为 44.9,BAGEL 仅 28.0,RynnUnify 在十项基准中的六项取得领先。细分来看,它在 VSI-Bench 拿到 67.1,相比 Cosmos 3 Nano 高出 12.2;RoboSpatial 得分 72.8,高出 10.7;RefSpatial-Bench 拿到 60.3,ShareRobot 的可供性指标从 28.0 提升至 41.8,这两项都是所有参评模型里的最优成绩。ShareRobot 轨迹误差为 0.27,该指标数值越低代表效果越好。这组对照里还加入了通用多模态模型,同赛道能力最强的 GPT-5.6 Terra 平均分 52.6,比 RynnUnify 低 5.3 分,说明这套统一模型在具身空间理解上不输顶尖通用大模型。而达摩院自研的专用理解模型 RynnBrain-8B 平均分 61.2,表现还要优于这款 16 B 统一模型。这也能看出,架构统一带来的收益,并不体现在基础理解能力上。
再来看视频想象带来的变化。在 Rynn-GEU 的十个子集上,RynnUnify 直接作答就能拿到 44.0,已是统一模型梯队里的最高水平。接入学会判断时机的 agentic 机制之后,平均分上涨到 50.0,十个子集中有七项分数提升。其中区域定位提升幅度最大,从 35.9 涨到 66.2;杂物堆连锁交互任务从 8.5 提升至 29.1。也有少数指标小幅回落:位置、距离、尺寸这三项细粒度几何任务分数略有下滑,原因是生成视频自带几何畸变,干扰这类高精度判断。三项公开推理基准同步受益,平均分从 41.3 上升至 44.6,MindCube 单项提升 8.4 分。反观其他竞品,情况截然相反:给 BAGEL、RxBrain、Cosmos 3 Nano 强行加上交错想象 rollout 机制之后,它们在 Rynn-GEU 的平均分分别从 11.9、31.4、37.3 下跌到 10.8、28.6、33.5。视频想象不会无条件加分,如果生成的画面失真、偏离真实场景,错误信息会顺着推演链路传递,拖累后续推理。

长程规划基准 Rynn-VP 的测试结果显示,RynnUnify 总分 54.80,对比 Cosmos 3 Nano 的 45.05,提升 9.75 分。拆开指标看,规划智能从 30.50 涨到 45.66,增幅 15.16;视觉实现从 54.58 提升至 60.54;画质分数反而小幅下降,77.53 对比 79.69。团队将这份增益归结于多重机制配合:具身微调、跨片段场景记忆、自强迫训练,还有按子任务预估动作时长的设计。不过外部拼接式系统的上限依旧更高,GPT-5.6 Terra 搭配 MiniMax-H3 组合拿到 65.71,比 RynnUnify 高出 10.91 分。所以「统一模型里最好」这个结论,只限定在单模型的范围之内。
视频特征直连动作头
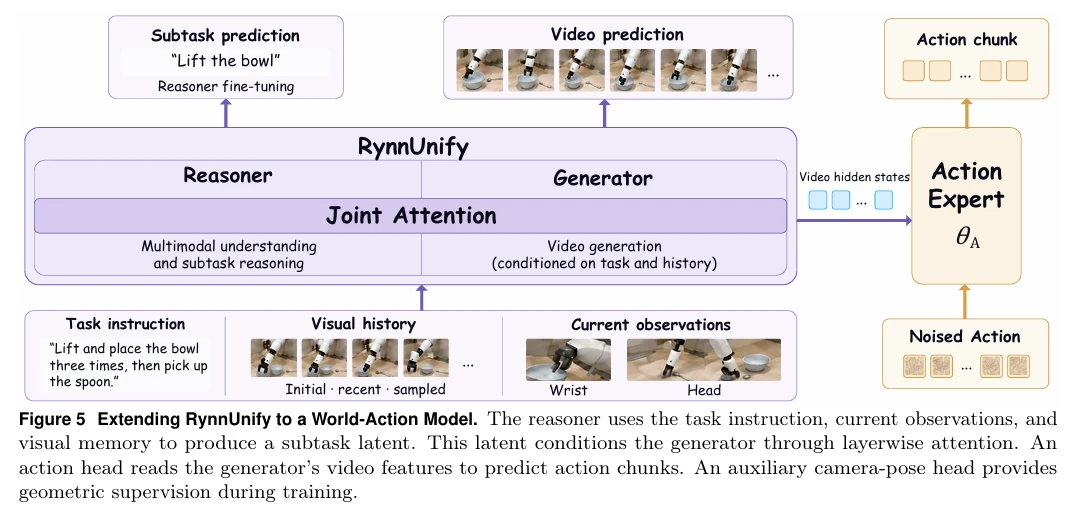
想要把场景理解、未来想象和机器人动作打通,团队额外训练了一套世界动作模型。
- 推理器接收指令、当前三路相机画面以及视觉历史信息,最多可以输入 12 帧图像,输出一段连续的子任务潜变量;
- 生成器以这份潜变量作为条件,预测后续视频序列;
- 动作头直接读取生成器输出的视频隐状态特征,它包含 18 个 block,依靠跨注意力,每个 block 对接两层生成器网络层,通过流匹配输出一段包含 48 步、12 维的动作块,机器人实际只执行前 16 步。
整套链路里,动作头读取的是底层视频特征,不需要解码渲染出完整画面,省去了中间这一步开销。还有一个相机位姿头仅用于训练阶段,用来提供几何层面的监督信号。
适配机器人的训练数据取自 RoboCasa365,包含约 1600 小时原子任务轨迹,外加 177 小时组合任务轨迹,每条样本都附带指令、三路同步图像、动作序列以及子任务标注。
训练流程拆成三个阶段:
第一阶段只训练推理器的语言层,视觉编码器和生成器全部冻结,让模型学会从指令、实时画面和历史观测当中识别当前子任务;
第二阶段固定推理器,单独训练生成器,视频损失和原生动作损失设置为等权重,单段序列为 48 帧、20 赫兹,对应时长 2.4 秒;
最后一个阶段联合训练生成器与动作头,总损失由动作损失、0.01 倍权重的位姿损失、0.005 倍权重的跨相机损失共同组成。推理阶段,一次前向运算提取视频特征,动作采样复用同一批特征,再通过 16 步欧拉积分,输出最终的动作块。
仿真环境内,Selected-20 基准包含 20 项复合移动操作任务,每项任务重复测试 10 次,合计 200 轮实验。RynnUnify 拿到 51.5% 的成功率;作为对照,CMA 为 47.0%,Xiaomi-Robotics-1 为 46.0%,Cosmos 3 为 45.0%。如果和常规视觉语言动作策略对比,差距会更加明显:π0 仅有 3.0%,π0.5 为 2.0%,GR00T N1.5 是 7.5%,这类策略面对组合长任务,往往在起步阶段就陷入停滞。
在 Composite-Unseen 未见过组合任务集上,RynnUnify 成功率 50.0%,比 CMA 高出 6.0 个百分点,比 Cosmos 3 高出 11.0 个百分点;Composite-Seen 见过任务集上得分 52.0%,位列第二,Xiaomi-Robotics-1 以 57.1% 的成绩领先。它在陌生任务组合上的表现反而更加稳定,这也是它和其他基线拉开差距的关键。
真机实验搭载 Astribot S1 机器人,设置三项任务,每项重复测试 20 次。转向抓取,要求机器人先转动机体再伸出机械臂,考验视角变化之后的目标定位与肢体协同能力;方块交换,需要把红色、蓝色两个小方块互换位置,考验小物件抓取与放置的精度;碗三次再勺子,流程是连续三次拿取、放回碗具之后再抓取勺子,每一轮的视觉画面高度相似,模型只能依靠历史信息判断当前执行到第几步。
三项任务上,RynnUnify 的完整成功率依次是 55.0%、35.0%、50.0%,平均成功率 46.7%。对比基线,GR00T N1.7 平均 26.7%,π0.5 平均 25.0%。其中碗具任务,RynnUnify 比最强基线高出 10 个百分点,这也直接证明,视觉历史记忆机制确实在发挥作用。