

石冠亚:智能体有望融合基于模型与无模型两条路线 |CoRL 2026
作者:于跃
2026 年 11 月 12 日下午,机器人学习会议(CoRL)在奥斯汀 JW Marriott 的 203–204 房间举行工作坊「Agentic Robotics」。卡内基梅隆大学机器人研究所助理教授石冠亚(Guanya Shi)是第二场邀请报告,报告题目是「从真实世界经验出发的机器人学习:基于模型(model-based)、无模型(model-free)和智能体自我改进」。他要讲的,是智能体式的机器人自我改进,以及他们在真机上已经做出的结果。他第一次看到这些真机结果时,觉得相当科幻。
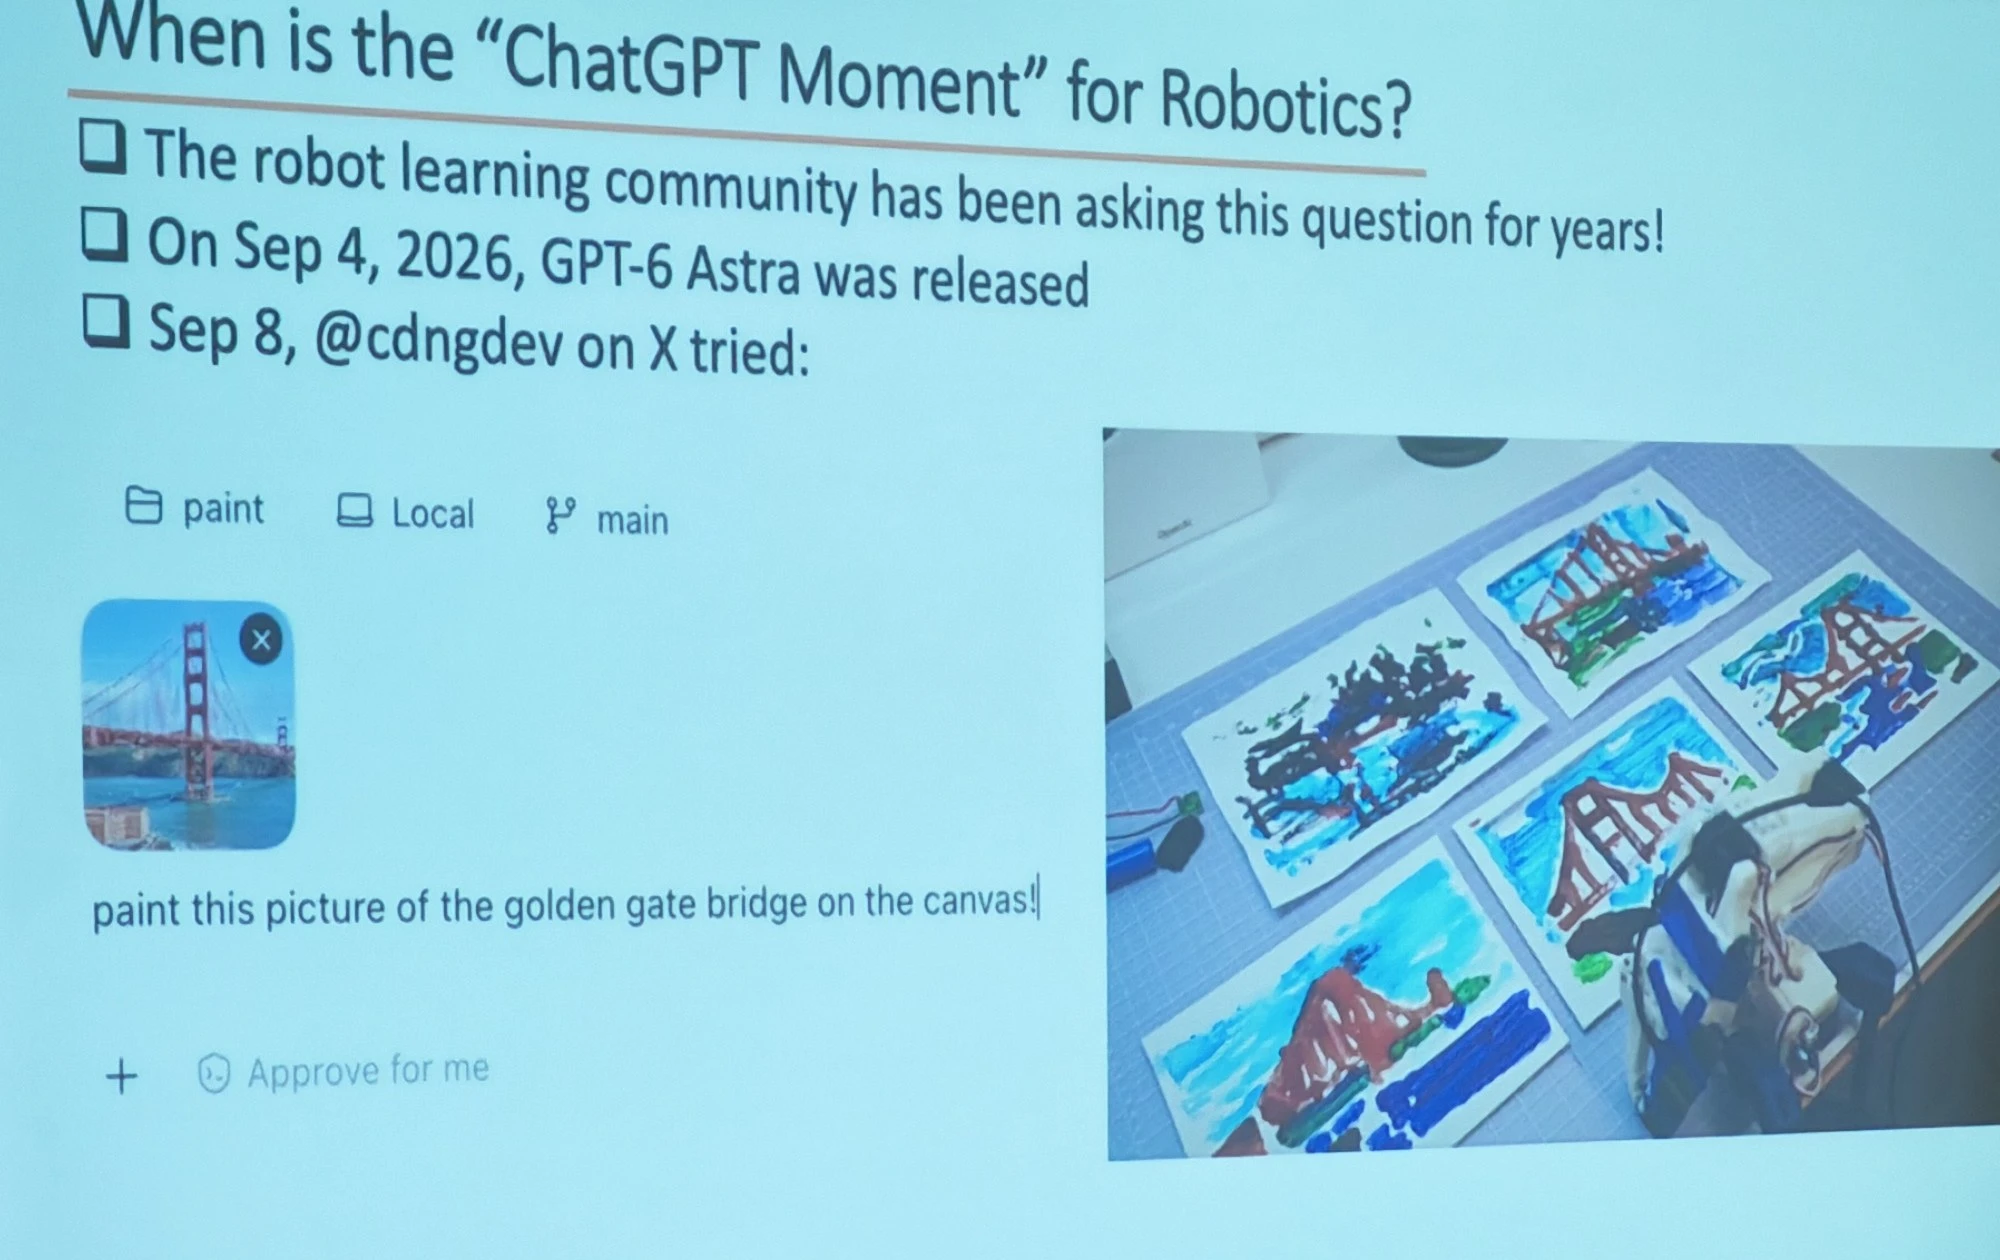
他先从一个问了多年的问题讲起:机器人的 ChatGPT 时刻何时到来。机器人学习社区已经问这个问题很多年了。
9 月 4 日,GPT-6 Astra 发布。9 月 8 日,@cdngdev 在 X 上用 Astra 控制一只很便宜的 YAM 机械臂,按「把这张金门大桥的图画到画布上」去做,只用了 5 次尝试,效果就很好。机器人还会一轮轮把画画得更好。他觉得,这可以叫递归的自我改进。
可对做机器人的人来说,心情是复杂的。大家还在等机器人领域的 GPT 时刻,GPT 的机器人时刻却先到了。他觉得,这对这个社区来说,其实并不是什么好事。
他自己更早的一次触动,发生在 2026 年 3 月 7 日。Andrej Karpathy 发布了自动研究仓库 autoresearch,用 Claude Code 对 nanochat 的语言模型训练做爬山。图上的进度是 83 次实验,留下 15 项改进。
石冠亚自己也做过更小模型的训练,清楚调架构和损失函数有多难;而当时那个写代码的智能体,已经能提出不少改动,把验证损失降下来。于是他问自己:改进机器人策略,和在 nanochat 上做自动研究,根本差别在哪里?
2026 年 4 月的一个周末,Claude Opus 4.7 刚发布,他在 Push-T 仿真里试了自动研究。设定是「代码即策略」(code as policy),完全没有神经网络策略,智能体直接写一堆代码来控制、完成这个任务。Push-T 是很难的多模态灵巧操作问题。
爬山过程可以看到:到了后来,智能体找出了相当聪明的办法,用上了规划和一些控制策略。这让他感到兴奋。于是他对学生说,为什么不拿到真机上试一试。那时也是 2026 年 4 月,还在 Astra 之前。
他们很快发现,在数字世界里跑写代码的智能体,和拿写代码的智能体去改进真实世界的机器人,确实有关键差别。nanochat 和 Push-T 仿真都是沙盒,环境容易复位,也容易得到奖励信号,也容易离已有结果很远地试。真实世界不是沙盒。
问题变成:怎样把诊断失败、改代码或训练流程、再去做试验,这条回路闭环。今天他讲了两种闭环办法。一种对照已公开的工作叫 ENPIRE:直接在真机上做实验,有了合适的运行框架,就可以在真机上做代码层面的爬山。另一种对照已公开的工作叫 SimEX:先在仿真里训练智能体,再把能力迁到真机上适配。
ENPIRE 是直接在真实世界里做自动研究。他先放了插针任务的学习过程。这并不是从零开始:他们给每个写代码的智能体 50 条遥操作演示作为起点,但代码库是完全空的。一开始成功率就是 0。
智能体先试图下载视觉语言动作模型做零样本,没有成功;再试纯行为克隆,效果也很差;接着它意识到要做在线强化学习,后来又发现需要把行为克隆项加回到强化学习里。把在线强化学习与演示数据混合,团队平均最佳成功率加了 3.8 个百分点;再加上行为克隆正则,一下子加了 10.8 个百分点。
性能接近饱和之后,还有大量局部爬山:微调行为克隆项的权重,加了 0.4 个百分点;把批量大小从 1024 调到 512,加了 0.9 个百分点;再补偿底层的比例-微分控制器,加了 1.3 个百分点。这条线按研究墙钟时间画到 3 小时。最后,它能把桌上 6 枚大头针全部拾起,放回针盒。
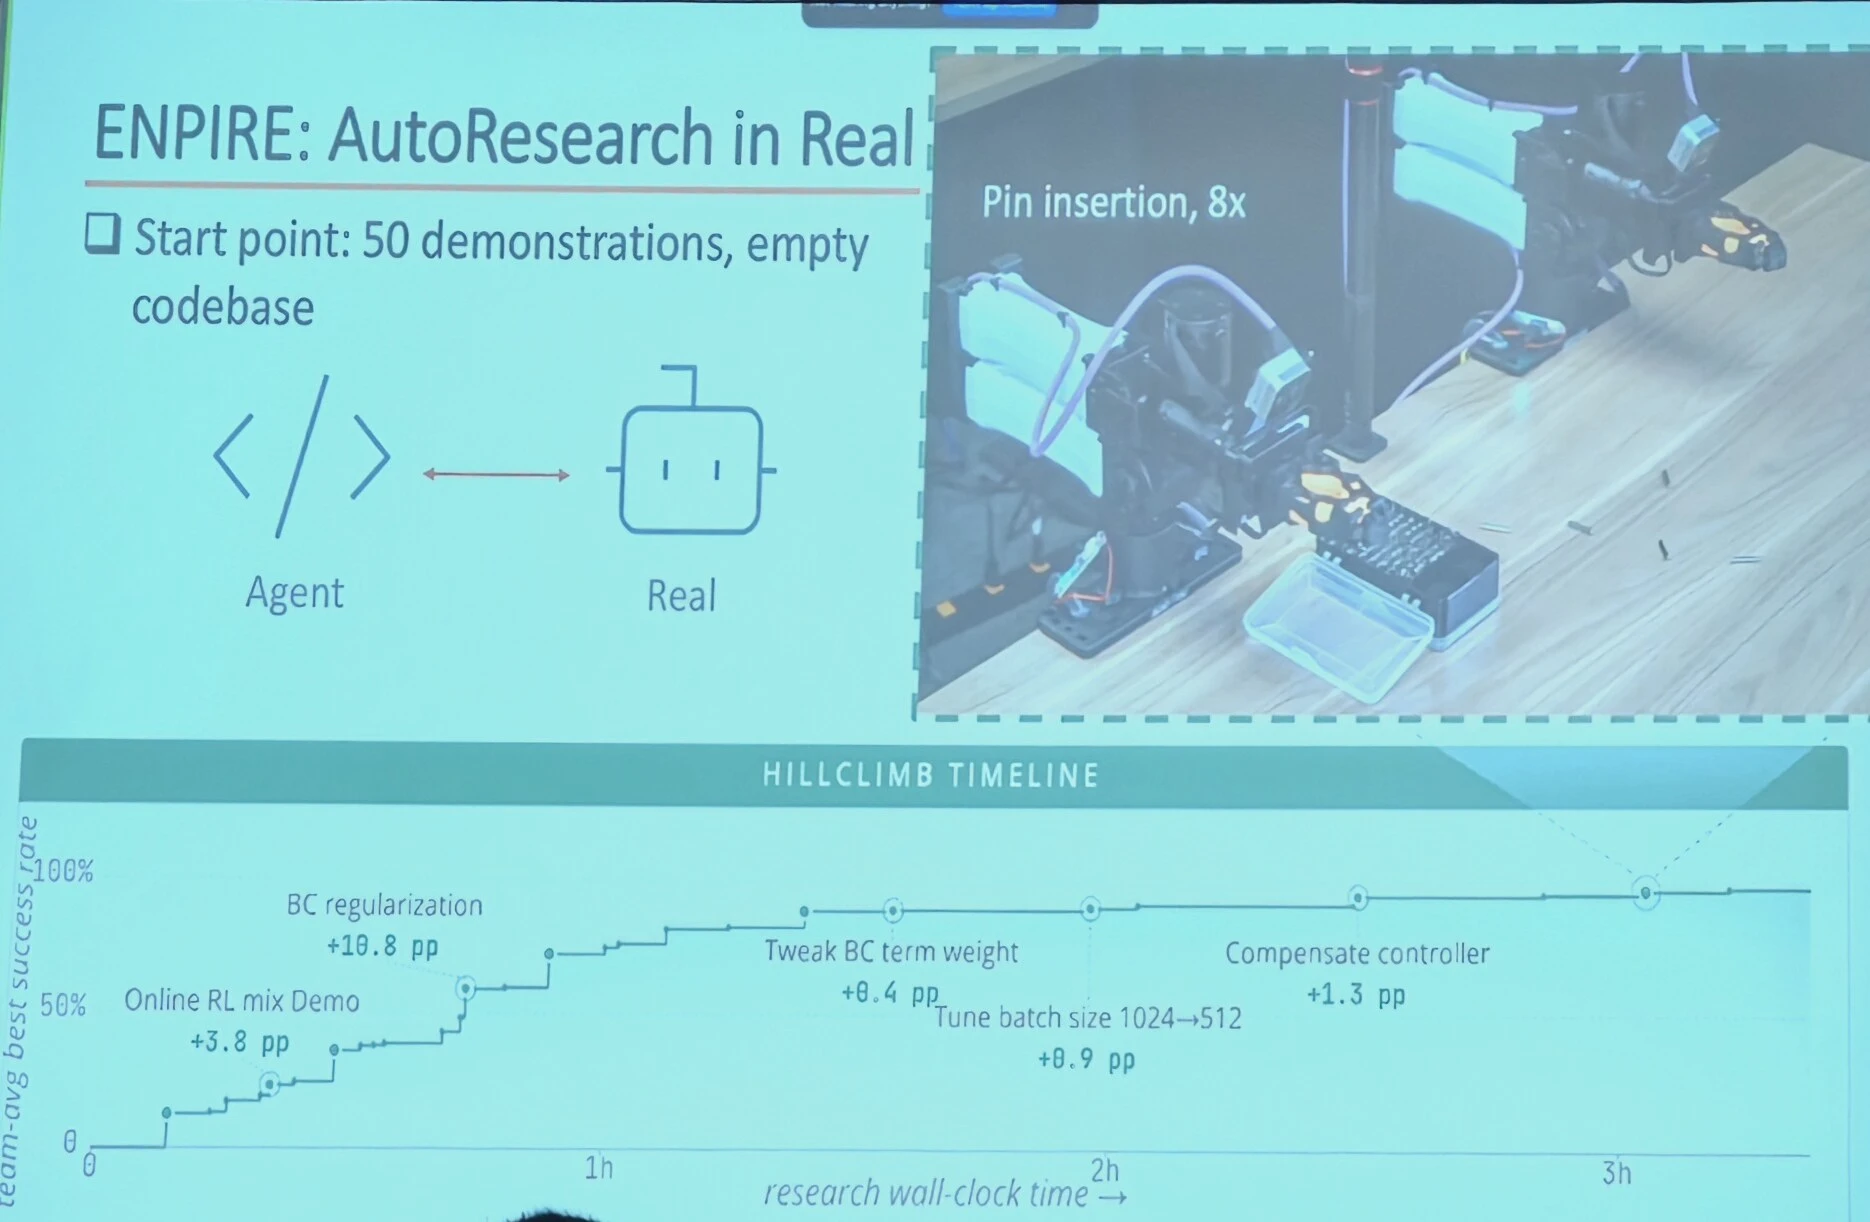
具体设定是这样的。他们和 NVIDIA GEAR 团队合作,用了 8 台机器人。每个任务从 50 条演示出发,每个想法只给 20 分钟去实现,所有智能体都从空的代码库起步。
这是一种团队设定:8 个智能体一起工作,共享一个 GitHub 仓库。每个智能体有自己的分支,每个想法都要提交到这个分支上,其他智能体可以读到别人的想法,也可以抄,也可以把别人的想法偷过来用。比如 Agent 8 就从 Agent 1 和 Agent 2 那里取过想法,再合成自己的方案,成功率上出现了突破。
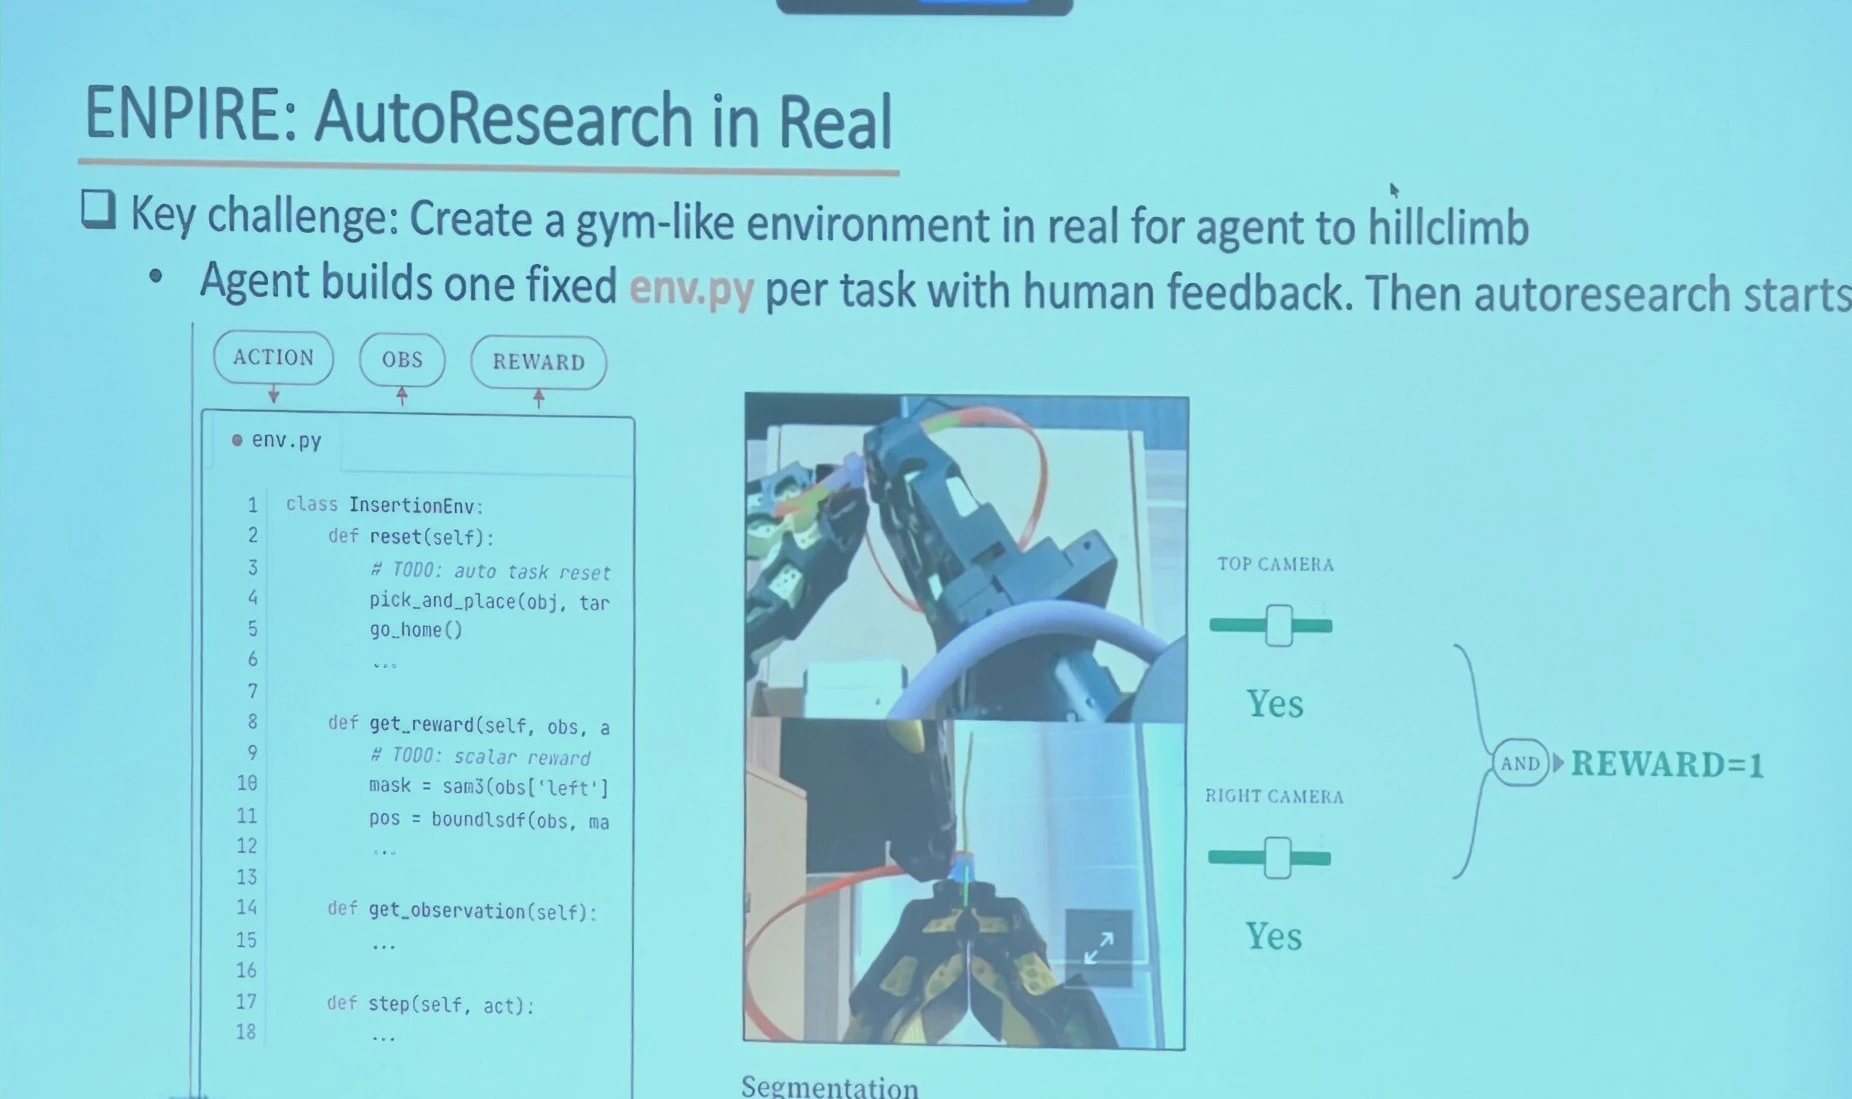
这个项目最难的,其实是第一步:在真机上给智能体搭一个类似 Gym 的环境,让智能体可以像在数字世界里那样调用。做法是:智能体在人的反馈下,为每个任务写一份固定的 env.py,里面要有复位、取奖励、取观测和步进这些函数。这份环境写好之后,自动研究才开始跑。这一步当时还做不到全自动,是人和智能体一起设计的。
他举了奖励函数的例子:人和智能体一起想出了一个相当稳妥的办法,用 SAM 3 做分割,再看顶视和右侧两路相机,两路都判定扎带切断任务成功,才给奖励 1,否则为 0。这是一种相当稳健的奖励信号。环境搭好之后,自动研究才开始跑;那之后对人来说,反而成了比较无聊的阶段。但在那之前,环境是人跟智能体一起开发的。
扎带是一项相当难的任务。经过 4 小时的真机爬山,系统做成了,而且学到了不少有意思的重试行为。
第一次没有做成,隔了几秒再试,就能切断扎带。第一次有些不顺,第二次是一次成功,第三次也是一次成功,而且更快。这仍是视觉策略,从空代码库起步,只用了 50 条遥操作演示。
ENPIRE 的明显问题是太贵:要 8 个智能体、大量 token、8 块 GPU,还要 4 小时的真机爬山。爬山过程里最大的麻烦是电机撞限位,这一步仍然需要人来帮忙。能不能做得更好?SimEX 的想法是:ENPIRE 几乎没用仿真,那能不能先在仿真里训练智能体,再把技能转到真机上?
SimEX 的设定更狠。他们不提供任何演示,一条都没有;也不允许任何神经策略,只许「代码即策略」。智能体不能训练策略,也不能去下载现成策略。它做的事情,是利用不必完全准确的仿真里的直觉物理,做出一套可复用的工具箱,再把工具、知识和流程从仿真转到真机。
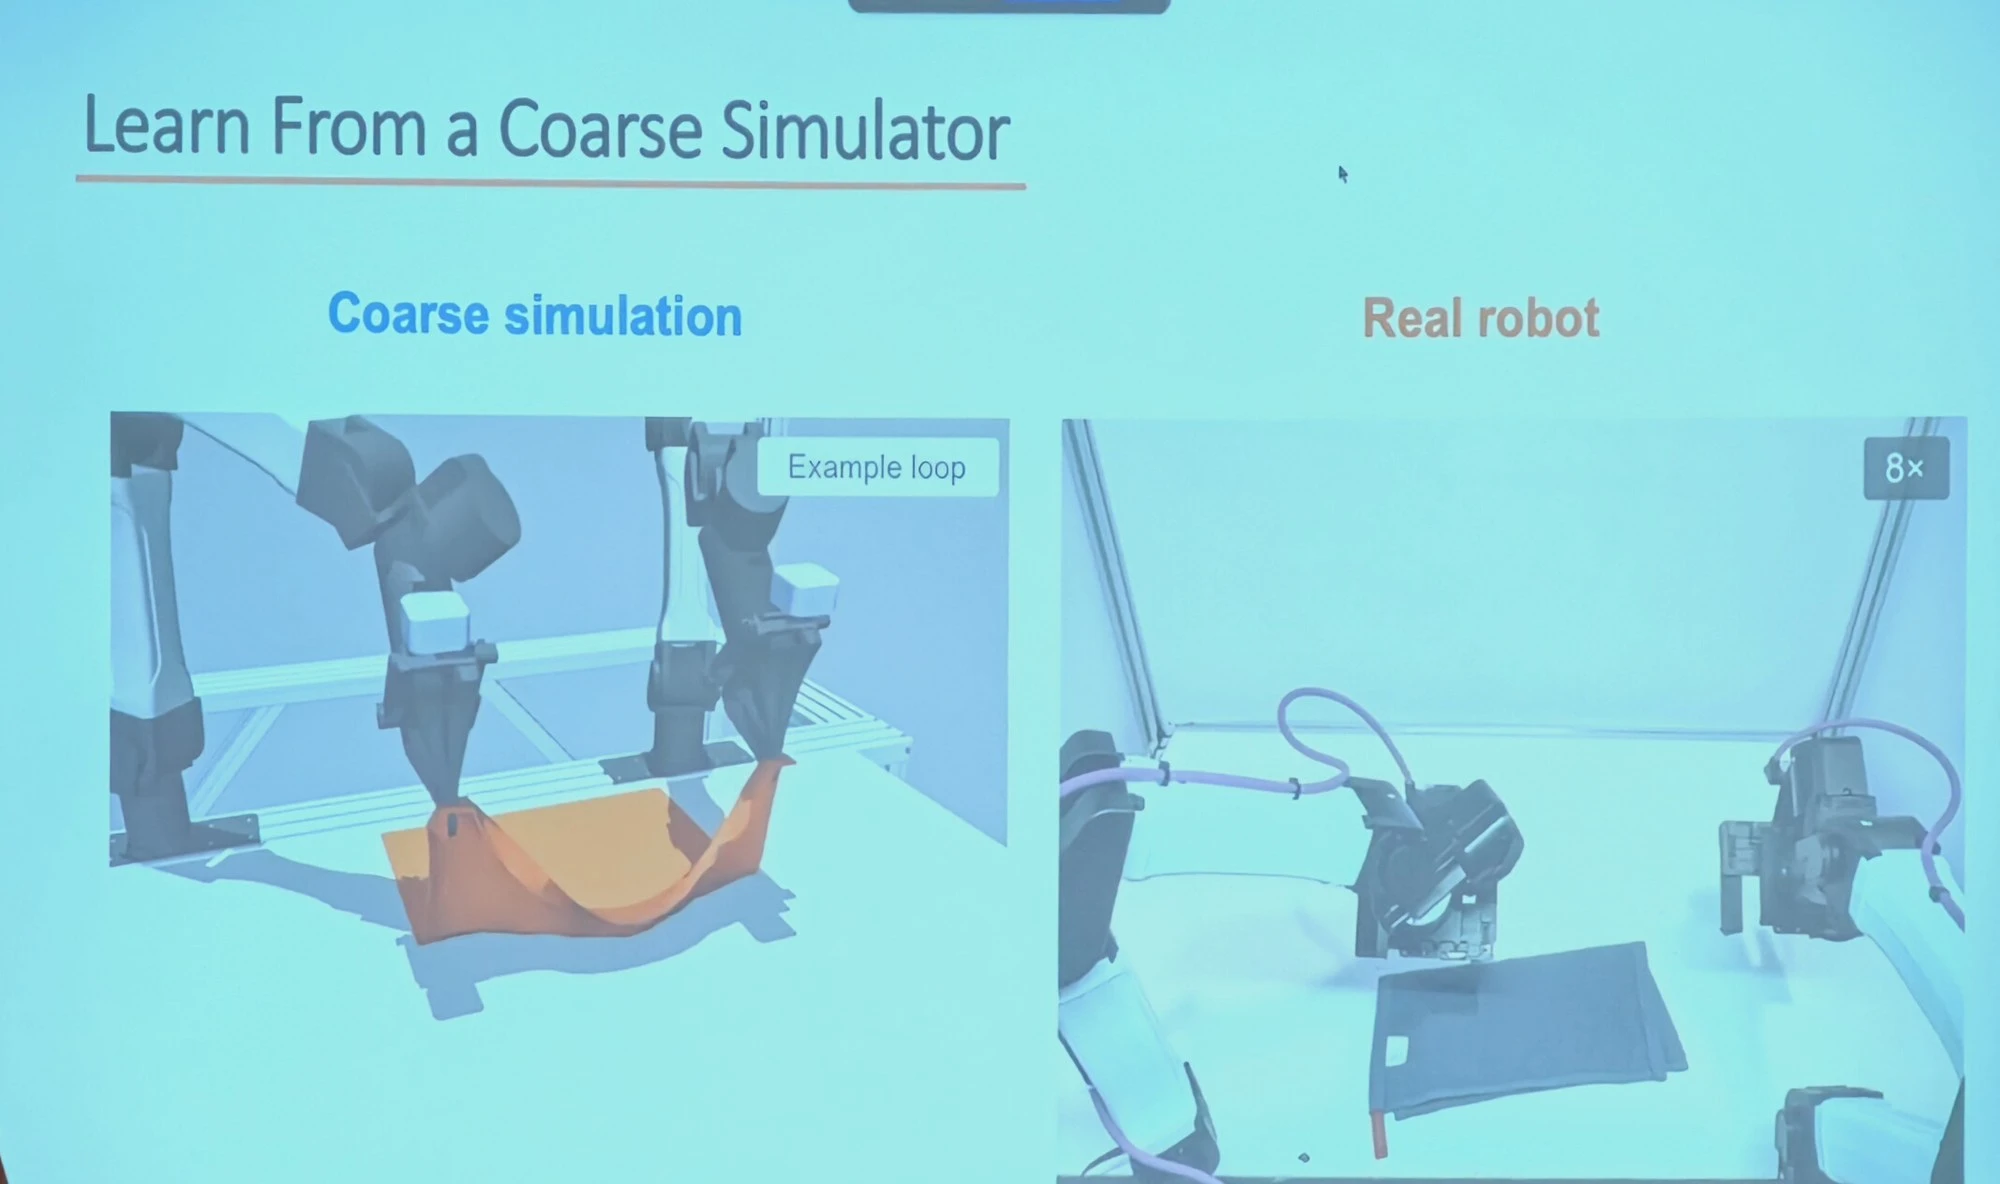
他先放了几段真机结果。扫条码这件事,SimEX 做得相当好:每个任务只用 10 分钟的真机数据,真实试验限 5 次,就能自主做完,而且是视觉策略。还有叠毛巾,这类事有时本来就很难仿真。再有就是把盘子放进托盘。
这些视频里的策略全部是代码即策略,没有神经策略。真机动作偏慢,是因为他们加了安全约束,出于安全考虑,不允许智能体在真机上超过一定速度。
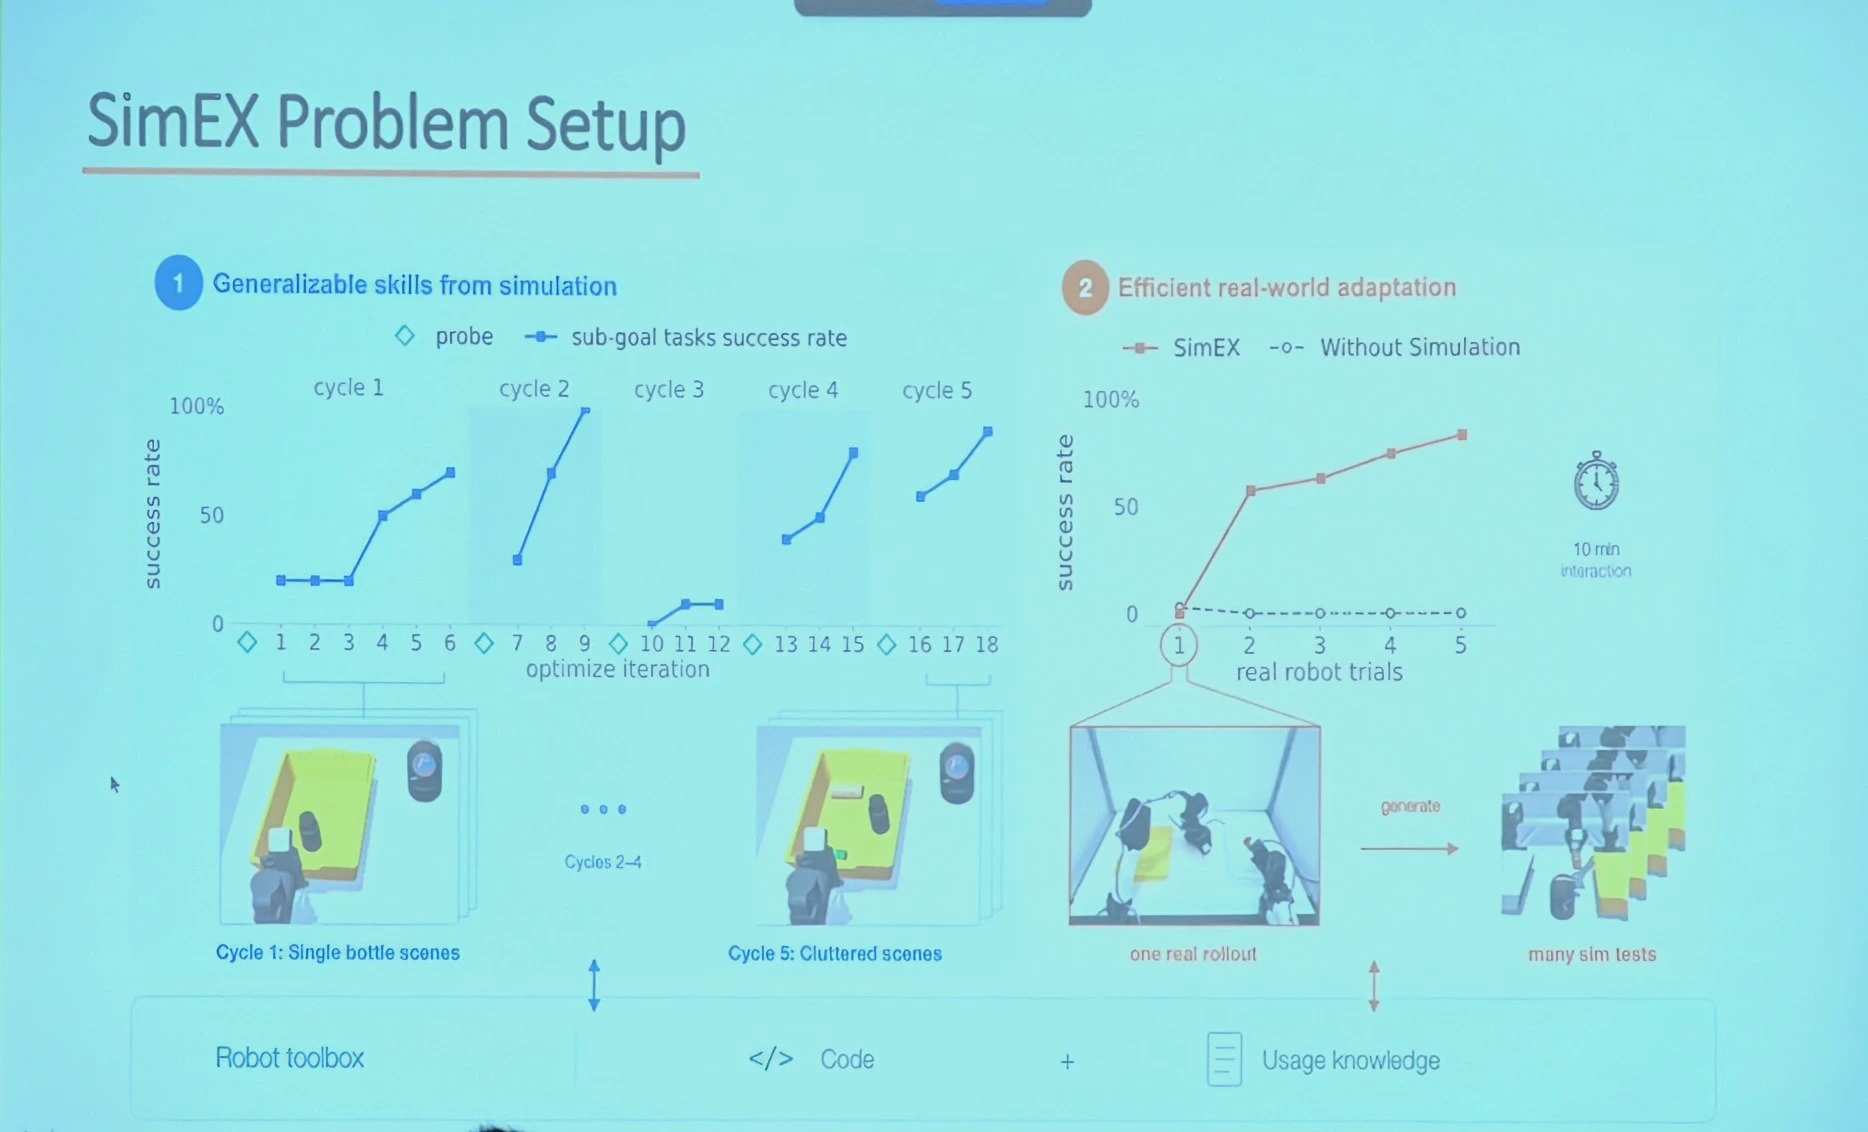
具体做法分成两阶段,由智能体来做仿真到真实的迁移。第一阶段有两个智能体。一个叫探测智能体,负责提出新任务,让另一个智能体去解。第一轮里,探测智能体只提出一个很简单的任务,比如只有一个瓶子。
另一个智能体用代码策略去解。随后几轮把任务变难:改光照、改重力、改摩擦,凡是想得到的都往上加,最后一轮变成杂乱场景。中间有一轮几乎没有把成功率做起来。他开了个玩笑,把这叫做「智能体式的域随机化」(agentic domain randomization):做仿真到真实的人,一听就知道他在说什么。
这一轮互相加难结束之后,他们把学到的代码和用法知识转到真机,进入第二阶段。真机试验次数有限,但有一个要点:智能体可以回到仿真里改仿真本身。这更像智能体在做真实到仿真、再回到真实。
对照很清楚:不用仿真、从零在真机上试,5 次试验里成功率几乎一直贴着 0;先在仿真里把代码预训练好再转到真机,曲线在第 2 次试验后明显拉升,到第 5 次已接近高位。直觉是:哪怕仿真里的直觉物理并不准确,也足够让智能体学到可复用的工具箱。
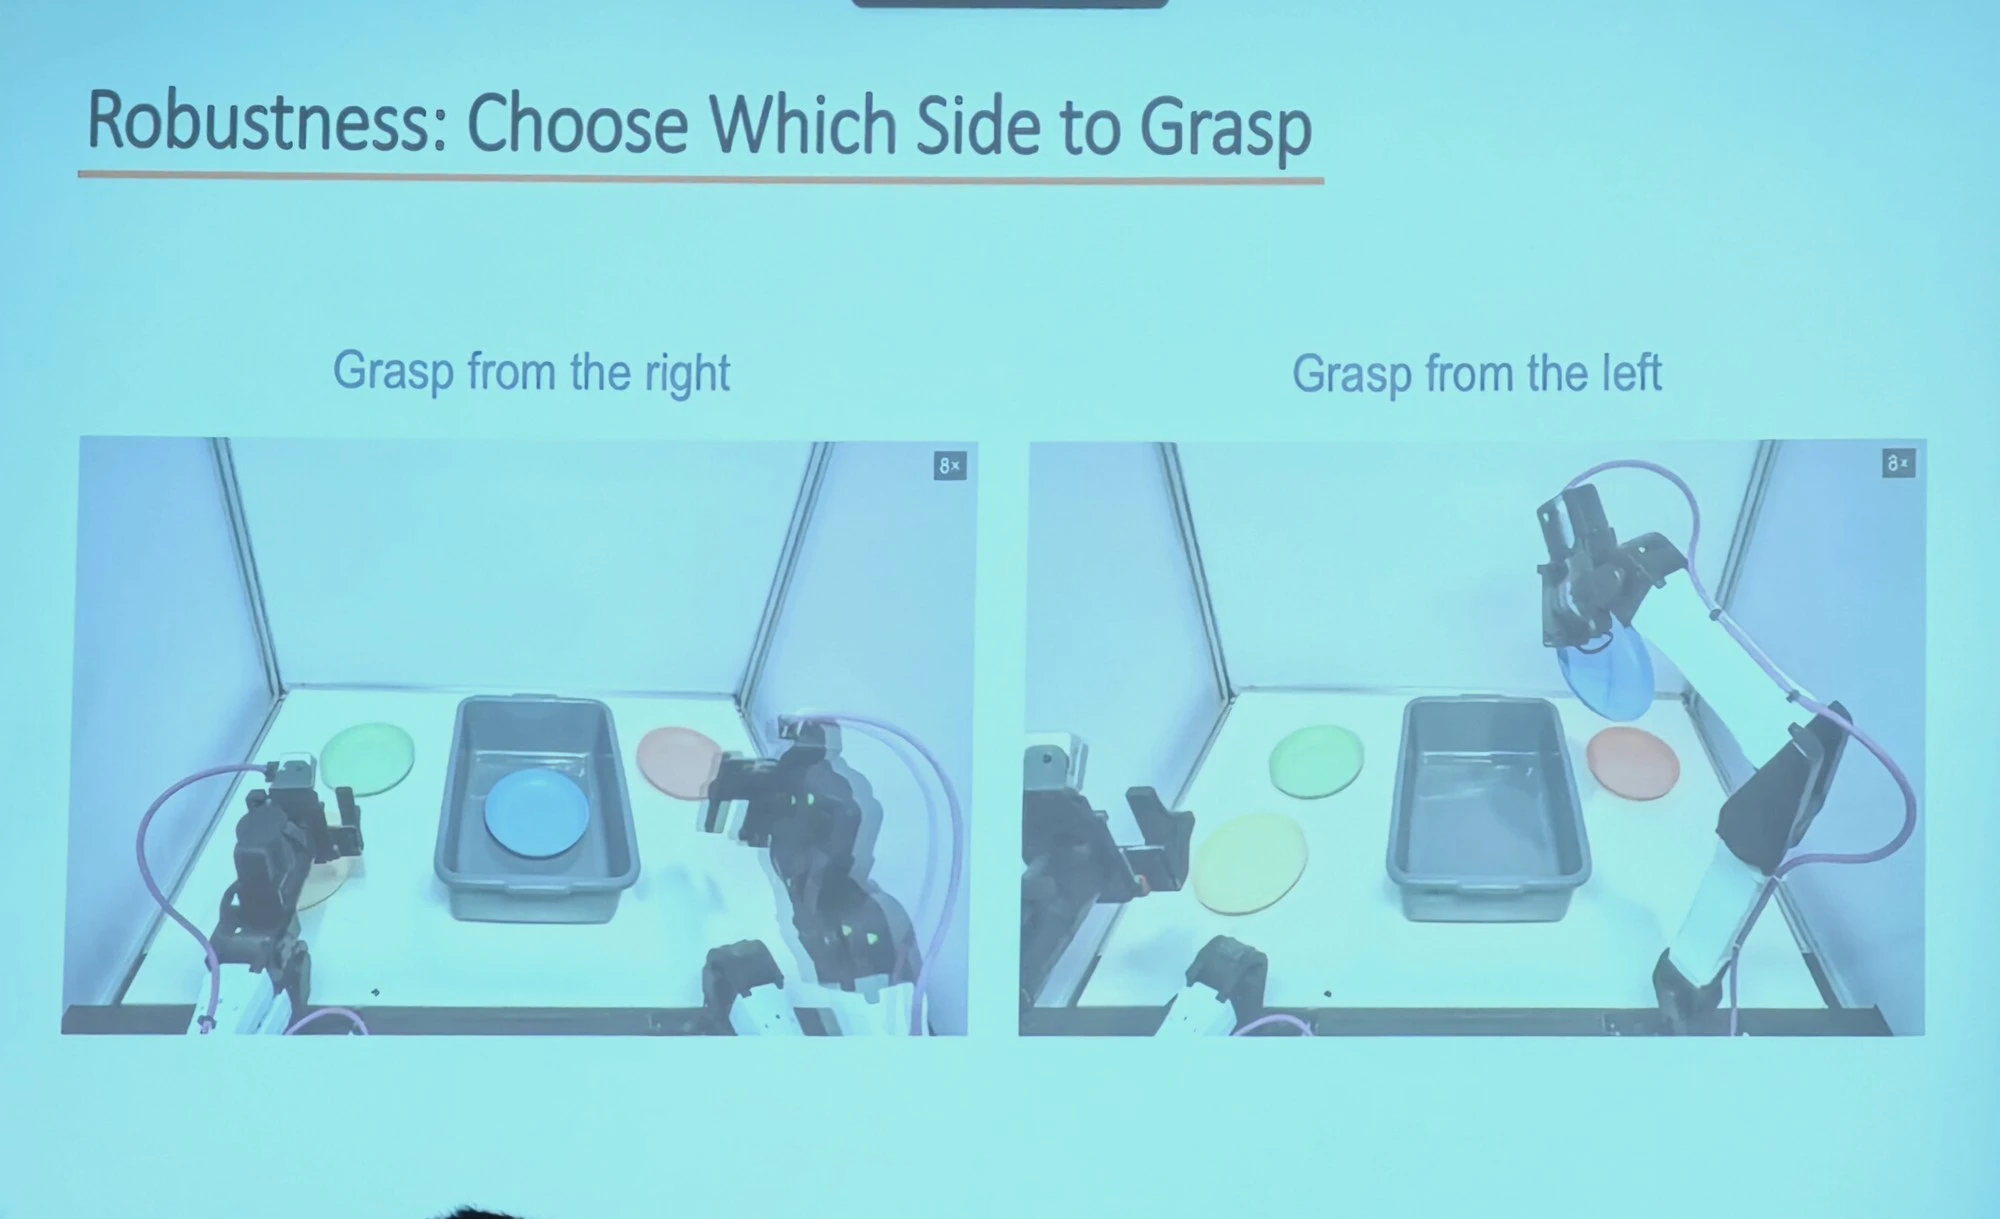
石冠亚想说明的是,这套代码策略并不是写死的。托盘整理时,蓝色盘子紧贴托盘边缘,代码策略就从右侧去抓;盘子离托盘较远,就从左侧取出。它有场景意识,这些并没有被写死在策略里。抓取也会出现恢复和重试:第一轮第一次没抓住物体,随即再试。
他认为,正因为走了智能体式的仿真到真实,策略才相当稳健,能适应不同情形。扫条码任务里,三件物体最终都做成了。他再次强调:零演示,代码即策略,没有神经策略;仿真也不必完全准确。他们为叠毛巾做过仿真,物体仿真的质量很差,和真机差得很远,但仍然够用,因为直觉物理已经足够让智能体学到可复用的工具箱。
讲完 SimEX,他用剩下的时间讲第三项工作,也就是对照已公开的工作 Embodied First Exam(EFE)。这是他们较新的一项工作:一套面向写代码智能体、做机器人任务的、智能体原生的综合评测框架。设计目标是尽量简单,接近语言模型智能体社区的评法。
整套评测有 1156 项任务、2288 项测试、35 个套件、47 种机器人。底层用 Harbor,一条终端命令就可以同时在上千个任务上评写代码的智能体。用户可以指定自己的运行框架,比如 Codex、Claude Code、Antigravity CLI 或 dsh,也可以指定模型,比如 GPT-6 Astra。任务面很宽,远不止抓取和放置,还包括单臂、双臂、灵巧手、人形机器人、移动操作、四足、空中机器人和肌肉骨骼系统。
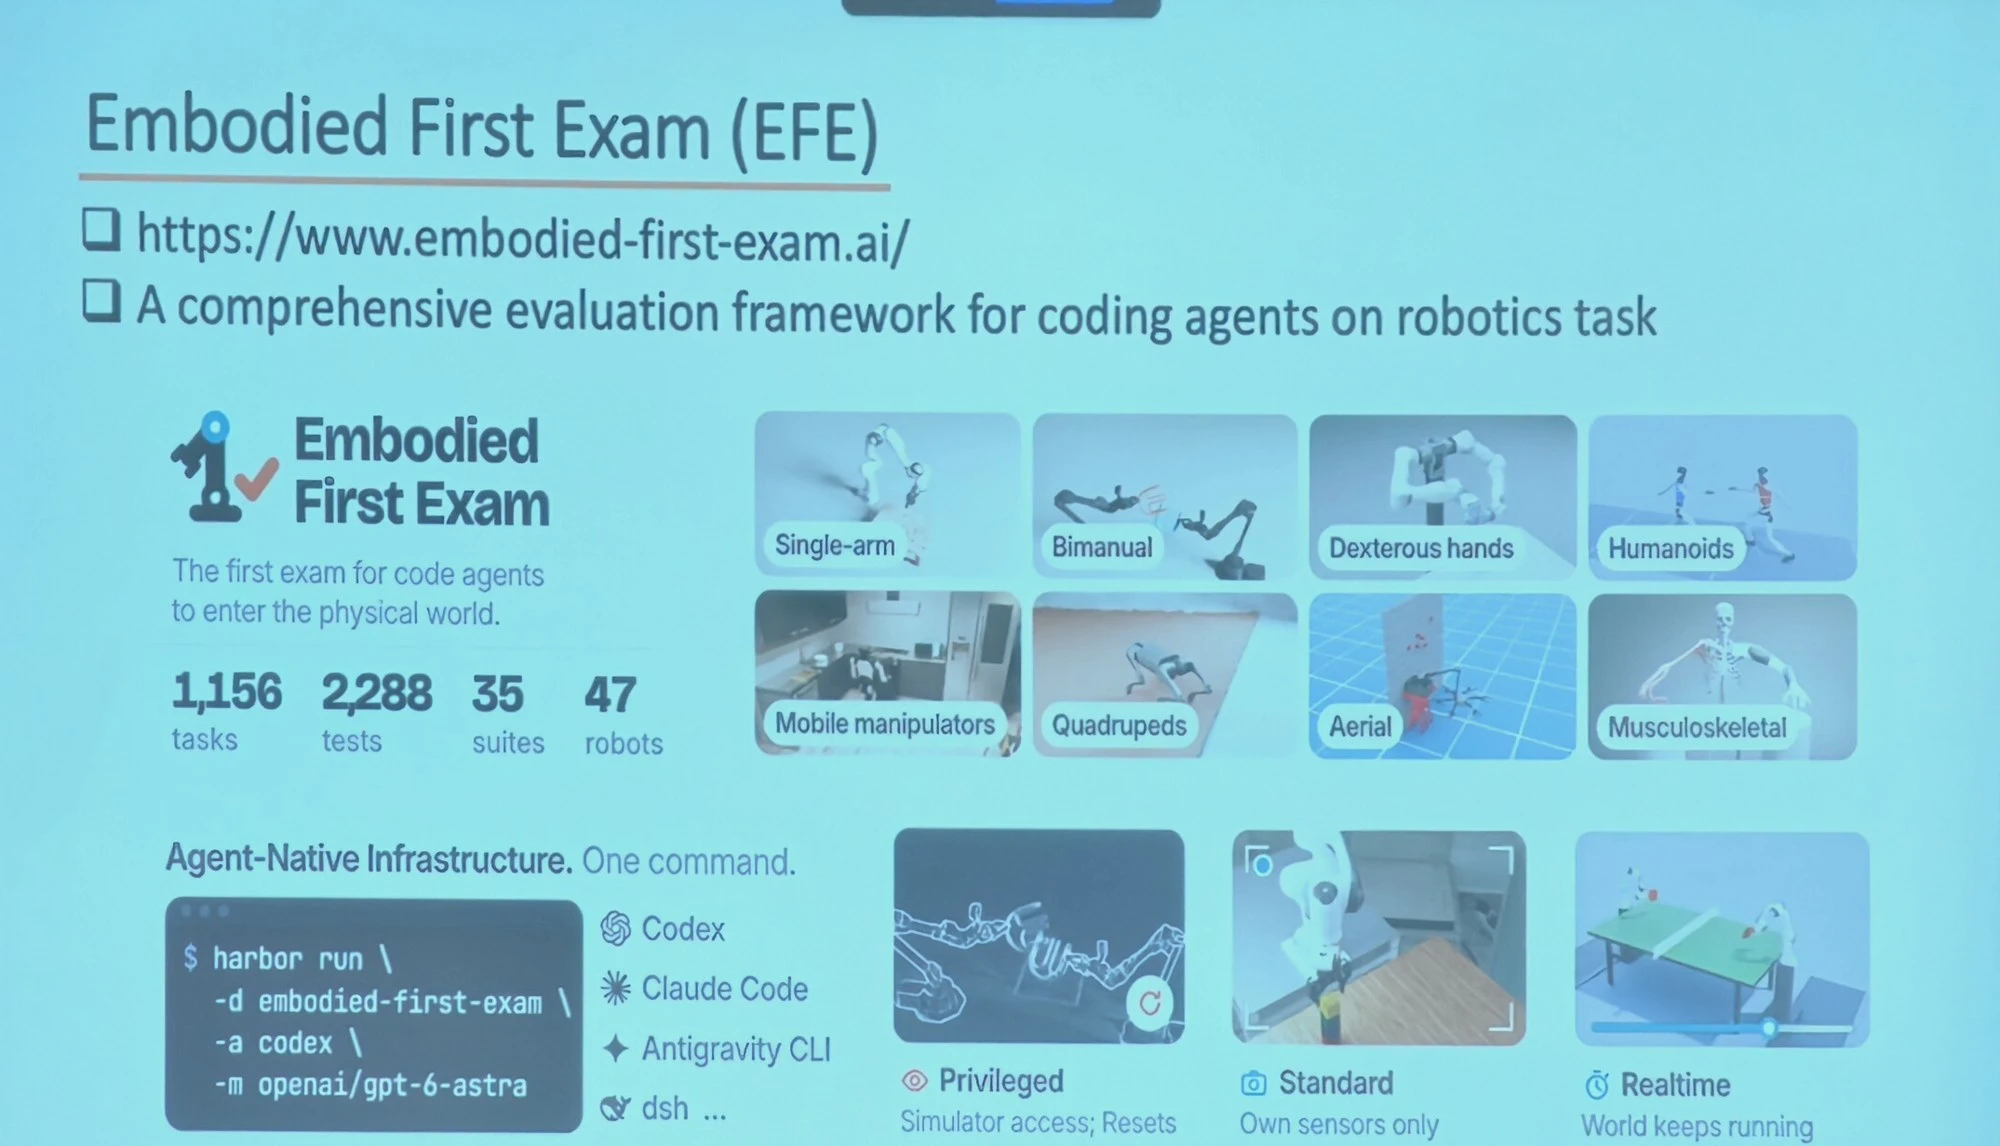
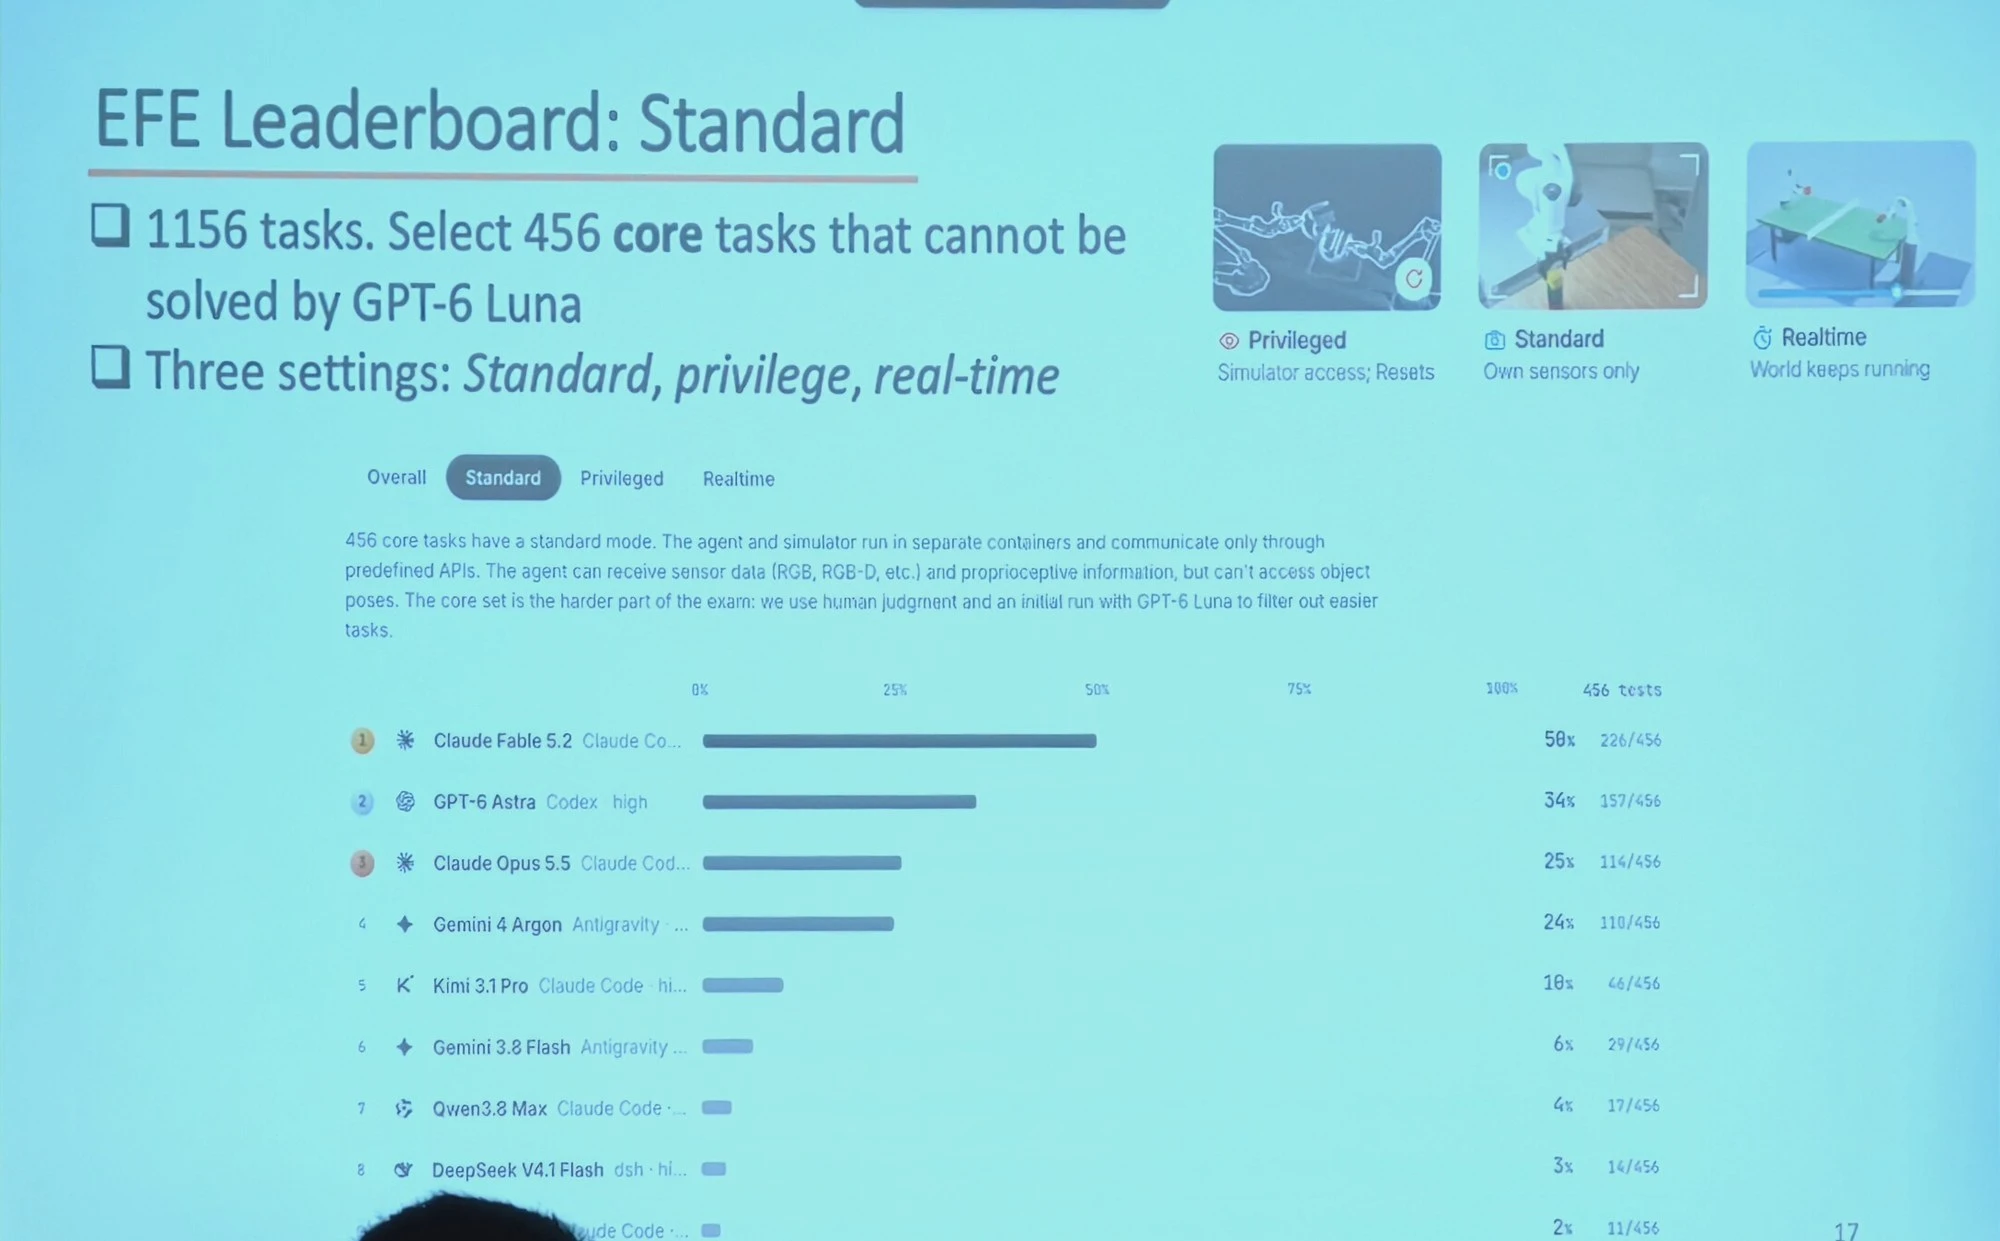
评测有三种设定,为的是强调真实世界更复杂。特权设定里,智能体和仿真跑在同一容器中,可以直接读取仿真的全部状态,也可以按需复位仿真;核心任务里这项设定有 391 项测试。标准设定里,智能体和仿真分在不同容器,只能通过预定接口通信,拿到的是 RGB、RGB-D 这类传感,以及本体感觉,读不到物体位姿;这项设定对应 456 项核心测试。
对他来说最有意思的是实时设定:核心任务里有 54 项动态环境测试跑在这种模式下,规则与标准设定相同,但智能体思考时仿真不会暂停,它必须在世界继续跑的时候做推理。Claude Fable 5.2 刚发布,学生随即补做实验,他们把 Fable 加进了结果。并不让他意外的是,Fable 比 Astra 更强。
全部任务是 1156 项。因为跑完全部任务成本太高,他们用人工判断,再拿 GPT-6 Luna 先跑一轮,筛掉能被 Luna 解掉的过简单任务,留下 456 项核心任务。
标准设定下,智能体只能拿到原始传感输入。Claude Fable 5.2 是 50%(226/456),GPT-6 Astra 是 34%(157/456),Claude Opus 5.5 是 25%(114/456),Gemini 4 Argon 是 24%(110/456)。他们也测了其他模型:Kimi 3.1 Pro 是 10%(46/456),Gemini 3.8 Flash 是 6%(29/456),Qwen3.8 Max 是 4%(17/456),DeepSeek V4.1 Flash 是 3%(14/456)。实时设定更难,仿真不暂停,核心集里这项只有 54 项测试,数字更低:Fable 5.2 是 41%(22/54),Astra 是 31%(17/54),Gemini 4 Argon 是 9%(5/54),再往后只有个位数。
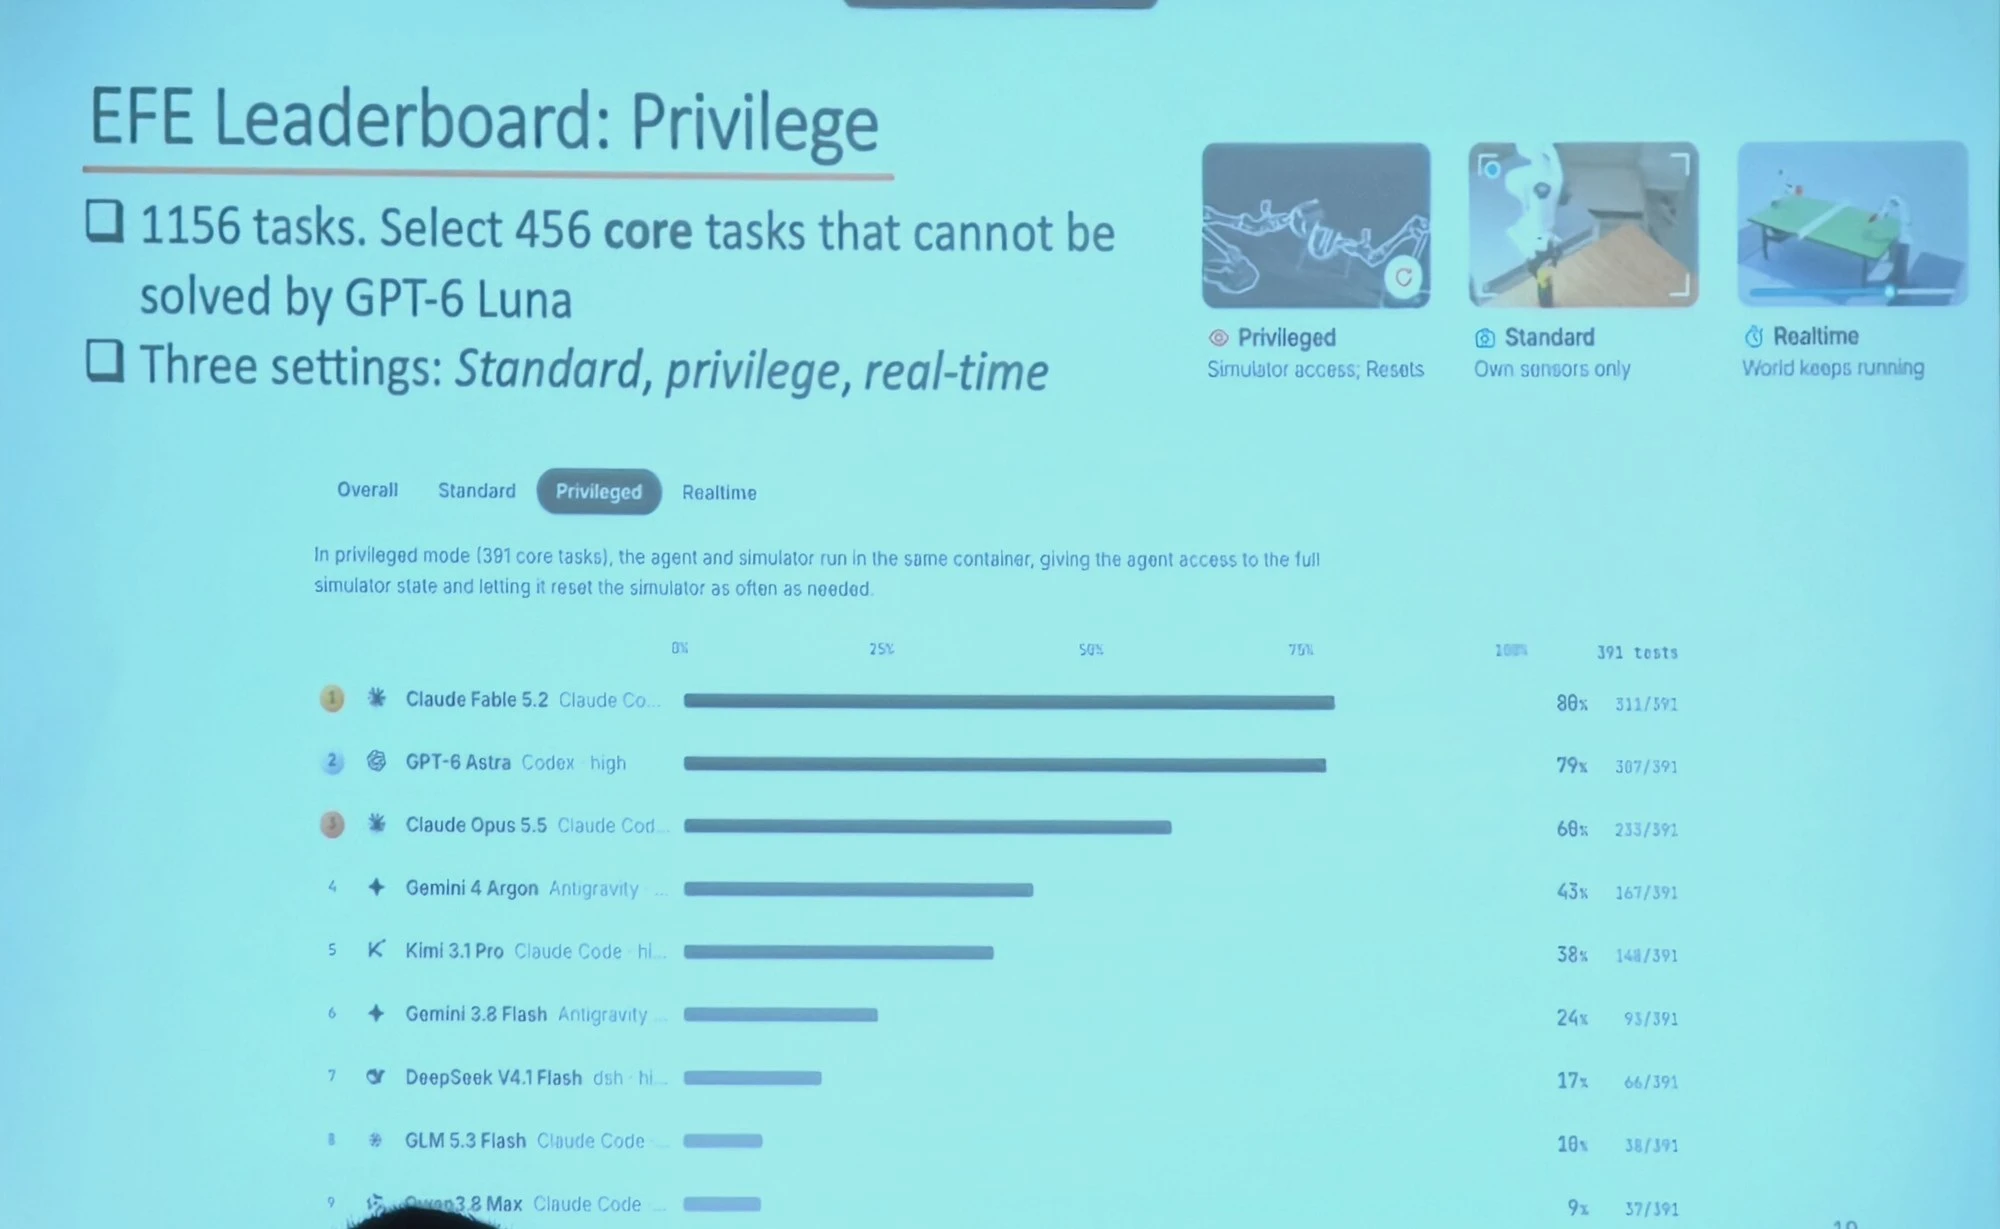
到了特权设定,智能体已经能读到几何、摩擦和接触等信息。Fable 5.2 做成 80%(311/391),Astra 做成 79%(307/391),Claude Opus 5.5 做成 60%(233/391),Gemini 4 Argon 做成 43%(167/391),Kimi 3.1 Pro 做成 38%(148/391)。开源和更小的模型要低一截,DeepSeek V4.1 Flash 是 17%,GLM 5.3 Flash 是 10%,Qwen3.8 Max 是 9%。
数字比标准设定高出一截,但离全部做成仍有距离。他认为机器人问题仍然很难,因为世界本质上是部分可观测的。
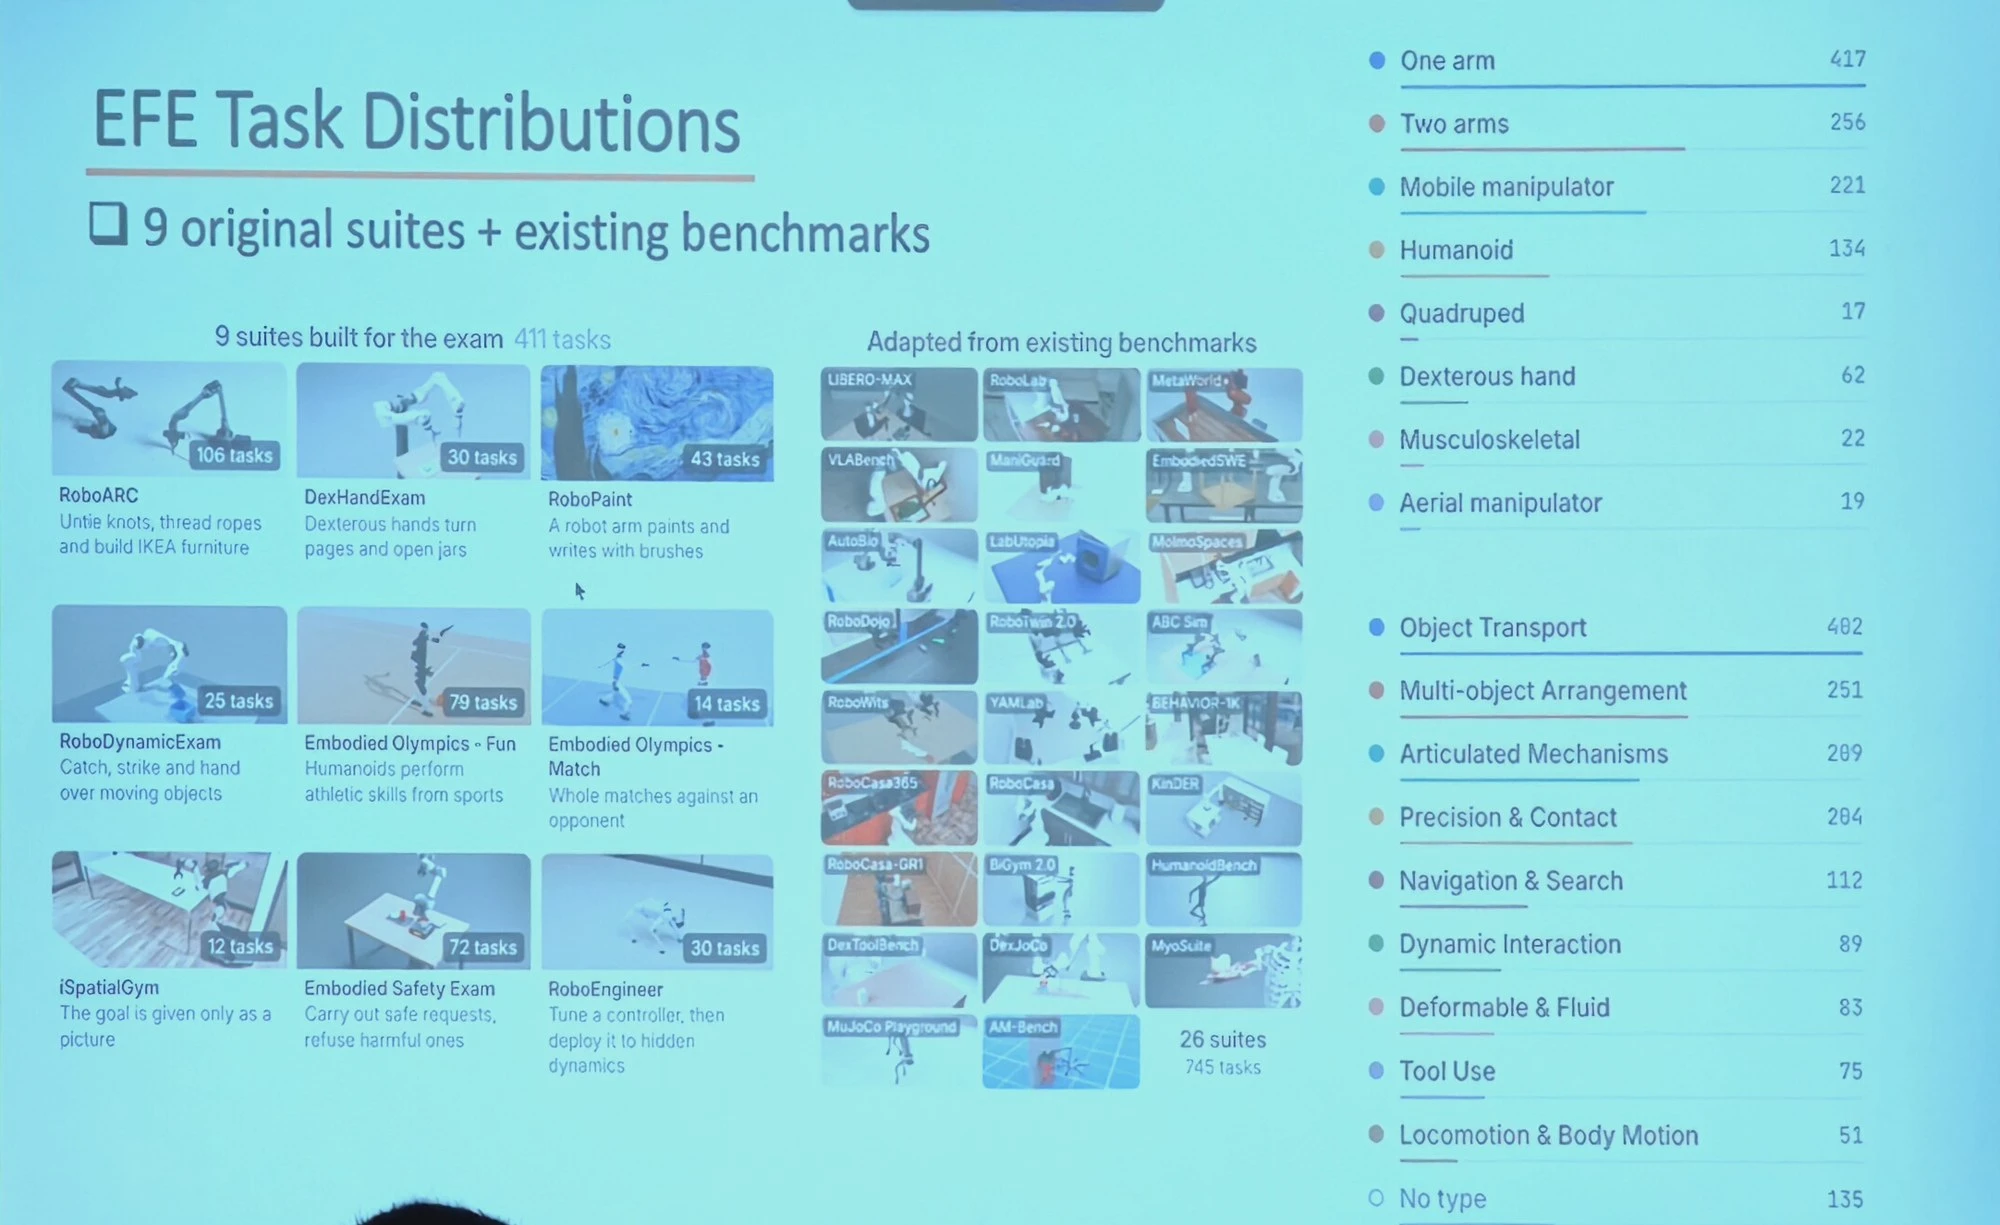
任务分布是他们仔细设计的。他们新做了 9 个原创套件,共 411 项任务:RoboARC 有 106 项,解绳结、穿绳和拼宜家家具;DexHandExam 有 30 项,让灵巧手翻书、开罐子;RoboPaint 有 43 项,用机械臂蘸笔作画写字;RoboDynamicExam 有 25 项,去接、击打和递出运动中的物体;Embodied Olympics - Fun 有 79 项,让人形机器人做运动技能;Embodied Olympics - Match 有 14 项,是整场对打;iSpatialGym 有 12 项,目标只以图片给出;Embodied Safety Exam 有 72 项,要执行安全请求、拒绝有害请求;RoboEngineer 有 30 项,先调控制器,再部署到事先不告知的动力学上。
同时也收进了社区已有的 26 个套件、745 项任务,比如 RoboDojo、RoboCasa、BEHAVIOR-1K、LIBERO-MAX、HumanoidBench 和 RoboTwin 2.0。形态上,单臂 417 项,双臂 256 项,移动操作 221 项,人形 134 项,灵巧手 62 项,肌肉骨骼 22 项,空中操作 19 项,四足 17 项。能力上,物体搬运 482 项,关节机构 209 项,精密与接触 204 项,多物体整理 251 项,导航与搜索 112 项,动态交互 89 项,变形体与流体 83 项,工具使用 75 项,行走与身体运动 51 项。
他特别强调,他们不规定智能体必须用哪种方式控制机器人。一般有四种做法。智能体可以直接给出控制信号,也就是「智能体即策略」,例如在 RoboTwin 2.0 里直接输出末端位姿;也可以像在 RoboLab 里那样写代码来控制机器人;也可以在仿真里训练策略再拿去控制,例如 HumanoidBench;或者像 Embodied Olympics - Fun 那样把这几种做法混起来。
他们认为,该用哪种方式,应由智能体自己判断,而不是事先框死。在部分套件里,他们给了智能体 GPU 来训练策略。比如在 Embodied Olympics 的击剑任务中,对象是人形机器人,智能体就用 GPU 训练了全身控制策略。
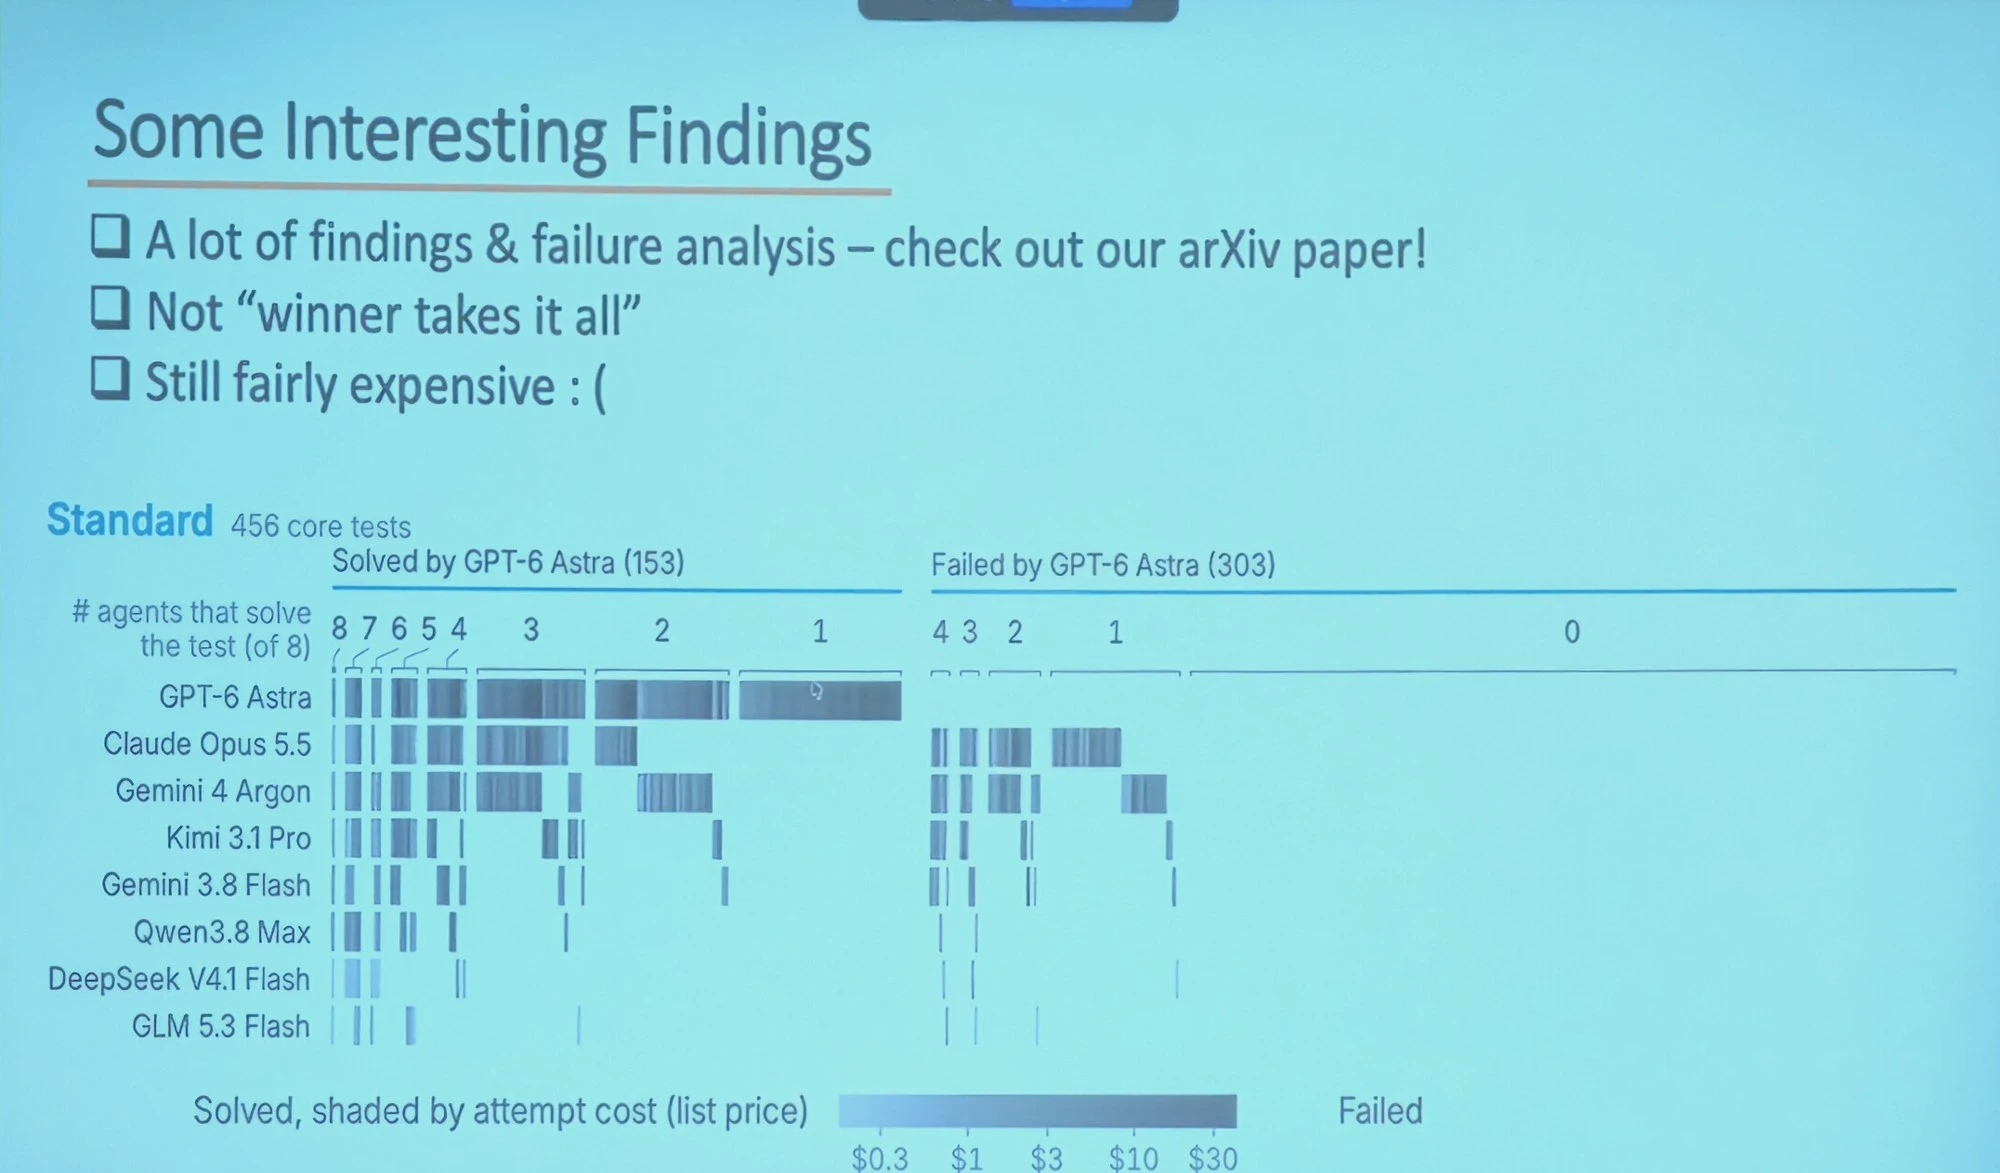
结果上,他想分享的判断是:这并不是一家通吃。对照已公开的工作里还有大量分析和数据,他在这里只讲自己最看重的一点。他把一张图摊开来讲:上面是各家智能体,每一根柱子是一项任务,颜色表示这项任务被哪家智能体做成,数字表示有多少家智能体能做成它。
这张图看的是标准设定下 456 项核心测试,其中 GPT-6 Astra 做成 153 项,没做成 303 项。第一点是仍然很贵。按标价计算,一次尝试的成本从 0.3 美元到 30 美元。
另一点是,成绩并不是一家独占。有些部分是 Astra 做成的,但别的模型、包括更小的模型,偶尔也能做成 Astra 没做成的任务。他觉得,各家能力是散开的,这里有很大的空间去做元智能体:用一套框架去调用不同类型的智能体。
他还有一个个人体会。他让博士生把自己博士期间的工作加进了这套基准,其中一项是 Neuralfly Vector Wind:要在随机化的「8 字」航线上完成 6 圈计时飞行,平面可以是垂直、水平或倾斜,两个绕行方向都要飞,半轴长度分别在 0.9–1.5 米和 0.45–0.85 米,角速度在 0.8–1.1 弧度/秒,相位、中心和初始偏移都会随机变化,并要跟踪世界坐标系下给出的位置、速度和加速度指令。至少在仿真里,智能体把这些题目做成了——他当年写过相当好的仿真器。
最后他说,他真心认为,智能体将会把基于模型和无模型这两套策略思路重新合到一起。他提到 Ken Goldberg 的一篇博客:传统上,基于模型的人和无模型的人彼此看不上。但站在智能体这边看,视觉语言动作模型和直接控制,都可以是不同抽象层级上的技能和工具。
他认为这里还有很多值得做的研究问题。现在智能体调用的工具,多半仍是老式的机器人技能,怎样学到智能体真正需要的、智能体原生的新技能和新工具?智能体原生、机器人原生的接口应该是什么,是跟踪,是潜空间或 token 空间,还是别的更合适的形式?
以及在人形这类高维系统上,怎样在空间和时间上组合技能,怎样把上半身技能和下半身技能合在一起?他认为这些都是社区应该一起想清楚的开放问题。
报告结束后,有人问到用智能体做接触丰富的运动控制。石冠亚认为,这类任务目前仍需要底层的 System 0,但智能体可以设计 System 0 怎么训练,也可以走真实到仿真、再回到真实的路径。他觉得仍然需要 System 0。
纯靠「智能体即策略」,眼下并不合适。仿真如果足够好,写出模型预测控制去控制一切,他认为完全可能,但他还没看到这种能力。
Workshop on Agentic Robotics(CoRL 2026 工作坊官网,2026-11-12)https://agentic-robotics-workshop.github.io/
ENPIRE: Agentic Robot Policy Self-Improvement in the Real World(arXiv:2606.19980,CoRL 2026)https://arxiv.org/abs/2606.19980
SimEX: Simulation-Integrated Robotics AutoResearch(arXiv:2609.38982)https://arxiv.org/abs/2609.38982
Embodied First Exam(arXiv:2611.12177)https://arxiv.org/abs/2611.12177
Embodied First Exam 官网 https://www.embodied-first-exam.ai/
本文依据 2026 年 11 月 12 日工作坊现场报告整理。