

世界模型该不该要,Finn 与 Max Li 辩后现场票数反转 | CoRL 2026
作者:江思奇
2026 年 11 月 12 日中午,机器人学习会议(CoRL)工作坊「机器人需要世界模型吗?」(Do Robots Need World Models?)在奥斯汀 JW Marriott 的 Brazos 房间进入最后的辩论环节。
工作坊官网把辩论拆成四项动议:端到端策略能否内化机器人行为所需的预测结构;通用策略是否比通用世界模型更容易学;显式世界模型是否为可复现、可扩展的策略评估所必需;现有基准能否告诉我们世界模型是否必要。现场则把它们收成一个问题来投票:机器人需要世界模型吗?
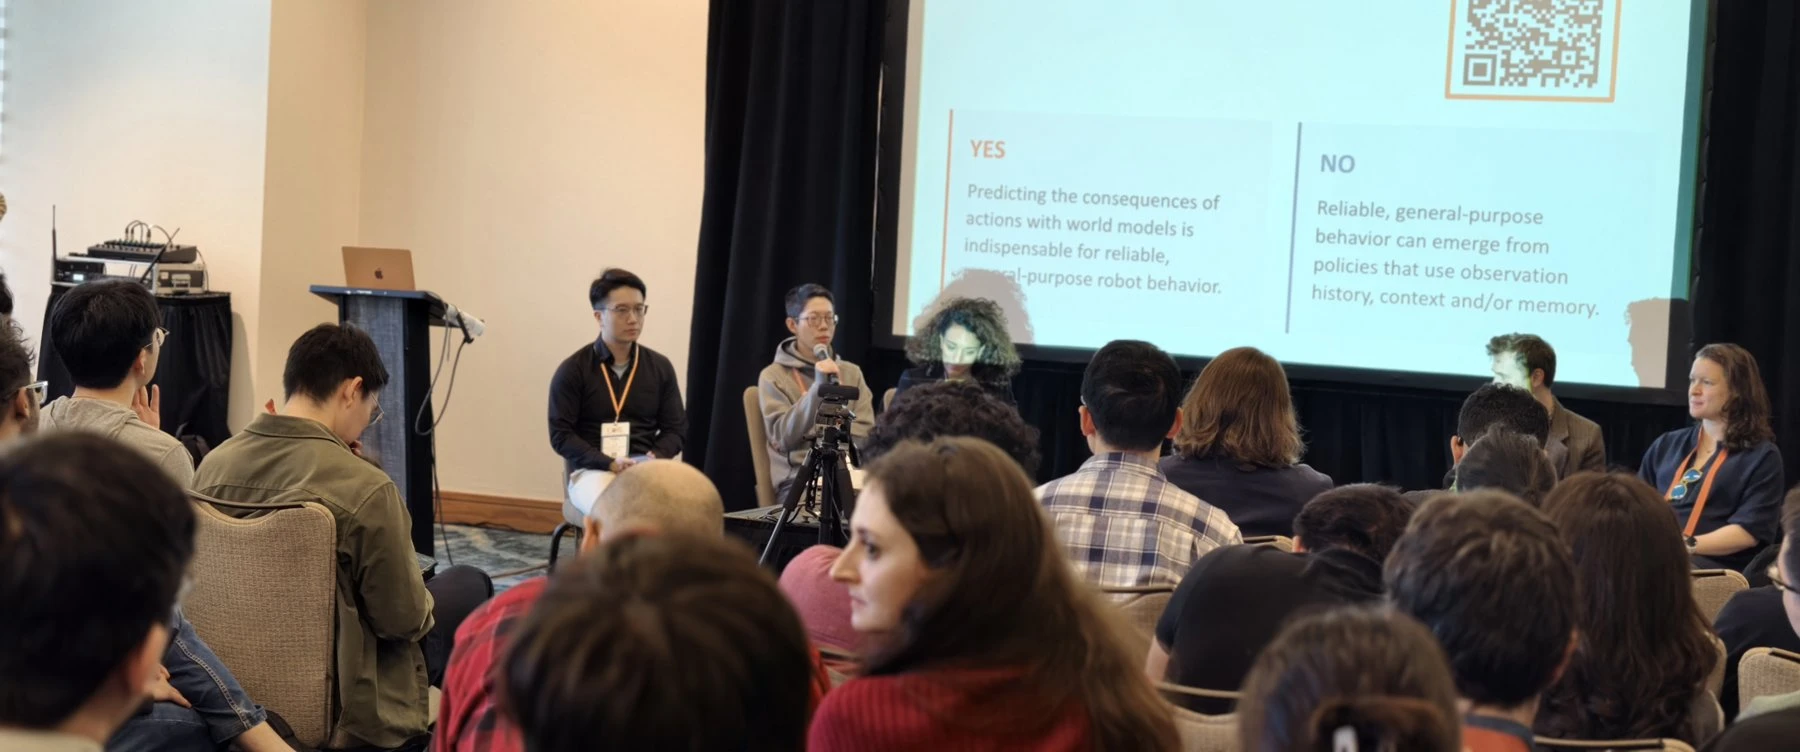
正方的表述是:用世界模型预测动作的后果,对可靠、通用的机器人行为不可或缺(Predicting the consequences of actions with world models is indispensable for reliable, general-purpose robot behavior)。反方表述是:可靠、通用的行为,可以从利用观测历史、上下文和/或记忆的策略中涌现(Reliable, general-purpose behavior can emerge from policies that use observation history, context and/or memory)。
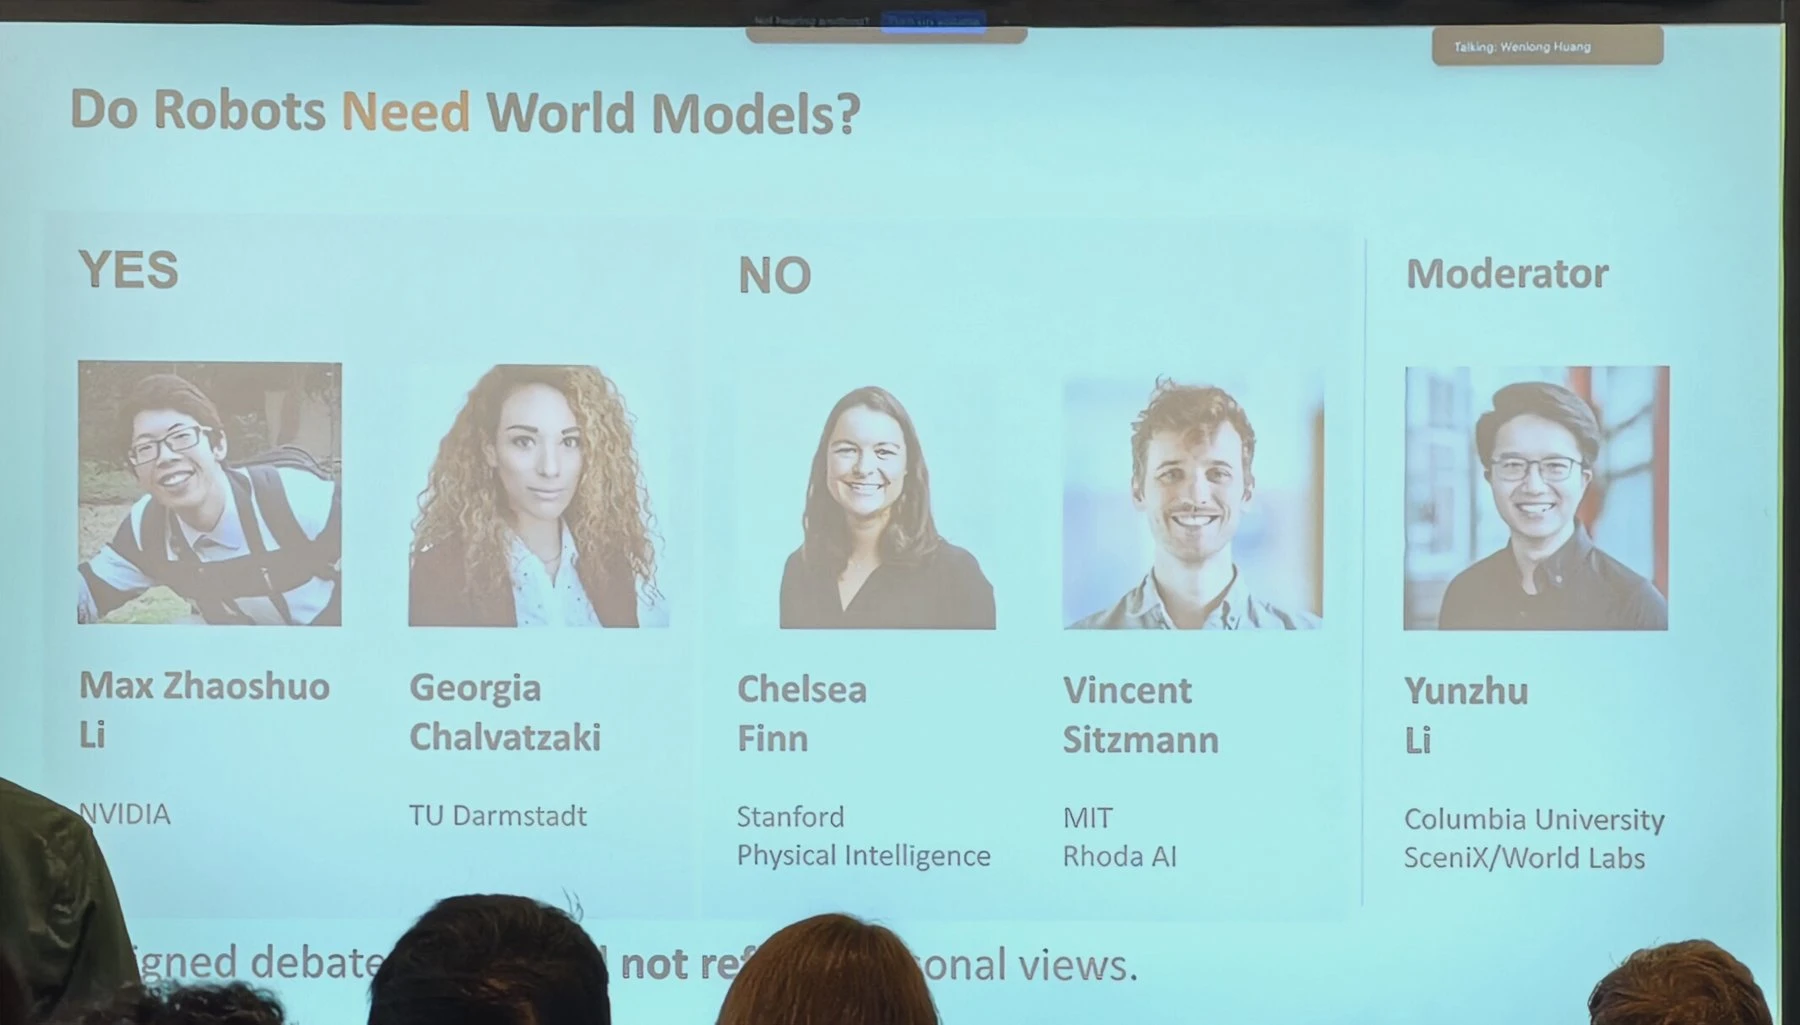
按照分组,世界模型、结构化一侧是 Max Zhaoshuo Li(NVIDIA)和 Georgia Chalvatzaki(达姆施塔特工业大学);端到端、隐式一侧是 Chelsea Finn(斯坦福大学 / Physical Intelligence)和 Vincent Sitzmann(麻省理工学院 / Rhoda AI)。主持人是 Yunzhu Li(哥伦比亚大学 / SceniX / World Labs)。这是一场分配立场的辩论,不代表个人观点。官网注明,分组是为了让讨论更严格,不一定代表每个人在每项动议上的个人观点。
Yunzhu Li 开场用两个例子说明双方都有道理。围棋的世界模型很好建,规则本身就是模型;倒一杯水,水流的模型要用到很难处理的方程,倒水这件事本身却没那么难,只要盯着水从哪里出来。
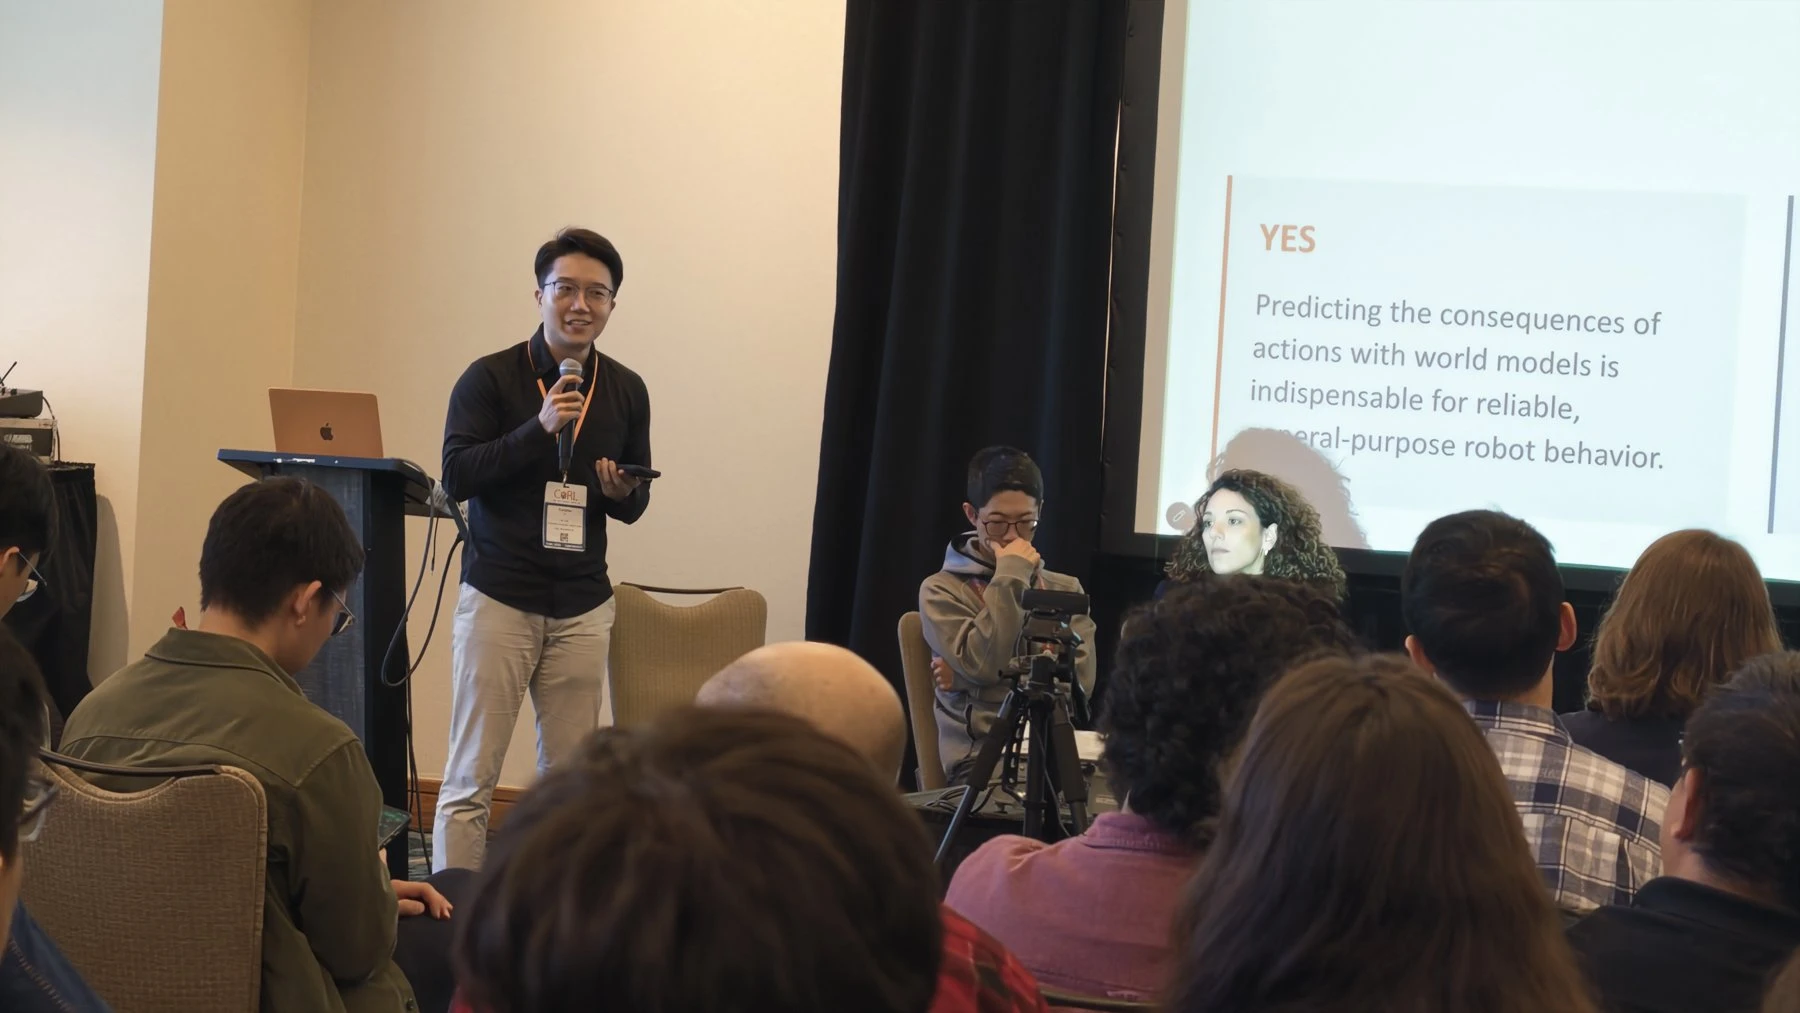
辩论开始前,现场投票,大部分人认为需要世界模型。
开场:先预测,还是直接优化
Max Zhaoshuo Li 先发言。他认为世界模型是基础:能想象结果,才能决定做什么。他知道反方会说,策略只要以历史、记忆等为条件,动作分布就能收窄、变得更集中,直接做对。他不认为现实是这样,复杂物体上尤其如此。
他拿近来的编程智能体作比:写完代码,它们会去运行程序、看结果。他认为机器人也会一样。
Chelsea Finn 从自己的经历说起。她 2016 年就做过世界模型。当时让她兴奋的,是这看起来是一条通往通用性的路:那时训练出来的策略往往只会做一件事,换一件事就得清空重训,很不令人满意;以动作为条件的视频模型显出了一些「生命迹象」,能推广到训练时没见过的新目标。可到了 2026 年,她认为另一类模型已经做到了零样本泛化:以语言、以任务视频等为条件预测动作的基础模型,能推广到新物体、新场景,以及没见过的机器人与任务组合,而且已经部署在真实用例里。
她的第二个论点关于优化:做任何优化,都应该优化真正在乎的东西。建一个世界模型是手段,目的是让机器人完成任务。如果直接在真实使用场景里,用强化学习去优化任务成功,她认为这是得到可靠机器人最直接的路,而可靠性正是现在还缺的。
对照已公开的工作,Finn 2016 年前后的这条线包括《通过视频预测进行物理交互的无监督学习》(Unsupervised Learning for Physical Interaction through Video Prediction)和《用深度视觉预见规划机器人运动》(Deep Visual Foresight for Planning Robot Motion)。
Georgia Chalvatzaki 接着说,已经有能成功部署的策略,可机器人还没有遍布我们周围。她的立场是:世界模型能让机器人学习更高效、更有效,尤其是在陌生情境和不确定性面前。即使策略能吸收记忆、历史等知识,在正确动作不明确、或者错误不容易纠正的时候,她希望机器人先比较可能的结果,再决定执行。
她列了世界模型的几种用处:生成训练经验;用于策略验证;在两个看起来一模一样、质量或摩擦却不同的物体面前,让机器人主动干预,比如推得更用力一点,收集更多信息;失败之后做反事实推理,问一句「如果当时换个动作会怎样」。
她还认为,不确定性应该决定机器人怎样使用计算、怎样分配评估策略的预算;不同层级的决策需要不同程度的细节,所以要重新考虑模块化,只是不再按以前的做法,而是要找能随计算扩展、又能给出预测和反事实的新架构和新算法。她也回应了 Finn:基于模型的强化学习从 2016 年起就有,过去被某些东西卡住,不等于模型没用。
Vincent Sitzmann 给了两个反驳论证。务实的一面:世界模型的关键用途,一是像思维链那样,先想象要做什么再去做;二是在仿真里训练策略。对前者,他认为正如 Chelsea 刚才所说,也许直接端到端训练就行;对后者,他不认为真实世界里的强化学习显然不够。哲学的一面:世界模型以前叫动力学模型,本质上是一个人类概念。
我们说,这里有个盒子,定义它的输入输出,输入动作和过去的观测,输出对未来的预测,再把它编进某个框架(harness)里去做事。他认为物理智能不会这样展开。将来会有人工智能体,它们被优化去追求比任何具体机器人任务更一般的目标;如果世界建模有用,它会作为这种智能的一部分涌现出来,用不着我们造一个输入输出由人定义的小盒子。即使相信思维链有用,也不意味着要坐下来专门造一个思维链盒子。
反驳:后训练会不会把模型磨窄
Max Zhaoshuo Li 的反驳针对后训练。他说自己的偏见是:后训练是在让输出分布收窄、更集中,使模型专门去做某个任务,这就牺牲了对各种变化的稳健性。他认为绕不开这样一种模型:既理解任务意图,又知道动作即将执行时会有什么后果。在他看来,这是通才智能体最基本的能力之一。
Chelsea Finn 回应,把训练收窄到单一任务,是出于方便:在特定领域、特定环境里研究算法比较容易。她认为未来的后训练会更像语言模型,在宽得多的范围内做,覆盖很多任务和环境,同时追求高性能,而且不需要世界模型。
她讲了一件自己玩一个策略时的事。组装纸风车(pinwheel)这个任务后来被蒸馏进了基础模型。在那之前,她先为纸风车做过后训练。其中一步是把一根小销钉插进纸中心的小孔,她用的数据里只用右手插销,是很窄的单一策略。
看评估视频时,她发现机器人不小心把销钉掉在了桌子左边。接着,它用右夹爪拿起纸,用左夹爪捡起销钉,成功插了进去。她说,后训练数据和预训练数据里都没有展示左右夹爪之间的这种对称,可它在被后训练到很窄的单一策略之后,仍然懂得这一步可以用左手完成,也可以用右手完成。她认为这说明,即使后训练让分布收窄、更集中,模型仍保有通用性。
Georgia Chalvatzaki 的反驳从动物讲起。她提到当天上午有例子展示动物解谜,许多研究表明动物会用前向模型做预测,再据此做决定;经验积累多了,不确定性坍缩下来,知识被内化成策略,成了日常行为。所以她说,正方并不反对策略。
问题在于:当智能更高、要和人交互、还要加上约束的时候,难道不想要一个能预测自己动作效果的系统?她认为视频模型里已经有大量知识,可以在抽象层面引导机器人决策、帮助做反事实预测;她认为要深入想怎样让架构更高效,光想着采更多数据、把模型做大是不够的。
Vincent Sitzmann 的反驳指向学习型世界模型的覆盖范围。学到的模型只能建模过去见过的东西,受限于它的泛化能力。他认为在真实机器人上,必须持续地从智能体的经验流里在线学习世界模型,可现在没有任何系统能在真实世界里做到这一点,深度学习里没有一个模型能可靠地在线学习。
而一旦要大量在线学习,世界模型就会变成策略的函数,因为训练它的数据是策略采来的;到那时,很难再分清哪里是策略、哪里是世界模型。所以他主张整体地处理这个问题。
现场有观众问 Sitzmann:视频规划器生成并预测在特定环境里执行动作的结果,它算不算世界模型?
他说这里有一点语义问题。视频规划器不是纯粹的动力学模型,它和策略纠缠在一起。如果要在数学上精确,就得说清模型什么时候是智能体策略的函数、什么时候不是;按这个标准,视频规划器更接近智能体的策略。不过他也承认,在视频规划器之上微调出一个以动作为条件的世界模型,效果会相当好,两者共享大量基础设施,视频规划器本身也得建模动力学,从这个意义上说,它同样是一个动力学问题。
评估:沙箱还是真实环境
Yunzhu Li 先问正方。他说自己一直在劝学生做世界模型,学生的反驳是:世界模型太难做,采些示教数据训出来的策略已经能在真实环境里做有意思的事;评估最后反正也得在真实环境里做,为什么还要世界模型?
Georgia Chalvatzaki 同意,现在训练世界模型很难,还没有对的配方。她认为原因之一是预测目标并不清楚,显式预测未必是该做的事;她一直认为,模型应当作为工具,用在决策过程的不同层级上,现在学模型所用的抽象层可能就不对。她举了个例子:她现在要坐电梯回房间,脑子里能大致模拟一遍路线,不确定性很高,但足够做计划,边走边更新判断。
所以,为整个流程建一个真正的数字孪生,未必是做出有依据决策的必经之路。她认为思维链是在某种空间里建模的一种方式,但把语义理解和几何结果融在一起、并组合出行为,仍是开放问题,表征需要重新想。
Max Zhaoshuo Li 回答,世界模型和策略在建模同样的状态转移,不必做成两个分开的系统,可以合成一个整体;他以语言模型为例,认为以任务为条件生成的每个文本标记,都在建模这种转移。
随后 Yunzhu Li 问反方。他说两年前和做自然语言处理的朋友聊,对方开始做智能体,突然也感受到了具身研究的痛:智能体要和环境交互,评估要在闭环里做。现在大语言模型智能体的团队建了大量闭环工作流和沙箱来做评估。
他比较过,比如要区分成功率 90% 和 92% 的两个检查点,在真实环境里评估和在沙箱里评估,效率差几个数量级。既然世界模型式的沙箱在智能体评估上这么成功,反方怎么看?
Chelsea Finn 回答,要用学到的世界模型做评估,并最终换来效率,需要一个能对任意动作分布建模结果的世界模型,这要求对各种动作分布有相当的覆盖。往酒杯里倒酒,要建模液体怎样反应;不小心把酒杯碰到地上,还得建模所有碎片怎样飞散。训练策略则只需要隐式地学到一部分动作的结果。
用强化学习学习时,会试一些成功的动作、一些失败的动作,但试的方式很有针对性,在优化循环里很快就能收敛到会成功的动作,用不着在真实世界里把每一个可能的动作都评估一遍。所以,绕道世界模型、并要求它能建模每一个动作,会比直接在真实世界里优化策略、只考虑优化过程会碰到的动作更慢。她把症结归结为:世界模型总体上比策略更难学,区别在于要考虑的是所有动作,还是学习过程中遇到的动作。
Vincent Sitzmann 说自己的论点正好跟着 Chelsea。要建模什么,归根结底取决于要学什么、目标是什么。事先划一条线,规定要对哪些动作、哪些状态保持稳健,他认为是一场必输的游戏;应当让智能体自己决定世界模型该管什么、该采取什么动作。
定义:预测后果就算世界模型吗
观众里有很多关于定义的问题。Yunzhu Li 转述:在像素空间或潜空间里预测动作后果,算不算世界模型?同时也预测动作的,又算不算?
Max Zhaoshuo Li 先说,这个问题谁先答,以后大概就要挨批。他的回答是:只要在建模后果,就算。学策略时,很多时候其实也在建模后果,把模型拿出来探一探,能看到这种迹象,它会避开某些策略、尝试别的做法。
在他看来,这就是世界模型的定义,即理解后果。他还说,对他而言世界模型比采取动作难得多,因为它要理解好动作和坏动作两者的后果,这在他看来是更有意思的问题。
Georgia Chalvatzaki 再次表示,世界模型绝不容易,她仍然认为我们学它的方式不对。人在生命最初几年里花很多时间玩耍,玩耍不针对目标,多半由好奇心驱动,好奇心又来自对知识、对信息的追求。她认为,让机器人智能从这种与世界的交互里生长出来,是一个很令人兴奋的方向;强化学习能让智能体解决任务,但得到的是贪心策略,给不出多少替代方案。如果能通过干预、探索替代方案、与目标无关地训练模型,就可以在此基础上再去探索别的做法。
Vincent Sitzmann 回到覆盖问题。为每一个可能的动作建模结果,他认为人类自己也做不到,而且需要的训练数据会大得不成比例。在深度学习的范式里,模型的每一种能力都来自数据,这里的数据也包括生成数据的方式;所以我们的工作很大程度上是策展数据,或设计挑选数据的算法。如果对所有可能动作都取均匀先验,就只能把所有数据都采一遍,他认为这非常棘手。
收尾:必需,还是有用
最后,Yunzhu Li 请每人简短说说真实看法。
Max Zhaoshuo Li 说,他心里的世界模型指的是真正理解每个动作的转移动力学,和以动作为条件的视频生成模型是两回事;在他看来,这是任何策略评估的基础。
Georgia Chalvatzaki 说,视频模型也许能提供一个不错的起点,但关键是真正理解物理,解开这一步之后,才能进一步做反事实预测。这个问题很难,需要更深入地想;与此同时,大家在推视觉-语言-动作模型(VLA)的极限,看能走多远,而背后也得做另一条线的研究。
Vincent Sitzmann 说,技术上,什么管用就用什么,它能帮评估、帮所有事;这是应用科学,是工程问题。哲学上,他不认为物理智能到来时,会带着一个由我们先定义状态空间、再以动作为条件做预测的世界模型;如果智能体如他所料能预测自身动作的后果,那会作为副作用涌现出来。
Chelsea Finn 说,世界模型是值得探索、也很有意思的研究课题,其中一些部分会对开发模型非常有用。比如,不必捕捉所有可能交互的仿真,对评估策略会非常有用,也可能在一定程度上改进策略。但要说严格必需,她认为不太可能;它们也许能让我们更快走到那里。
这场辩论的分歧,最后落在一个可以检验的问题上:要建模哪些动作。Finn 和 Sitzmann 认为,世界模型若要对任意动作给出可靠后果,覆盖和数据的代价太高,直接优化只需要碰到优化过程会考虑的那些动作,世界建模能力如果有用,也会从更一般的目标里长出来。Max Zhaoshuo Li 和 Chalvatzaki 认为,正是在陌生情境、高不确定性、要比较后果和做反事实的时候,只会做对动作的策略不够用;Chalvatzaki 同时承认现在没有对的配方,问题可能出在抽象层和学法上。
双方在评估上靠得最近。主持人摆出的是沙箱评估的效率差距,Max Zhaoshuo Li 把世界模型称为策略评估的基础,Finn 在收尾时也说,不必捕捉所有交互的仿真会对评估策略非常有用。分歧在于这样的模型是工具还是前提:反方把它当成可以加速的工具,正方把它当成通才智能体必须具备的能力。要分出高下,需要看到在陌生物体、真实环境里,带显式预测的系统和直接优化的策略,在同样的数据和算力下谁更可靠。
辩论结束后再次投票,票数反转。