
智在无界卢宗青团队提出 Being-M0.7,依托人类视频动作先验,训练人形机器人全身移动操作
Being-M0.7 依托一万余小时人类第一视角视频与人体动作数据,学习画面与全身动作的联合先验,再通过机器人轨迹完成中训与动作后训练,输出人形机器人全身移动 + 操作的控制指令。模型在 SIMPLE 仿真基准中综合成功率 71.1%,位列基线第一;在 Unitree G1 真机测试中和最强基线性能持平。
10 月 8 日,智在无界(BeingBeyond)团队发表论文《Being-M0.7: A Latent World-Action Model for Humanoid Robots》。论文共有 13 位作者,Junpeng Yue、Boyuan Li、Yuxuan Wang 为共同第一作者;通讯作者为北京大学计算机学院长聘副教授、智在无界创始人卢宗青。
人形机器人完成全身移动并操作物体,既要感知当下环境,预判后续场景与自身运动,还要调度全身肢体协同。真机示范样本稀缺,是该方向的核心瓶颈。
人类第一视角视频与动作数据能够大规模补充样本,但数据模态参差不齐,部分仅有视频、部分只有动作,且人类动作无法直接迁移给机器人执行。
Being-M0.7 采用「先学习人类数据,再迁移至机器人」的思路:预训练阶段将视频、动作映射至共享表征空间,联合预测未来视觉潜态与动作,使视觉表征内嵌运动学信息;机器人中训阶段,把学到的先验适配到机器人的观测视角与本体形态;动作后训阶段,由动作专家基于冻结先验输出的预测上下文,生成全身控制指令。
01 统一人类视频与动作表示
该工作面向人形机器人全身移动加操作任务。机器人边走边抓取物体,需要同步规划行进方向、躯体转动与手脚协同,并且在伸手交互时维持身体稳定。这类任务不仅依赖实时环境观测,还需要预判未来场景与自身运动状态。
真机示范采集是该方向的核心瓶颈。想要采集同步配套的第一视角画面、本体状态、可执行全身控制指令轨迹,需要复杂遥操作系统,同时受安全约束、硬件条件与场景丰富度限制。人类第一视角视频与动作捕捉数据可以大规模提供视觉动态与全身行为信息,但数据模态并不统一:部分样本仅有视频,部分只包含动作序列,并且人类动作无法直接转化为人形机器人的可执行指令。
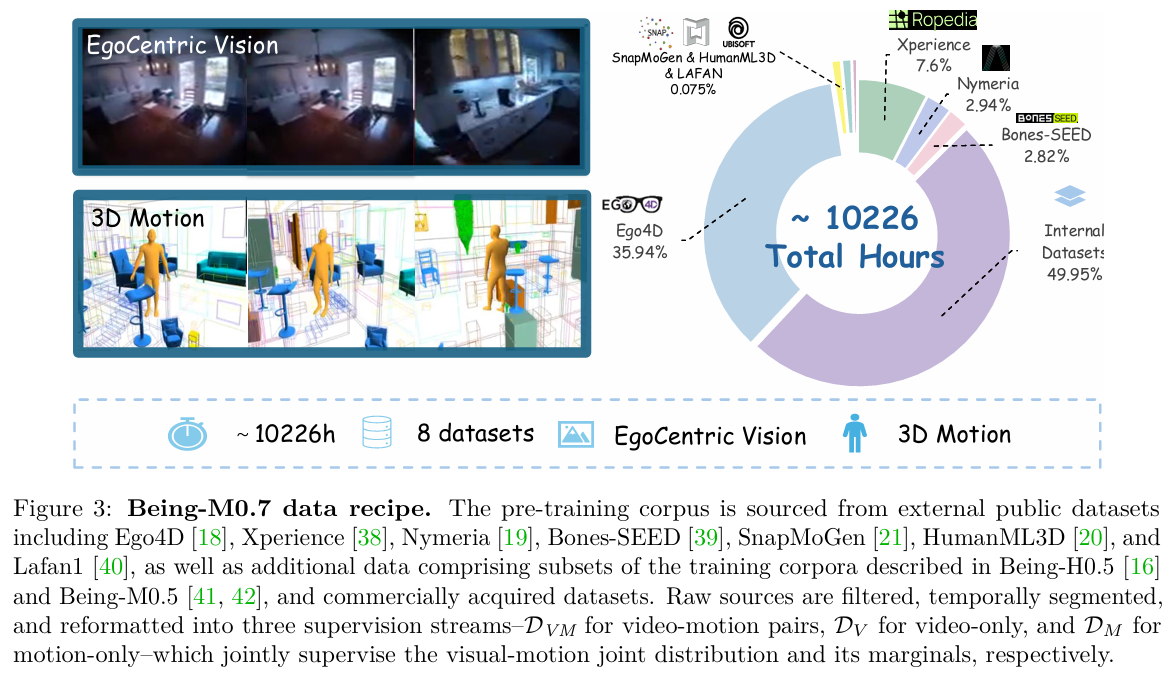
团队基于一万小时以上原始人中心数据,在过滤、时间切片处理前,将数据整理为三类监督信号:
-
视频动作配对样本:监督未来画面与全身动作的联合预测
-
纯视频样本:监督场景视觉动态变化
-
纯动作样本:监督全身运动学结构
配对样本提供跨模态联合监督,单模态样本补充各自维度的边际监督,让训练覆盖范围远大于仅使用成对语料的方案。数据集来源包含 Ego4D、Xperience、Nymeria、Bones-SEED、SnapMoGen、HumanML3D、Lafan1 等公开数据集,同时纳入 Being-H0.5、Being-M0.5 前期工作的子集以及商业采购数据。
研究为人类与机器人设计一套共享的精简动作表征。该表征为 22 维、以头部作为根节点的向量:包含根节点平移 3 维、根旋转连续 6D 表征 6 维、初始头高 1 维,再加上左右手、左右脚局部位置各 3 维,合计 12 维。这套表征从人体动捕数据提取,在机器人端则通过正运动学由关节量重建,实现人与机器人共用同一套表征接口。数据时间维度降采样至 5 Hz;动作通道按照各数据集均值、标准差做逐通道归一化,标准差低于 10⁻⁵ 时替换为 1。
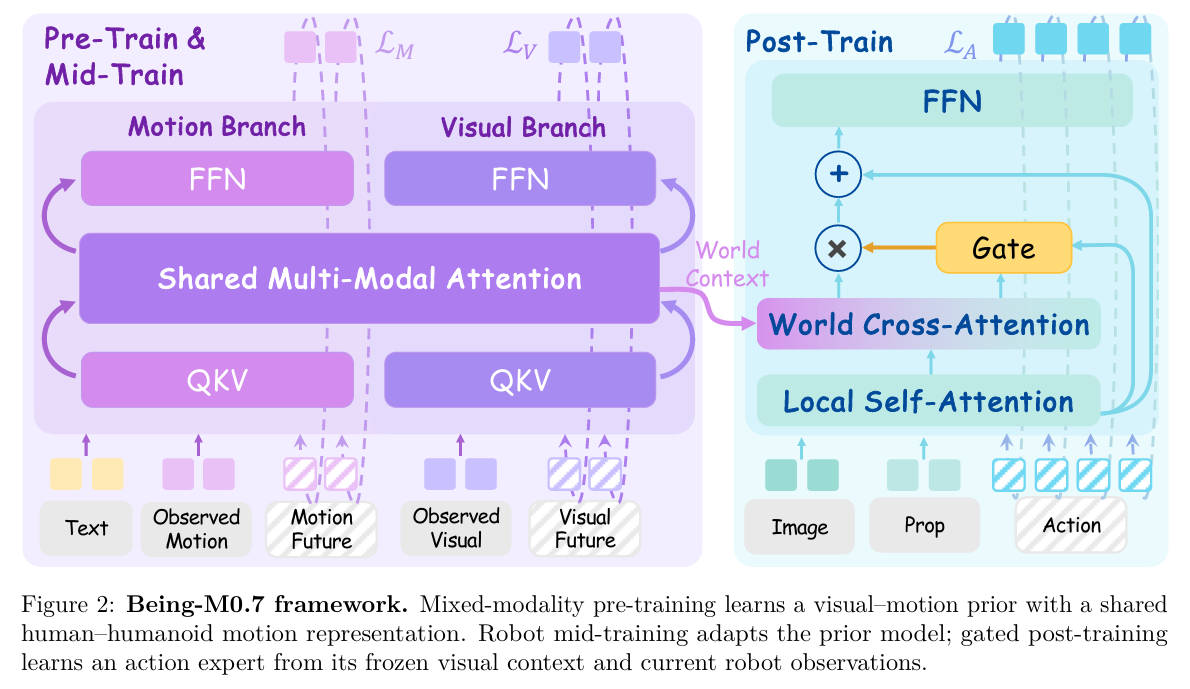
视觉分支不直接处理原始像素,采用冻结 DINO 编码器将图像转为潜变量;潜变量同时作为模型输入与预测目标。模型无需重建像素细节,将算力集中于场景语义、物体布局以及场景时序演化。预训练阶段联合预测未来视觉潜态与动作,视觉特征需要同时编码画面变化与底层运动学变化,这也是将人类视觉 - 动作先验迁移到下游机器人控制的关键。
02 混合专家模型联合预测未来
先验模型需要同步处理图像、动作两类模态,团队采用视频 - 动作混合 Transformer(Mixture of Transformers,MoT)架构实现联合建模。视觉潜变量与动作 token 分别经过可学习输入投影、时序位置嵌入与模态嵌入,映射至统一隐空间。任务指令由冻结的 DistilBERT 独立编码,视觉、动作两条分支均借助交叉注意力读取指令信息。
在每个 MoT 模块内部,视觉与动作分支保留各自的层归一化、QKV 投影与前馈网络,仅在共享注意力模块完成信息交互,让视觉状态演变与动作动态能够相互作用。流时间步 τ 的正弦嵌入,经由各模态独立的自适应层归一化,对本模态的自注意力、语言交叉注意力以及前馈网络做调制。模块间采用分块注意力掩码:已观测的历史 token 仅能在历史序列内交互,无法看到未来信息;带噪声的未来 token 可同时读取历史与同 chunk 内其他未来 token,实现整段未来序列并行去噪。
架构层面显式处理模态缺失问题。模型对视觉、动作 token 设置固定交错排布方式:纯视频样本将动作特征替换为可学习的「缺失动作」嵌入;纯动作样本则把视觉特征替换为「缺失图像」嵌入。模态存在标识结合时间有效性掩码,限定有效 token 的访问范围:有效查询无法读取缺失模态的键值,无效查询仅可自交互,其输出既不参与监督计算,也不会送入动作专家。进入动作后训练与部署阶段时,动作存在标识全部置为关闭,动作状态初始化为零,不再接收流更新,仅积分并缓存视觉未来状态。
动作专家为独立的流匹配 Transformer,与先验模型解耦。该模块接收带噪动作 token 与当前观测信息:观测中的第一视角图像复用同一套冻结 DINO 编码器,本体状态则通过可学习投影完成编码。专家先依靠局部自注意力融合动作与观测 token,再在指定网络层,通过门控交叉注意力读取冻结先验的隐状态,将包含运动学信息的预测上下文注入多层网络。信息流向单向,动作 token 不会参与先验模型的计算过程。
门控机制作用于单个 token。动作 token 在专家某一层经过局部观测处理得到特征 x,其世界交叉注意力的投影更新量为 r;模型利用带 sigmoid 的门控系数 g 缩放该残差项,再乘以流条件给出的尺度,叠加回动作 token。这套机制允许每个 token 自主决定吸收多少预测上下文,而动作 token 对当前观测的读取,依旧由本地自注意力保障。先验模型共 30 层,隐层宽度 768,配备 24 个注意力头;动作专家同样为 30 层,隐层宽度 1,024,32 个注意力头。专家在第 3、6……30 层,与先验模型对应层建立连接,动作序列块长度设为 30。
03 分三阶段训练再闭环推理
整体训练流程分为三个阶段:预训练依托人类数据学习粗粒度的画面 - 动作先验;机器人中训将该先验适配至机器人的观测视角与本体运动特性;动作后训则在冻结后的适配先验基础上训练动作专家,输出机器人可执行的全身控制指令。
预训练采用流匹配方案,向干净的未来 token 添加噪声,让模型预测目标速度。视频 - 动作成对样本同时计算视觉、动作双分支损失;纯视频或纯动作样本仅激活对应模态的损失,依据存在的模态做针对性监督。动作分支额外引入两项几何辅助损失:一项约束解码得到的全局头部位移轨迹,另一项约束左右手、左右脚的局部末端速度,权重分别设为 0.1 与 1.0。几何损失仅对运动 token 内有效的未来帧计算,当有效索引为空时,该项损失置零。
中训与后训复用同一套机器人轨迹数据。中训负责将先验适配到机器人视频、动作序列与任务文本,损失为视觉损失与动作损失之和,其中动作损失仅在轨迹附带动作信息时参与计算。依靠统一的动作表征,预训练习得的先验能够迁移到机器人场景与本体动力学。完成中训后,先验权重冻结,进入带动作监督的后训练阶段。
后训练阶段,先验从高斯噪声起步,通过 3 步积分流 ODE 采样生成未来视觉序列,关闭显式动作预测。沿着这条去噪轨迹,提取先验指定网络层的隐状态,作为预测上下文输入动作专家,专家同时接收当前观测信息。在先验自身生成的预测样本上训练专家,目的是缩小训练与推理阶段之间的条件分布差异。动作专家对动作分块加噪,以流匹配平方误差作为损失;冻结的先验模型在视觉、动作分支均不接收来自动作损失的梯度更新。
推理阶段,先验以低频生成未来视觉规划,并缓存中间隐状态,作为策略端的键值。动作专家在多次动作查询中复用这份缓存。每一次查询,专家读取最新图像与本体状态,借助门控缓存对动作块执行去噪。缓存会在上下文耗尽前更新,以此分离低频的场景、全身意图预测和高频响应式控制指令生成。时序配置上,单个先验窗口包含 1 帧观测加 24 帧未来帧,5 Hz 预测帧率,覆盖时长 4.8 秒。底层控制器以 50 Hz 执行指令,单个动作块包含 30 步,时长约 0.6 秒,新查询触发频率约 1.67 Hz。采样步数方面,后训练时先验采用 3 步采样;推理阶段,先验与动作专家各自使用 10 步采样。
工程配置上,三个训练阶段均使用 8 张 GPU;单卡批量依次为 256、64、64,有效批量分别为 2,048、512、512。学习率依次设置为2*10^{-4}、10^{-4}、10^{-4};优化器选用 AdamW,权重衰减 0.05,梯度裁剪阈值 1.0,启用 FP16 混合精度。后训练从 50,000 步的中训检查点初始化,DINO 与 DistilBERT 在全流程保持冻结。
04 在仿真与真机上验证成绩
本次评测分别在 SIMPLE 仿真基准与 Unitree G1 真机平台开展,所有对比基线与模型消融变体均采用统一多任务训练配置,保证评测条件公平一致、结果可信。
真机测试平台基于宇树 Unitree G1 人形机器人搭建,双臂各含 7 个自由度,搭配 Linker Hand O6 灵巧手;头部搭载 Intel RealSense D435i 相机,用于采集第一视角观测画面。模型推理部署在单张 NVIDIA RTX 4090 显卡,底层控制器通过 ZMQ 协议与策略服务器完成闭环交互。
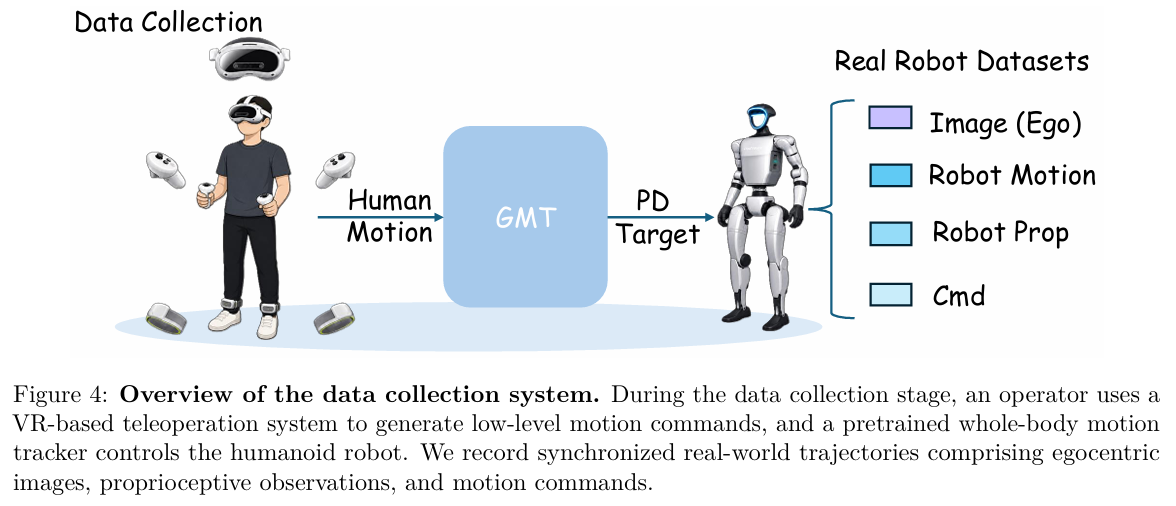
真机训练数据依托整套 VR 遥操作体系采集:操作人员佩戴 PICO VR 头显、双脚踝追踪设备与双手操作手柄,输入全身动作指令;XRoboToolkit 实时解析 VR 数据流,解算操作人员 SMPL 人体姿态,再经由 SONIC 模块输出稳定的 29 自由度全身控制指令,以 50 Hz 频率驱动 G1 机器人运行。数据采集全程同步记录第一视角 RGB 画面、机器人本体状态及含手部控制的完整全身指令,形成高质量真机轨迹数据集。
所有基线模型与消融变体均采用统一多任务评测方案:仿真场景下基于 SIMPLE 基准的六项任务联合训练、统一模型完成全任务评测;真机场景下基于三项全身操作任务联合训练,单模型适配全部测试任务。SIMPLE 仿真基准包含 BendPick、Handover、Mobile P&P、Grasp、XMoveBendPick、XMovePick 六项任务,每项任务均设置简单、中等、困难三档难度,每档重复测试 10 次,单模型累计完成 180 次仿真试验。
仿真整体评测结果显示,Being-M0.7 综合成功率最优,180 次试验成功 128 次,聚合成功率达 71.1%,显著优于同条件下的主流基线模型:Ψ0 为 64.4%(116/180)、π0.5 为 52.8%(95/180)、GR00T-N1.6 仅 33.9%(61/180)。分任务来看,模型在 Handover 任务三档难度全通关(9/9/10),Grasp、XMovePick 任务也表现优异,分别取得 10/10/8 的成绩。同时模型存在针对性短板,跨难度汇总结果表明,Ψ0 在 BendPick 任务更具优势,π0.5 则在 Mobile P&P、XMoveBendPick 任务中表现更佳。
研究在相同六项任务、三档难度的仿真体系下开展完整消融实验,每个变体同样完成 180 次对照试验,精准验证各核心模块的有效性。移除人类数据预训练后,模型聚合成功率从 71.1% 大幅降至 48.9%(88/180),性能下降 22.2 个百分点;去除机器人中训适配环节,成功率降至 59.4%(107/180),下降 11.7 个百分点;将先验模型的预测上下文替换为纯任务语言特征,成功率降至 58.3%(105/180),下降 12.8 个百分点。
两类关键消融变体的性能短板集中体现在 BendPick 任务中,该任务成功率从原模型的 22/30 分别骤降至 0/30 与 2/30。纯语言特征替代的变体在六项任务中有四项性能落后,其中 XMovePick 任务差距最显著,原模型 28/30 的成功率远高于变体的 8/30。唯一例外为 XMoveBendPick 任务,语言特征变体表现更优(21/30 vs 9/30),团队分析认为,这是多项任务视觉场景高度相似,引发视觉特征干扰,进而让纯语言条件临时占据优势。
真机评测聚焦三项高难度全身移动 + 操作任务,分别为 Walk to Fish(W2F)、Walk to Mirror(W2M)、Walk to Doll(W2D)。每项任务测试 5 次,单模型累计 15 次试验。测试固定机器人起点与桌面位置,目标物体随机摆放于左、中、右三个位置,单次任务限时 30 秒,任务成败由人工标准化判定:W2F 要求机器人通过网兜捞取玩具鱼,W2M、W2D 要求完整抓取并转移对应玩偶。
真机实测结果表明,Being-M0.7 15 次试验成功 13 次,成功率 86.7%,与当前最强基线 GR00T-N1.6 性能完全持平,大幅优于 π0.5(7/15)与 Ψ0(3/15)。分项任务表现与顶级基线完全对齐:W2F 成功 3/5、W2M 成功 5/5、W2D 成功 5/5,在双手精准操作、移动协同抓取场景中稳定性极强。
团队同时明确了模型当前的局限性:本次评测仅覆盖短时程全身移动操作任务,更长时序、更复杂的连续全身交互场景尚未完成验证;此外,现有 SONIC 全身控制器的末端跟踪精度存在上限,一定程度增加了高精度真机示范数据的采集难度,也限制了模型极致性能的发挥。