
世界动作模型
共 7 篇相关内容
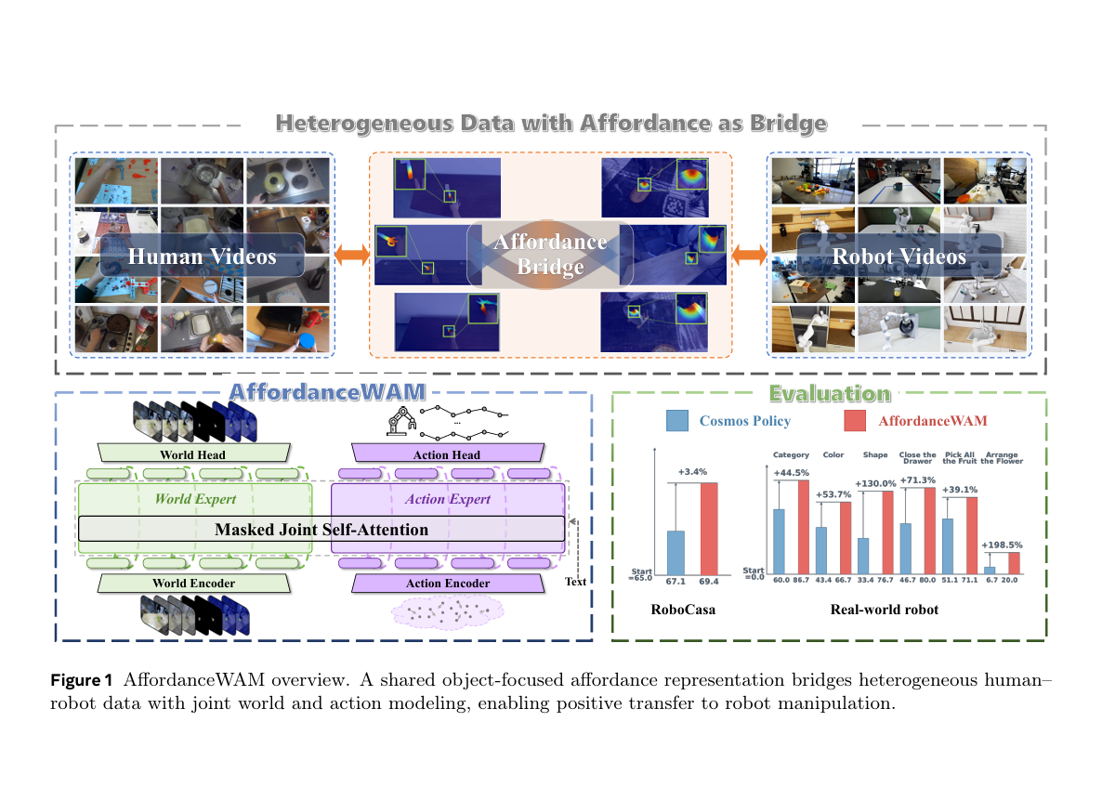
港大、港科广、北大等五校团队联合发布 AffordanceWAM,靠可供性激活真人训练视频
AffordanceWAM 的核心突破,是将「物体可交互位置与方式」的可供性,纳入世界动作模型的显式预测目标,彻底解决真人第一视角视频难以适配机器人训练的行业痛点,让原本容易造成负迁移的真人数据,转变为可规模化扩展的有效监督信号。 9 月 …
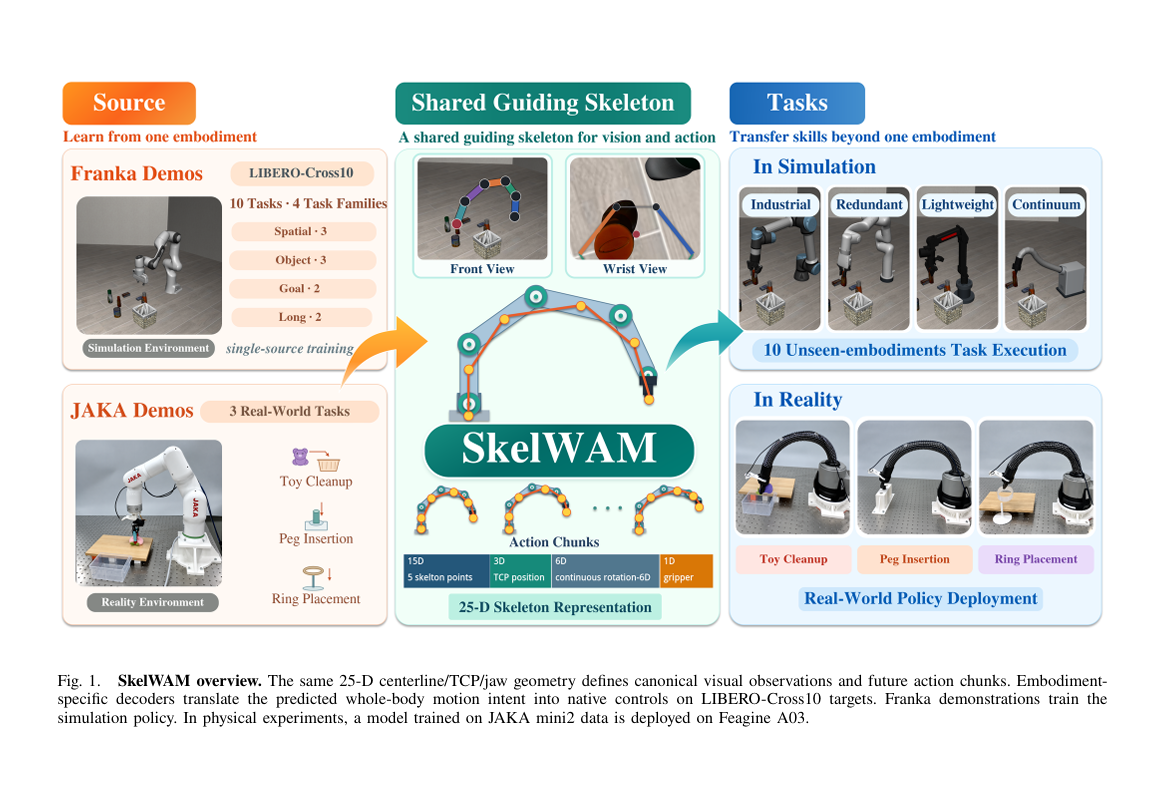
清华赵行团队与北大刘珂团队发布 SkelWAM,用骨架让策略零样本跨十种机械臂
SkelWAM 实现了在一台机器人上训练好的操作策略,可以直接部署到其他不同结构的机器人身上。研究团队设计了一套统一手臂骨架的公共几何表征。模型接收视觉画面,读取本体状态,预测后续动作,全部基于这套表征。策略只在 Franka 上训练,迁移…
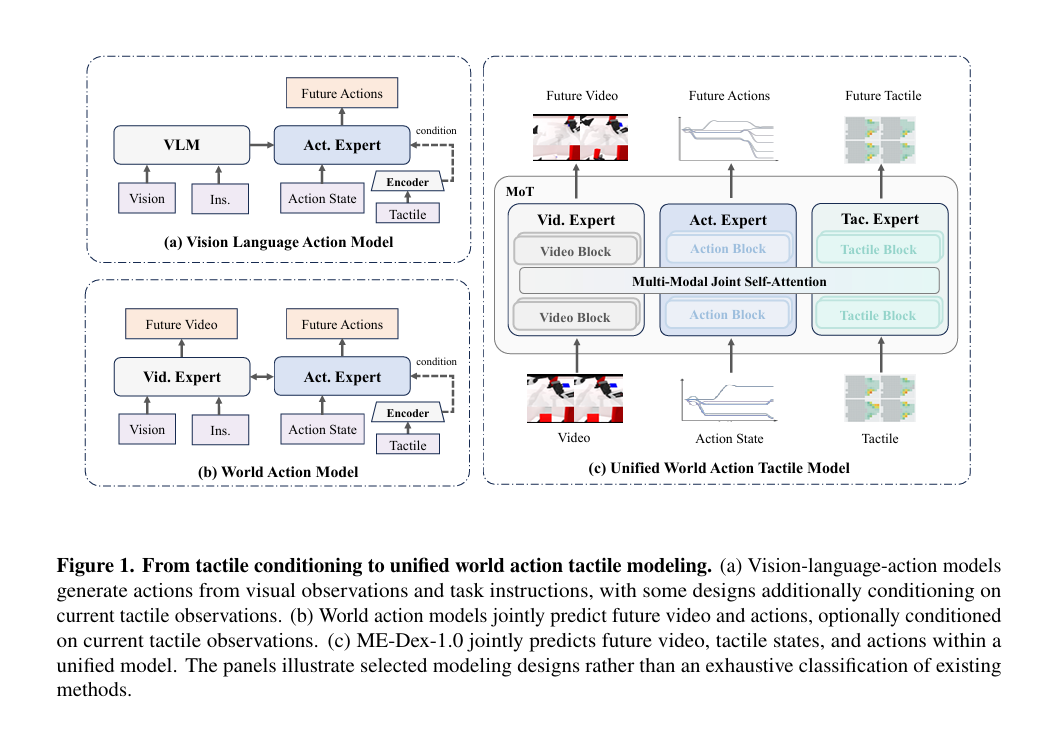
理想汽车基座模型团队提出 ME-Dex 1.0,让触觉和画面一起预测未来
ME Dex 1.0 让机器人在输出动作前,预先计算下一步会产生的接触状态。理想汽车基座模型团队将视觉、触觉、动作三路专家模块整合进同一个去噪框架;触觉与图像一样,被视作需要预测的未来观测。团队还借助手部模板,把不同灵巧手、夹爪的触觉信息对…
星海图赵行:机器人的下一次 Scaling,不只发生在预训练
机器人抓起一个商品,只能说明它会做一个动作。展台上的机器人完成一次抓取,与它进入前置仓持续接单、拣选和打包,是两种不同的考验。 前者可以被压缩成一条成功轨迹,后者却要求机器人理解订单、定位货架、自主导航、处理随机摆放的商品,还要在多机协同时…
杨立昆点赞,浙大孙俊涵、清华赵昊等提出 INTACT:免去 JEPA 世界模型的「搜索税」
世界动作模型的核心在于,先预测「下一步发生什么」,并为其设立目标,再让机器人看一眼目标,自己决定执行的每一步该做什么。 然而当前的主流方案有一个别扭的设计:训练时,模型学会「给定当前画面和动作,预测接下来发生什么」;部署时,控制器却从随机噪…
首次!北大、南洋理工等 30 位研究者联手厘清具身数据金字塔
7 月 28 日,来自北京大学、南洋理工、港科大、新加坡国立、港大、上海交大等十余所机构的近 30 位研究者联合发布了一篇 72 页长文综述《Data Pyramid for Embodied Manipulation》。该综述通过一个五层…
百亿估值后,这家机器人公司推出「最快」世界模型
在机器人落地干活这条路上,世界模型(WM)被很多人认为是上限更高的技术路径,不过在行业逐渐对其范式形成共识之际。星海图团队发布的世界模型研究成果 Fast WAM,让机器人的反应速度大幅提升的同时,也提出了一个非常直接的问题: 「WAM(世…