

输入
共 84 篇相关内容
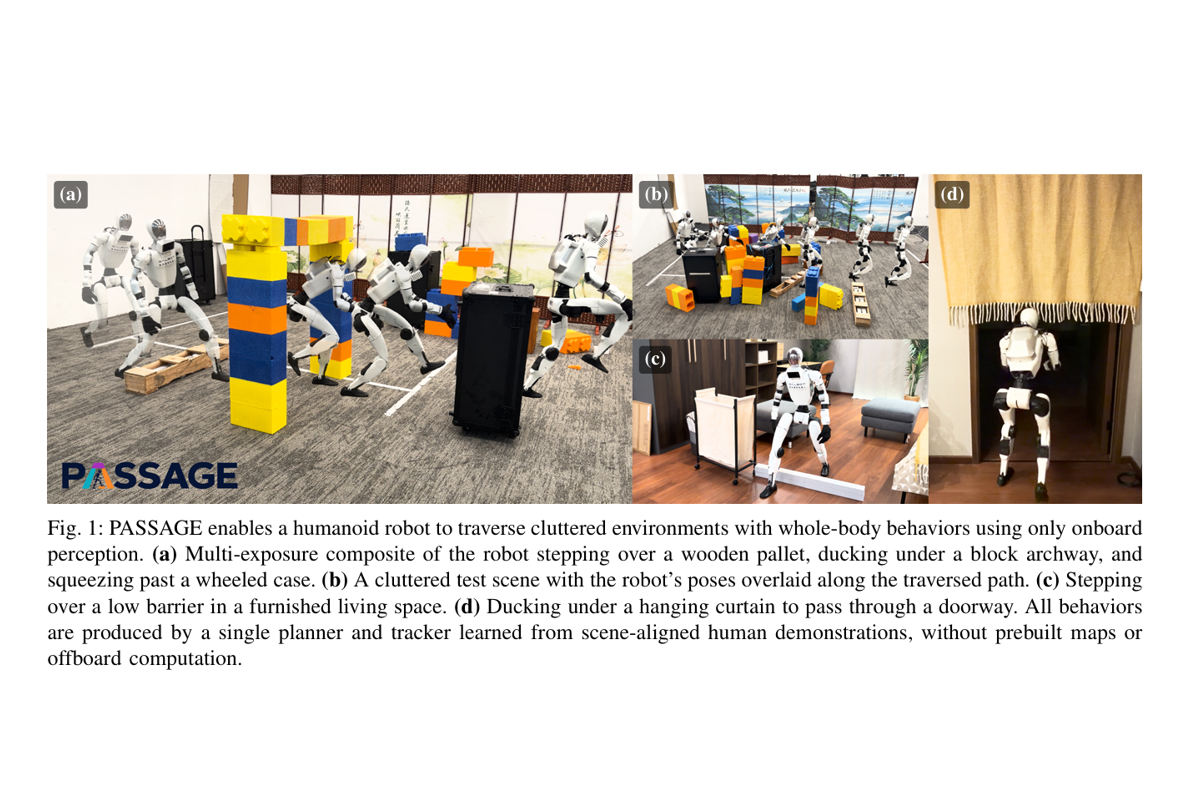
清华大学弋力团队发布 PASSAGE,让人形机器人自己挑动作穿过杂物间
PASSAGE 研究将场景对齐的人体动作数据积累至100小时量级,通过流匹配规划器搭配感知增强的全身追踪器架构,让人形机器人能够在杂乱受限环境中自主选择并组合跨越下穿侧身避让等多元运动动作。仿真测试结果可以直观证明,机器人无接触通行的成功率…
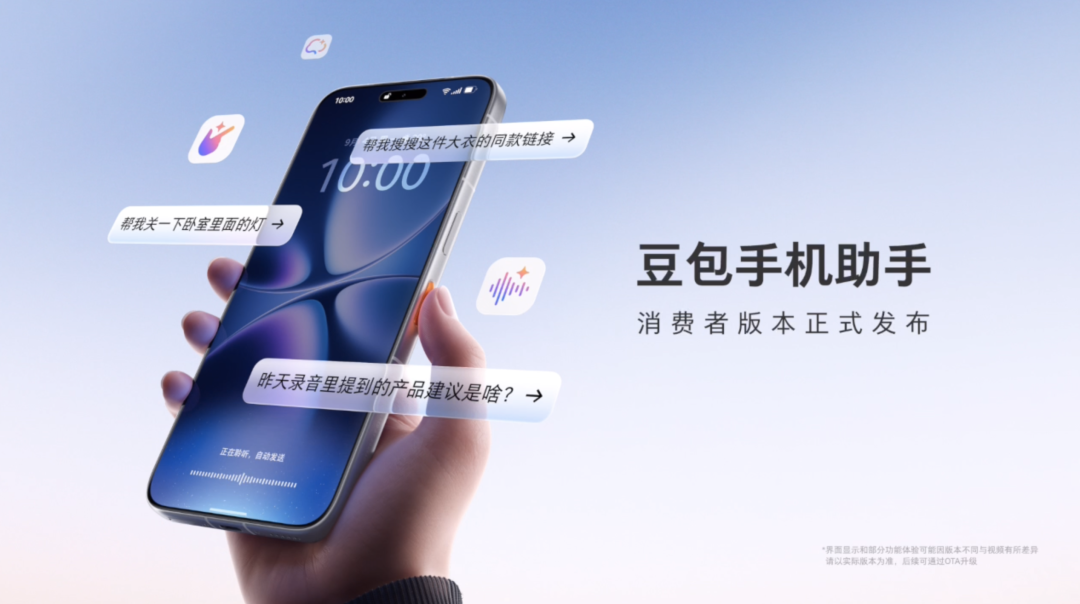
卷土重来的豆包手机,把隐私问题解决了吗?
2025 年 12 月 1 日,搭载豆包手机助手技术预览版的努比亚 M153 以工程样机的形式少量发售,定价 3,499 元,很快售罄。官方演示中,它可以根据一篇种草笔记寻找商品、跨平台比价,也能整理旅游攻略、在地图中标记餐厅,再根据行程继…
对话上海交大杨理欣:为什么机器人需要一条「三维时间轴」
机器人会倒水,却可能在放下瓶子后忘了刚才倒过哪一瓶。会执行动作,不等于知道任务该如何推进;机器人还需要把任务意图、行动历史与世界变化连成一条三维时间线。 这类失败不完全是抓取精度问题。今天的视觉—语言—动作模型(Vision Languag…
星海图赵行:机器人的下一次 Scaling,不只发生在预训练
机器人抓起一个商品,只能说明它会做一个动作。展台上的机器人完成一次抓取,与它进入前置仓持续接单、拣选和打包,是两种不同的考验。 前者可以被压缩成一条成功轨迹,后者却要求机器人理解订单、定位货架、自主导航、处理随机摆放的商品,还要在多机协同时…
模型之外,Ego2Robot 让数据处理管线当回主角
一台机器人在固定桌面上完成任务,和换了桌布、改了光照、挪了相机位置之后仍然做对,是两种完全不同的能力。前者说明策略已经收敛,后者才决定它能不能走出实验室。 众所周知,机器人遥操作天然比人类中心视频慢、贵。而此前工作仅在小规模单任务上验证过「…
上交卢策吾、浙大等团队提出 Track4Action:把「动作后的 3D 世界」蒸馏进 VLA
VLA 模型可以把图像和语言指令转换成机器人动作,训练的过程中,研究人员通常只评价机器人的动作像不像专家。至于机器人的动作会怎样改变物体、空间关系和任务状态,通常没有被明确交给模型学习。短任务可能掩盖这个缺口;一旦任务变长,或者视角、背景和…
杨立昆点赞,浙大孙俊涵、清华赵昊等提出 INTACT:免去 JEPA 世界模型的「搜索税」
世界动作模型的核心在于,先预测「下一步发生什么」,并为其设立目标,再让机器人看一眼目标,自己决定执行的每一步该做什么。 然而当前的主流方案有一个别扭的设计:训练时,模型学会「给定当前画面和动作,预测接下来发生什么」;部署时,控制器却从随机噪…
0.04B 通吃异构相机,与地瓜机器人隋伟谈 X-Lens 取舍逻辑
鱼眼相机看得广但画面边缘是畸变弯曲的,针孔相机看得直但视野窄。 一台机器人身上往往同时挂着这两种相机,用于感知环境深度,而像 DAC、MapAnything 等深度估计模型,几乎没有既能同时适配好这两种相机,又能端侧跑起来的方案。 对此,地…
50 万小时第一视角视频,如何给具身世界模型补上「触觉」
一只机械手把葡萄从一串果实中摘下来,难点不在于「看见」葡萄,而在于何时接触、哪根手指承力、力道多大才不会把果肉捏坏。挤牙膏、从软袋里摸出被遮住的物品、用软笔写字,都是同一类问题:视觉能描述物体和姿态,却很难直接给出接触已经发生了没有、接下来…

一次开源三大模型,腾讯机器人正在「超车」
继 2025 年 WAIC 腾讯 Robotics X 实验室发布首个模块化具身智能开放平台 Tairos,在今年 WAIC 上,腾讯 Robotics X 实验室、福田实验室联合腾讯混元发布具身智能系列新成果。 新成果包括发布并开源基于混…
不止于预测,小米将世界模型打造成数据引擎
7 月 14 日,小米放出其自研机器人在工厂中连续作业的任务视频,视频中可以看到机器人在面对不同尺寸工件依然可以长时间稳定作业。 然而,机器人在工厂里的稳定作业,只是最终呈现出来的结果。真正支撑这一结果的,是机器人背后的模型能力。模型能力决…
把 Codex、CC 搬进机器人训练? 朱玉可、Jim Fan 最新力作谈具身持续学习系统
让机器人去拿一罐可乐,听起来像一件很小的事。 但行动的每一步都可能翻车:没看清可乐罐,抓取姿态歪了,路径规划撞到了桌角,手指夹住了空气,或者好不容易拿起来,下一秒又把它放错了地方。 最后给你一句很没用的反馈:任务失败 。 这就像程序崩了,但…