

输入
共 84 篇相关内容
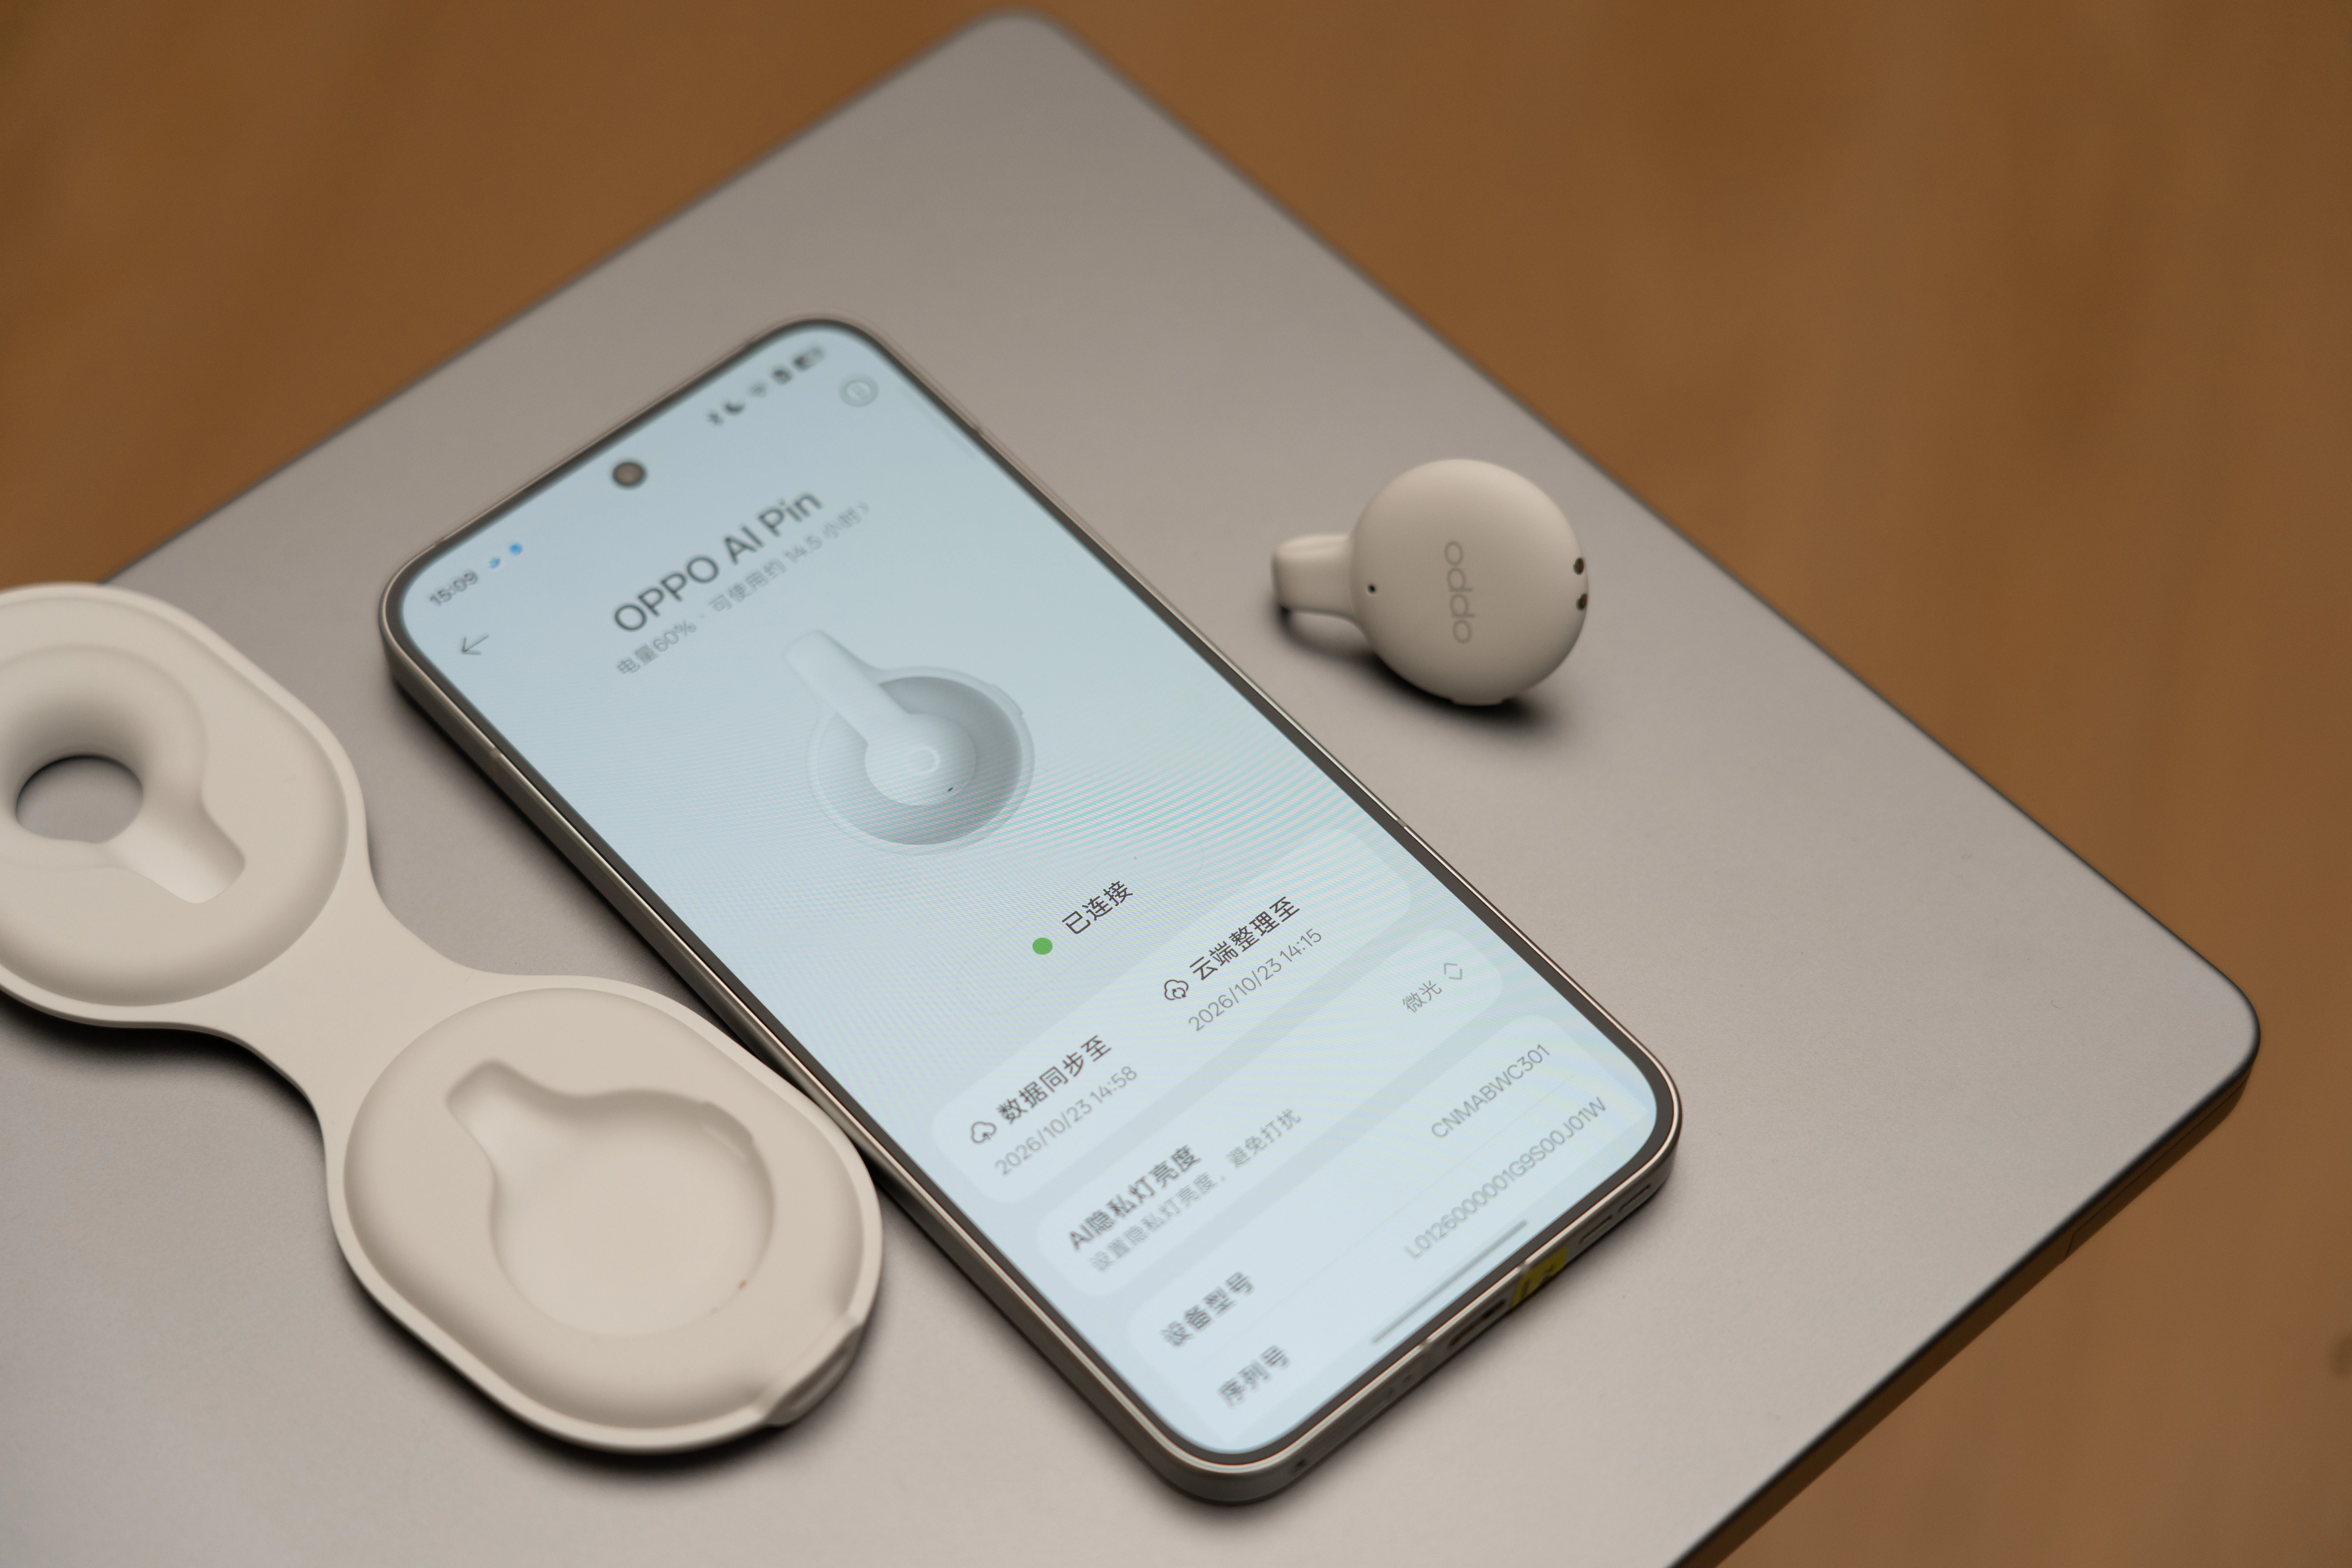
OPPO 心力球实测:三天时间手搓个「妈味」AI
第一次连 OPPO 心力球,我差点以为手机里钻进了一位故人。 App 里显示的设备名叫:OPPO AI PIN。 看到这几个字,经常关注科技的朋友大概都会条件反射一下。Humane 那个著名的 AI Pin,已经在 2025 年 2 月跟着…
具身智能前沿取得重大突破!SuperMimic 或为机器本体扫清算力障碍
10 月 21 日,加州大学伯克利分校(UC Berkeley)团队公开论文《SuperMimic: Scaling Humanoid Whole Body Control with One Differentiable World Mod…
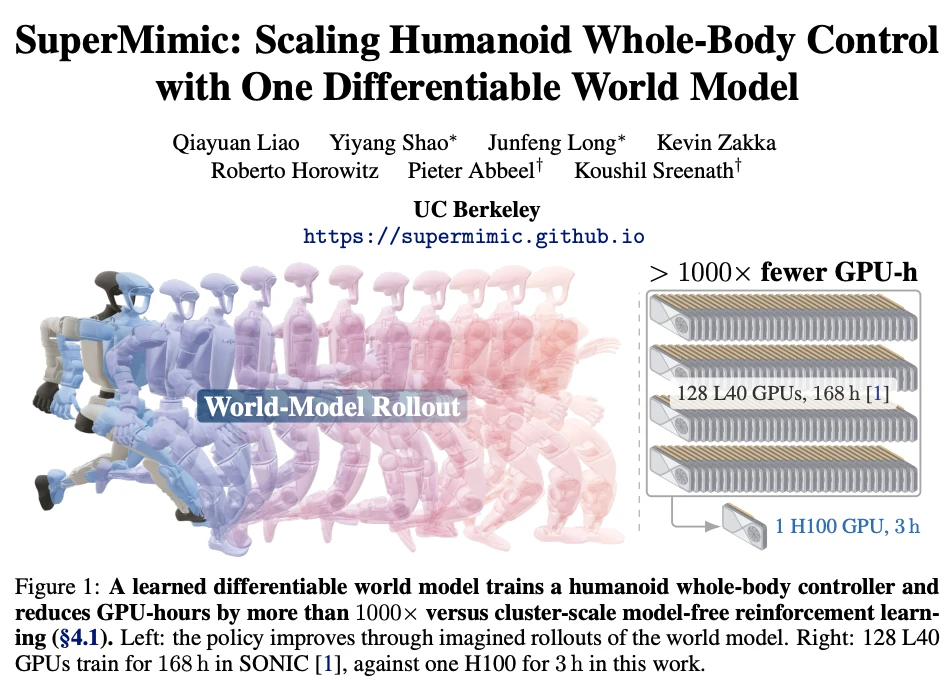
UC Berkeley 团队提出 SuperMimic,单卡训练 3 小时超越 128 卡基线
UC Berkeley 团队提出 SuperMimic,单卡训练 3 小时超越 128 卡基线 人形机器人想要掌握行走、跳跃乃至空翻,背后需要多大的训练算力? 过去的常规做法,是让机器人在模拟器内不断试错,依靠强化学习优化动作控制策略。动作…
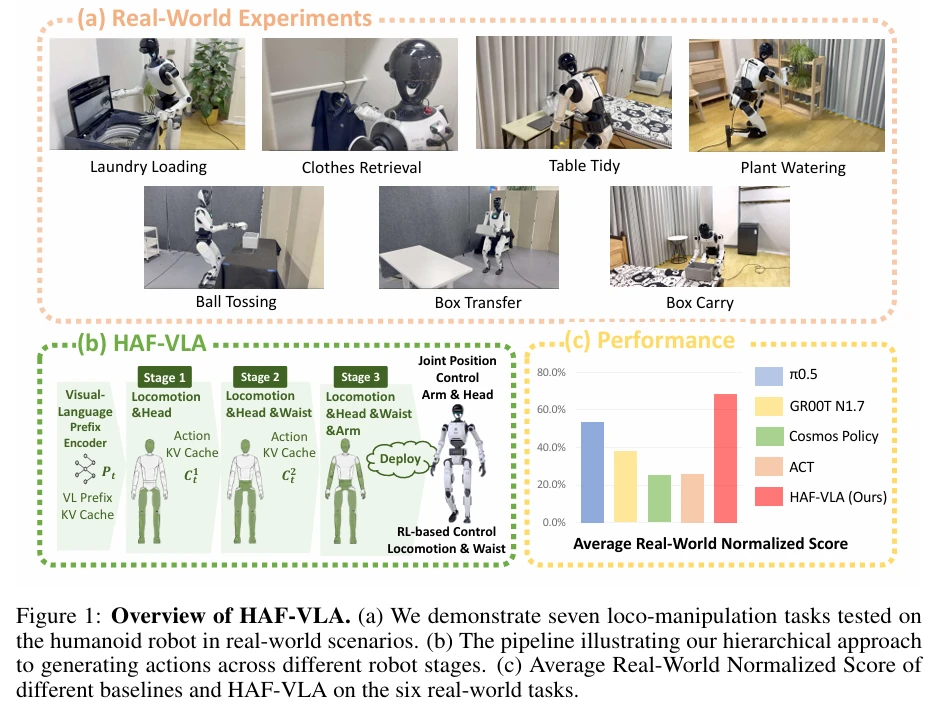
仉尚航等提出 HAF-VLA,让人形机器人分层生成协调的全身动作
仉尚航等提出 HAF VLA,让人形机器人分层生成协调的全身动作 人形机器人要学会自主走向目标、俯身、再伸手抓取,卡点在于全身动作的协同生成。腿、腰、头部与双臂串联在同一条运动学链上:底盘偏移几厘米、腰部角度差几度,手臂就得伸得更远代偿。持…
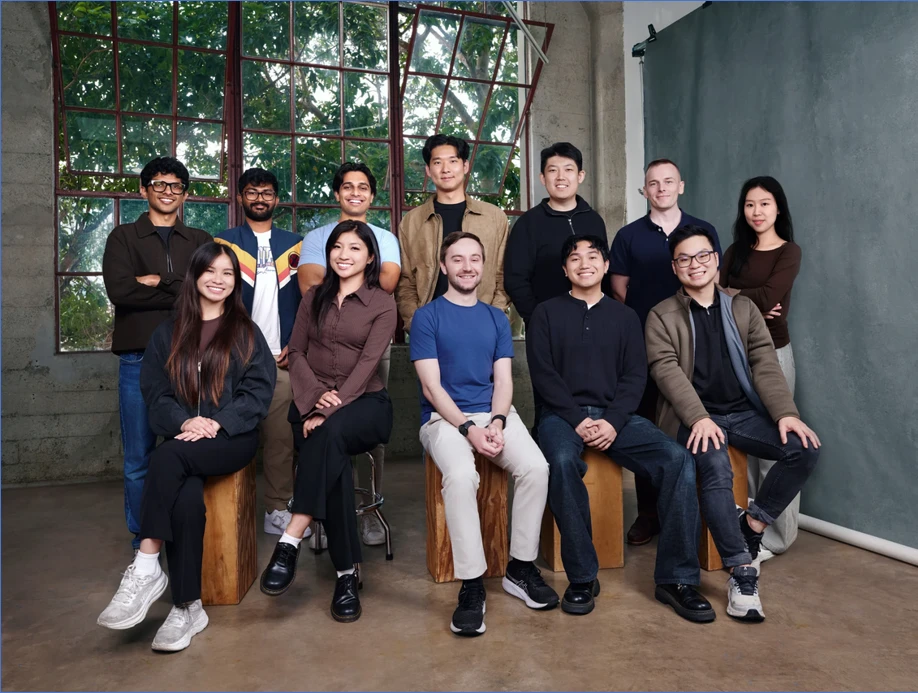
获 9,000 万美元种子轮融资,Dream Labs 同步亮相了新模型
获 9,000 万美元种子轮融资,Dream Labs 同步亮相了新模型 10 月 19 日,机器人 AI 公司 Dream Labs 宣布完成 9,000 万美元种子轮融资,同步推出机器人基础模型 Dream 1 和公开 API。本轮融资…
自然意志物理基模 Natura-1 首次亮相:技术、启发与幕后故事
10 月 13 日,由清华大学电子工程系助理教授、博士生导师丁宁创办的自然意志(Nature Will)发布了成立以来首个通用具身基础模型 Natura 1 及技术报告,引起了业内广泛关注。 这是一个拥有 500 亿参数的混合专家(MoE)…
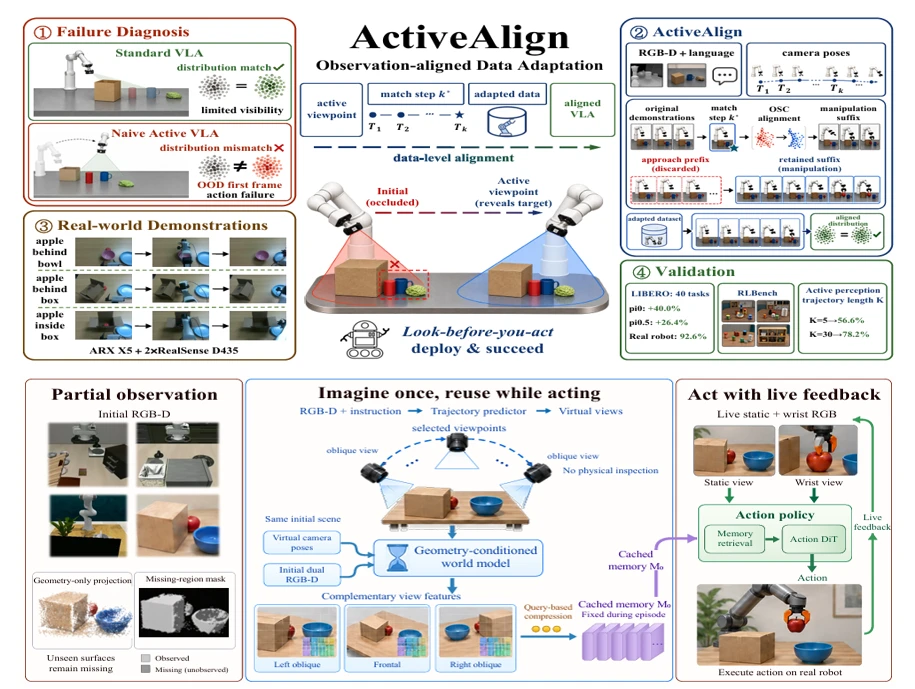
同一天两篇论文,复旦大学付彦伟团队:机器人先行感知,接住新视角下的动作
同一天两篇论文,复旦大学付彦伟团队:机器人先行感知,接住新视角下的动作 机器人伸手抓取被杂物遮挡的杯子,最直观的解法就是转动腕载相机重新观测。但相机转动会同步改变机械臂构型,策略将面临训练期间从未见过的初始状态,图像、位姿与剩余任务之间的关…
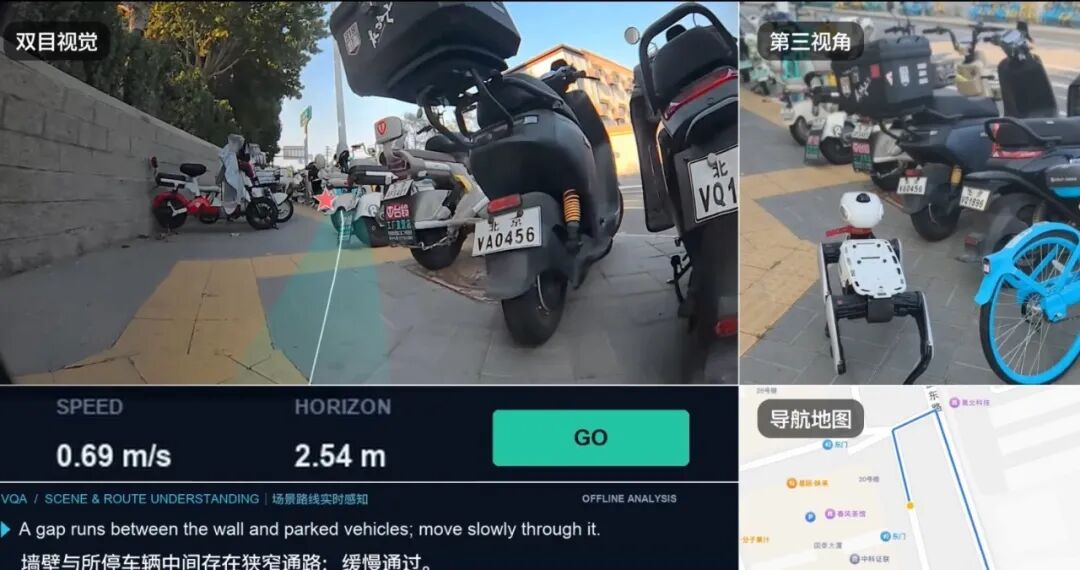
机器人都能跑马拉松了,为什么走到前台还这么难?
机器人越来越会动了。四足机器人爬楼梯、翻越障碍早已不新鲜。今年北京亦庄的人形机器人半程马拉松上,甚至有近四成参赛队伍采用自主导航方式。 但如果终点不是赛道上的冲线,而是某栋写字楼的前台呢? 在 Vbot(维他动力)展示的一段导航演示中,机器…
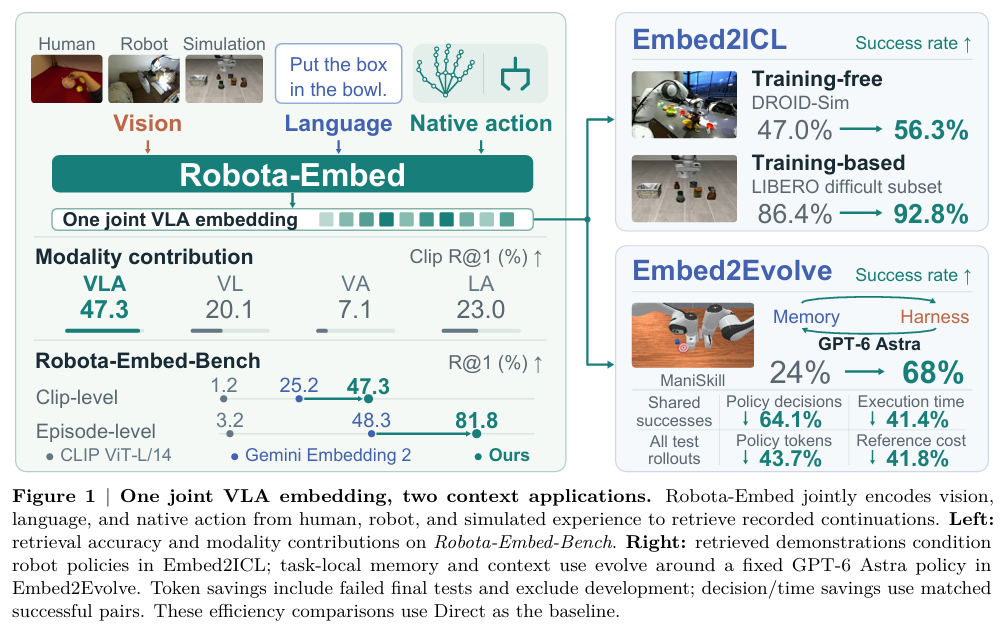
Jim Fan、韩松团队提出 Robota-Embed:机器人检索经验,动作比画面更关键
具身智能机器人想要复用过往操作经验,普遍会检索历史示范视频,模仿曾经成功的操作。 但传统检索大多只比对画面外观:只要桌子、物体看起来一致,就判定是匹配片段,忽略机械手当下的运动方向。同样的纸箱、同一段胶带,封箱和撕胶带两张画面几乎看不出差别…
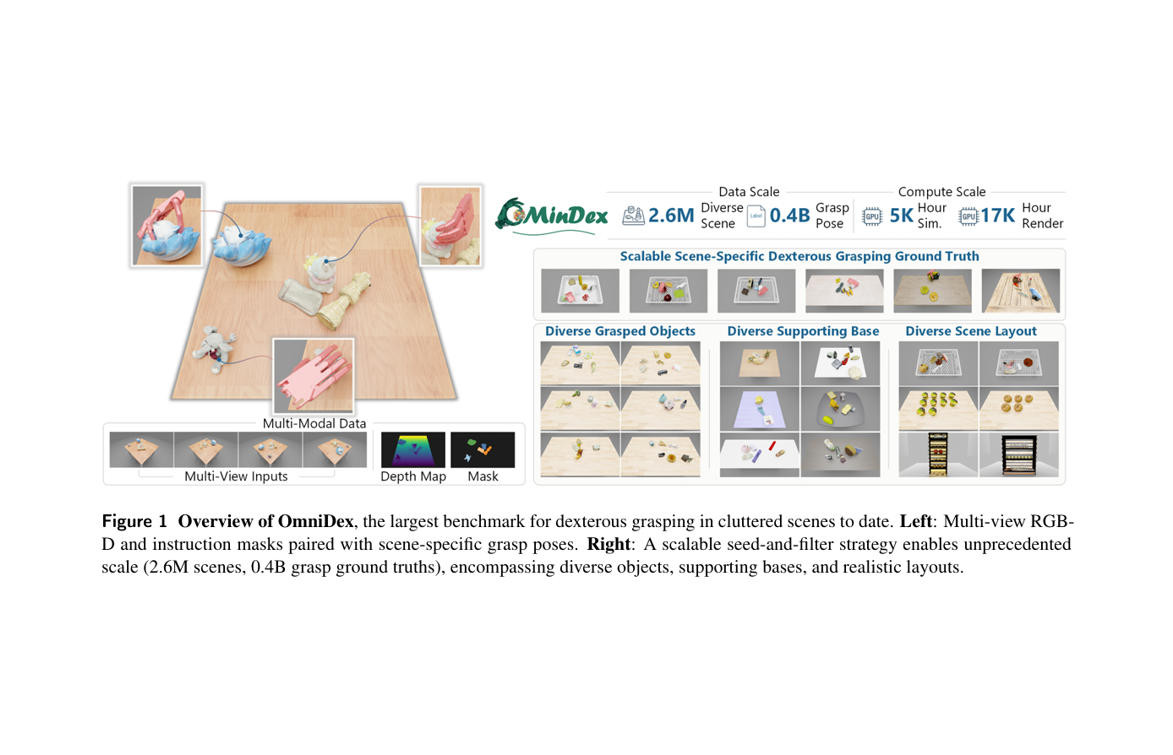
王晓刚、李鸿升团队新作:260 万个场景训练灵巧手
OmniDex 借助可复用种子抓取库搭配碰撞筛选,将杂乱场景下的灵巧手抓取数据集规模从数千个扩充至 260 万个场景、约 4 亿条抓取标注;配套采用软胜者全取学习与物理约束的生成模型,省去推理阶段反复优化抓取位姿的步骤。 10 月 8 日,…
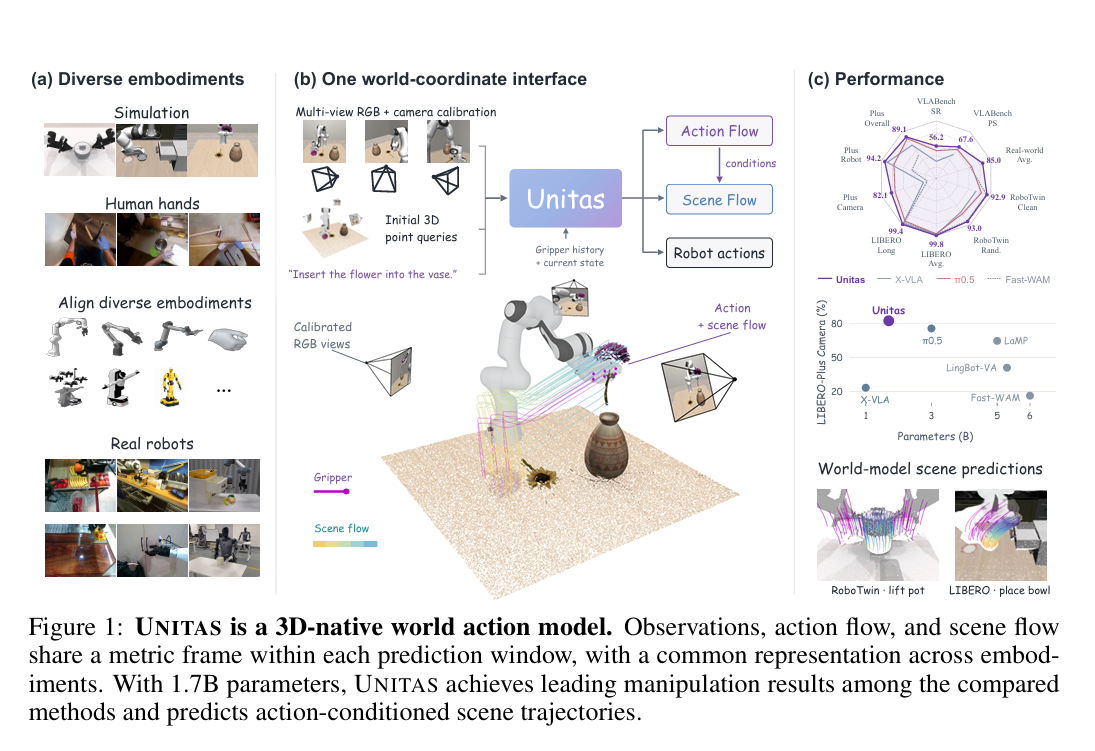
贾奎团队新作:让世界动作模型真正理解三维空间
UNITAS 将观测、动作与场景变化统一至同一个米制三维坐标系:以点轨迹表征人手与夹爪的运动,用场景流描述场景点的位移,让世界动作模型不再单纯依靠图像推测环境演化。模型参数量仅 1.7 B,在 LIBERO 基准测试上取得 99.8 % 任…
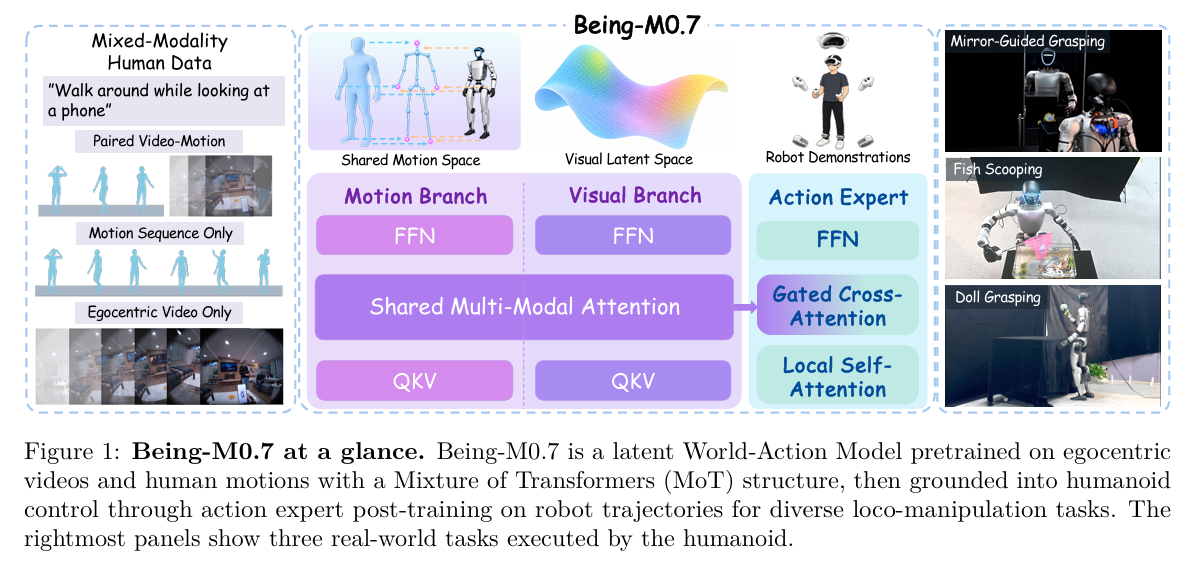
智在无界卢宗青团队提出 Being-M0.7,依托人类视频动作先验,训练人形机器人全身移动操作
Being M0.7 依托一万余小时人类第一视角视频与人体动作数据,学习画面与全身动作的联合先验,再通过机器人轨迹完成中训与动作后训练,输出人形机器人全身移动 + 操作的控制指令。模型在 SIMPLE 仿真基准中综合成功率 71.1%,位列…