共 1 篇相关内容
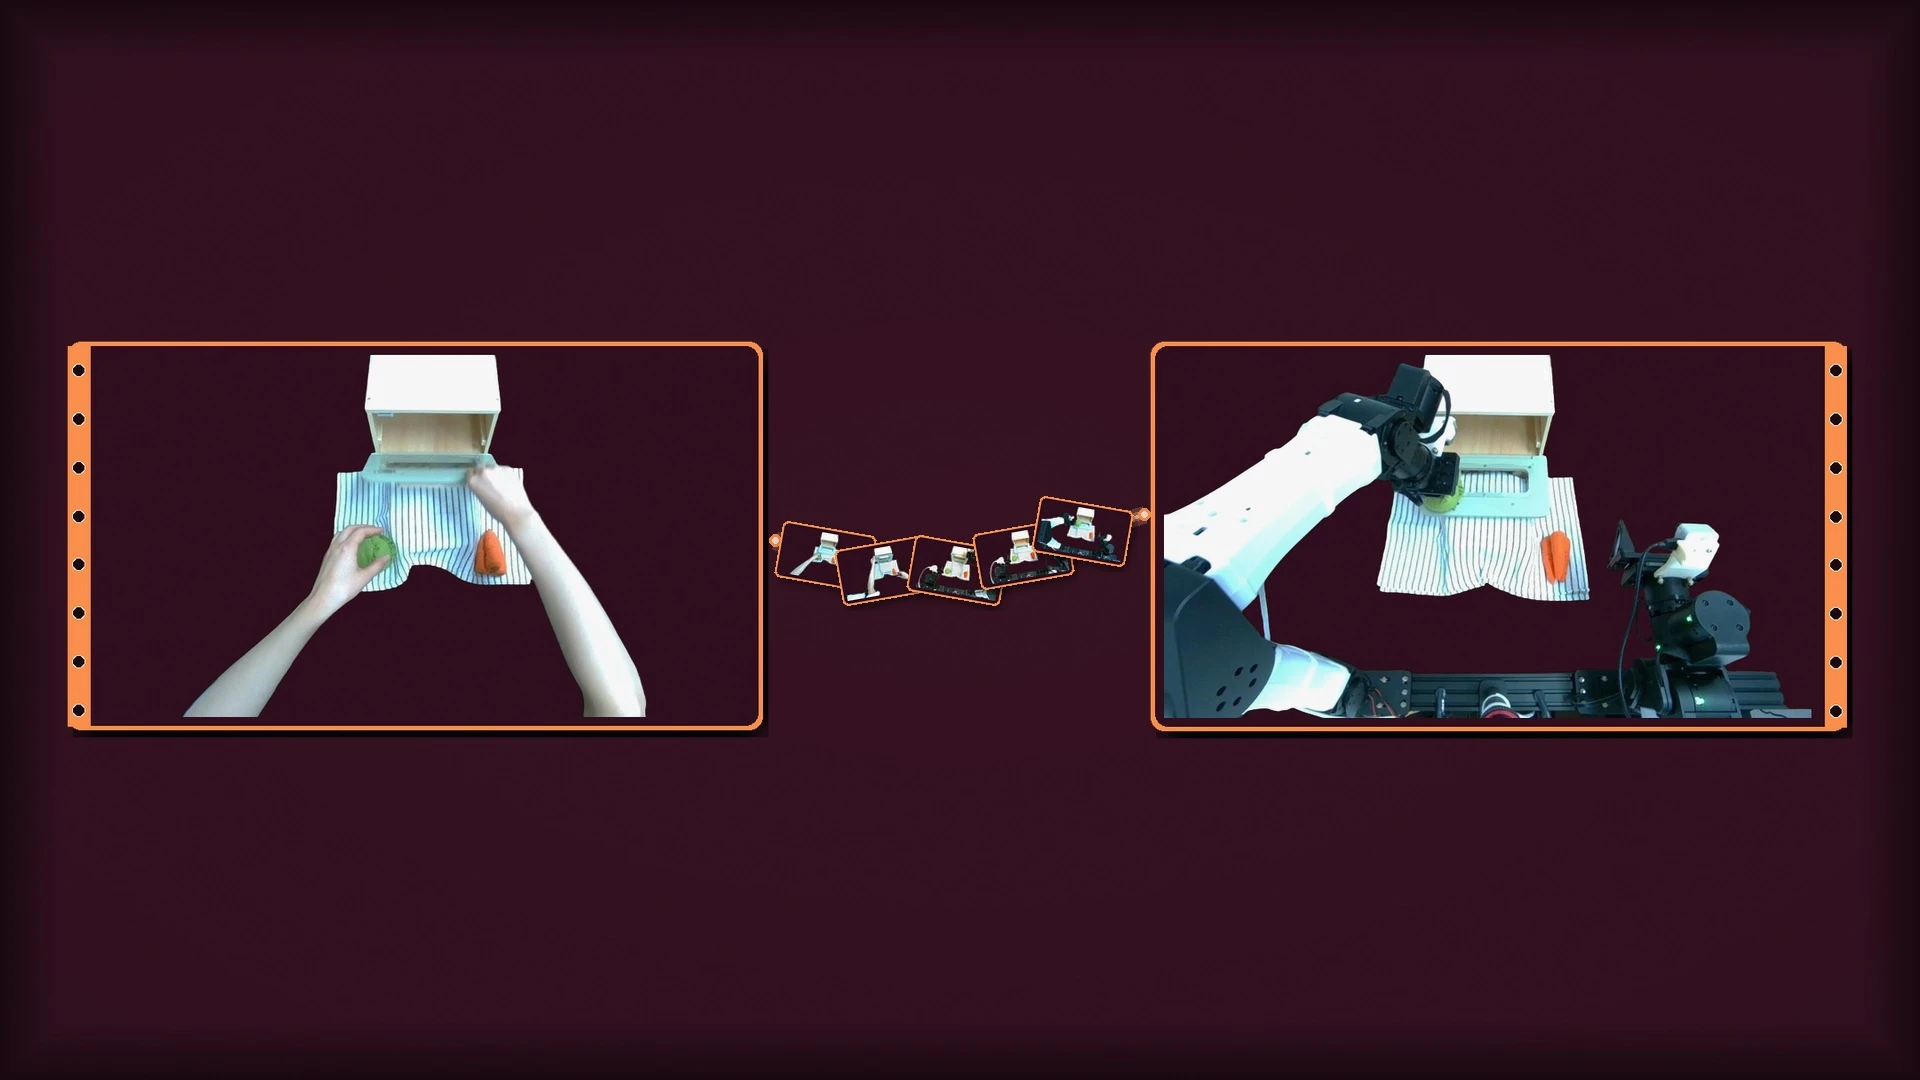
机器人演示采集成本高,覆盖的场景和动作有限。互联网上虽然有大量人类第一视角视频,却零散杂乱,也没有机器人可以直接执行的动作标签。VLA 怎样吸收这些视频里的操作经验? 针对这个问题,英伟达联合 KAIST(韩国科学技术院),于 10 月 2…