

英伟达提出 ThinkWorld,把动作写成链,用想象的未来判对错
作者:江思奇
机器人演示采集成本高,覆盖的场景和动作有限。互联网上虽然有大量人类第一视角视频,却零散杂乱,也没有机器人可以直接执行的动作标签。VLA 怎样吸收这些视频里的操作经验?
针对这个问题,英伟达联合 KAIST(韩国科学技术院),于 10 月 27 日公开论文《ThinkWorld: World Imagination Reinforces Chain-of-Dynamics Reasoning》(ThinkWorld:世界想象强化动力学链推理),提出了 ThinkWorld 这一 VLA 学习框架,该框架能让没有动作标注的人类视频,也能为机器人动作推理提供训练信号。
论文第一作者为 Chaehyun Kim,通讯作者是英伟达研究科学家 Fu-En Yang,其主要研究方向涵盖机器人学习与控制、具身推理。
研究团队将动作构想转化为跨本体的动力学链(Chain‑of‑Dynamics),以「想象的未来」与「真实未来」二者的对齐程度作为强化学习的打分依据,即便视频没有动作标签,同样可以用来监督模型完成推理。
真机双臂 YAM 的实验结果显示,模型分布内任务取得 60/60 的成功率,分布外任务为 52/60,综合 micro 成功率达 93.3%;项目页面汇总统计的分布外成功率约 88.9%,大幅优于各类对照基线。
即便机器人仅学习过零散的原子技能,完整的任务组合只出现在人类视频样本中,模型依旧可以通过单次 rollout 完整跑完整套任务流程。
从动作链到世界想象
机器人的动作一般定义在关节角度、末端位姿这类适配特定本体的控制空间中。这类指令虽可以直接执行,却很难跨不同机器人本体复用,更无法直接对接人类演示数据。
为此 ThinkWorld 引入动力学链(Chain‑of‑Dynamics,CoD):一组离散运动 token,用来描述世界状态随时间的演变,充当人类行为与机器人行为之间通用的推理接口。
团队先把两类动作换算到同一把尺子上。将机器人轨迹与带标注的人手轨迹,统一映射到归一化的末端增量表达,再通过类似 FAST 的运动分词器,切割为共享词表下对应的动力学链 CoD。 视觉‑语言模型结合任务指令、历史视觉信息与当前画面观测,自回归生成这条动力学链。分词过程并不要求人类与机器人的运动学结构完全等同,仅需要二者的运动能够映射至同一套离散词表。训练时间窗口约 1 秒,单手运动为 6 维、双手为 12 维(包含平移与旋转向量,不含夹爪控制)。
仅仅生成动力学链,模型还无法预判这套动作会让世界产生怎样的变化。
研究团队在 CoD 之后接入可学习的未来查询模块。**模型在教师强制给定 CoD 的条件下对查询做上下文编码,再经由轻量化解码器,输出约一秒之后的未来表征。**模型并不在 RGB 像素空间做图像重建,而是在冻结的 DINO 特征空间完成预测。DINO 特征能够保留空间与物体的完整结构,同时弱化外观细节,方便对比环境发生的结构性改变。 观测得到的未来帧仅用于构建监督目标,不会输入视觉语言模型参与推理。
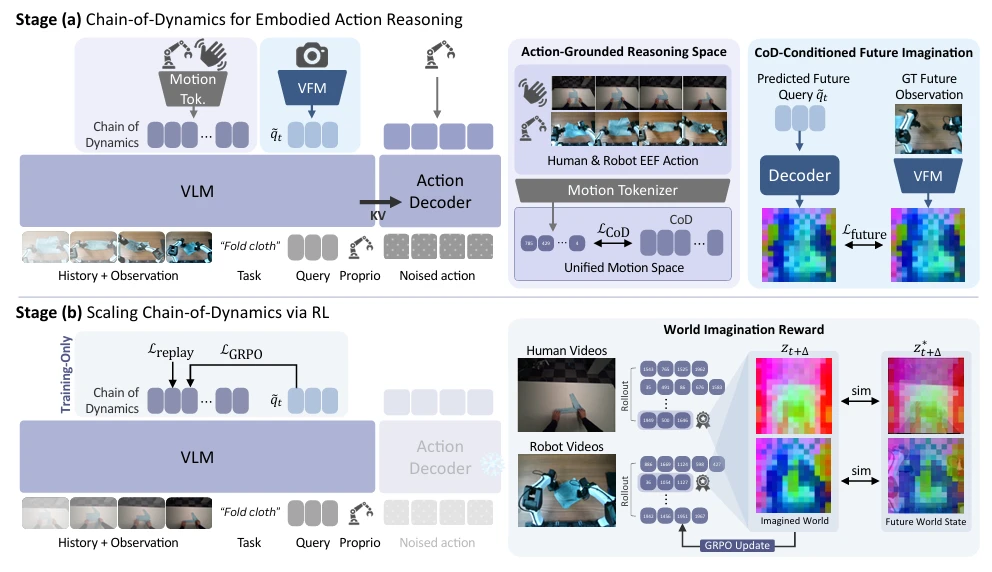
在监督微调阶段,模型同步完成两项学习任务:一是根据观测到的运动生成动力学链 CoD; 二是基于 CoD 预测未来的视觉状态。
实际的连续控制交由动作专家模块完成。该模块接收经过上述两个训练目标塑形后的 VLM 表征,并不会直接解码、使用 CoD token。
两个阶段的冻结方向正好相反。SFT 的后半段适配环节只调动作专家、冻住 VLM 主干;进入世界想象强化学习之后,则只更新 VLM、冻住动作专家。
这套设计把推理规划和底层控制拆分开训练,避免「推理规划」和「实际执行动作」被绑定在同一轮参数更新中。 只要是时序有序的人类、机器人视频,都可以生成未来预测目标,这也为后续实现无动作标签样本打分埋下技术接口。
只靠教师强制训出来的未来预测,模型仍然不会自己去规划抵达该未来所需的中间动力学过程。
**因此研究的第二阶段调整训练逻辑:**在同一个视觉上下文下采样多条候选 CoD,对比每条链生成的想象未来与观测真实未来的匹配程度,对齐效果越好的动力学链,获得的奖励分数越高。
奖励仅依赖视频中观测到的状态变迁,既不需要动作标签,也不需要在线执行这些候选动作。
奖励的计算发生在特征潜空间内。通俗来讲:模型先「脑补」 1 秒 之后的场景结构,再和视频里真实的下一帧做比对;匹配度高则加分,匹配度低则减分。
研究采用加入运动加权的特征相似度计算方式:从当前帧到未来帧变化幅度更大的图像块,在打分时拥有更高权重;同时保留全场景的均衡贡献,避免静止背景主导奖励结果,运动权重全部来源于观测帧。
优化环节使用 GRPO,依据归一化后的世界想象奖励更新 VLM,同时保留监督回放机制,防止模型丢失 SFT 阶段习得的动作物理落地能力。RL 训练过程中其余模块全部冻结;到实际部署推理时,模型既不会生成 CoD,也不再执行未来预测。
两阶段训练与一次推理
这套机制落在具体配置上,用的是 Qwen3‑VL‑2B 主干,动作专家继承自 MolmoAct2,未来表征由 DINOv3 提取。
预训练分监督微调与强化学习两段。团队先用 128 张英伟达 H100 完成 SFT,之后用 64 张英伟达 H100 开展 RL,每次采样 K=4 条轨迹,只更新 VLM。完成预训练后还要针对目标本体做专属后训练,ThinkWorld‑LIBERO 在标准 LIBERO 训练集上适配,ThinkWorld‑YAM 在 MolmoAct2‑BimanualYAM 上适配,两套配置分别消耗 32 张与 64 张英伟达 H100。
训练数据混合人类第一视角视频与机器人演示。人类数据源包含 EgoDex 与 EgoVerse,机器人数据源涵盖 DROID / BimanualYAM、Bridge / RT‑1、BC‑Z、RoboCOIN 等,全部源数据约 76.9 万条 episode、约 4276 小时视频。其中 EgoVerse 与 EgoDex 合计约 1880 小时,占总数据的四成四,这部分数据没有可执行的机器人动作标签。SFT 阶段还混入辅助视觉问答样本,用来缓解灾难性遗忘。
推理这一侧不背训练时的账。CoD 与世界想象只在训练阶段塑造表征,部署时不需要重复运行。单张 H100 上的稳态延迟测试显示,ThinkWorld 的中位延迟约 325 毫秒,峰值显存约 7.07 GiB,优于同等配置下开启思考模块的 MolmoAct2‑Think。
闭环执行时还有一个容易被忽略的细节,模型提前脑补出的下一时刻特征,能不能跟上自己动作带来的真实环境变化。团队用 PCA 投影比对想象中的未来状态与随后采集到的画面,结果显示想象特征可以随环境变化同步更新。这不代表接触类控制问题已经被解决,但说明训练学到的未来表征,面对策略动作引发的分布偏移仍然有效。
真机、仿真与技能组合
真机实验平台采用双臂 YAM,搭载三路 RealSense D405 相机:一路顶视相机,左右腕部分别各布置一路。训练与推理阶段仅使用 RGB 图像。策略在单张 RTX 3090 显卡上完成推理,控制指令统一按照 15 赫兹进行查询与执行。
评测设置三项操作任务:颜色匹配(把水果放进同色碗)、挂杯、分拣。每项任务至少覆盖六种物体配置;分布外场景会修改物体颜色或者物体类别,部分场景还会采用训练阶段从未见过的运动轨迹。每种配置开展 5 次试验。开展任务专项微调之前,会使用经过本体适配后的 ThinkWorld‑YAM 模型做初始化。
对比基线包含 Diffusion Policy、具备显式动作推理能力的 MolmoAct2,以及依靠预测潜视觉子目标来约束动作的 LaWAM。完整分项结果可查阅论文 Figure 3 以及附录 Table 6。
分布内条件下,各类方案表现差距不大,ThinkWorld 在三项任务全部拿到满分:颜色匹配 30/30,挂杯 15/15,分拣 15/15。 进入分布外场景后性能差距显著拉开:颜色匹配 24/30(80%),挂杯 15/15,分拣 13/15(86.7%)。 综合统计,分布内整体结果为 60/60,分布外为 52/60;macro 成功率 94.4%,micro 成功率 93.3%。作为对照,MolmoAct2 的 micro 成功率仅有 60.0%,Diffusion Policy、LaWAM 的成绩还要更低。项目页面汇总分布内 / 分布外成功率为 100 / 88.9,对照组分布外的最高成绩仅为 46.7。
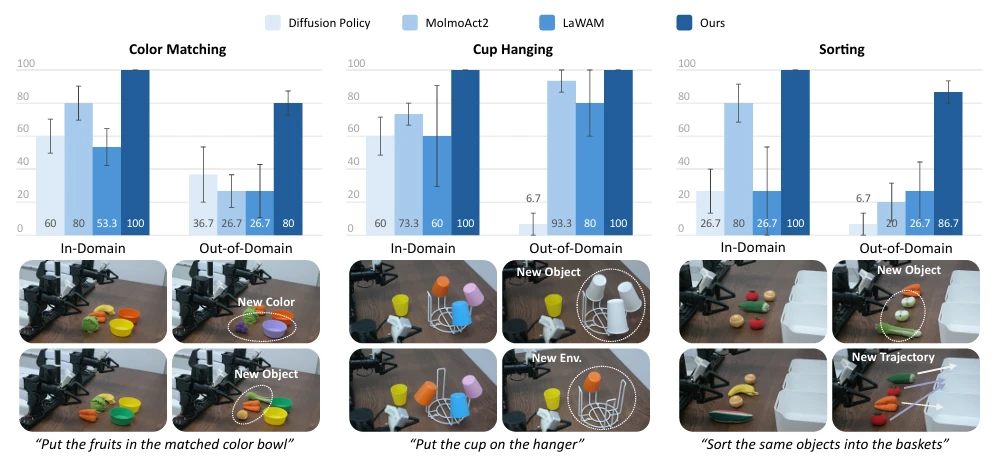
研究团队认为,CoD 推理以动作带来的世界变化作为物理依据,有助于策略抓住颜色、类别这类任务核心属性,灵活调整运动,降低模型死记外观线索、机械复刻轨迹的倾向。分布外仍有失败样本,颜色匹配失手 6 次,分拣失手 2 次。
真机上还有一个更有辨识度的验证点是技能组合。团队搭了一个烤箱任务,机器人演示只覆盖零散的原子技能,包括开、关、把左侧物体放入烤箱、把右侧物体放入烤箱,完整的执行顺序只出现在人类视频里。
普通端到端 VLA 靠机器人动作监督学习可执行控制,整套任务轨迹一旦没在机器人数据里出现过,模型很难从人类演示中拼出完整工序。执行这件事需要机器人认出相关原子技能,维持正确时序,并在技能之间完成切换。
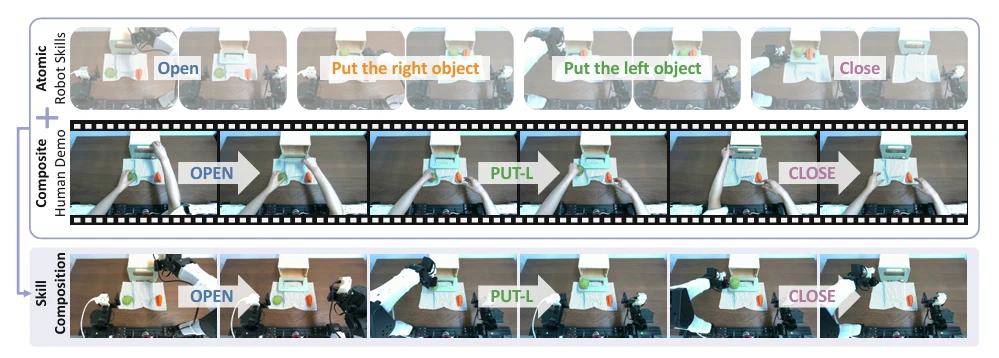
参考人类演示的「开 → 放左 → 关」,ThinkWorld 在一次 rollout 内组合出对应的机器人技能,跑完了整条流程。机器人训练时只接触过技能零件,整套任务的装配图纸来自人类视频,团队把这种迁移归因于人机共用的 CoD 推理空间。
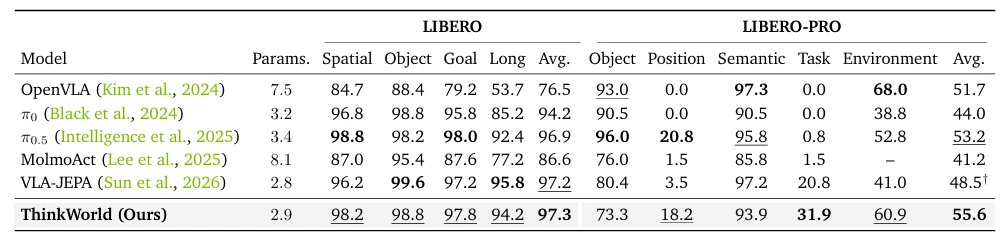
仿真一侧用 LIBERO 与难度更高的 LIBERO‑PRO 两套基准。LIBERO 涵盖空间、物体、目标以及长程任务套件,LIBERO‑PRO 引入物体属性、位置、指令语义、任务目标以及环境层面的可控偏移。ThinkWorld‑LIBERO 只在标准 LIBERO 训练集上完成后训练,随后以零样本方式直接在 LIBERO‑PRO 上评测。
测试数据显示,ThinkWorld 在 LIBERO 的平均成功率为 97.3%,LIBERO‑PRO 达到 55.6%,两项都位列表格内全部模型的首位,模型参数量约 2.9 B。附录给出的 LIBERO‑Plus 零样本结果平均成功率 71.7%,面对机器人初始状态与物体布局的扰动时优势更明显。
在任务偏移与环境偏移两项指标上,ThinkWorld 分别取得 31.9% 与 60.9%,对比同样做潜在世界建模的 VLA‑JEPA 分别高出 11.1 与 19.9 个百分点。
消融以「Qwen 骨干加 MolmoAct2 动作专家」为基线,之后逐步叠加视觉历史、未来预测、CoD 与世界想象 RL。LIBERO‑PRO 的平均成功率从 40.1% 依次涨到 40.7%、50.4%、54.4%,最后到 55.6%。
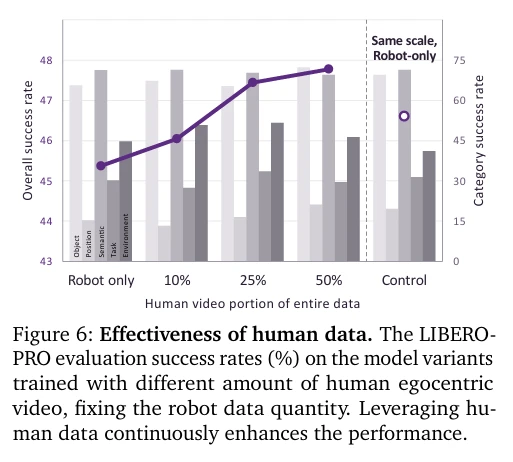
未来预测带来的增益最突出,CoD 继续拉高各个偏移维度下的表现,世界想象 RL 又补强了位置、任务与环境偏移。团队还做了一组对照,保持机器人数据总量不变,不断调高人类视频占比,整体成功率随之持续走高,50% 人类数据的变体还略优于算力相当的纯机器人数据对照组。
放到 SimplerEnv 环境、不做针对性微调的条件下,模型整体 micro 成功率为 46.5%。跨场景迁移的情况以 YAM 真机与 LIBERO 系列仿真测试为准。
特征按运动聚,不按本体分
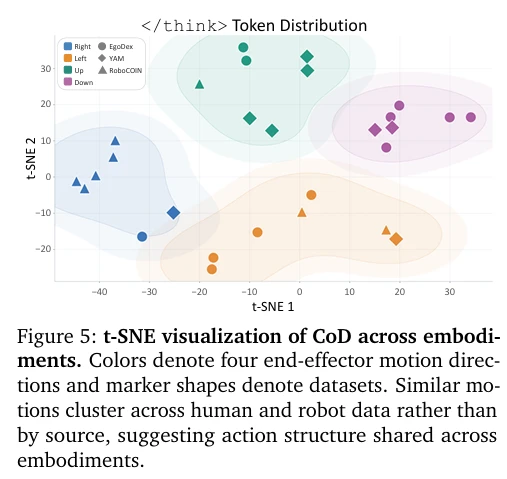
研究先看 CoD 在人类与机器人之间留下了什么。团队取模型末尾思考单元的内部特征做降维可视化,图上不同颜色代表机械臂末端的运动方向,标记形状用来区分数据来自人类还是机器人。运动走向相近的样本聚拢在一起,人类与机器人的数据相互混杂;就算出自同一个数据源,样本也会按运动模式重新划分。模型特征优先围绕动作构建,不被机器人的设备形态束缚。
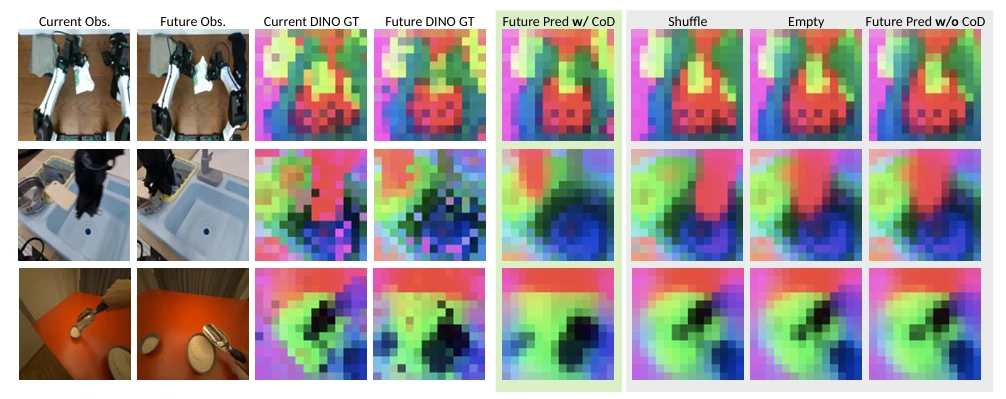
第二组对照测的是未来预测吃不吃 CoD。以模型产出的 CoD 作前置条件,推演出的未来视觉特征更贴合真实环境走向;一旦打乱这条链、传入空链或直接关掉 CoD,预判就容易卡在当前画面,整体匹配相似度随之下降,在变动最剧烈的区域差距更大。注意力可视化也显示,CoD 对应的计算单元优先关注人手、机械臂与被操作物体,很少看静止背景。
把 ThinkWorld 放回整条技术路线里看,它一端对接规模化人类视频,一端面向可落地的机器人策略。隐式动作学习与显式动作重定向是两条并行路线,世界模型与视觉预见能提供动作带来的环境后果信号,过往研究往往直接把未来预测当作控制输出,或只用来做虚拟推演。ThinkWorld 的取舍是训练阶段用后果对齐强化共享的动力学推理,部署阶段舍弃推理与想象,只保留打磨成型的策略网络。
对科研人员而言,这套方案给出了一套可复现的实验范式,统一共享运动词表、基于 DINO 特征做视觉打分、搭配 GRPO,同时控制好人机混合的数据配比。对产业落地来说,高成本的真机整段演示可以用「少量真机原子技能加大量人类完整操作视频」来补充,前提是后训练与任务微调流程能够稳定收敛。
ThinkWorld 用真机分布外 52/60 的成绩,把「用未来想象做奖励打分」从构想做成了一套可对照验证的实验清单。接下来要看的,是它换到更多硬件、更吵的工况里,还能不能维持同样的稳定性。