

具身智能前沿取得重大突破!SuperMimic 或为机器本体扫清算力障碍
作者:王星宇
10 月 21 日,加州大学伯克利分校(UC Berkeley)团队公开论文《SuperMimic: Scaling Humanoid Whole-Body Control with One Differentiable World Model》,论文已被 CoRL 2026 接收为 Oral。SuperMimic 一经发布便引发业界广泛关注,更有同行直呼「震撼」、「权威」。
项目主页:https://supermimic.github.io/
论文链接:https://arxiv.org/pdf/2610.28480
研究核心结论显示,训练人形机器人全身动作所需算力在 SuperMimic 中得到了大幅降低。在 129,514 段人体动作上,SuperMimic 仅用 1 张 GPU 训练 3 小时,就超过了此前最好的方法 SONIC,后者要用 128 张 GPU 训练 7 天。这堪称自由落体式的成本下降。
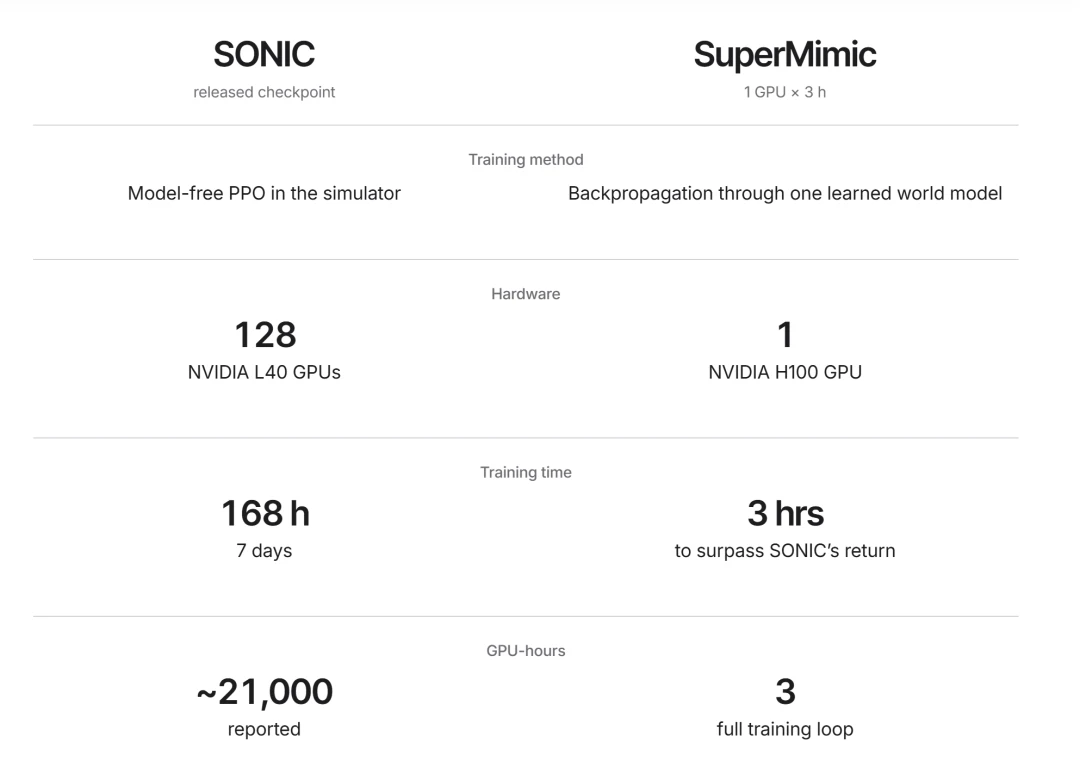
令人震撼的是,SuperMimic 所提出的可微分世界模型(Differentiable World Model)更是把原本需要 GPU 集群投入的训练推进到单卡数小时,并让所得控制器在实体机器人上运行。该项研究的核心贡献在于对机器人全身控制的既有策略实现创新,使用一个可微分的世界模型来为机器动作构建神经动力,并利用标准刚体仿真器记录的状态转移对其进行拟合,分摊不同动作的学习成本,并让世界模型与跟踪策略在同一个循环中共同训练,对短时想象轨迹进行随时间反向传播,从而为策略提供解析梯度、快速想象推演,进而大幅提高训练效率。
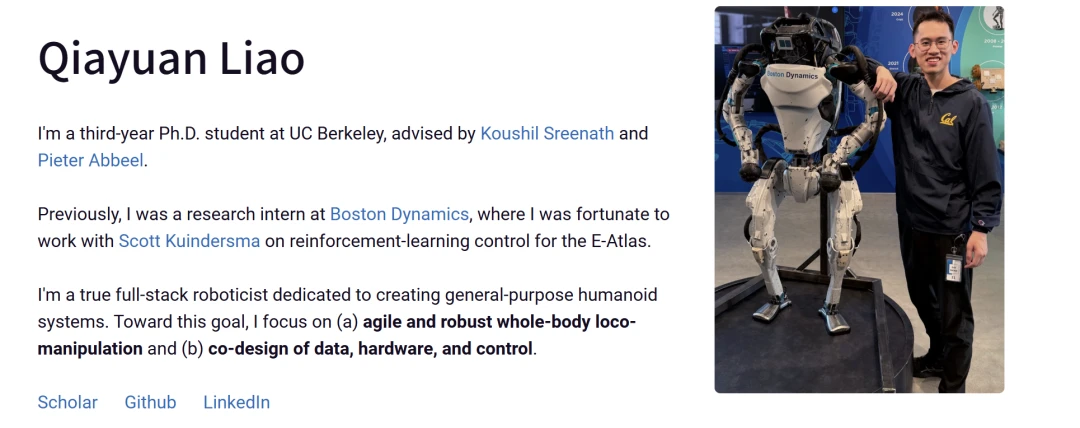
该研究的第一作者为廖洽源,加州大学伯克利分校(UC Berkeley)三年级博士生。其导师为 Koushil Sreenath 与 Pieter Abbeel。此前,廖曾在波士顿动力担任研究实习生,期间与 Scott Kuindersma 合作开展 E-Atlas 机器人的强化学习控制相关工作。研究方向为全身移动操作(Loco-manipulation)与数据、硬件与控制的协同设计。过往主导或参与研究包括 Workhorse、BeyondMimic、Berkeley Humanoid 等,其开源机器人学习框架 MoJoCo Playground 曾获 RSS 2025 Best Demo Paper Award。
廖洽源本人长期致力于打造通用人形机器人系统,SuperMimic 是其在这一目标下最新完成的震撼之作。汇聚可微分策略优化和强化学习的技术思想,**SuperMimic 团队声称「计算已不再是瓶颈」。它的出现可能将为人形机器人全身控制大规模训练扫清算力障碍,一个完整、经济的机器人全身控制方案可能正浮出水面。**若研究得到大规模复现验证,过往业界认定的庞大GPU集群算力将不再构成人形机器人全身控制规模化扩展的瓶颈,这意味着机器本体的训练成本不再因此受到制约。如果能够将其扩展至带感知的机器全身控制和行走,SuperMimic 将是具身智能领域最新的一次重大技术突破。
人形机器人怎么控制
SuperMimic 的研究对象,是让一个控制器跟踪大量参考人体动作。参考动作告诉机器人接下来应该怎样移动,控制器则必须根据自身状态,持续输出关节指令,把动作真正做出来。它与只会播放预设关节轨迹的程序有本质差别,身体一旦偏离目标,控制器需要调整后续动作,兼顾跟踪和稳定。
要让人形机器人有望在人类设计的环境中工作,需要它的全身控制器能够覆盖多种人体动作,从行走、舞蹈到下蹲和平衡恢复。在现有的研究中,主要通过两种方式扩展这一思路。要么,把大量针对特定片段的专家模型蒸馏成一个控制器,要么在大规模动作库上训练一个通用策略。两种情况下,更多样化的动作库都能为机器人带来能力更强的表现。
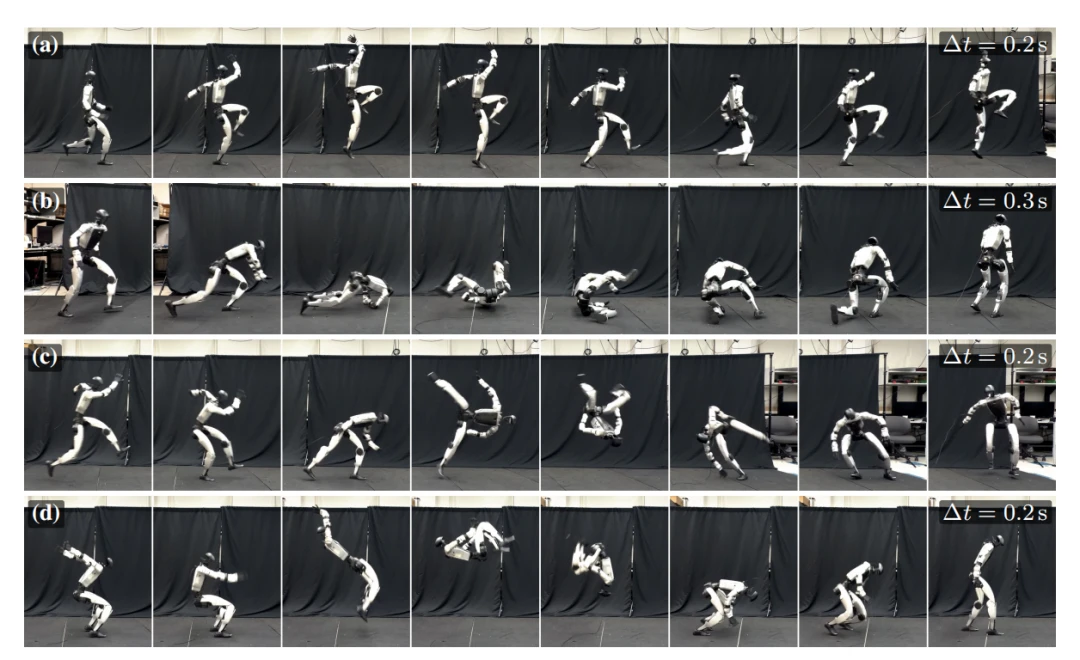
但随着动作覆盖范围扩大,两种方式的底层机制决定了计算成本的不断攀升。例如,采用先进跟踪器 SONIC 在 128 张 GPU 上训练所花费的时间约为 168 小时,合计时间约 21,000 GPU 小时。尽管参考动作各不相同,但由于它们共享同一个本体动力学,底层机制反复通过带噪声的仿真轨迹来估计动作后果。因此,无论是人形机器人的侧身翻滚、腾空翻转,到稳稳落地,镜头里的几秒钟背后可能是庞大 GPU 集群持续数日的训练。怎样让机器人的每一个关节及时配合,怎样在脚掌、手臂或躯干接触地面时保持动作连贯,这些看似属于机械结构的问题,也长期消耗着强化学习系统的算力。业界观点一度认为,扩展机器人的动作数量、实现泛化也就意味着算力投入必须扩大。
其实不然。
**关键在模仿。**SuperMimic 基于物理的动作模仿形成强化学习(RL)策略,并通过跟踪从大型动作捕捉(mocap)数据集中提取的参考动作片段来解决这一问题。它利用仿真器记录的状态转移,拟合一个统一的、可微的世界模型,以解决过往的低效率问题。通过短时想象轨迹进行随时间反向传播(BPTT),机器人即可沿着学得的模型获得解析策略梯度,使一个动力学模型在整个动作捕捉库中分摊学习成本。由于这些梯度来自学得的模型,SuperMimic 仍然兼容刚体仿真器,其中也包括采用非光滑接触或不可微实现的仿真器。
How Policy Works?
强化学习把这种协调问题转化成反复试验。策略接收身体状态和目标,输出动作,仿真器计算动作的物理后果,奖励函数评价身体位置、朝向和速度是否跟得上参考动作,同时遏制过大的控制变化和关节越限。策略通过训练逐步提高累计奖励。所谓「学会一个动作」,就是在许多连续时刻找到能兼顾当前跟踪和后续稳定的关节配合方式。以常用的无模型强化学习算法 PPO 为例,策略主要依据采样轨迹和回报估计,判断哪些行为值得增加、哪些应该减少。这个办法能够成功,但机器人要为每一种复杂动作反复经历大量试错。
SuperMimic 的控制器仍然需要学会这种协调。它把输入目标压缩成一个 32 维的动作潜变量,再结合最近十帧的本体感觉,通过共享解码器生成 29 维关节动作。本体感觉包括关节位置、关节速度、惯性测量信息和上一时刻的动作。历史信息让策略能从一小段身体变化中作判断,而不只是对一张静止「姿态照片」作反应。
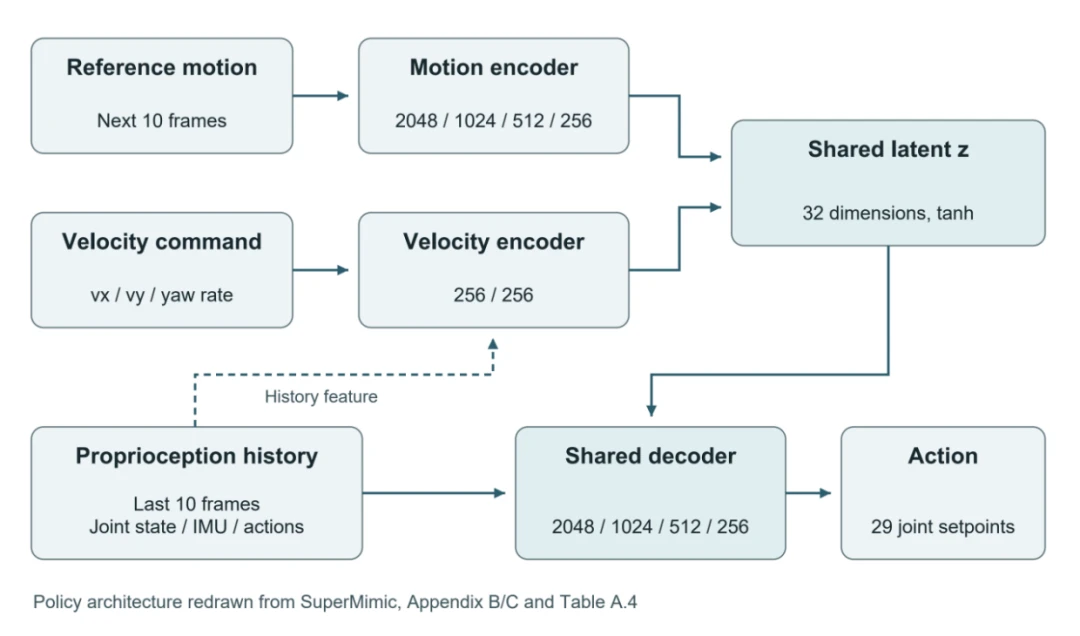
如图所示,SuperMimic 的动作参考编码器与初步研究中的速度指令编码器共享动作潜空间和解码器,速度编码器还接收身体观测历史的特征。另有一个可微分世界模型参与配合训练,部署时无需将它作为在线规划器随身运行,最后综合构成控制策略结构。
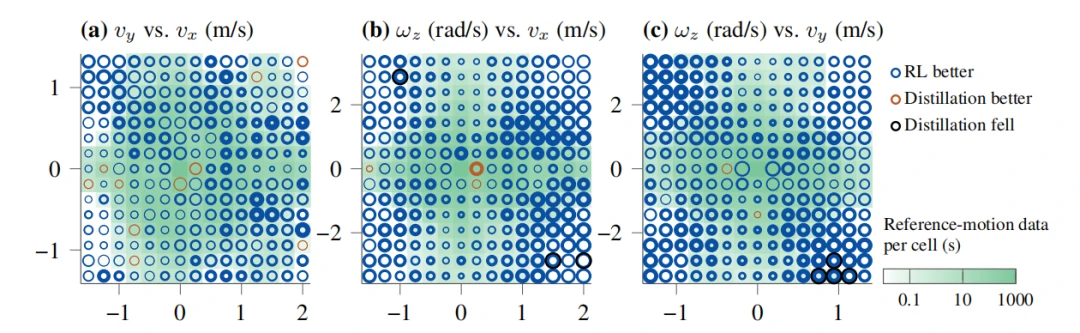
相较于蒸馏基线,采用经强化学习训练的速度编码器能更精准地跟踪步态指令。每个子图均为指令空间的二维切片(第三维度设为零),每个环形区域代表一条指令;外圈区域的面积与该指令下两种策略的相对稳态误差中较大值成正比,内圈区域的面积则与较小值成正比,颜色标记表示性能更优的策略。同一模型可直接基于速度接口自身的任务奖励进行下游训练。如今,仅需每轮运行使用一台 GPU,即可对运动跟踪的缩放规律进行量化评估。
默认的动作接口读取接下来十帧参考动作,经动作编码器形成潜变量。论文还初步研究了另一种入口:把前进、侧移和转向速度指令,与身体观测历史的特征一起送入速度编码器,两个入口可以使用同一个动作解码器。这种设计的意义,是把「想完成什么」和「如何协调这具身体」部分分开,使后续接口有机会利用已经学好的动作能力。控制器输出的数值还需要转换为电机能执行的目标。论文采用如下关系:
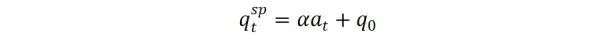
策略输出、动作缩放以及基准关节姿态综合构成底层控制器的关节目标位置参考。模型神经网络决定关节部分接下来往哪里行动,底层控制器则负责把这个目标变成连续的电机作用,并不需要在每次输出时都直接求解一遍完整的刚体接触方程。
共享世界模型
SuperMimic 把共享的身体规律单独学成一个世界模型,以控制人形机器人如何运动、怎样接触地面,以及执行某个动作后会进入什么状态。实际上,这个世界模型并不是凭一段文字就生成任意现实场景的通用视觉模型,且它需要与策略相互配合,把状态、实际执行的动作和后续结果存入回放缓冲区。模型从这些记录中学习预测身体运动,再在自己预测的短轨迹上帮助策略改进。策略变好后继续回到仿真器采集数据,模型也随新数据更新,形成循环。
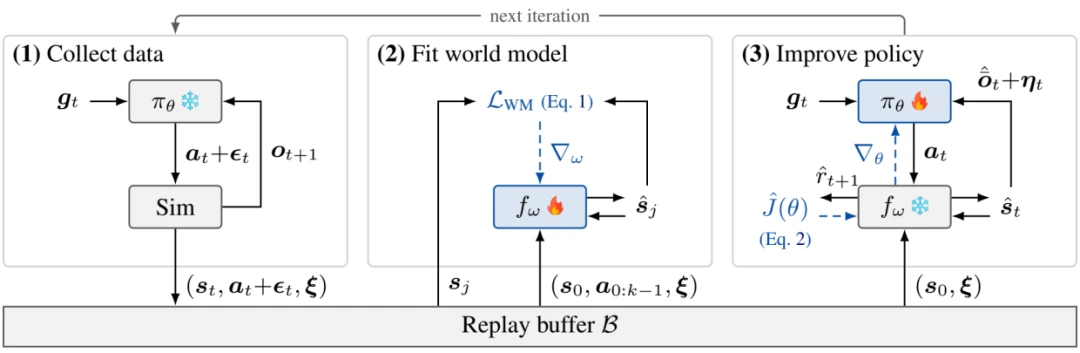
世界模型在每轮训练中都会更新。固定模型只发生在一次策略优化内部,让策略面对相对稳定的预测环境。与此同时,模型学习所需的仿真轨迹,仍由物理仿真器提供。为了使想象可信,模型不能只把下一帧猜准。SuperMimic 从已有状态出发,沿着记录中的动作连续预测八步,再将预测与仿真记录逐步核对。
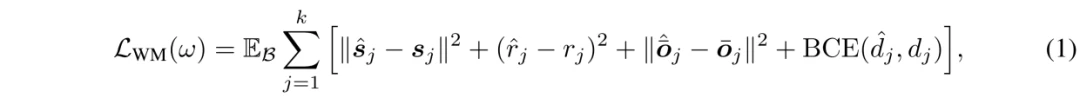
实际部署中,模型不能每次都依靠仿真器提供的正确状态重新起跑,按照自己预测出来的状态往下走,直到造成大量错误累积。因此,在多步展开中匹配状态、奖励、无噪声观测和终止标签,削减不同类别的误差就非常必要。式中的四类误差分别对应四个实际问题,即身体会不会被预测到错误位置,这个动作会不会被错误地打高分,策略接收到的本体感觉是否合理,以及模型能否判断动作已经失败。世界模型能通过它来约束「自己预测出来的状态能否继续作为下一步输入」时的误差,迫使模型适应自身的小误差,帮助后续多步想象保持稳定。
此外,模型还接收每个仿真回合的环境与机体参数,例如摩擦、关节校准偏移和躯干质心位置。这样,网络可以在给定条件下学习较清楚的动力学关系,不必把已知的噪声来源都混为一谈。实体部署时,策略只使用带噪声的本体观测和目标,不要求得到仿真训练时的这些特权参数。
对提升训练效率更关键的一点,是这个世界模型可以求导。在改变某个关节指令后,模型不仅能预测身体会怎样变化,还能通过导数给出“动作往哪个方向改,预计回报会增加”的局部信息。误差沿预测轨迹倒着传播,依次追溯到前面的动作和策略参数,简称时间反向传播(BPTT)。
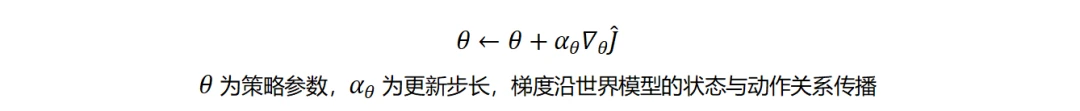
当然,「固定世界模型」并不等于停止一切梯度。策略更新时不改变模型自己的权重,但仍利用模型输入与输出之间的导数把远一点的奖励变化传回动作。比如一次落地不稳,训练得到的信号不只判定最后一步,而可以追到起跳前的关节配合,进行过程性追溯。
这一处理也绕开了直接对仿真器求导的困难。现实接触包含碰撞、摩擦和支撑切换,仿真软件未必提供适合反向传播的实现。SuperMimic 保留标准仿真器作为数据来源,把策略梯度放到学得的神经模型中计算。导数因此属于物理仿真的学习替身,其准确性依赖模型覆盖的数据与训练质量。
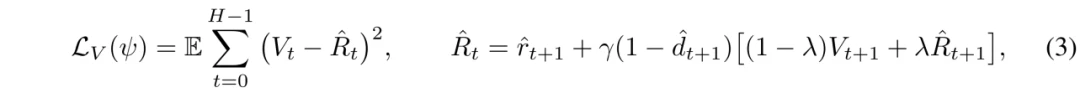
但想象越长,模型误差就越可能积累,反向传播也越费计算。SuperMimic 默认只展开 32 个控制步。在 50 Hz 控制频率下,这只是 0.64 秒。为了让策略顾及这段短窗口之后的后果,系统另外训练一个价值网络,也称 Actor-Critic,估计未来还能获得多少回报。
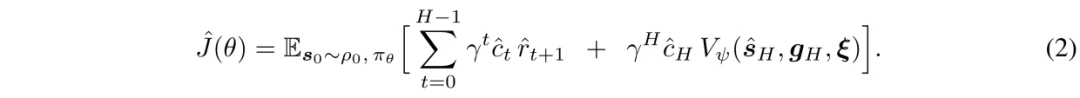
**作为 SuperMimic 策略优化的核心目标,这种算法为模型在自我想象中逐渐优化本体提供了参照。**前半部分累加短轨迹内的折扣奖励,最后一项由评论家估计窗口结束之后的价值。简单来说,该算法式的前半部分负责判断「眼前这段动作做得怎样」,而后半部分则用于判断「做完以后,还留下多好的继续行动条件」。其中,一部分参数调整未来回报的权重,另一部分根据模型预测的存活概率降低失败后轨迹的贡献。它能让机器人在模型里试着自己动一小段,评估这段动作好不好,再估计后续表现。Action-Critic 让机器人动作执行能够在推理中保持稳健,仅勉强完成任务难以蒙混过关。
上述机制综合叠加构成 SuperMimic 的主要技术思想,即所有动作共用一个不断更新的动力学模型,在短轨迹上获得策略梯度后,再用价值估计补足短窗口之外的后果。SuperMimic 的创新价值,正在于把过往强化学习、PPO、SuperTrack 等得到初步验证的机制组织成能覆盖大规模人形动作库,提供能够迁移到实体机器人的完整、经济的方案。
惊人表现
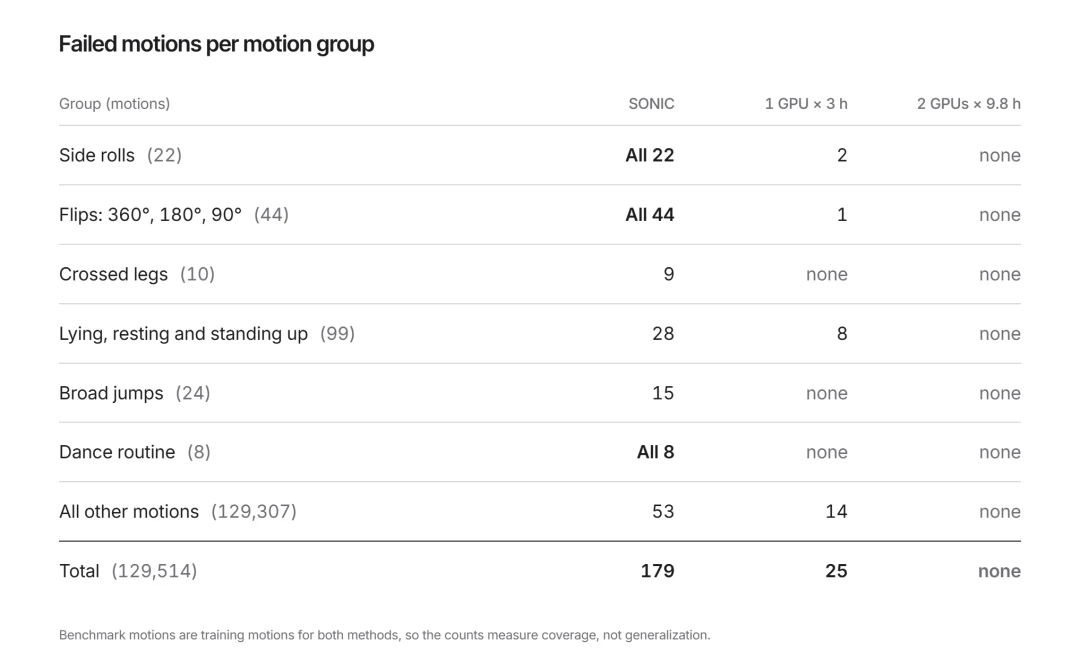
**SuperMimic 最突出的数据是性能和训练效率的双重飞跃。**在单张 GPU 上,SuperMimic 在 3 小时内的训练效率即超越 SONIC ,GPU 小时消耗降低超过 1000 倍。在包含 129,514 个动作的基准上,SuperMimic 单卡训练 3 小时后有 25 个动作失败,双卡训练 9.8 小时后实现任务 0 失败的惊人成绩。
值得注意的是,当数据集时长增加至原先的数百倍时,世界模型的预测误差保持稳定,SuperMimic 达到固定回报所需的算力竟然仅出现缓慢增长,学得的策略能够迁移到实体 Unitree G1。在对下游接口的初步研究中,通过 RL 训练的速度编码器优于蒸馏基线。这意味着人形机器人全身控制的训练成本得到大幅降低,且不必受到 GPU 算力约束。
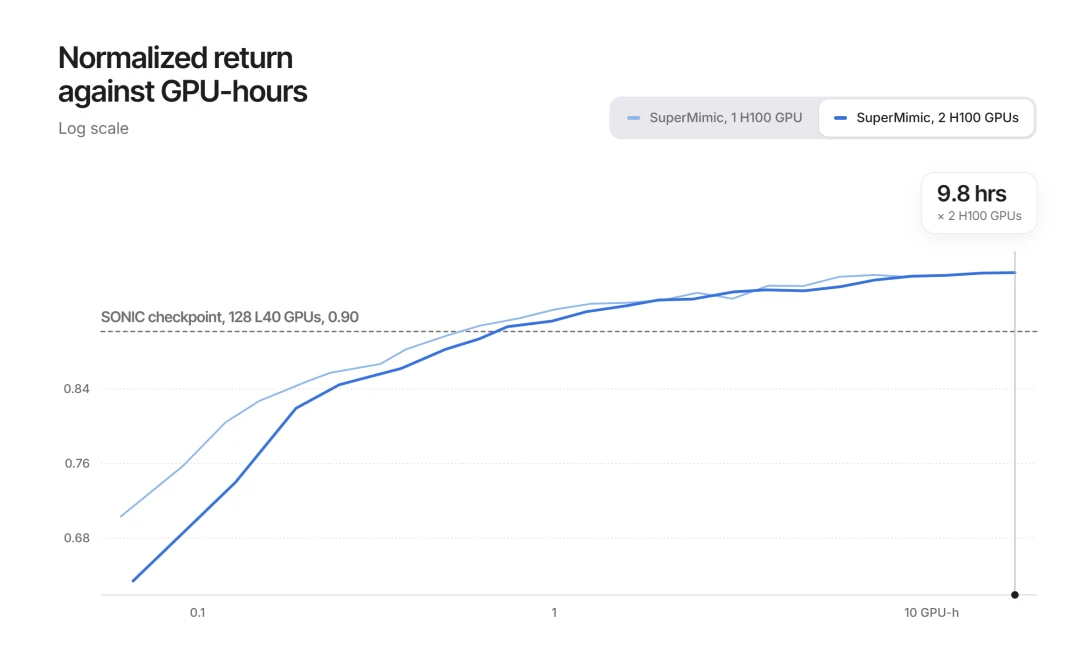
此外,与百卡集群的计算比较也佐证了 SuperMimic 对训练效率的提升。研究者固定 40 段、合计约 2.45 小时的动作,尽量保持观测、奖励、终止条件、随机化和策略网络规模一致。SuperMimic 用一张 H100,在约 1.2 小时达到 0.82 的评估回报,而与此相较,仿真器里的 PPO 在 18 小时预算内仍未达到这一水平,其单卡、四卡和八卡配置的最终回报分别约为 0.60、0.70 和 0.72。它意味着训练效率得到了飞跃式提升。
为什么能省下这么多计算成本?
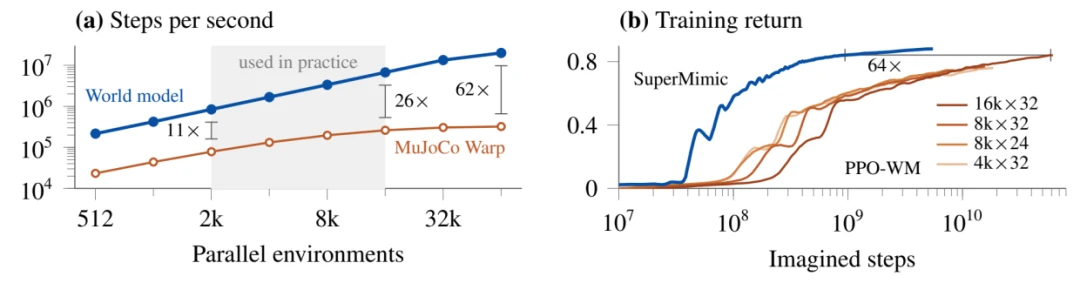
首先是每一次练习变便宜了。在实际使用的并行批量范围,神经世界模型生成轨迹的吞吐量比 MuJoCo Warp 高十倍以上。标准仿真器每一步都要处理刚体和接触计算,训练好的神经网络则把这些状态变化近似为一次网络计算。其次,达到相应成绩所需的练习步数减少了。在同一个世界模型中,研究者比较解析梯度更新与继续使用 PPO 的策略优化:前者约用后者 1/64 的想象步数,就达到 PPO-WM 的最佳训练回报。这项测试说明收益并非全部来自「更快的仿真替身」,策略还更有效地利用了动作后果的信息。
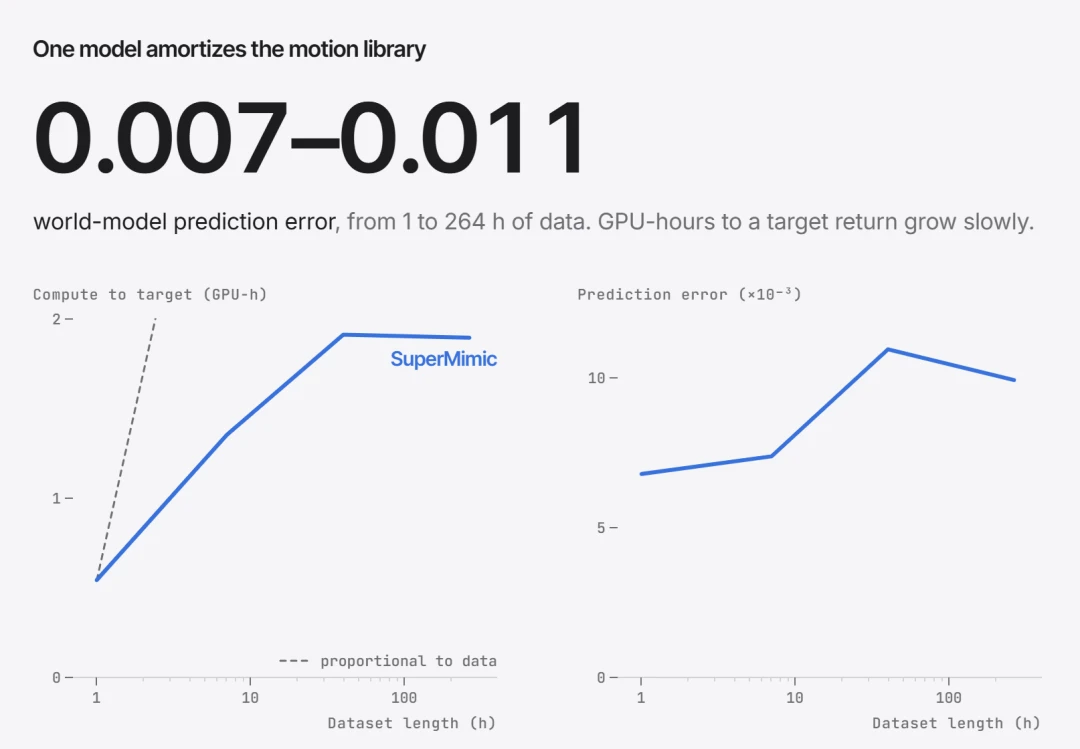
如图所示,当训练动作从 1 小时增加到 7 小时、40 小时,再到约 264 小时,世界模型的八步预测误差仍处在约 0.007—0.011 的窄区间,到达目标回报所需的 GPU 小时增长也较缓慢。
它真正有启发性的地方,是动作多了两百多倍,同一具身体的动力学所需的计算资源并没有因此呈现暴涨。不同动作提供的数据,能够共同训练共享模型,新增动作因此有机会利用已经建立的身体规律。不过,这些数据点还不足以保证任意数据规模下都保持同样趋势。当加入新地形、物体和接触形式时,共享模型面对的问题也会改变。
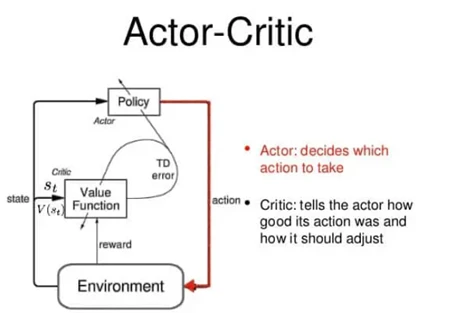
Action-Critic 的一般作用是把「学得快」和「动作后续是否稳定」联系起来。消融实验中,带 Critic 的 16 步想象可以更快达到预期表现。比如,在仿真推扰实验中,受到 0.5 — 4 m/s 的根部速度扰动后,带 Critic 的策略约在 0.5—2.4 秒内恢复稳定,而缺乏 Critic 监督时,机器人则出现持续踉跄,在较大扰动下跌倒的情况。这说明终端价值不仅改变训练曲线,还与短窗口之后的恢复行为有关。
共享控制能力也初步延伸到速度接口。在 672 个速度阶跃响应中,利用任务奖励训练的编码器在 650 个响应上的误差低于蒸馏基线;相对误差中位数为 0.16,对照为 0.49,约下降 67%。直观地说,已有身体技能并不一定只能照抄参考动作,还可以通过新的指令入口重新组织动作。
它们分别说明,模型可以降低每次练习的成本,可微分优化可以减少所需练习量,共享动力学有助于吸收更大的动作库,短窗口加价值估计可以兼顾计算与后续稳定。这些证据共同支撑了本体训练效率的重大突破。
社群热议,焦点在哪?
**论文一经发出,即在中国与美国具身智能领域社群中引发热议。**热议的焦点在于对该项研究取得突破的认可、强化学习的发展历程,以及仿真器选型、复现工作和部分异议等。
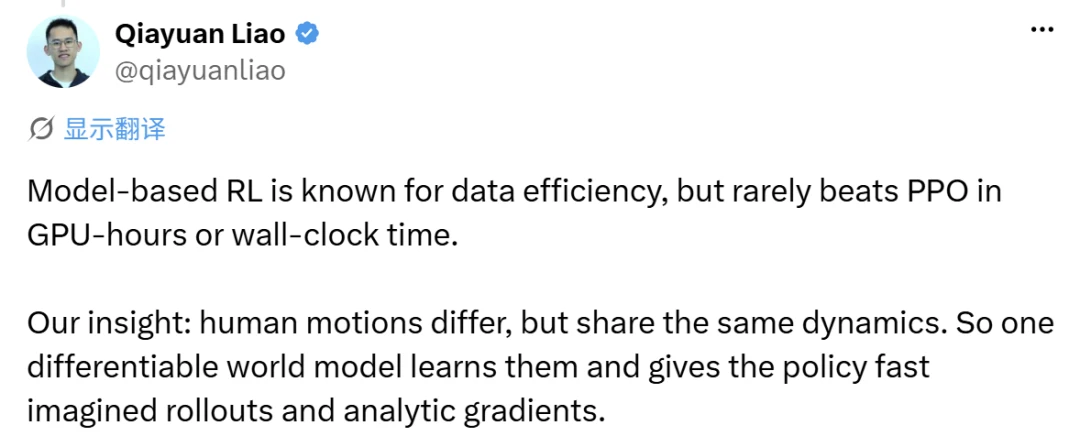
第一作者廖洽源公开表示,SuperMimic 反映出的核心技术思想在于某种同一性。人的动作各不相同,但背后的动力机制是相同的。找到这样的机制并予以形式化,让世界模型快速习得它们并能快速驱使策略运转,那么训练不同参考动作需要的成本障碍很可能不攻自破。参与开发过 MuJoCo Playground 的共同作者 Kevin Zakka 称,SuperMimic 是仿真器和世界模型相互配合的绝佳范本。
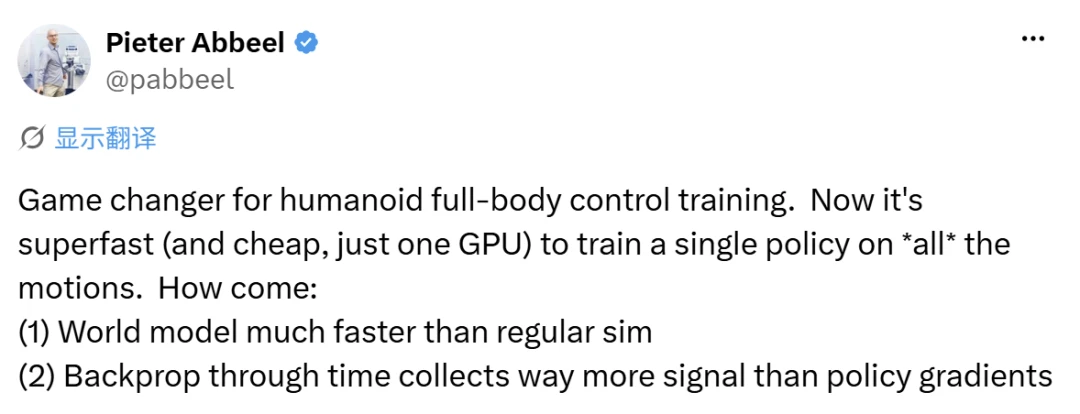
廖洽源的其中一位导师 Pieter Abbeel 在转发中发表评论,肯定了SuperMimic 对人形机器人全身控制的价值可能足以改变整个游戏规则,并称「人形全身控制训练的游戏规则改变了。现在用一个策略即可学会动作,训练又快又便宜,只要一张 GPU。原因有两个:世界模型比常规仿真器快得多;沿时间反向传播拿到的学习信号,比策略梯度多得多。」
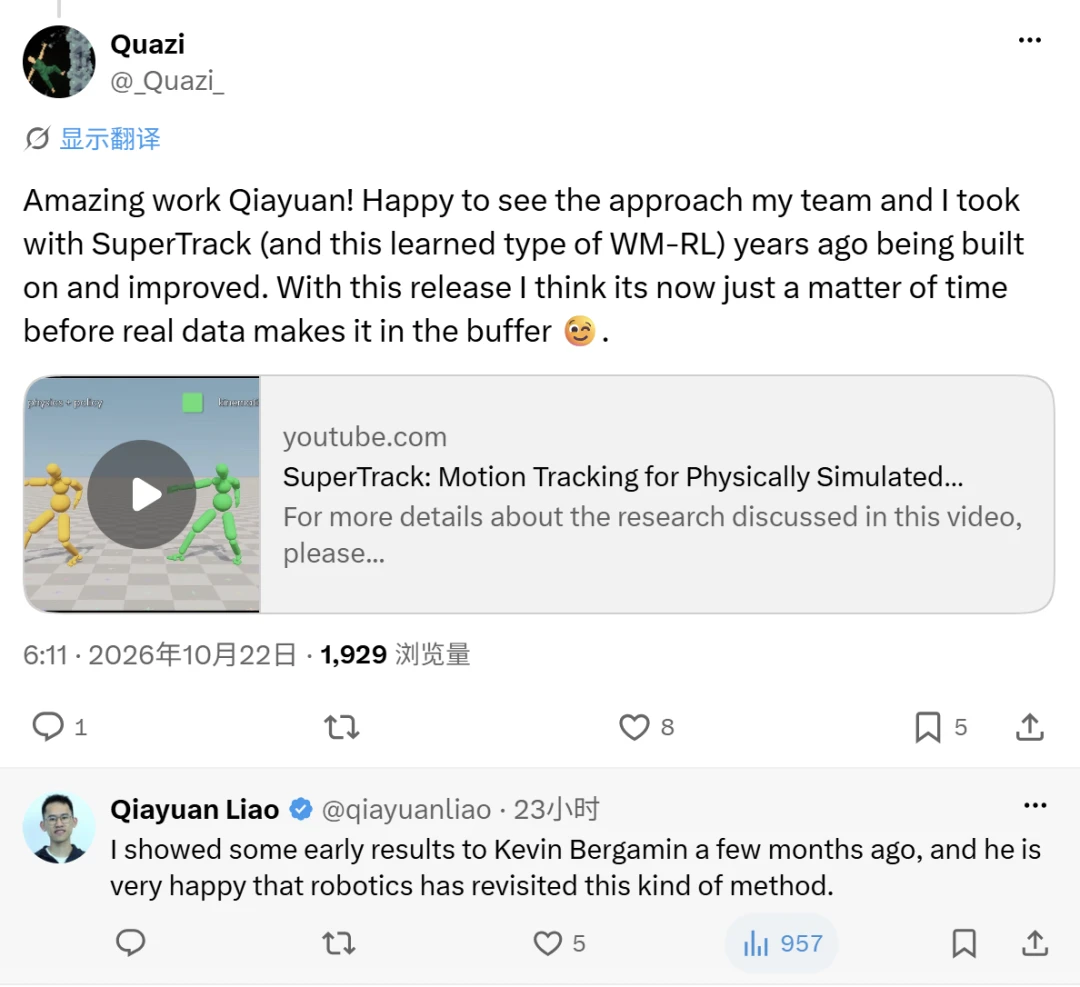
**SuperMimic 并非一蹴而就。**从最早出现于 SIGGRAPH Asia 的 SuperTrack(2021),到 SuperDyno(2025),再到 SuperMimic(2026),这些研究延续了机器人学界部分领军学者一贯的思想路线,即用世界模型代替仿真器、反向传播训练动作跟踪。从仿真走到真机耗时 5 年,依靠这条路线上一次又一次受启发的实验,逐步改进。SuperMimic 发布后,前作 SuperTrack 作者亦赶来对该项研究表示称赞:
「这项研究太棒了!很高兴看到我和团队几年前在 SuperTrack 上用的方法(以及这类学习型世界模型加强化学习的路线)被继承和改进。有了这次发布,我觉得把真机数据放进经验池只是时间问题。」
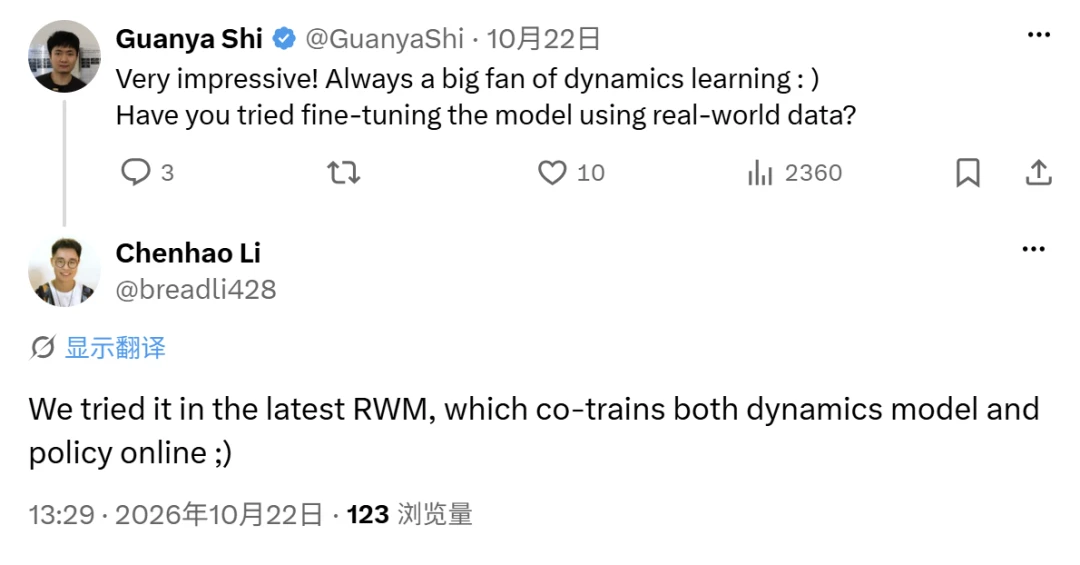
**就本文细节与复现问题,在中外社交媒体上亦有讨论。**卡内基梅隆大学机器人研究所助理教授、LeCAR Lab 中心石冠亚询问团队是否尝试过使用真机数据对模型微调,并提出将 SuperMimic 扩展到和场景、物体交互的设定会很有意思,可能需要通过设计巧妙的表示让模型表现更稳、更具泛化能力。
谷歌 DeepMind 的 Chenhao Li 随后表示,他们尝试在最新的 Robotic World Model(RWM)中尝试过将动力学模型和策略一起在线训练。
开源物理引擎 Bullet 作者 Erwin Coumans 也表示,Qiayuan 团队在神经动力学的研究非常出色,「解析物理引擎的梯度,不管是自动求导、有限差分还是手写的,都没有学出来的引擎或世界模型平滑」。
Genesis AI 的创始研究科学家宋运龙(Yunlong Song)认为这项研究可以将下一步聚焦于可微分世界模型在带感知的全身控制与行走上,因为「这能行,因为我们已经证明,用可微物理可以大幅扩展基于视觉的策略学习,样本效率提升 50 倍。」
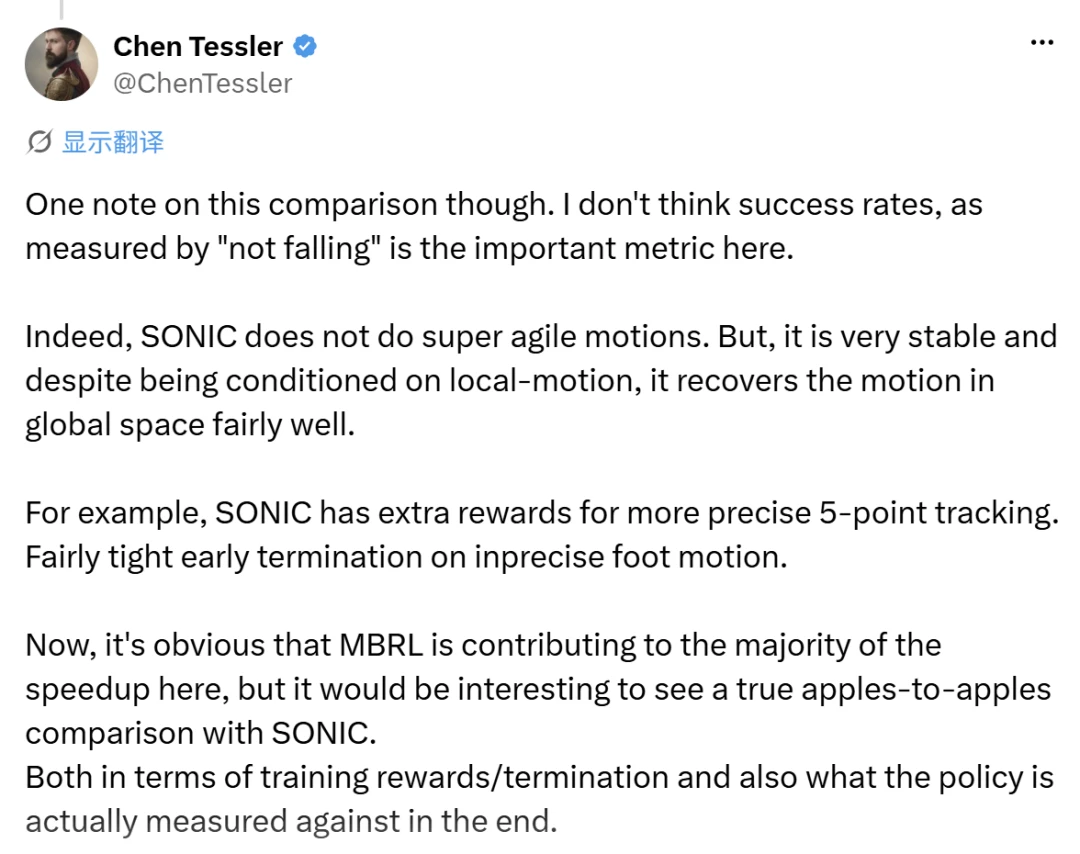
**亦有人对 SuperMicmic 或是廖洽源的部分观点表达异议。**曾参与开发 ProtoMotions、MaskedMimic、CALM 的英伟达特拉维夫实验室科学家 Chen Tessler 补充,在实际测试中用机器人不摔倒来衡量成功率并不能算作为关键指标。他认为,SONIC 虽然无法完成特别敏捷的动作,但它非常稳健,即便以局部动作为条件,也能够在全局坐标里把动作恢复出来。他还表示,「大家采用和复现这项工作的速度,让我更确信会议制度坏掉了……社区的检验比审稿重要 100 倍,影响也大 100 倍。」
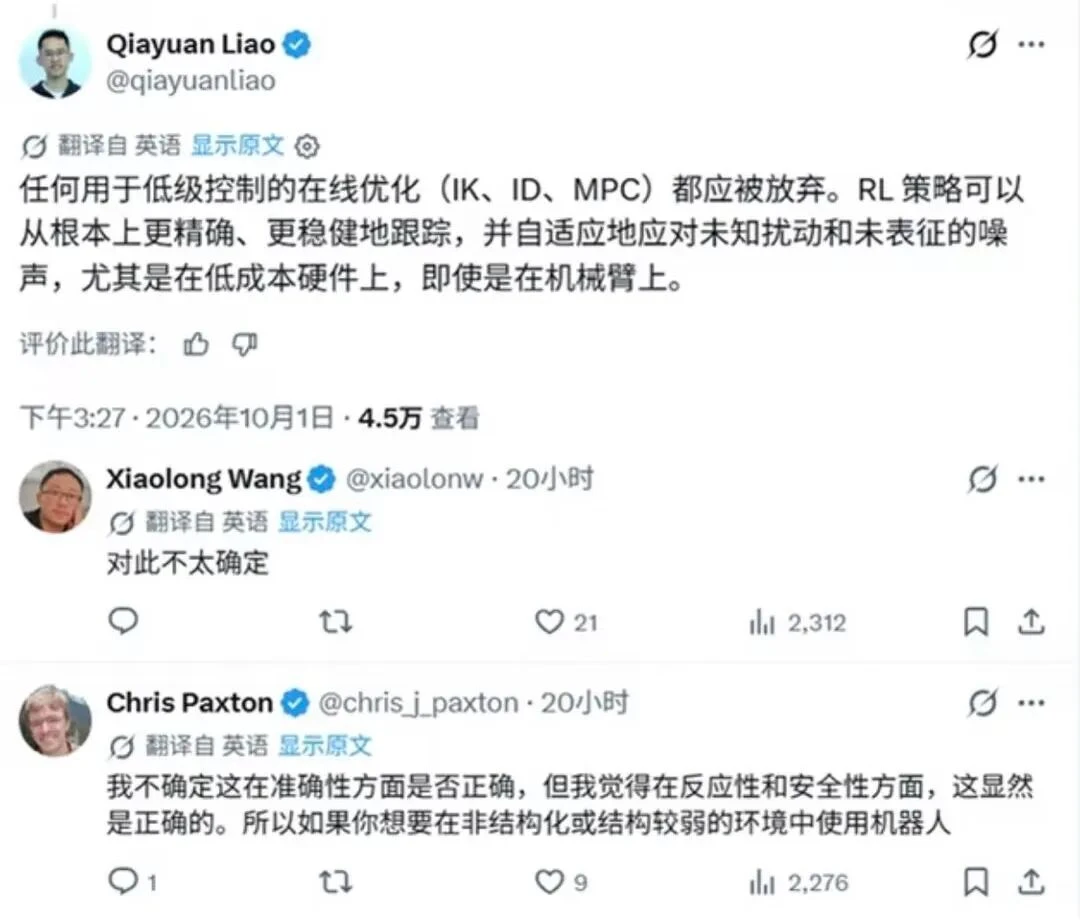
廖还认为,任何用于低级控制的在线优化(IK、ID、MPC)都应被放弃。强化学习策略可以从根本上更精确、更稳健地跟踪,并自适应地应对未知扰动和未表征的噪声,尤其是在低成本硬件上。有研究者对此表示不太确定。
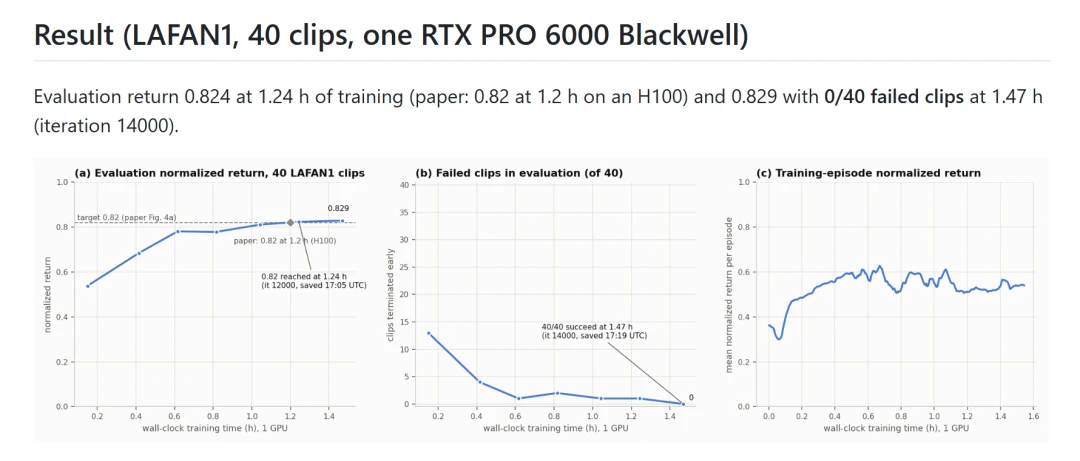
**目前,已有同行对该项研究进行复现。**苏黎世联邦理工学院 AI Center 博士生张翀(Chong Zhang)已经在 Github 公开复现项目并表示,通过 Claude 在单张 RTX PRO 6000 仅训练约 1.5 GPU 小时取得了相似的结果,并认为它学习的是完整状态,相当于一个更快、可求导的 Isaac Sim。
更有同行在国内社交媒体公开复现结果,表示对 SuperMimic 的训练效率感到震撼,相关消息一度刷屏小红书。
截止发稿前,仍有更多团队正对 SuperMimic 密集开展复现工作,以验证这项研究的突破性价值并投入应用。

融合突破趋势初显
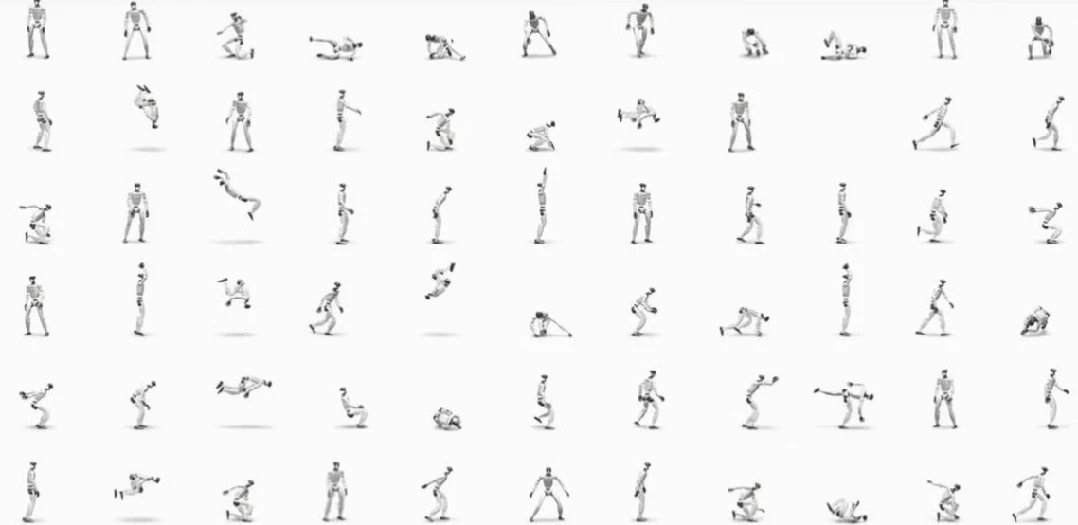
观察近几个月具身智能的技术趋势不难发现,世界—动作模型(WAM)、视觉语言动作模型(VLA)、联合嵌入预测架构(JEPA)等多条路线已取得了明显进步,强化学习亦不遑多让。它们从不同入口接近机器人的身体协调、任务理解和自我纠正,彼此之间互有借鉴、互有重叠。将 SuperMimic 放回具身智能的研究版图来看,它补强的是对当前机器人产业中很基础但极为关键的一项能力,即用可承担的成本来训练一具机器人的本体协调与控制。
**目前,国内的算力需求紧张、资源稀缺现象客观存在。**SuperMimic 对机器人技术的重大突破在于本体训练,即全身控制的训练效率和可扩展性。这项技术将有希望显著缓解围绕机器本体算法的 GPU 计算资源约束。扩展至具有知觉的全身控制后,与其他模型结合、放入不同的场景中测试泛化,亦有大量潜力。它为曾经十分昂贵的计算资源提供了明显更经济的方法,使更多动作、更频繁的实验和更系统的比较成为可能。接下来,真正决定机器人能走多远的,将是在新接触、新地形和真实任务中的应用表现。比如,复杂地形、带物体的全身接触,跨机型迁移和现实中的长时间可靠性。团队称,未来研究将把真实机器人数据和在线系统辨识纳入模型学习。整体来看,目前具身智能领域取得的前沿进展中,模型与本体融合突破的科技趋势正在初显。
无独有偶,宇树科技 CEO 王兴兴亦在近日的工博会、2026 世界物理 AI 大会等场合公开表示,物理 AI 很有可能在未来 1-2 或 2-3 年内加速到来。时至今日,似乎唯有信仰才能纪念人工智能领域日新月异的技术进步。或许更务实一些地说,我们仍应该对机器人抱有希望,对活跃在世界各地、才华横溢的中国青年学生、研究者、科学家保持充沛信心。
人类社会和通用人工智能的距离正在拉近,谁知道呢?也许一眨眼,通用人工智能就和身后的大海一样真实。