

「摔倒」方显真差距,I-BFM 把物理交互训进行为基座模型
这两年有不少惊艳的机器人搬箱子的 demo,但不知道大家是否有注意到一个细节,绝大多数 demo 里,一切都是按剧本走的。箱子摆在它该在的位置,机器人站得笔直,一遍过,没有任何干扰,甚至大部分镜头里都没有人的出现。
现实世界不是这样。手会没抓稳,箱子可能重得抬不起来,旁边会有人不小心撞你一下,甚至机器人自己会摔个四脚朝天。
面对这些问题,目前的主流回答是重新规划一条轨迹,再爬起来,可规划带来的延迟往往把恢复窗口直接耗掉。而同济大学韩子琪和他的合作者们,最近给出了一种不一样的回答。
10 月 5 日,同济大学韩子琪、清华大学李忆唐、浙江大学孙俊涵为共同第一作者,清华大学助理教授赵昊为通讯作者,联合 RoboParty Lab、哈尔滨工业大学、上海科技大学等机构,发布《I-BFM: Reward-Conditioned Robust Humanoid Interaction via Unsupervised Reinforcement Learning》(基于无监督强化学习的奖励条件化鲁棒人形交互)。据论文所称,这是第一个面向人形机器人与物体交互的行为基座模型。
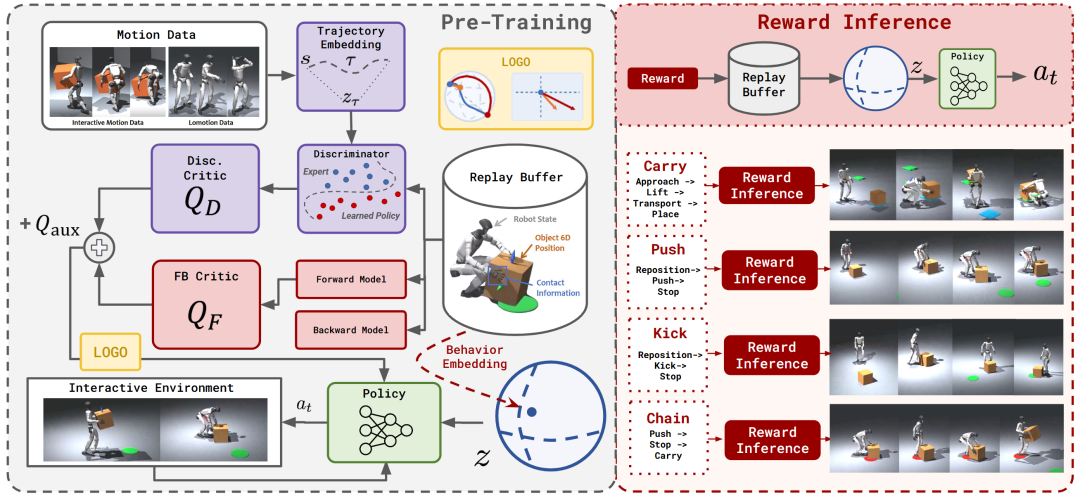
I-BFM 的思路是不给「搬箱子」设定任何任务奖励,让机器人在仿真中自由探索身体、物体和接触之间的关系,用前向-后向表征(FB)把状态转换规律压进一个可复用的隐空间。当新任务到来,写一条简单奖励函数去检索,取出隐向量指令(latent)直接执行。
关于 FB,F 是由「当前状态、做动作」编码成的一个前向向量,B 是由「未来可能到达的状态」编码成的一个后向向量,两个向量点积,就能读出「照这样走下去,未来能到达哪些状态」。而「照这样走下去」里的「这样」,由潜向量 z 说了算,换个 z,同一状态动作对应完全不同的未来,z 可以由奖励算出,这就是它能用一句奖励描述调用出不同行为的机制。
效果上,无干扰情况下,它与基于规划的 OmniContact 基本打平,但当给机器人一个瞬时冲击,将其放倒后,I-BFM 成功率仍有 89.3%,对手只剩 1.3%。
借 这篇论文发布的契机,42 号电波采访到了文章的共同第一作者韩子琪。他是同济大学研究生,同时在 RoboParty 做具身智能算法实习生,方向是运动控制。主要跟他讨论了三个话题:
- 机器人摔倒了还能继续搬箱子,核心原理是什么,这种鲁棒性从哪来,为什么依赖参考轨迹或规划的方法做不到这一点;
- I-BFM 目前只有箱子一个物体,核心思路是拿奖励函数在潜空间里搜索, 那要处理不同状态的物体,最需要增加什么东西;
- 这项工作的想法是怎么冒出来的,最近读到哪些受启发的工作。
结合韩子琪的采访和论文内容,得到了上述三个话题的简要回答:
关于第 一点,核心原理是让机器人根据当前的身体、箱子和接触状态决定下一步,而不是沿着预定轨迹执行。FB 学的是状态之间的转换关系,箱子位置变了就重新接近,机器人被推倒了就先恢复姿态再接着干。规划式方法的区别在于它摔倒后需要重新规划、引入延迟,「根据当前状态和目标直接调整动作」与「重新规划再执行」是两种不同的恢复机制。
对于第二点,关于扩展到更多物体,他的答案是数据和状态表示都要加。一方面扩大物体种类和接触经验,并为新任务设计具体奖励,搬箱和踢箱的奖励函数设计差别就非常大;另一方面要跳出动捕环境,用机载感知可靠获取物体与接触状态。他还特别提到,训练数据里全是平地到平地的搬运,但效果却可以跨高度搬运,这体现了算法自带的泛化。
至于受到启发的工作,他推荐了两篇。一篇是 BFM-Zero,他把这条「无监督强化学习加 FB 表征」的路线称为鼻祖,BFM-Zero 的第一作者李忆唐,正是 I-BFM 的另一位共同一作。韩子琪选 FB 的原因在于,FB 把能力预先训进模型、用时提取,速度和调参都省事得多。另一篇是孙俊涵的 INTACT,我们前段时间刚聊过 杨立昆点赞!浙大孙俊涵、清华赵昊等提出 INTACT:免去 JEPA 世界模型的「搜索税」 ,它让模型既理解眼前的物理变化、也朝着更远的目标移动。这启发了 LOGO「下一帧加第 8 帧」的双目标设计。
事实上,看到这篇工作,脑海里第一个想到的场景就是工厂里的搬东西、上下料,但工厂里真正值钱的从来不是一次搬成功,是即便出岔子还能把活干完。行为基座模型这条路,把「摔倒之后继续干」写进了机器人的能力清单。
差距在摔倒以后
先讨论仿真里没有扰动的表现。
在 MuJoCo 仿真 里,研究人员让机器人完成搬箱任务,内容包括走过去、抱起来、运到目标点、放下,每次评测跑 3×100 个随机回合。与 I-BFM 同场竞技的三个基线分别是无参考轨迹的 PhysHSI、LessMimic 和基于规划加参考轨迹的 OmniContact。
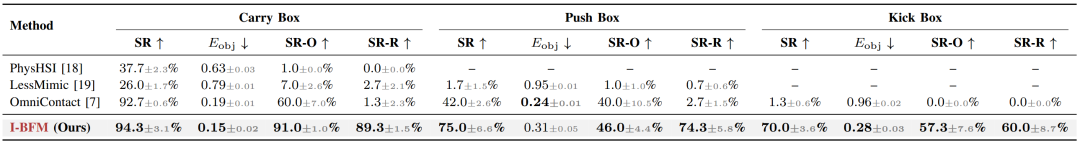
从表中看,I-BFM 的成功率为 94.3%,高于 PhysHSI 的 37.7%、LessMimic 26.0%,同时跟 92.7% 成功率的 OmniContact 打了个平手,说明无扰动情况下,I-BFM 已不输于「规划加参考轨迹」的方案。
分水岭是加了扰动之后的实验。实验设置了两种扰动,一是搬运途中给箱子施加一个 200 N 的向下力,让箱子脱手掉落;二是直接给机器人骨盆一个 2,000 N 的瞬时冲击,把机器人放倒在地。
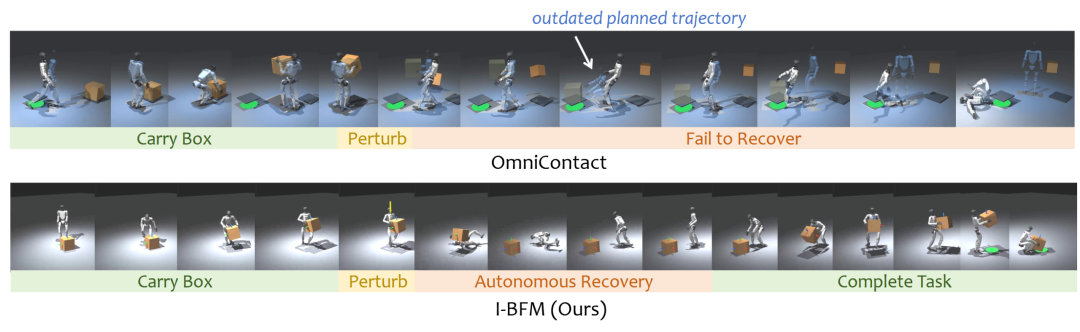
看结果,箱子掉了,I-BFM 的成功率还有 91.0%,OmniContact 掉到了 60.0%;机器人自己摔倒了,I-BFM 依然有 89.3% 的成功率,而 OmniContact 却只剩下 1.3%。无干扰下,94.3 对 92.7,还能说是同一水平线上的竞争;机器人摔倒情况下,89.3 对 1.3,已是天壤之别。
事实上,依赖规划的方法在摔倒后要重新生成轨迹,规划本身引入延迟,而且扰动后的状态可能已经偏离了规划所假设的初始条件,轨迹还没算完,最佳恢复时机已经过了。I-BFM 的策略每一帧都根据当前状态和目标直接给出动作,不用等待规划这一步。
关于这两种恢复路线,韩子琪在采访中是这样说的:「像 OmniContact 的话,它可能需要再重新进行一个规划。我们的区别主要在于,策略可以根据当前的状态和目标直接调整动作。采用既定参考的系统,则需要重新规划。这是两种不同的恢复机制。」
推箱子和踢箱子两个任务上,这个趋势也同样明显。推箱子遭遇机器人摔倒扰动后,I-BFM 成功率 74.3%,OmniContact 2.7%,LessMimic 即使在无扰动条件下的推箱成功率也只有 1.7%。踢箱子则更极端,OmniContact 就算在无扰动条件下成功率就只有 1.3%,而 I-BFM 是 70%,远高于前者。
当然,更重要的是,I-BFM 的真机表现也与仿真对得上。研究人员把策略部署到宇树 G1 上,在动捕场地里以 50 Hz 跑同一套策略。
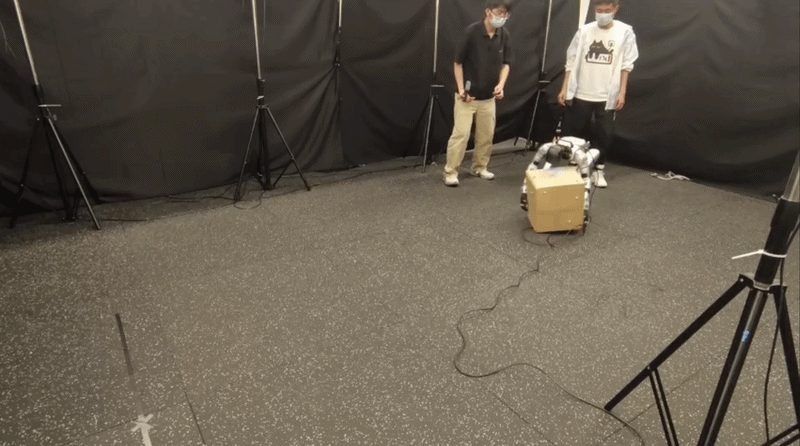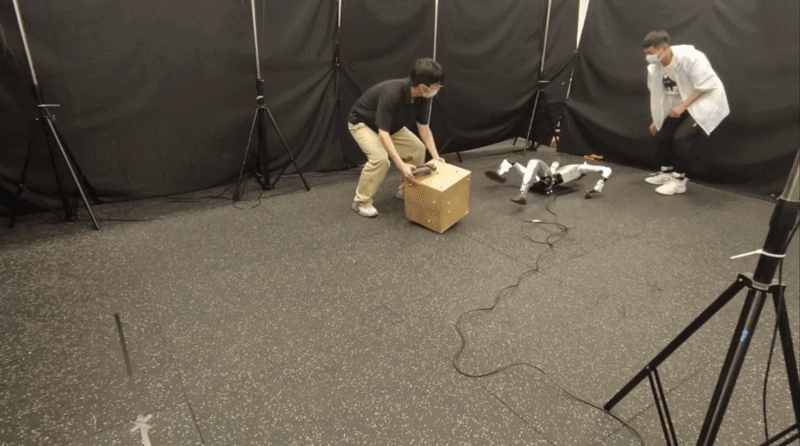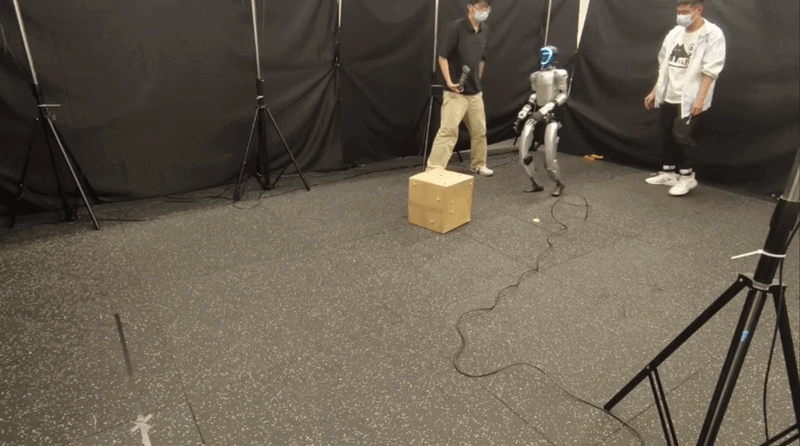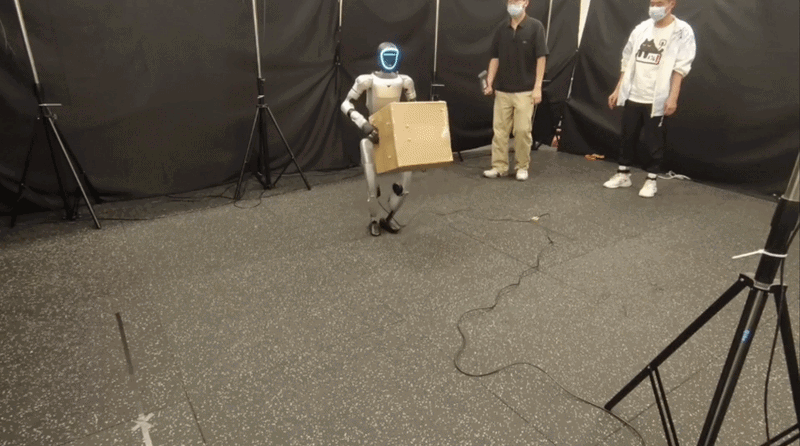
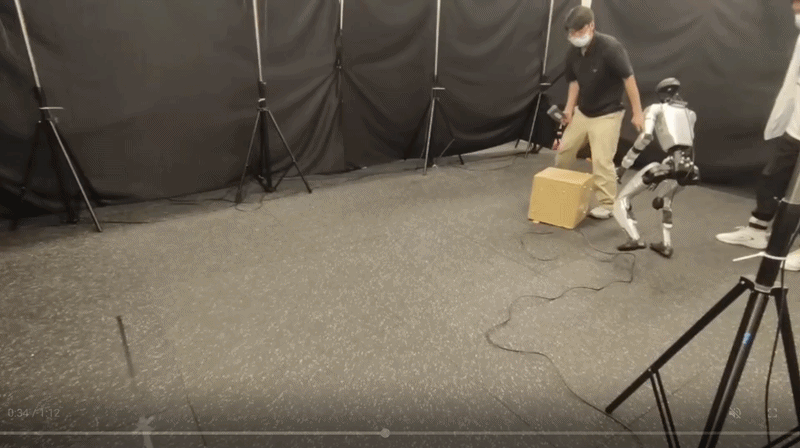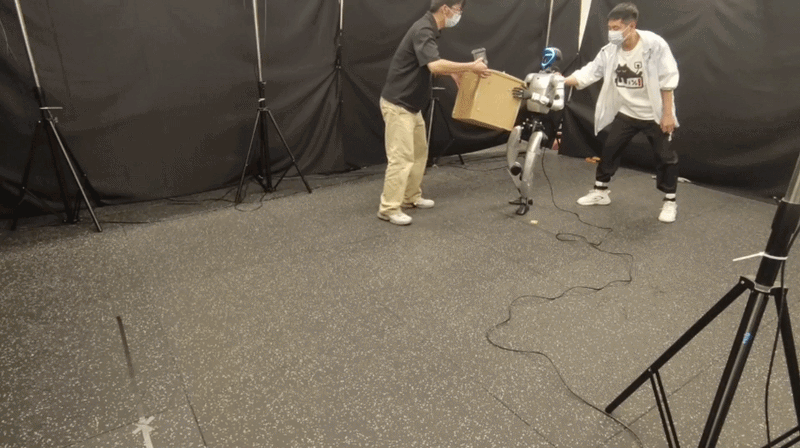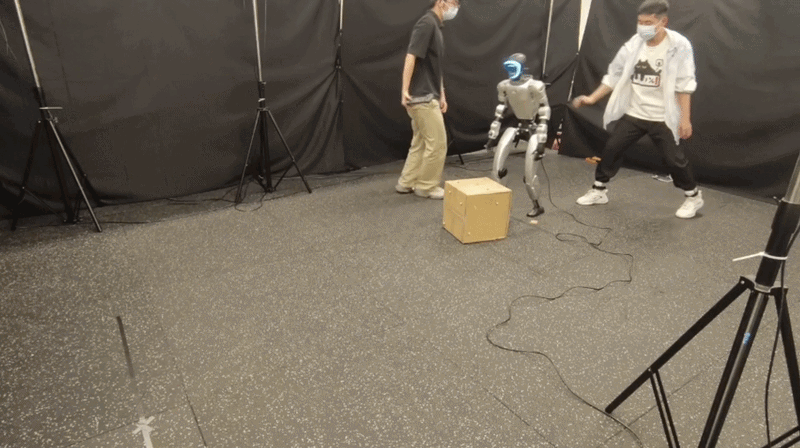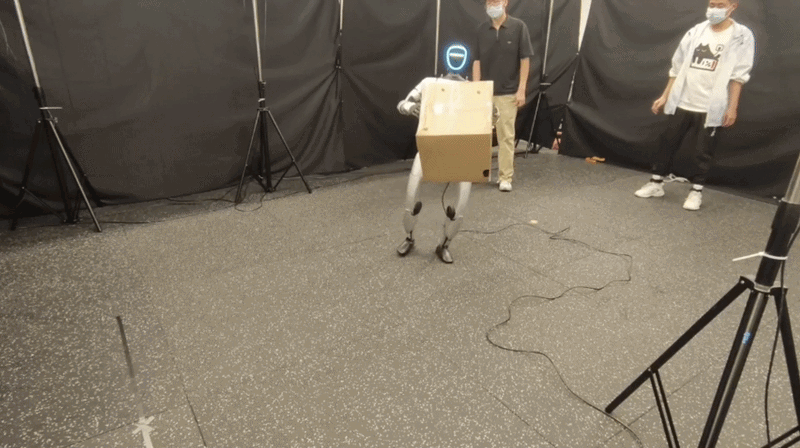
机器人可以做到搬箱失败了自己重试;被人推了一把或箱子被挪了位置,先稳住身体,重新走近箱子,接着搬;箱子在执行中途被踢走,它能立刻更新动作,重新接近新位置,并且全程没有像规划式那样停下来「想一想」。
I-BFM 不仅能在无干扰的情况下完成「搬箱子」等任务,并且依靠其恢复能力,它在各种干扰下的任务成功率也大幅领先其它基线。
恢复能力背后的秘密
这种「摔了直接爬起来」的恢复能力就藏在两个设计里,FB 框架和 LOGO。
先聊 FB,也就是开头提到的前向-后向表征,预训练阶段不设定任何具体任务,用无监督强化学习让机器人在交互环境里自由探索,FB 框架负责把探索到的状态转换规律压缩进一个共享的隐空间。
同时,行走数据和人箱交互数据混在一起训练,推、踢、搬甚至共用同一个任务标签。训出来的这个隐空间相当于一个巨大的能力库,当新任务来了,只需要写一个简单的奖励函数,比如「让箱子的高度上升」,拿它去能力库里检索,就能直接算出一个隐向量指令(latent),喂给策略执行,全程不需要针对新任务重新训练。
而之所以选 FB 这条技术路线,有一大部分是出于工程上的考量。用传统的逐任务强化学习方法调一个搬箱子策略,奖励参数不合适就得整轮重训,但 FB 的路线是先把能力训进模型,用的时候再提取。
韩子琪在采访中算过这笔工程账:「我之所以采用 FB 做搬箱,是因为我用 AMP 去调箱子实在太复杂了。我设计一个简单函数,运行个一天两天,然后发现参数不合适。但如果用 FB,模型本身已经训练出来这个能力,我们只需要把这个能力提取出来。所以它不管是速度,还是调参的能力,都比纯 AMP 强很多。」
这可能也是 FB 这条路的优势,可以减少训练策略的时间。
值得一提的是,I-BFM 的状态里专门放进了接触信息,信息包括双手有没有碰到箱子、手在什么位置、手离箱子还有多远。有了接触状态,「同样姿势、不同接触」对应「不同动作」才能被策略学进去,为后面的闭环交互和接触变化后的恢复打下基础。
箱子的位姿、速度、目标位移同样在状态里。这意味着奖励可以直接写在物体上,从而优化「箱子到没到地方」这件事本身,传统跟踪参考轨迹的方法就很难绕过「动作像不像参考」这道中间环节。
事实上,预训练目标是三路信号并行。FB 负责把交互状态的转换规律组织进隐空间;一个判别器负责区分「人类动作数据」和「策略自己生成的动作」,给策略持续施加运动先验,让它在自由探索的同时保持动作像人; 还有一个辅助 critic 提供环境层面的稳定信号,让控制更平滑,也是后来仿真表现能顺利迁移到真机上的关键 。
这套机制本身就有鲁棒性。因为策略每一帧看的都是「我的身体什么样、箱子在哪、手碰没碰到」的当前状态,再决定下一步动作,它执行的是状态驱动的闭环反应,而非一条预定轨迹的播放。
因此,恢复行为会在统一策略里自然涌现出来,其源头是无监督强化学习期间对状态空间的广泛探索,机器人在仿真里就会提前「见过」各种站不稳、抓不住、偏得离谱的状态。
韩子琪还介绍了一个团队做的一个测试,全程只给机器人同一个「抬举」latent,中途不切换任何指令,看它能走多远:「全程只给机器人同一个 lift latent,不切换接近、转向或起身的 latent。最远的话,在 2.4 米的时候它依然能够接近箱子,并且把箱子搬起来。这远远超过了我们数据集的分布范围。」
这个现象说明,一个 latent 指令在测试条件下能驱动出随状态自适应调整的行为,接近、弯腰等动作全是策略自己临时决定的。
再说 LOGO(Local–Goal Objective Geometry Operator)。它用来解决的是一个更细的问题, 关于眼前的接触和远处的目标怎么同时顾上。
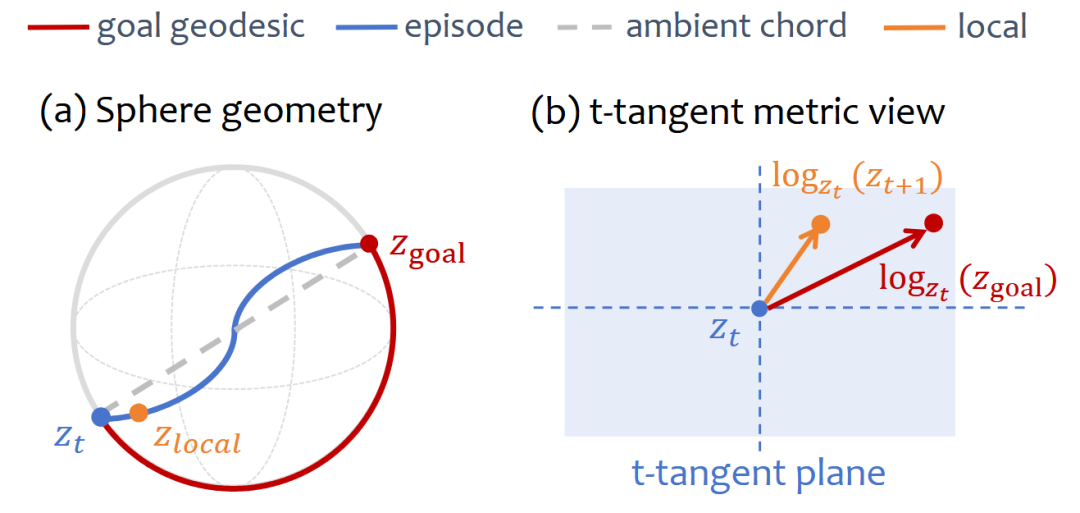
原来的做法是取未来 8 帧的平均特征当指令,但平均显然会糊掉关键信息,因为同样一个平均可能对应完全不同的第一步动作。
LOGO 把「8 帧平均」改成了「下一帧 + 第 8 帧」的双目标,具体而言,下一帧关注眼前马上要发生的物理接触,第 8 帧盯住任务的大方向,两个目标通过大量实验得到 4:3 权重,再混进训练。
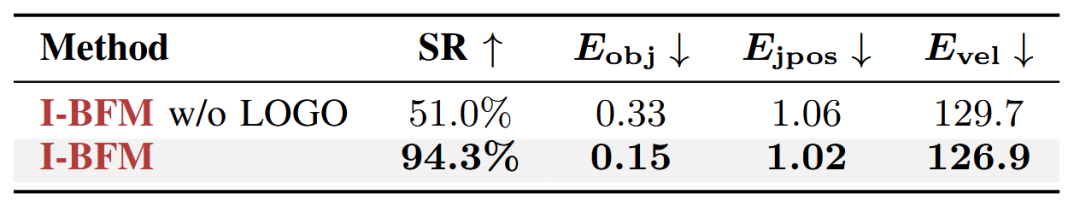
从消融实验可以看到 LOGO 的效果,去掉 LOGO,搬箱成功率从 94.3% 直接掉到 51.0%。事实上,LOGO 并没有让动作跟踪更精确多少,后面两列的关节位置和速度的跟踪误差几乎没变。
它真正提升的是接触转换的稳定性,即手什么时候该搭上箱子,什么时候该松,什么时候该重新够。
关于这个设计的灵感来源,韩子琪在采访中提到了孙俊涵的 INTACT:「INTACT 给我的启发是,模型既要理解眼前的物理变化,也要知道朝着怎样更远的目标方向移动。所以我们把原来 8 帧平均的处理方法,改成下一帧和未来第 8 帧作为目标,让策略在处理当前接触的同时,持续顾及后续的任务目标。」
不止「搬」一个动作
I-BFM 让人觉得有价值的地方不仅是抗干扰的鲁棒性,更来自于同一套策略,换个奖励函数,就能干其他活的能力。
先说「推」和「踢」。做法是把长程交互拆成若干阶段,每个阶段写一条简单的阶段奖励。推箱子的奖励围绕「从箱子后方用手接触、贴着地面平移、到点附近停稳」来写;踢箱子的奖励则挑选那些「站位对齐、不扶箱子、踢完自己还能站稳」的冲击动作。
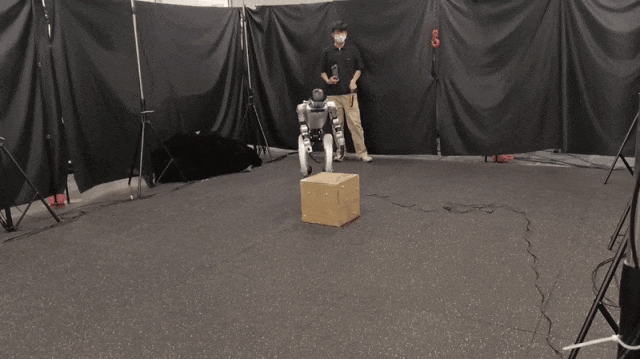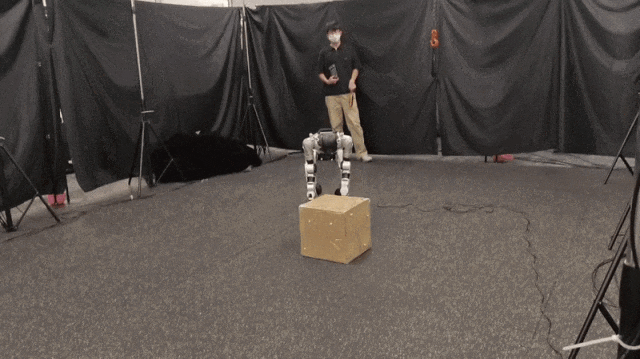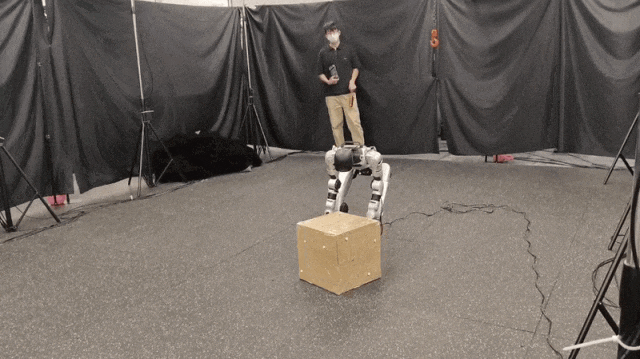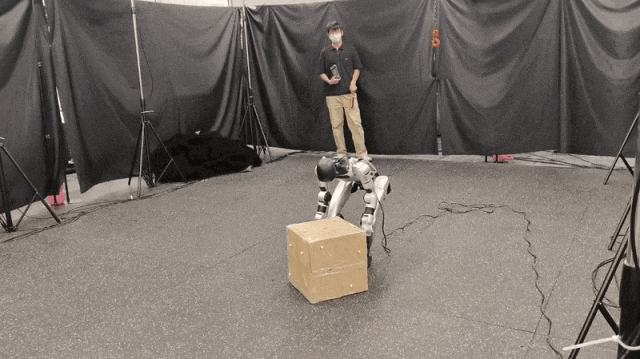
两条奖励函数各自检索出对应的 latent,机器人就从一个耿直的搬运工变成了面对重物时会推、会踢的灵活工人。仿真结果里推箱成功率 75%、踢箱 70%,这两个数字背后有一个关键前提,训练中完全没有针对推或踢做过任何专项训练,就是说预训练数据里推、踢、搬用的都是同一个任务标签,策略学到的是一套共享的交互表征。
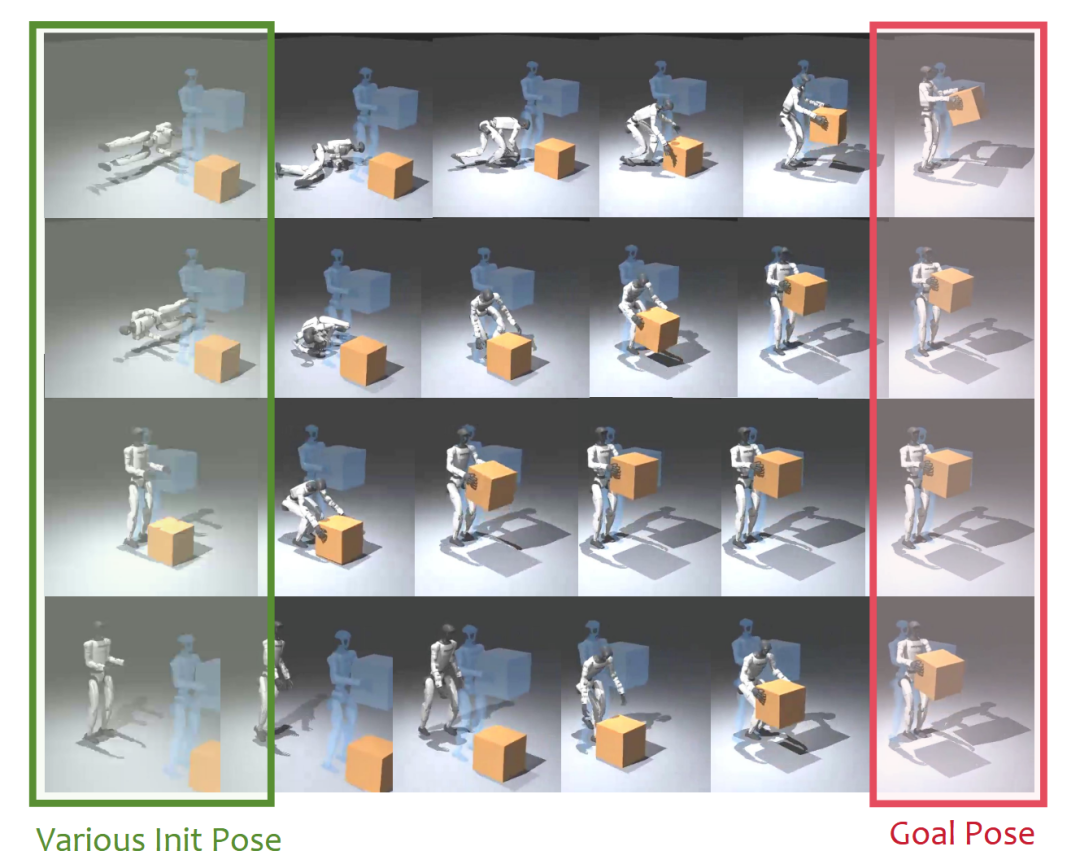
更进一步的泛化藏在高度里。训练数据中的搬运全是平地到平地,但评测时把起点和终点放在不同高度的平台上,机器人照样能完成跨高度搬运,图中从各种初始姿态和箱子位姿出发,最终都能把箱子搬到同一个目标位姿。这种「没见过但会做」的能力,正是 FB 加无监督强化学习组合带来的优势。
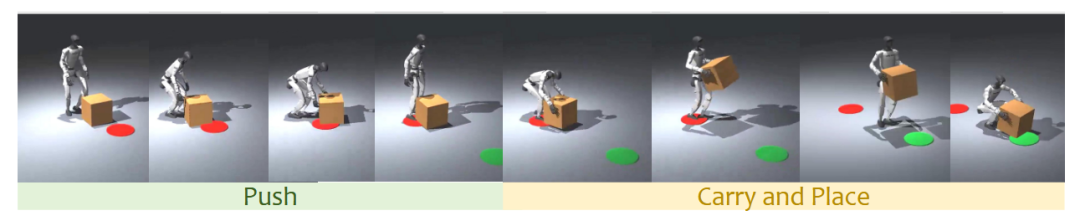
这也让长任务拼接变得顺理成章。每完成一个子目标,更新一次奖励描述,latent 跟着换。可以看到,图里机器人先把箱子推到半道,停手,再弯腰把它抱起来,运到终点放稳。全程不存在策略切换和重新规划。
当然,这条路有它的天花板。能力库(replay buffer)多大,舞台就多大,韩子琪在采访中把这个边界讲得很清楚:「它的上限取决于探索覆盖了多少真实会遇到的状态,以及仿真和现实有多接近。比如我数据集里面没有抛箱子的状态,那我的算法就没有办法实现抛箱子这样一个任务。」
离进工厂剩几步
仿真和真机的 demo 着实惊艳,但大家会更多关心这东西离进厂「搬砖」还有多远?采访中,韩子琪列了几道坎,也是要解决的具体问题,讲得很实在。
第一道坎是物体的种类。工厂里不会只有一种箱子,重量、尺寸、摆放位置都在变。目前 I-BFM 的交互对象还只有箱子,要扩展到更多物体,状态表示本身就得改,箱子的状态好描述,门把手怎么描述?抛起来的物体怎么描述?这些都是开放问题。
第二道坎是感知。当前的真机实验依赖外部动捕,工厂里铺满动捕既不便宜也不现实,最终要换成机载感知,让机器人自己的眼睛可靠地获取物体和接触状态。
值得一提的是,I-BFM 在架构上已经为这一步留了口子。训练时只有 critic 能看到全知的特权信息,真正部署的 actor 只看本体感知加外部测量的观测历史,也就是说,策略本身从不依赖「上帝视角」,要换的是物体和接触状态的来源。
第三道坎是更高层的决策。现在的任务规则依然是人写的,从这里搬到那里。工厂环境里会有阻挡、需要绕路、会有突发情况。这或许仍要求往上再接一层规划,让机器人自己决定先处理什么、失败了怎么办。
第四道坎是最朴素的效益问题。工厂要算节拍、算连续运行时长、算多久更换一次电池,还要过安全关。这些都是算法走出实验室要算的效益账。
不过它仍证明了交互能力是可以像大模型里的知识一样,先大规模预训练、存进一个隐空间,用的时候拿奖励当 prompt 去调取。
搬、推、踢是三个 prompt,那照这个逻辑往下想,理论上写好奖励、检索出 latent 就能完成开门、递工具等物理交互。
韩子琪对这套框架的期待,也不止于箱子:「我觉得 BFM 实际上有非常非常多的潜力。同样尝试把它应用为一种更大规模的基座模型的话,我觉得其实也是可以的,这个后面还可以有待挖掘。」
论文结语里有一句话可以作为这整件事的注脚:让通用型人形机器人通过一种可复用的、鲁棒的行为表示与物理世界交互,I-BFM 迈出了一步。