

王晓刚、李鸿升团队新作:260 万个场景训练灵巧手
OmniDex 借助可复用种子抓取库搭配碰撞筛选,将杂乱场景下的灵巧手抓取数据集规模从数千个扩充至 260 万个场景、约 4 亿条抓取标注;配套采用软胜者全取学习与物理约束的生成模型,省去推理阶段反复优化抓取位姿的步骤。
10 月 8 日,大晓机器人、香港中文大学多媒体实验室、香港 InnoHK 感知与交互智能中心、同济大学、上海交通大学、浙江大学与南洋理工大学团队发表论文《OmniDex: Scaling Dexterous Hand Grasping to Diverse Cluttered Scenes》。论文共 10 位作者,香港中文大学教授、商汤科技联合创始人王晓刚位列作者名单;房乃玉与罗忠金为共同第一作者,罗忠金与黄思远为项目负责人,香港中文大学多媒体实验室的李鸿升担任通讯作者。
灵巧手抓取是具身智能的基础动作,一切复杂操作都建立在稳定抓取之上。真机采集高自由度抓取姿态成本高昂,难以大规模量产,行业普遍转向仿真合成数据。
但杂乱场景最贴近真实落地环境,现有方案长期受三重瓶颈制约。
其一,输入多依赖深度点云,模型仅关注物体外形、丢失语义信息,面对外观近似的不同物体,难以区分抓取目标。
其二,传统抓取标注需要逐场景优化,仅为单个物体优化 500 组初始解,就需要在 A800 显卡上运行约 15 分钟,这也导致公开杂乱场景基准仅维持在数千场景规模。
其三,过往基准很少覆盖桌面以外的支撑平面与摆放形态,货架、纸箱、分拣台这类真实作业场景均未纳入。
OmniDex 同时从数据、算法两端突破局限。
数据层面,团队摒弃逐场景优化,改为离线预计算:先在空旷环境为每个物体构建可复用的种子抓取库,再将物体置入杂乱场景执行碰撞筛选,最终构建 260 万个场景、约 4 亿条抓取标注的数据集。
算法层面,团队训练无需后优化的端到端抓取生成模型,依靠软胜者全取学习目标保留多种可行抓取方案,并在训练过程中引入物理约束,补齐毫米级定位精度;推理环节采用并行采样搭配物理打分。整套方案尝试在杂乱环境中,同时兼顾抓取候选多样性与毫米级操作精度。
01 空场攒种子,杂物堆里筛 —— 数据模块详解
OmniDex 的核心突破首先落在数据体系搭建上。
真实作业场景中,桌面物体密集堆叠、彼此紧邻,灵巧手抓取需要同步规避周边物件与支撑结构,对空间适配能力要求极高。但传统杂乱场景抓取数据的标注成本极高:不同场景的物体摆放形态完全不同,需要逐场景优化求解,才能生成有效抓取姿态。论文给出明确算力开销:仅为单个物体优化 500 组初始解,就需在 A800 显卡上运行约 15 分钟;而单一场景往往包含十余件物体,整体算力成本完全不具备规模化落地条件,这也是过往公开杂乱场景抓取基准始终停留在数千场景小规模的核心原因。
团队之所以坚持做大尺度数据规模,核心是适配杂乱场景的空间交互逻辑。
单物体悬空抓取仅需关注物体自身形态特征,而密集杂乱场景中,物体互相遮挡、彼此支撑,机械手需要精准学会避让、伸取的空间策略。这类复杂空间关系无法依靠少量样本覆盖,必须依托海量场景数据完成模型泛化学习,这也是 OmniDex 将数据规模化作为核心突破口的关键原因。
为破解逐场景优化的算力瓶颈,团队创新采用「离线预优化+场景复用」方案。
研究人员先在无遮挡的空旷场景中,为每类物体优化生成 4,000 组候选抓取姿态,通过力封闭初步筛选后,接入仿真环境完成提拉实测,仅保留可稳定抓取的有效姿态,搭建起可全局复用的物体种子抓取库。经过这一流程,每个物体都储备了多方向、高适配的标准抓取姿态,可直接复用至任意杂乱场景,彻底摒弃传统逐场景重复优化的低效模式,这也是模型能够支撑 260 万超大场景规模的核心前提。
完成种子库搭建后,团队开展大规模场景生成与严格筛选。
基于 Isaac Gym 仿真平台,将多类物体从随机高度投放至各类支撑面,待物体姿态稳定后,将预存的种子抓取姿态映射适配至物体实时位置,生成场景专属抓取候选。团队设置严苛的三重筛选标准:机械手可精准接触目标物体、不触碰支撑平面、不与周边物体发生碰撞干涉。同时筛选口径偏向保守,仅保留直接抓取的有效姿态,剔除需要推移、拨开周边物体的复杂抓取方案,保证样本干净有效。
得益于前置离线优化,该阶段仅需完成坐标变换与碰撞检测,算力开销远低于传统逐场景优化流程。此外,团队增设跨模态一致性校验环节,针对物理模型与视觉模型的网格偏差、仿真收敛误差等问题,通过视觉模型重放所有生成场景,剔除几何标签与视觉画面错位的无效样本,确保所有数据的空间逻辑、模态信息完全对齐。
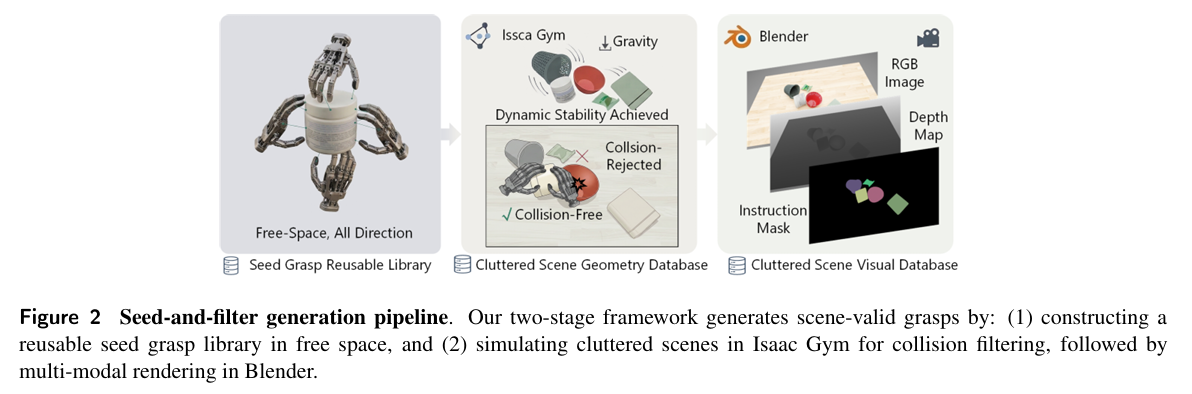
为覆盖多元化真实作业环境,团队针对不同应用场景定制差异化生成规则,构建五大细分场景子集。
-
标准桌面子集、混合子集采用随机桌面摆放模式,物体随机落位,适配日常桌面作业场景;
-
箱子子集模拟包裹分拣场景,实现受限容器内物体密集堆叠;
-
网格子集适配仓库分拣场景,同类物体均匀散落在桌面,仅保留稳定直立的物体姿态;
-
货架子集模拟零售仓储场景,按层级规整码放物体。
统一资产库搭配差异化生成规则,形成形态、场景、难度各不相同的杂乱样本,也让后续评测可分场景精准量化模型性能。
研究团队对数据集物体与支撑资产完成精细化筛选与优化。抓取物体素材源自 OmniObject3D、ShapeNetCore v2、Google Scanned Objects 三大公开数据集,经过语义类别筛选、样本均衡去长尾、残缺网格与贴图剔除三重筛选,最终保留 6,000 多个适配灵巧手抓取的优质物体实例,覆盖手机、玩具、生活用品、鞋类等多元日常物件,且全部完成人工核验适配性。
同时,每个物体配备两套高精度对齐模型:基于流形归一化、凸分解构建的物理仿真模型,以及高保真视觉渲染模型,两套模型共用统一归一化标准,彻底规避空间错位问题。支撑面资产也突破单一桌面局限,囊括 244 张桌面、79 个开顶箱子、21 组货架,全面覆盖桌面、分拣箱、仓储货架等主流作业载体,极大拓宽了场景适配边界。
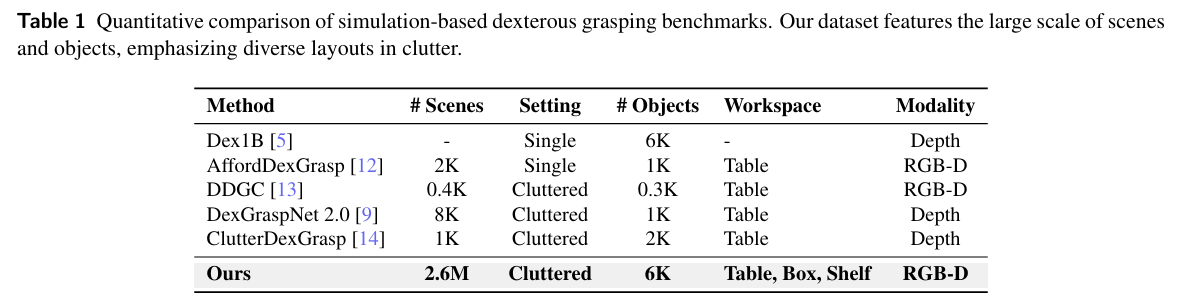
相较于过往行业基准,OmniDex 实现量级级突破。
传统单物体抓取数据集样本充足,但无杂乱交互场景;主流杂乱场景基准均为千级规模,DDGC 仅约 400 个场景、ClutterDexGrasp 约 1,000 个场景、DexGraspNet 2.0 仅 8,000 个场景,且仅支持单一桌面场景。而 OmniDex 将场景规模拉升至 260 万,有效物体样本扩充至 6,000 余个,支撑面覆盖桌面、箱子、货架,观测维度从单一深度升级为 RGB-D 多模态,实现数据规模、场景丰富度、模态完整性的全方位升级。
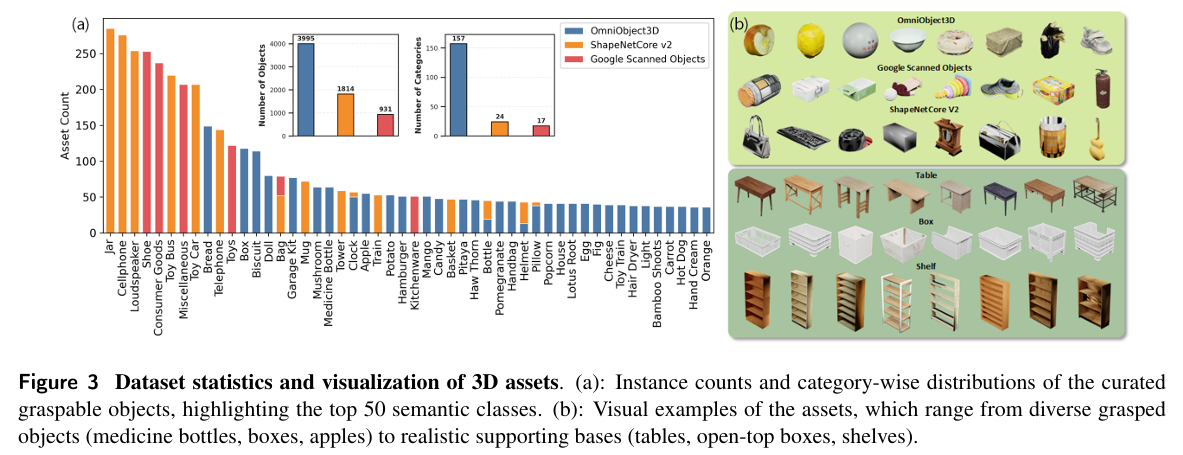
场景搭建完成后,团队构建标准化多模态输入观测协议。
通过 Blender 重放所有杂乱场景几何信息,统一渲染输出 RGB 图像、深度图、语义分割图与相机参数,结合场景语义标签生成目标物体掩码,作为模型「指定抓取目标」的指令依据。相机采用「1 主 4 辅」多视角布局,并根据场景类型动态适配机位:桌面场景采用常规斜视角,规避大范围遮挡;箱子场景收紧机位视角,适配边界密集堆叠场景;货架场景采用分层正视视角,杜绝纵向层间遮挡。多视角标准化布局,彻底解决传统方案仅依赖深度点云、缺失语义信息的短板,让语义识别、目标定位成为数据基准的核心能力。
这套多模态观测体系,重新定义了杂乱抓取任务的输入标准。RGB 图像提供语义特征与物体身份信息,深度图精准刻画几何形态,目标掩码明确抓取主体,相机参数锚定全局空间坐标,多模态信息互补对齐。尤其针对外观高度相似的堆叠物体,可依靠语义信息精准区分抓取目标,解决纯几何识别的核心痛点。
整体数据集按场景类型划分为五大子集,数据规模覆盖十几万至上百万量级,分工明确、适配不同评测维度。其中标准桌面子集 114 万个场景,固定支撑面、替换目标物体,用于测试模型跨物体迁移能力;混合子集 94 万个场景,同步替换物体与支撑环境,模拟无规则复杂作业场景;箱子子集 14 万个场景、网格子集 28 万个场景、货架子集 14 万个场景,分别对标包裹分拣、仓库分拣、货架零售三大工业落地场景。
所有子集均划分专属训练集与两类测试集,分别对应「见过物体换新布局」的空间推理能力、「未知物体换新布局」的零样本泛化能力。评测体系设置双维度核心指标:抓取成功率按重力方向分为三档口径,以真实场景重力下成功率为主指标,辅以全方向稳定抓取、单方向可用抓取双重标准;碰撞规避率用于校验模型抓取策略合规性,量化机械手规避支撑面与非目标障碍物的能力,全方位衡量杂乱场景下的灵巧抓取性能。
02 把抓取的多种可能留住
数据铺开之后,模型层面需要同时处理两项相互制衡的目标。
同一场景观测下,单个物体通常存在多组合法抓取姿态,这是抓取任务天然的一对多特性;但灵巧手的位置只要偏移 1 mm,接触状态就可能失效,对定位精度提出严苛要求。传统方案要么依靠可供性图这类中间表征,压缩多种可行方案为单张热力图,破坏端到端链路;要么在推理阶段迭代优化补足精度,带来显著时延,两种方式都存在短板。
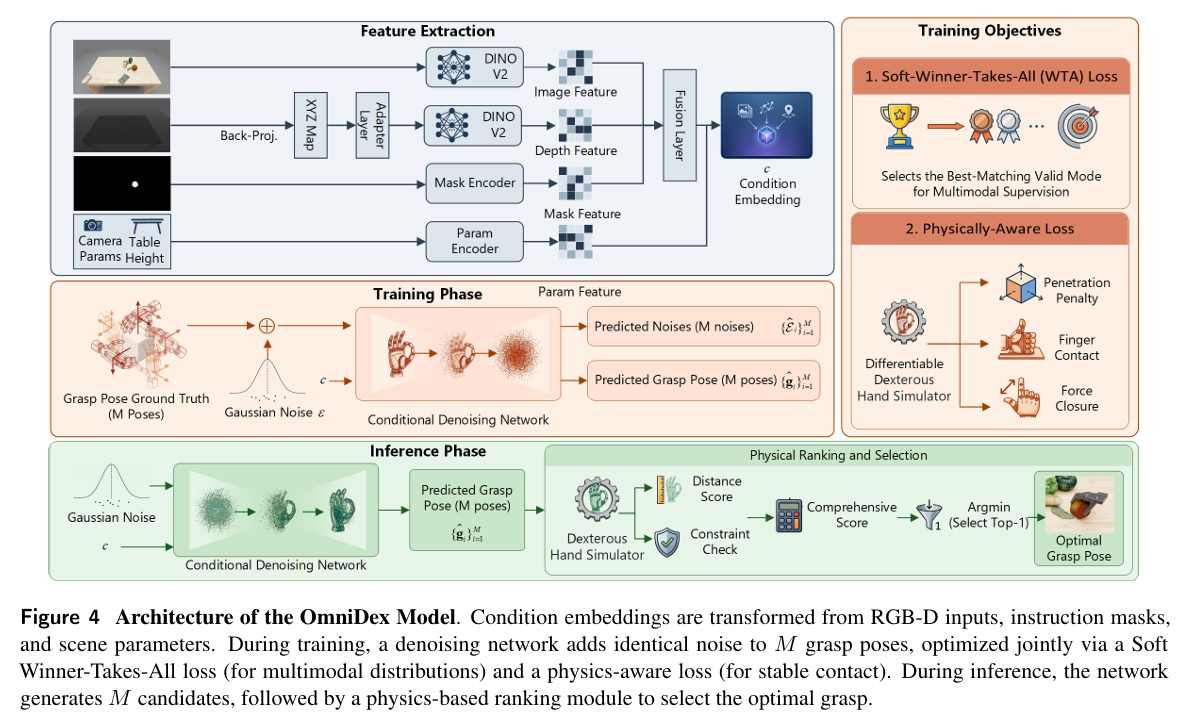
OmniDex 以扩散模型作为生成主干,基于场景观测条件,从噪声逐步去噪还原抓取姿态。
模型先构建融合多模态信息的条件输入:RGB 图像通过 DINOv2 提取语义特征,深度图借助轻量适配器提取几何特征,目标掩码单独编码,三路特征融合构成场景表征。为统一抓取生成的全局坐标系,团队将相机参数、桌面高度编码为参数标记,拼接至场景表征后。深度图不直接作为输入,而是反投影得到三维坐标图,保证几何信息与抓取真值对齐。团队选择深度重投影,是因为深度承载严谨的空间几何,纹理信息可插值,几何关系不能近似凑取。
多视角输入采用双分支融合策略:RGB 做早期语义融合;深度依据相机参数重投影至主视角,通过硬件加速 Z 缓冲散射完成点云对齐,相机位姿单独编码作为视角关系标记。最终条件序列包含图像、深度、掩码分块特征与参数标记,一并送入去噪网络。参数标记将相机投影矩阵、桌面高度压缩为向量,固定生成坐标系,让模型感知相机与桌面位置,输出姿态能够映射至真实物理空间。
为保留多种可行抓取方案,团队采用软胜者全取学习目标。针对同一物体的一组有效抓取姿态,注入相同噪声,训练过程引导网络拟合这批样本,仅择优逼近最匹配的姿态,避免对多种抓法取平均。模型学习环境内全部可行抓取模式,不会因姿态平均,生成物理上无法实现的中间假姿态。软胜者全取目标能够保留抓取任务的一对多分布,剔除平均插值产生的无效假姿态。 温度参数用于调节候选模式的保留范围:低温倾向只保留最优单模式,高温可同时保留多个近似可行方案,团队借此在多候选多样性与抓取保真度之间取得平衡。
03 训练里补精度,推理只打分
精度约束被嵌入训练阶段,依托可微灵巧手仿真器增加物理约束损失,由四项损失项组成。
-
大拇指接触项鼓励拇指稳定贴合物体;
-
对指项在距离最近的一组手指间计算接触,稳定抓取通常仅需部分手指参与;
-
闭合项约束拇指与对指从相反方向靠近,形成对跖抓取;
-
穿透项利用带符号距离场限制手指,避免模型输出手部穿透物体的姿态。
计算流程为:按掩码过滤深度图并反投影,得到目标物体局部点云;将预测抓取送入仿真器,获取手部表面接触点,逐点计算与物体点云的最小距离。为让网络优先学习抓取形态,再学习物理规则,团队采用延迟升温策略:前 10 个 epoch 关闭全部物理项,第 10 至 20 个 epoch,权重线性提升至 100。四项损失设置差异化权重,拇指、对指、穿透、闭合按 5:1:0.2:2 分配,拇指权重最高,契合它在稳定抓取中不可替代的作用。
推理阶段不再执行迭代优化。
模型基于同一条件并行采样 64 组噪声,解码得到 64 个候选抓取姿态,送入仿真器计算物理打分。打分公式融合三项指标:运动学闭合稳定性为主项,多指接触奖励鼓励更多手指参与抓取,安全惩罚项对轻微穿插线性扣分、对严重碰撞与缺失拇指对跖的姿态重度惩罚,直接过滤物理不可行候选,最终选取最高分方案。将物理精度约束前置到训练环节,推理仅保留并行解码与候选打分,彻底省去后优化步骤。 团队把物理约束嵌入训练目标,核心价值在于重塑模型本身。推理侧优化是在已生成姿态上局部调优,初始姿态偏差较大时容易发散;训练阶段融入物理规则,让网络从学习之初就偏向输出物理可行姿态,推理只需批量生成候选并择优。
整套方案的算力成本集中在数据生成与模型训练环节。
使用 A800 显卡生成几何数据库、视觉数据库,分别消耗约 5,000、17,000 GPU 小时;模型采用 AdamW 优化器,初始学习率与权重衰减均设为 1e-4,共训练 25 个 epoch。模型在拥有 24 个自由度的 Shadow 灵巧手上完成验证,该设备动作空间远大于平行夹爪,用于检验模型在高维姿态空间的生成能力。训练、推理统一使用 64 组并行抓取假设,既是训练阶段用于拟合抓取分布的样本集合,也是推理时的候选池规模,同一参数实现两处复用。
04 没见过的物体,也抓得稳
团队统一在 OmniDex 训练集上重新训练所有基线模型,不直接复用基线原有权重进行对比。
在标准桌面子集、第一视角输入条件下,OmniDex 抓取成功率达到 55.80%,碰撞规避率 84.12%,相比 DexGraspVLA 分别高出 14.81、2.68 个百分点。该成功率包含指尖补力技巧,移除该技巧后为 33.60%,所有基线对比均保持相同统计口径。面对模型从未见过的新物体,OmniDex 抓取成功率仍可达 59.74%,高于 DexGraspVLA 的 54.97%。
陌生几何体上依旧保持稳定性能,证明模型能力并非仅局限于训练集中见过的物体。 同组数据中,开启指尖补力后,DexGraspNet 2.0 在见过物体上成功率 43.64%、未知物体 47.60%;面向语言指令的 Grasp-as-You-Say 仅有 1.68% 与 2.55%。这类语言驱动抓取方案在密集杂乱场景几乎失效,也印证拥挤环境高度依赖专门针对杂乱场景构建的训练数据。
在整套基准的五个子集、两种观测视角、「见过 / 未见过」两类物体评测中,OmniDex 基本维持领先或接近最优的水平,这也是论文将其称为当前杂乱场景灵巧手抓取最优方案的依据。
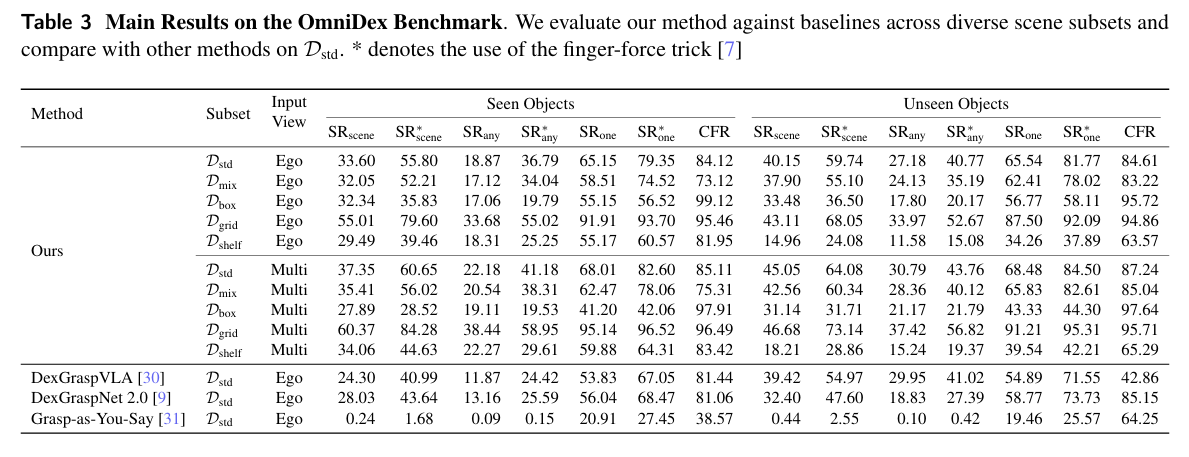
更换不同布局与支撑面,结论依旧成立。
五个子集中网格子集性能最优,第一视角抓取成功率 55.01%,多视角可达 60.37%。团队认为结构化排布带来稳定空间线索,模型可以依靠物体均匀间隔推断抓取位置;箱子子集难度最高,成功率仅 30% 出头,容器内物体高度堆叠、遮挡严重,机械手可伸入空间十分有限。多视角输入在绝大多数子集都能带来性能提升,标准桌面子集从第一视角 55.80% 提升至多视角 60.65%。箱子子集是少数特例,增加视角后指标小幅回落,说明极端密集场景下多视角不一定总能带来增益。
其余子集表现稳定:混合子集多视角下,见过物体成功率 56.02%、未知物体 60.34%;货架子集多视角 44.63%,纵向遮挡越严重,多视角信息的价值越突出。
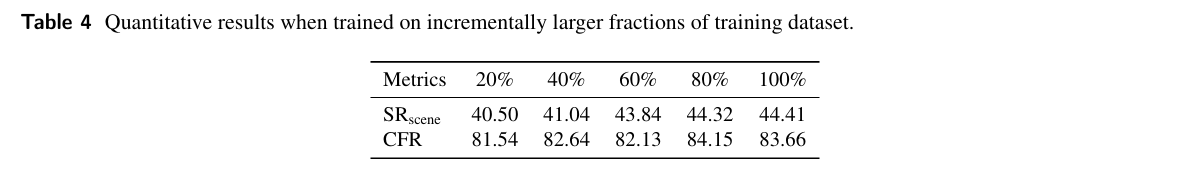
团队专门开展消融实验,验证扩大数据规模的收益。分别使用 20%、40%、60%、80%、100% 的完整训练集训练模型,抓取成功率由 40.50% 逐步提升至 44.41%,碰撞规避率从 81.54% 上升至 83.66%,碰撞规避率在 80% 数据量时达到峰值 84.15%。物体之间避让、避障这类复杂空间关系,必须依靠足量场景样本学习,这也是团队将数据集拓展至 260 万个场景的核心原因。
研究人员逐项拆解输入条件做消融。仅输入深度图,模型只能学到基础物体形态,成功率维持在 30% 区间;加入 RGB 图像引入语义与目标定位信息,性能明显上涨;补充相机参数,几何感知精度进一步提高;多视角输入带来最大幅度提升,全套多模态输入下成功率达到 49.87%。看似不起眼的桌面高度参数同样关键,坐标系原点以桌面中心为基准,它将深度反推得到的几何信息与抓取真值对齐,缺少该项指标会直接造成性能下滑。
团队还验证了各模型组件的价值:基础去噪损失容易生成多个抓取姿态的平均解,替换为软胜者全取目标后成功率显著提升;训练阶段嵌入的物理约束,决定毫米级接触能否成立;推理阶段改用物理打分代替随机挑选候选,将成功率从 30% 级别抬升至 40% 级别。
并行采样替代后优化的效果,也在消融实验中量化。并行候选数量从 1 增加至 64,抓取成功率从 36.08% 稳步提升到 44.41%,碰撞规避率由 79.71% 升至 83.66%,推理耗时仅从 219 毫秒增加至 1598 毫秒。如果改为推理时迭代优化,使用相同物理目标迭代 200 步,耗时达到约 6044 毫秒,但成功率仅 36.16%,碰撞规避率暴跌至 2.56%。团队发现迭代优化常常偏离有效抓取流形,越优化结果越不稳定,这正是选用并行候选打分方案的理由。
团队进一步做故障分析与可达性检验。
在标准桌面子集上统计失败原因:抓取失败案例中,95.71% 是成功建立接触后无法维持稳定抓取,仅 4.29% 是机械手根本没有触碰到物体;碰撞失败里 61.26% 撞击支撑面,38.74% 碰撞其他非目标物体。数据直观体现难点集中在抓取后的稳定性维持与杂乱环境避障。 可达性测试采用 Franka 机械臂,在第一视角侧设置五种基座摆放方式求解逆运动学。合格抓取方案中,83.75%~87.98% 处于机械臂可执行的可达空间,证明模型生成的抓取姿态大多能在真实机械臂上落地。
两类失败案例指明后续改进方向。
绝大多数抓取失败发生在接触建立之后,说明模型已经可以把手指送到目标位置,瓶颈在于维持稳定力闭合;六成碰撞失败是触碰支撑面,意味着机械手向下伸入时,对桌面的空间约束理解尚有不足,这也解释了桌面高度输入不可缺少的原因。
从定性效果来看,模型在差异巨大的场景布局下均可稳定工作。面对物体密集堆叠、多个外观近似物体紧邻摆放的场景,模型依然能够依靠目标掩码锁定抓取目标,输出可行抓取姿态。
仿真环境抓取有效,真机能否复现?
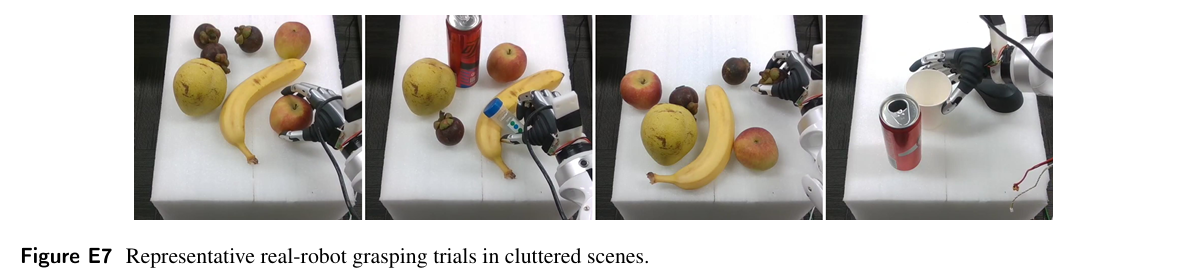
团队完成小规模硬件验证。基于适配硬件的小型数据集对 OmniDex 重新训练,采用 Tianji Marvin M6S 机械臂搭配 BrainCo Revo2 灵巧手,依靠 SAM 生成目标掩码,在摆放苹果、山竹、水杯等物体的杂乱场景开展抓取试验。真机相机机位复刻仿真环境的设定,让仿真学到的空间先验直接匹配真机观测。该试验以定性验证为主,论文没有给出真机抓取成功率,但证明仿真训练得到的抓取姿态可以迁移到真实硬件。
这套模型与配套基准,为杂乱场景灵巧手抓取提供了大规模、高复杂度的训练底座,让高自由度灵巧手的抓取生成不再需要每次推理都执行迭代后优化。 乱桌上的灵巧抓取想要从演示走向实用,正缺少这样一套底层支撑。