

不出声,也能语音输入?这副眼镜能把没说出口的话变成文字
作者:黄思喆
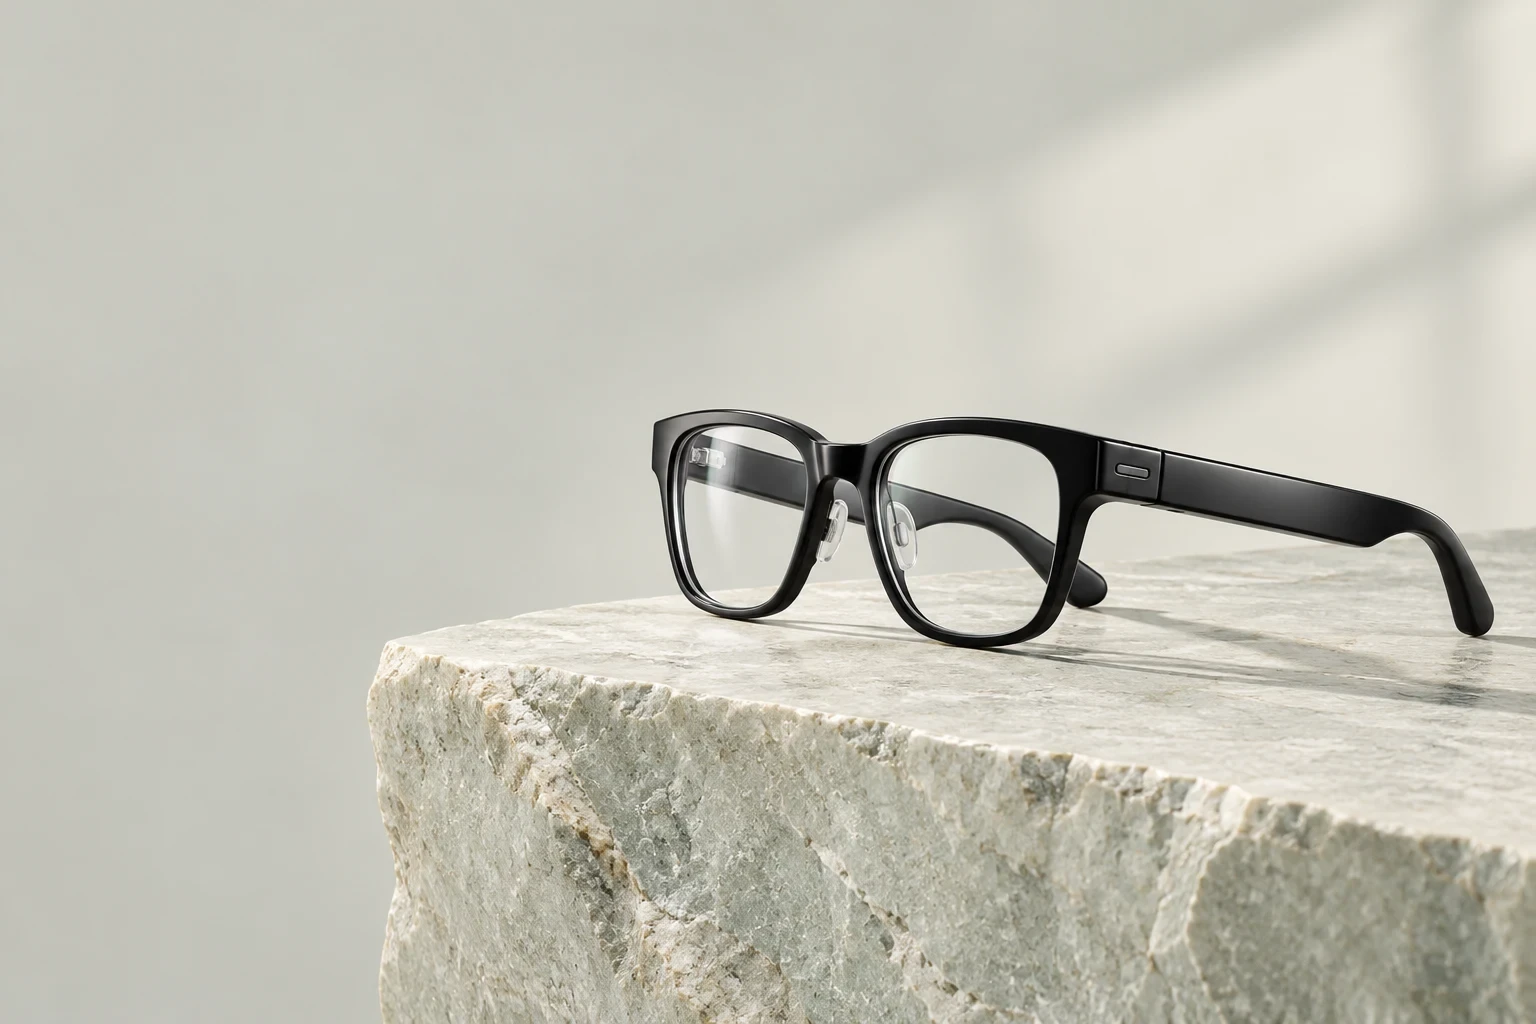
美国时间 10 月 30 日,创业公司 Subvocal 宣布获得由 Afore Capital 和 Y Combinator 投资的 130 万美元融资,并同步在官网开启了首款智能眼镜的预订,早鸟价定在 499 美元,预计 2027 年一季度发货。
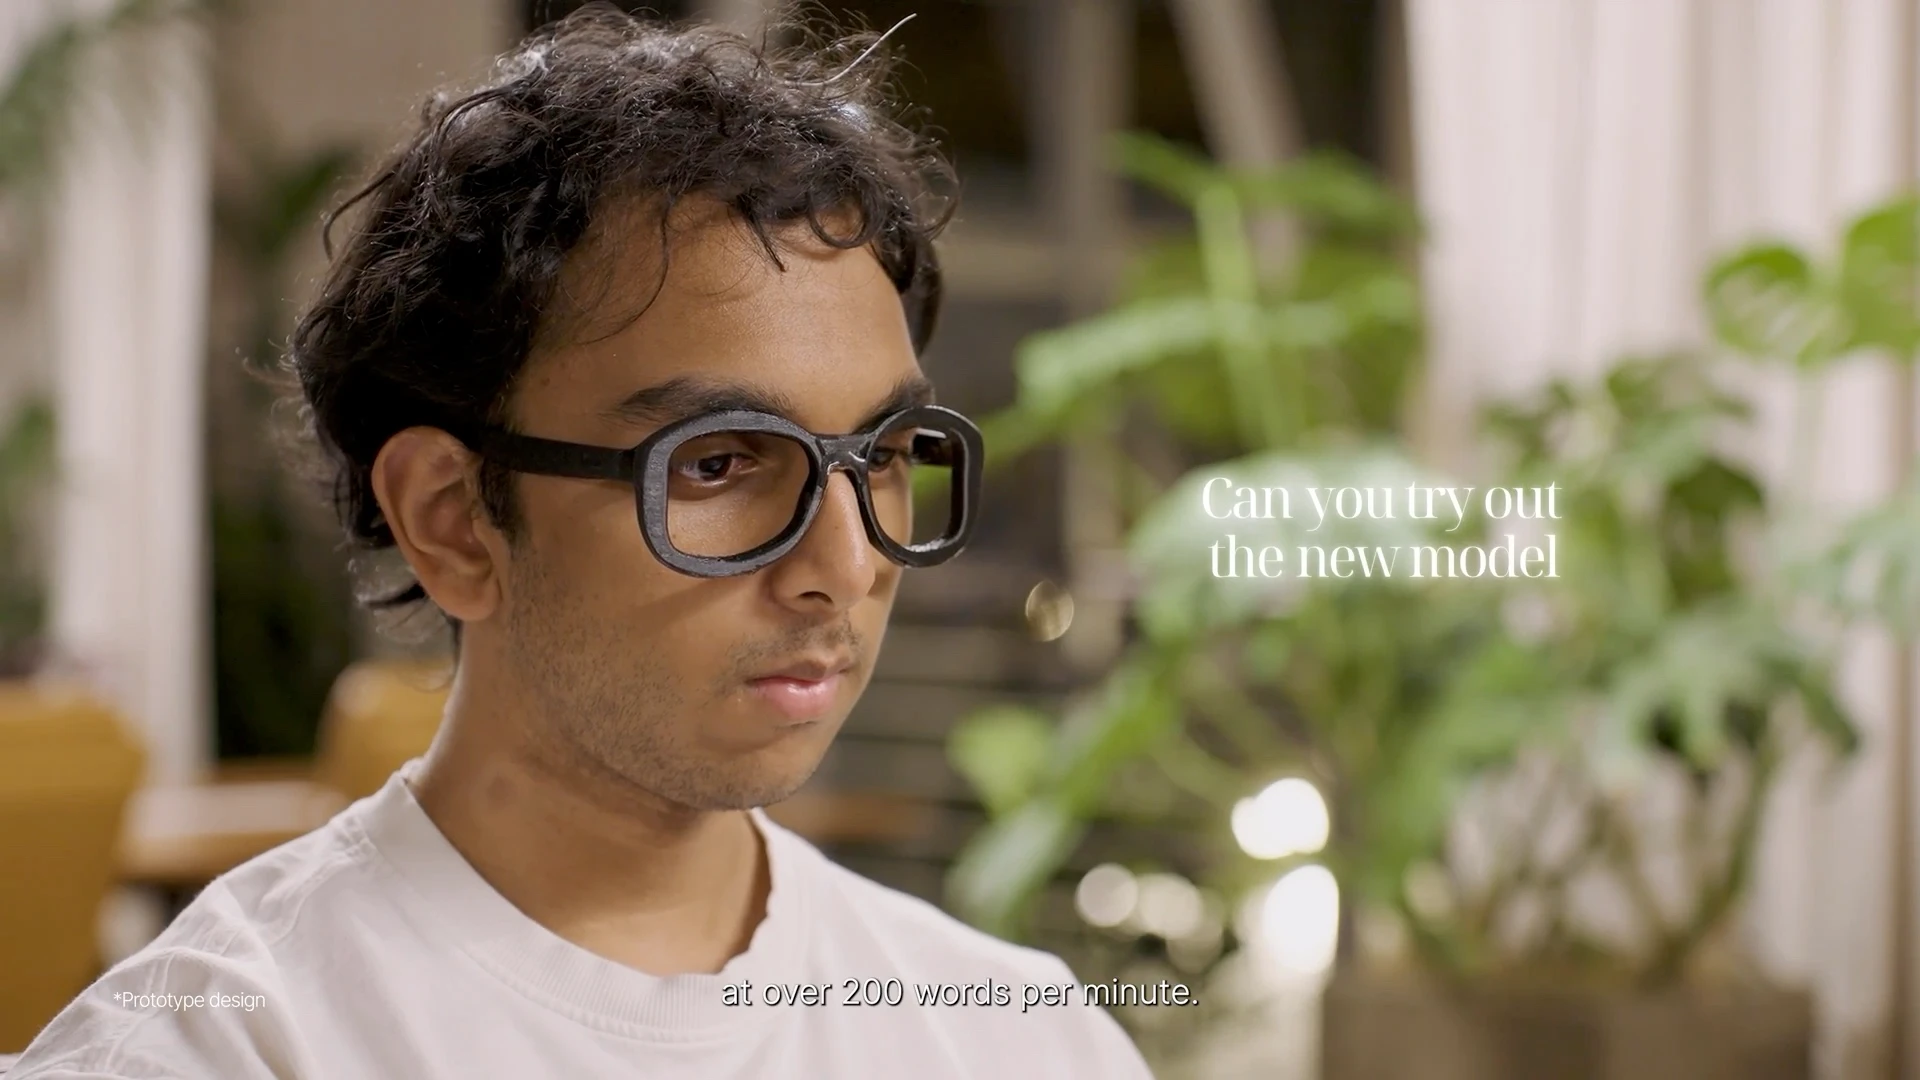
这副眼镜不能拍照,也没有彩色屏幕,它只干一件事:当你戴上它、不出声地动嘴「默念」句子时,可以把你的发音动作直接转成文字,输进电脑或手机里,官方宣称输入速度能超过每分钟 200 个英文单词。
这副还处在原型阶段的眼镜之所以引人注意,是因为它碰到了当下用随身 AI 设备时的一个痛点。现在的 AI 眼镜、耳机已经能帮人干不少活,但怎么把任务告诉它,依然是个麻烦事。眼镜上没有键盘,想输入一整段话,基本只能靠语音。Subvocal 联合创始人 Aarush Yadav 自己就有一副 Meta 智能眼镜,但他说自己平时很少用上面的 AI,原因是:「走在外面大声跟眼镜说话,实在太怪了。」
这就引出了一个问题:如果保留说话的动作,却不发出声音,Subvocal 到底想让人怎么输入,又凭什么把这些动作变成文字?
戴在脸上的「键盘」
虽然 Subvocal 长着一副眼镜的样子,但它并不是一台带屏幕、带摄像头的完整 AI 眼镜,目前也没有接入其他品牌的智能眼镜。按照公开的信息,它和这两年程序员常用的电脑语音听写工具 Wispr Flow 很像,只是把收音的麦克风换成了眼镜。
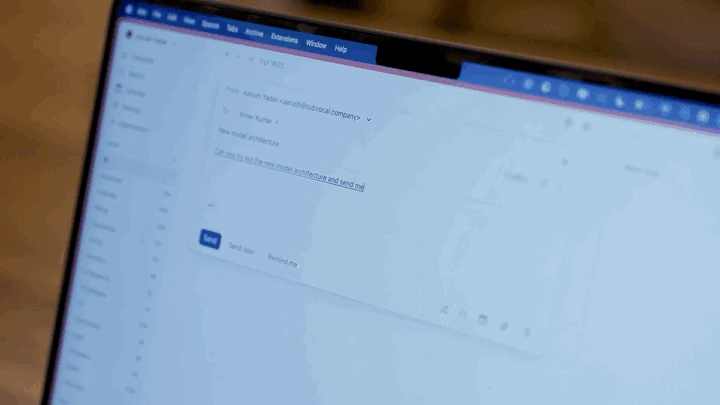
用户戴上眼镜后,在要输入文字的电脑或手机上按住一个触发键,然后不出声地做出说话的动作。眼镜采集到面部动作信号后,会先传给电脑或手机上的配套应用,再送到云端解码成文字,直接落在当前光标停着的位置。也就是说,文字最终输进哪个软件,完全看你的光标停在哪。它可以是聊天框、邮件正文、备忘录,也可以是电脑上正在跑的编程 Agent 输入框。官方也表示发货几个月后会开放 SDK。
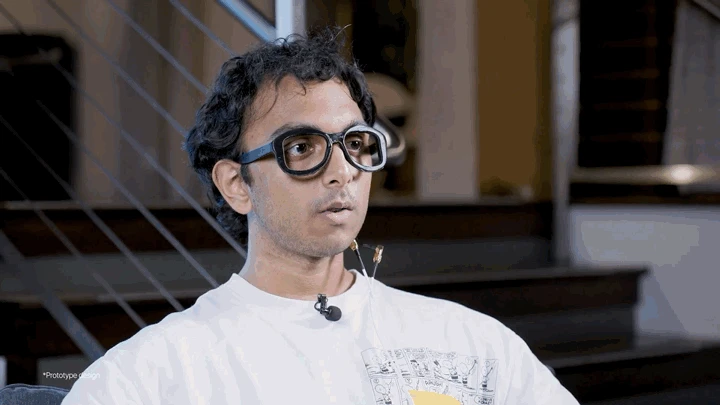
第一次戴上这副眼镜前,用户需要先做一步简短的个人校准。在官方放出的演示视频里,YC 合伙人 Dave Lieb 先对着屏幕读了 20 句话,让系统摸清他的发音习惯,随后就开始用无声口型往电脑里输入句子了。而需要摸清发音习惯,就意味着不同语言适配难度不同,首发版本只支持英语。团队表示其他语言要等硬件发货后,再通过软件更新陆续加入,第二个计划支持的是西班牙语。
团队虽然提过未来想在眼镜上加入开放式扬声器、自研的 Agent 工具甚至 AR 显示,但现阶段,它的功能就只有「输入」这一件事。在这项指标上,官方抛出的核心卖点就是开头提到的「每分钟 200 词以上」。普通人敲键盘打字的速度大约是每分钟 40 到 50 词,熟练的程序员能到 70 到 100 词,而人类正常说话的语速在 120 到 200 词之间。如果真能做到每分钟 200 词,意味着你不出声「默念」的速度,已经追上了正常开口说话的上限。
它怎么知道你在「说」什么?
人开口说话时,声带振动发出声音其实是最后一步。在声音出来之前,你的舌头、嘴唇、软腭和下颌,已经配合着摆到了对应的发音位置。
无声发音保留了前面这一整套肌肉和器官动作,只是省掉了声带振动。Subvocal 要捕捉的,就是这些动作。它采用的技术方案叫射频感知(RF Sensing)。按照创始人的解释,眼镜框里嵌着发射和接收天线,工作时会向面部发出类似蓝牙的低功率无线电波。
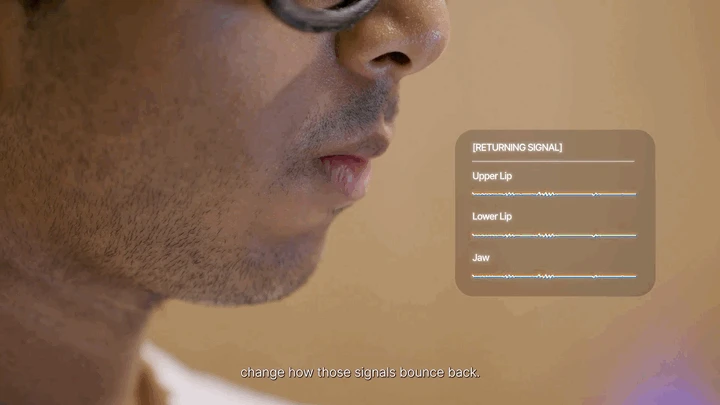
人的口腔内部有软组织、水和空气,这三种物质的介电常数各不相同。当你不出声地动嘴、动舌头时,电波穿过的介质环境跟着改变,信号的相位和幅度也会随之发生细微偏移。接收端记录下这些信号变化,再交给训练好的模型,把它们还原成对应的文字。
听起来有些玄乎,但其实原理并不复杂。首先,它需要你主动做出发音动作,并不是「意念打字」。官方 FAQ 专门澄清过,这副眼镜不会读取你脑子里一闪而过的念头。如果你只是在心里想事情,嘴巴和舌头没有刻意做出说话的动作,系统就什么也转写不出来。
团队倒是在内部测试一种更隐蔽的「内部语音」用法:完全闭上嘴唇,只靠舌头在口腔里动来发音。不过这种发力方式和正常说话区别非常大,普通人要学会得花不少时间练习,所以首发阶段不会作为主打功能推出。
其次,它和「摄像头拍嘴唇」走的是两条完全不同的技术路线。很多人看到「动嘴不出声」,第一反应是靠摄像头做视觉读唇。Subvocal 团队早期确实试过这条路,还用过开源读唇模型 Auto-AVSR,结果发现词错率降到 17% 左右就再也压不下去了。
卡住他们的是物理层面的信息量上限:英语里大约有 40 个音素,但能从嘴唇表面直接看出来的只有 12 到 15 种。比如发 P 和 B 的时候,嘴唇闭合的样子在镜头里几乎一模一样,不看口腔里面舌头和气流的配合,哪怕后面接上再强的语言模型,近两成的错误率也足够毁掉日常体验。
出于同样的原因,他们也排除了毫米波雷达和 IMU(惯性测量单元)。毫米波穿透不了皮肤组织,打到脸上就被反射回来,看到的还是外部口型,而且空间分辨率太粗;IMU 则只能测出脸部整体的震动,顶多用来分辨几个简单的指令词。只有能穿透脸颊、直接「看」到舌头和软腭动作的低功率射频,采集到的信息量才足够多。
另外,「没有声音」不等于「脸上毫无动作」。官方的说法是,离得很近的人可能会察觉到你嘴部有轻微动作,但在正常交谈距离下基本看不出来。
如果把 Subvocal 和几年前出圈的 AlterEgo 放在一起看,更能看清这类无声输入设备在采集方式上的取舍。2018 年,MIT 媒体实验室发布了无声语音设备 AlterEgo,当时用的是表面肌电(EMG)方案,靠贴在脸颊和下颌上的电极去拾取发音肌肉的微弱生物电信号。在当时的 10 人测试里,受试者先花 15 分钟做个人校准,在数字和算术这类有限词汇任务上做到了约 92% 的准确率。
Subvocal 两位创始人最初其实就是想复刻 AlterEgo,但很快意识到贴面电极没法做成日常消费品:人脸一出汗,肌电信号就会漂移;周围的电器容易带来电磁干扰;每次佩戴时电极贴偏一点,信号就全变了。更何况,没人愿意每天往脸上贴电极片。
把贴皮肤的电极换成嵌在镜框里的射频天线,最大的好处是没有穿戴负担。但代价也随之转移到了算法一侧:每个人的面部骨骼和口腔结构千差万别,射频穿过去产生的信号图案完全不同。团队试过用算法硬修,最后发现唯一管用的办法是堆预训练数据。他们在办公室里搭了几个隔间,花钱请不同的人戴上眼镜朗读提示词,靠扩大数据规模把不同用户的识别错误率往下压。
为什么要做成一副眼镜?
理解了射频感知的原理,就不难理解它为什么被做成了一副眼镜。这类低功率射频信号随着距离增加衰减得很快,发射和接收天线必须离嘴部和鼻腔足够近,而且每次佩戴时的相对角度不能差太多。
团队试过把传感器挪到笔记本电脑屏幕上方,结果距离太远,信号衰减得根本没法用;他们也考虑过做成夹在普通眼镜腿上的小配件,但不同人的镜框形状差异太大,天线位置没法保持一致。相比之下,一副眼镜架在鼻梁和耳朵上,不仅离发音器官近、位置相对固定,而且眼镜本来就是近视人群的必备品,不需要重新适应身上多件设备这件事。
这副眼镜形态,也是两位创始人在几个月里一步步试错试出来的。今年初,Yadav 和另一位创始人 Arnav Kumar 还在佐治亚理工学院读计算机,两人平时都是语音输入工具的重度用户,却一直苦于在图书馆和公共办公室里没法开口。2 月去斯坦福参加 TreeHacks 黑客松时,他们用 36 个小时做了一个往脸上贴肌电电极的粗糙原型,勉强能按字母拼出单词。虽然没在比赛里拿奖,但这个演示帮他们拿到了旧金山风投机构 Afore Capital 的早期支持。
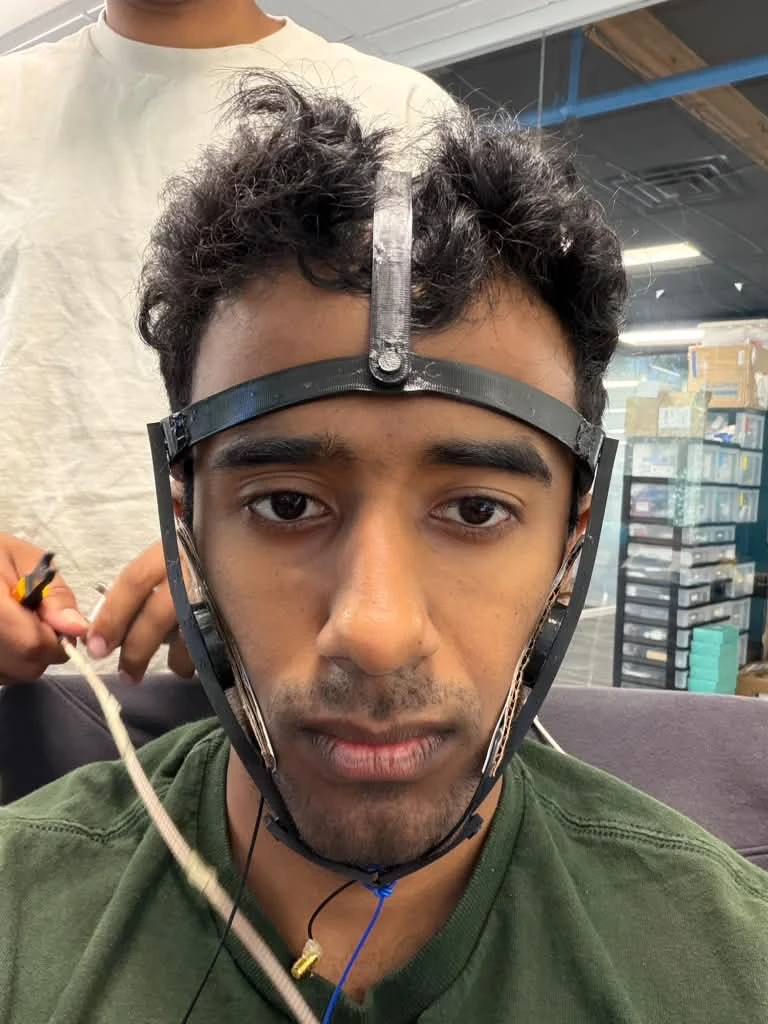
决定放弃肌电、改走射频路线后,他们做出的第一副眼镜原型彻底失败了,收不到可用信号。两人只好退回老办法,用胶带把射频天线直接贴在脸上测;因为每次胶带贴的位置和角度都对不准,他们又做了一个看着颇为怪异的头戴支架把天线固定在脸旁。直到确认这条路能跑通,才靠仿真一点点把天线重新设计进镜框里,并在近期拿到了 YC 和 Afore Capital 的这笔 130 万美元融资。
从理想到现实还有多少距离?
如果顺着射频感知的物理特性往下推,它想做到日常可用还需要解决几个问题。
最先要打问号的是「每分钟 200 词」背后的真实准确率。在无声语音(SSI)领域的学术论文里,无论是 MIT 的 AlterEgo 还是早期的脉冲超宽带(IR-UWB)雷达方案,90% 以上的准确率大多是在数字、算术或几十个固定指令词的「有限词汇表」里测出来的。一旦放开到日常连续说话,由于前后音节之间存在「协同发音」(前一个词的舌位会带偏后一个词的动作),光靠射频信号的相位和幅度变化其实很难把每个音素都拆干净。
Yadav 在回复技术追问时也承认,遇到模糊的发音(比如部分元音),系统很大程度上要靠后端的语言模型根据上下文去「猜」。这套逻辑在说普通长句时很管用,可一旦进到真实场景,比如上下文猜不出来的人名、电话号码、专业术语或者代码变量名,识别准确率就会大打折扣。
连续佩戴时的信号漂移是另一个问题。麦克风远几厘米,收音效果差别不大;但 Subvocal 用的是穿透面部的近场射频,接收端解算的正是电磁波穿过脸颊和口腔路径上的微弱相位偏移。这也解释了为什么团队早期用胶带往脸上贴天线时总是失败。只要天线角度和位置偏一点,穿过的组织厚度变了,信号基准就全乱了。人坐在工位上,低头看手机、抬头看屏幕,或者鼻梁出汗让镜框往下滑了两三毫米,天线与发音器官的重叠场就会移位,这时候识别率还能不能稳定,得打个问号。
另一个限制是它必须联网。受限于眼镜的体积和功耗,Subvocal 没法把模型塞进镜腿本地,只能先通过蓝牙传给手机或电脑,再发到云端解码。创始人透露目前未优化的端到端延迟在 500 毫秒以内,这意味着如果坐在信号时断时续的地铁里,很可能就用不了了。
把信息传上云端还会有隐私问题:虽然不用摄像头避开了图像采集,但你默念的每一句话都要先过一遍公司的服务器。Yadav 的解释是射频只在按键输入时开启,云端数据在硬件隔离环境里加密处理,连团队自己也看不了原始数据,未来也打算做本地模型。但作为一家初创公司,能否真正管住这批数据是个很现实的考验。
它给 AI 眼镜带来了怎样一种输入可能?
不管是乐奇手势戒指、Meta 肌电手环,还是 Subvocal 这种无声输入眼镜,其实都在解同一道题:人机交互怎么才能更便捷?
Subvocal 的思路是把采集发音动作的传感器放进镜框。如果这套方案能做进日常佩戴的眼镜,用户在不方便开口时,就有机会多一种输入文字的办法。
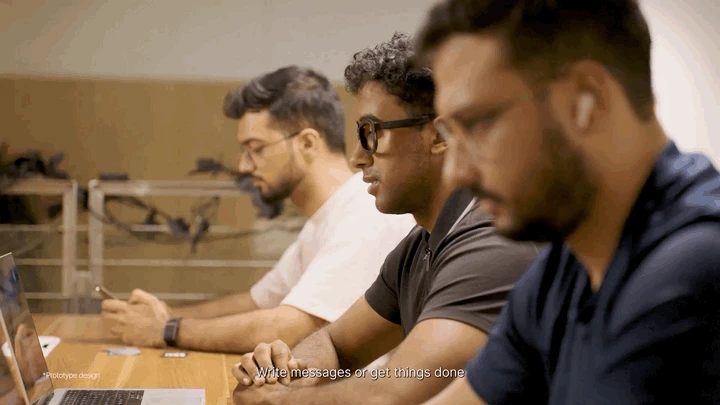
对乐奇、雷鸟、影目这些厂商来说,值不值得做,得看它能省下多少操作。比如开会时想回一句「晚点发你」,如果戴着眼镜就能输入、看一眼确认,再把消息发出去,那确实少掏了一次手机。要是开始输入和改字都还得回到手机上确认,那直接在手机上回可能更快。
至于传感器该放在镜框里,还是做成戒指、手环,得看整套东西怎么配合。真要多花一笔钱、多戴一件设备,我会先问一句:平时有哪些内容,会让我愿意用这副眼镜来输入?