

上海交大、创智学院、穹彻智能联合发布 UniFlowWAM: 当「流」成为模态
作者:王星宇
上海交大、创智学院、穹彻智能联合发布 UniFlowWAM: 当「流」成为模态
近半年来,有关 WAM 的研究越发出现一种趋势,即将物理世界的信号提取为抽象模态,成为数据并进入编码器中,用于具身模型的学习。积水成冰,随着越来越多的团队叩问什么样的编码形式最有利于模型的数据吸收效率,模态已不仅仅局限于世界知识、动作信息,或是世界与动作之间的耦合,而逐渐扩展至了时间、因果关系、未来状态等等。可以说,模态本身也在愈发抽象。

早在 9 月,前 Google 地图沉浸式视图产品经理、技术负责人 Bilawal Sidhu 便将对一种 3D「流」式模态形成了一段演示。通过将时间与空间相结合,基于物体或对象的运动轨迹,世界与物体的动作变化以 4D 形式重建出来。「流」概念的多象性使人看到了更多可能。
UniFlowWAM 之前,上海交通大学 MVIG 实验室、上海创智学院、穹彻智能发表于 ECCV 2026 的 ChronoFlow-Policy 和 LaMP 已经将三维交互流确立为观测理解与动作预测之间的中介信号。UniFlowWAM 便是他们的最新力作。

论文链接:https://www.alphaxiv.org/abs/2610.30991
项目主页:https://kksham111.github.io/UniFlowWAM_ProjectPage/
上海交通大学视觉与智能(MVIG)实验室联合上海创智学院、穹彻智能最新发布了 UniFlowWAM。据悉,这是一种融合视觉语义与 4D 几何的统一世界 — 动作模型,能够将 3D 场景流提升为与视觉、动作地位对等的第三种模态。该研究的共同第一作者为 Jialin Tian、 Zhuofan Li ,二人同为上海交通大学 MVIG 实验室成员。团队中的重要学者包含上海交通大学人工智能学院副院长、穹彻智能联合创始人兼 CEO卢策吾教授,上海交通大学人工智能学院助理教授、穹彻智能杨理欣担任通讯作者。
怎么理解这种 3D 场景流?作为一种全新模态,模型该如何在模态之间形成注意?
从「光」到 3D 场景流
在经典方法中,流是一种描绘物理世界中物体移动的一道痕迹,流即是一道带有物理意义的线。这一帧的某个像素在下一帧移动到了哪里?怎么行动?因此,我们通过流的形式来描述图像平面上的二维位移。
不过,用二维的流描绘 3D 空间的物体位移有着明显的局限。容易想见,物体在三维空间中的真实运动,以及相机视角带来的投影变化,并不一定能够通过流来完整重建动作轨迹,比如物体旋转,或者只是局部颤动,在这样的情形下,二维流便很难适用。
流在 VLA 或 WAM 的部分研究中得到使用。比如,在如 Im2Flow2Act、PointAction 等的用法中,流直接充当感知与控制之间的显式接口,让其作为中间表征得到先行预测,再在单独阶段转换为动作;也可以将流用在单个策略内部,诸如 TraceVLA、MolmoAct、3D Flow Diffusion Policy、LaMP 等在推理时以跟踪到或预测出的流作为动作的条件,来增强策略;又或者只是将其当作一种训练信号,而不成为接口或策略。当然,也有形如 UMA 等将 3D 关键点轨迹与动作绑定在一起联合学习的用法。
**「流」对于统一的未来预测和动作学习有着极大的参考价值。**UWM、UVA 等模型就是既学习预判动作的视觉后果,也学习从未来视觉特征反推动作。虽然这些特征捕捉了未来目标图像中的语义,却没有明确描述三维场景如何演化到该状态。
那么,UniFlowWAM 提出的 3D 场景流与前述的「流」有着怎样的特异性呢?

对 UniFlowWAM 而言,学习三维点的流式轨迹能够改进预测动作。通过显式地监督场景点的三维位移,UniFlowWAM 能够超越基于深度的目标所监督的几何状态,把未来视觉语义与来自场景级 3D 流的 4D 几何结合起来,将「流」提升至与动作、视觉、语义持同等地位的模态。要让它们彼此结合在一起,3D 场景流就不能只是一个输入。
基于 3D 场景流的 Transformer
捕捉到了这一点后,UniFlowWAM 团队提出了基于扩散 Transformer 架构的统一世界—动作模型,它的每种模态配备一个专家,三个专家通过联合注意力交换信息。

UniFlowWAM 从用于策略学习的同一批演示片段中,用单目 3D 跟踪器提取点图与场景流,再用冻结的 4D VAE 编码,输出流式的 Latent。基于 DINOv3 Encoder、Action Encoder 编码器,语义、视觉两个模态同步拥有自己的专家,三者仅通过共享的联合注意力交换信息。进入中训练与后训练阶段后,再把流加入一个预训练视觉—动作模型。视觉与动作专家从预训练权重出发,流专家则从零开始训练,随后三个专家联合训练,使预训练表征适应这一新模态。
模型的每种功能都对应一个训练目标,每一列即代表一个目标。策略、视觉预测、流预测等十个目标构成角色网格,为每种模态分配「目标」「条件」或「缺失」三种角色之一。实心方块表示干净的条件输入,噪点方块表示被加噪、需要预测的目标,空白方块则是学习到的占位符。由于每个目标只有一个目标模态,该网格覆盖了动作预测中「流」与「未来视觉特征」存在与否的全部四种组合,并为流预测与视觉预测各保留三个目标。
这种有意为之的不对称设计,优先照顾控制变量的条件选择。简单来说,当目标是动作时,「流」与视觉特征的存在与否恰好组成四种组合,而任务目标又覆盖了这些组合,为流预测与视觉预测各保留三个目标。这样一来,更多的条件组合就能留给「动作」。同时,不含流的四个目标,恰好恢复了预训练模型原本的任务集合,于是新模态可以在不破坏旧能力的前提下被接进来。在直接策略目标下,由于流分支已经携带学到的权重,部署时既不需要提取场景流,也不需要编码流,因此不难发现 policy 列只有动作是噪点目标,流与视觉都为空白。
实测效果
团队将 UniFlowWAM 分别放在仿真环境、分布外环境以及真机双臂任务中进行测试,以测试 UniFlowWAM 的学习能力、泛化能力以及真机效果。

在 RoboCasa-GR1 仿真测试中,UniFlowWAM 的最佳结果为58.9%,表现略低于 OpenWAM-alpha,而只加流、不做中训练的 UniFlowWAM 成功率在 54.84%,叠加中训练后成功率达到 56.38%。也就是说,相对公开发布的 LDA,仅接入流就带来 2.7 个百分点的提升,叠加中训练后提升扩大到 4.27 个百分点。
熟悉 OpenWAM-α 的研究者应该了解,OpenWAM 架构的开放性使其达到了理论上最佳的数据吸收效率,而 UniFlowWAM 紧随其后。从增益的分布可以发现,UniFlowWAM 尽管在基座上可能存在弱于 OpenWAM 的情况,但是 3D 场景流的模态一定程度上补全了这一点,对几何关系所体现的空间变化相应提升。
不过,UniFlowWAM 的中训练仅采用了 1,200 小时。由于 LDA 预训练使用了约 3 万小时规模的 EI-30k 语料,如果训练量进一步拉长,UniFlowWAM 的表现可能还会更好。
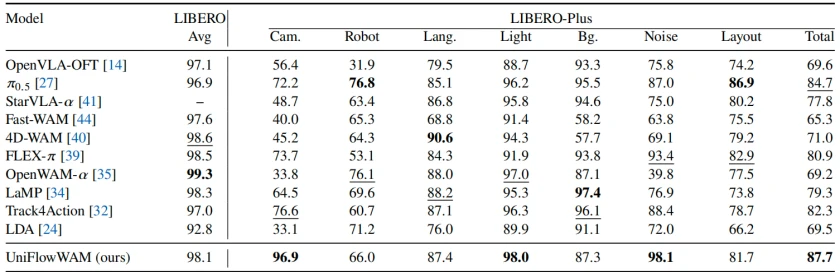
LIBERO 及 LIBERO Plus 两项测试上,UniFlowWAM 的表现十分亮眼。八项任务平均取得 98.1% 的成功率,明显优于 π0.5、FastWAM,但弱于 OpenWAM-alpha、4D WAM。进入 LIBERO PLUS,在七种扰动、10,030 个回合的零样本测试中,UniFlowWAM 的总成功率为 87.7%,优于 π0.5,并与 Track4Action、FLEX-π、LaMP 相比明显领先。拆分发现,UniFlowWAM 面对相机视角扰动、光照与传感器噪声有着惊人的优势,但是在机器人初始状态与物体布局扰动下,平均成功率明显降低。
这也反映出 2D 流沿用至 3D 场景流上独有的一种特点。正如之前所说的,「流」这种模态,虽然能够帮助形成很好的物体理解,这种理解形式在一个给定空间内的延续性使其具有抗相机、光影和噪声扰动的卓越优势,但如果本体不发生明显变化、场景也不出现变化,那么「流」就不起作用,或者会迅速在某个任务上坍缩,尽管它是 3D 的。
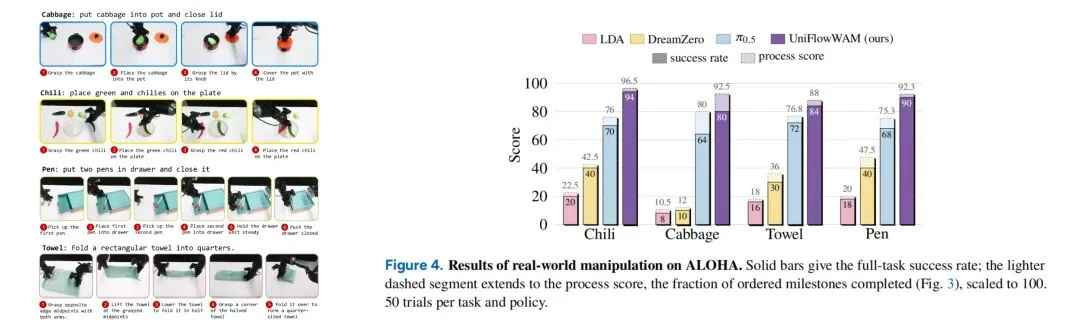
UniFlowWAM 采用 AgileX Cobot Magic 进行真机测试,分设抓取辣椒、转移卷心菜、把钢笔放入抽屉、叠毛巾。不同任务分设不同里程碑独立评分,包括卷心菜与辣椒(抓取、放入锅中、抓取并放置每个辣椒),笔(取放每支笔、用右夹爪稳住抽屉、把抽屉推上),毛巾(抓取、提起、对折、再折、压平)。其中,把钢笔放入抽屉、叠毛巾最考验双臂灵巧操作,叠毛巾还额外考验机器对于变形物体的视觉理解。如果模型在某次试验的某个里程碑失败、随后又在后面的里程碑成功,仍能获得后者的分数,最后取平均值。
结果显示,UniFlowWAM 以 87.0% 的平均成功率和 92.3 的过程分大幅领先 π0.5、DreamZero 与 LDA 。在四个任务上,UniFlowWAM 都取得了最强表现。其中值得注意的是,UniFlowWAM 在转移卷心菜任务中的成功率与过程分指标偏离非常明显。团队提到,UniFlowWAM 在锅扔盖上时抓取并放置卷心菜,导致其从中滚出,在该实验中,UniFlowWAM 在结尾处仍有一小部分失败,却完成了 92.5% 的里程碑。

这一主要原因可能在于「流」及多种模态创造的解释力到达了极限。由于 3D 流记录的是点怎么移动,不记录力、摩擦、质量与形变,亦有可能由于训练时学到的 4D 几何表征并没有得到短程推演、流的中训练时长不足等等。在接触密集的环节,双手灵巧操作仍然有较大难度。随着跟踪模型不断改进,流的提取有望更快、更准,从而使流像视频一样更容易在机器人训练中扩展。未来,团队计划开展更大规模的联合预训练。
怎样的模态才最有效
在「流」的选型上,4D VAE 并不是最初的选择。
在探索与 3D 流联合训练的过程中,团队曾尝试过几种效果不佳的设计。一种是用图像 VAE 编码流,即把 Im2Flow2Act 中把 2D 点轨迹写入图像通道再编码的方法扩展至 3D。尽管 VAE 能忠实重建这些图像,流去噪损失也正常下降,然而生成的流对每个输入几乎相同,模型会坍缩到数据集上的平均流,从未产生可用的流。
**另一种则是对流模态做门控。**为保留 LDA 骨干在预训练中学到的东西,团队也曾打算通过逐层门控注意力 logits,让流从既有 token 到流 token 的连接逐渐放开,但收效甚微。
作为具身模型技术发生在内部的一种趋势,「流」让模型编码状态之间的转移。不过,它的局限在哪?在模态、策略和显式接口,「流」似乎已经用尽了可以进入模型架构的形式。其所使用 4D VAE 编码器的运作机制,是让跟踪器对每一帧的每个像素给出一个三维点和它到下一帧的位移所产生的位置序列与位移序列分别编码,再拼成一个潜变量。换句话说,它是一门运动学语言,哪里有点、点往哪动、动多少,在不涉及实际物理量的前提下重建状态的解析形式。无独有偶,新近发布的自然意志 Natura-1 当中亦出现类似「流」的另一种形式,即基于流匹配的多模态统一序列。
除此之外,由于这条流经过 Track4World 从示范视频里跟踪出来,有时也会报错,比如产生时序上的不一致,连续轨迹中突然发生方向反转,在 SAM 分割下丢失部分背景和上下文等等。更重要的是,「流」式预测对真正产生物体接触的部分很难起到作用,即在夹爪与物体的交界处易产生遮挡。再加上,抽屉的铰接约束、笔与抽屉的配合、毛巾的折叠拓扑都没有显式变量,既不够用,要支持这些变量的输入,也需要大量的数据。
总的来看,这种形式似乎在哪还差了一口气,还有更进一步的空间。留待考虑的是,由于 UniFlowWAM 所使用的「流」聚焦于策略,它在物理世界是否过于单薄?「流」的改进需要发生在「流」的内部还是模型的外部?
于是回到最初的问题:对于具身模型,什么样的模态才最有效?或者更进一步,模态内部,什么是更重要的部分?显然,信息不是越多越好。建构一个有效的模态取决于它的阐释力、使用方式和实证数据支撑,至少要满足四个条件:它要显式描述状态的转移,而不只是状态本身;它要有自己的监督信号,而不只是别的任务的副产品;它要能作为条件被查询,也要能作为目标被预测;它还要与其他模态共享同一套时空坐标,否则联合注意力便无从谈起。
UniFlowWAM 足以启示,「流」式建模对于物理现实有着较高的应用性和阐释力,也许它将对具身智能有更长远的意义。让模型「预测流」,强迫模型自己在潜空间里重建三维位移,相当于让机器把物体的几何动力内化理解。把「世界模型」从视觉层面的想象往几何层面的理解推进一步,远比仅「读取流」更高效。不过,任何一个模态都有其边界,不可能在所有维度上都表现得完美无缺,更待考虑的也许是接近物理世界的模态与其他模态之间的组合方式。未来,考虑如何将这种「流」升级成含接触、力、形变的统一状态或带有折叠性的表征,让显式的接触状态、力/触觉、形变梯度、物体与关节结构在实际训练和推理中彼此配合,形成毫秒级计算、高度拟合的机器理解,到那时,或许「流」将获得新的形态,也将是一个有趣的方向。