

对话简智朱雁鸣:一千万小时 Ego,也不够
具身数据的下一站,不是继续卖「小时数」。
具身智能的数据竞争,正在经历一个「跑分」的阶段。
公司开始用数十万、数百万小时说明产能,采集设备从夹爪、头戴式相机延伸到腕部相机、全身动作和触觉;一些模型公司买走越来越多的人类演示,期待量变能让机器人出现类似语言模型的能力涌现。
但当行业终于学会用「百万小时」讲故事,简智机器人合伙人朱雁鸣已经开始反问:如果一千万小时里只有 Ego——也就是头戴相机记录的第一视角视频——它究竟能让模型学会什么?
在他看来,Ego 像大米饭:便宜,可以大量提供碳水,却不是完整的营养。机器人只看到人眼前的画面,看不到被手遮住的接触,不知道手指如何发力,也无法仅凭成功画面还原人在失败以后如何重试。所以数据的下一步不只是更多,还必须加入全身动作、腕部视觉、触觉和力反馈,并且让这些模态在同一时空坐标中对齐。
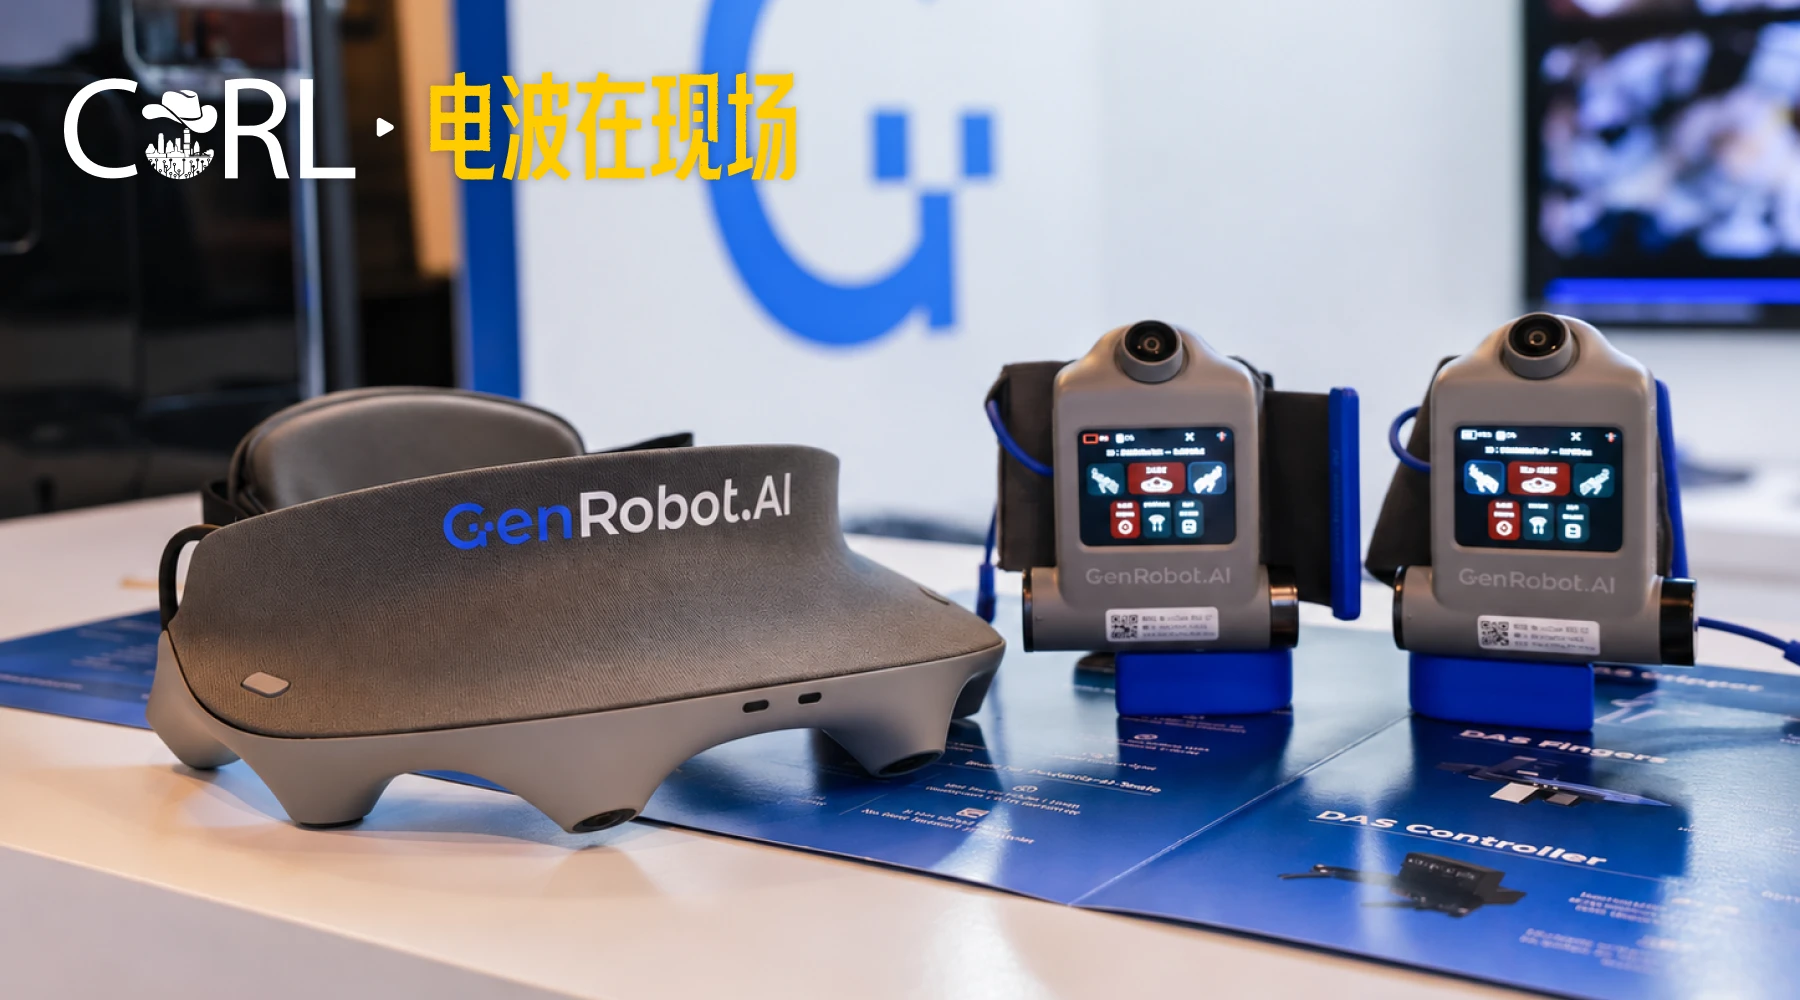
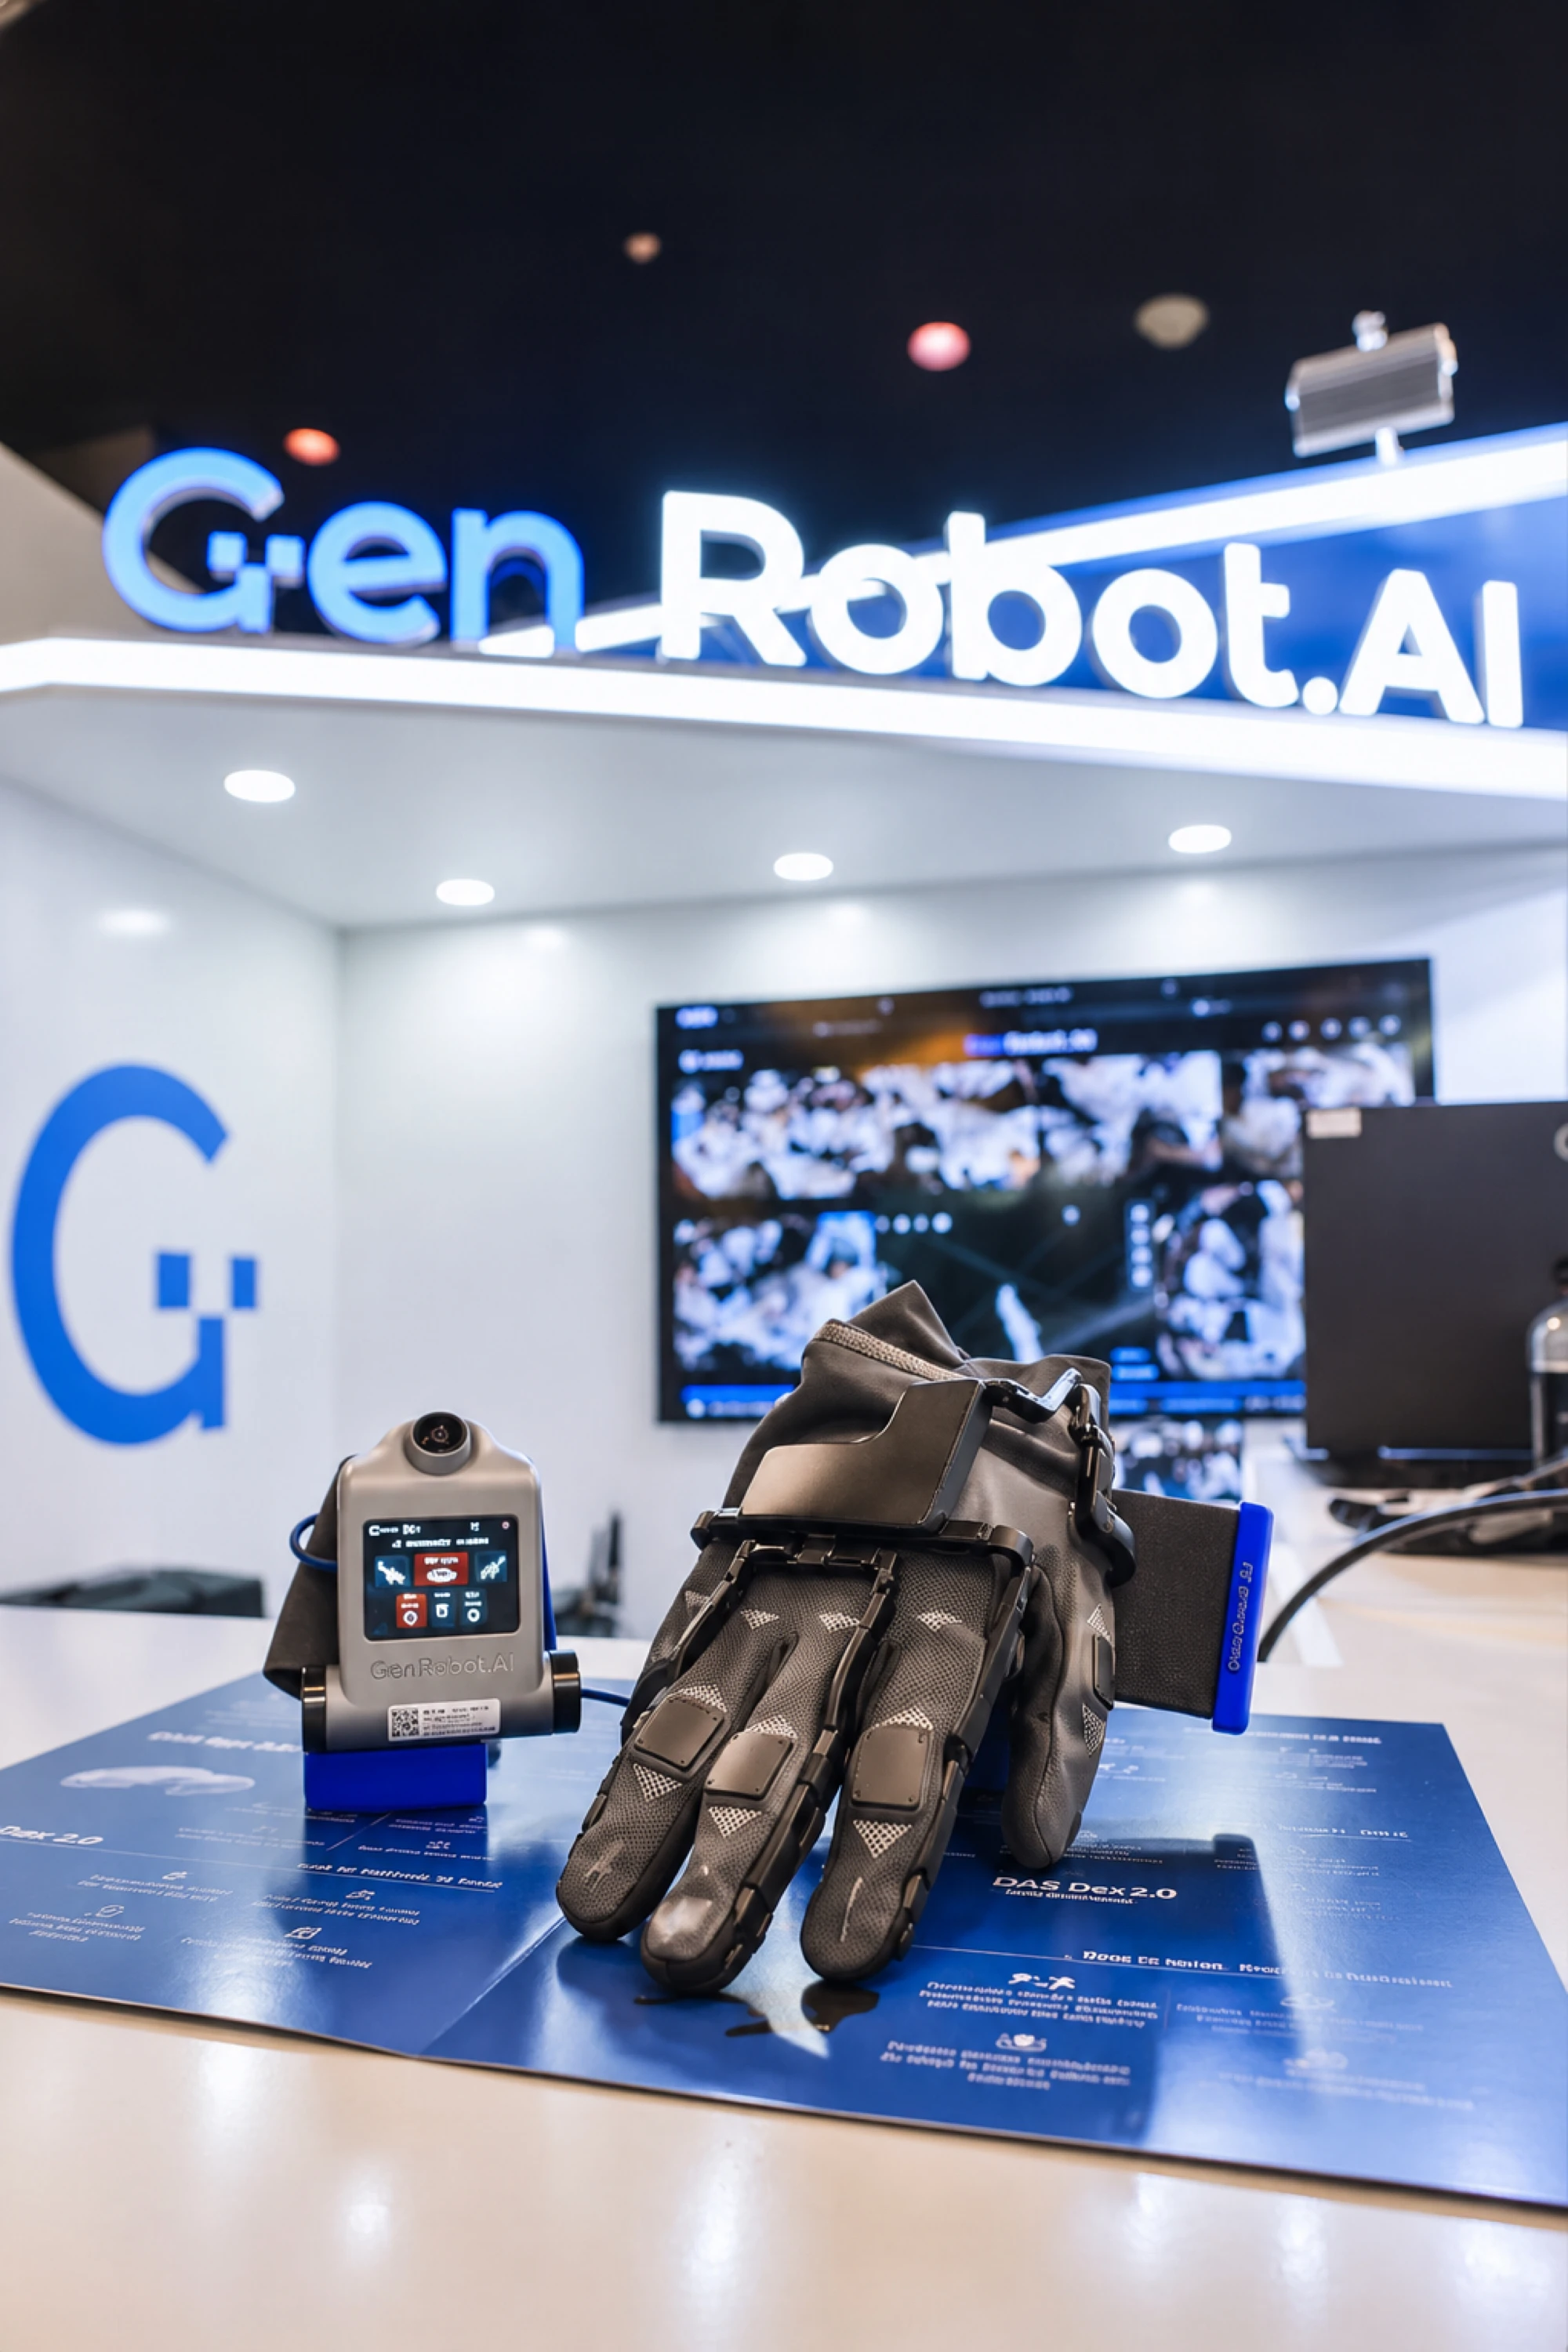
CoRL 2026 上,简智也把这套判断做成了新一代产品。公司正式展出 DAS 2.0 系列,包括第一视角多模态采集设备 DAS Ego 2.0、灵巧数据采集手套 DAS Dex 2.0 搭配腕部相机:Ego 负责记录环境与全身操作,腕部相机补足被遮挡的手部细节,Dex 则直接记录全掌构型、接触与触觉。
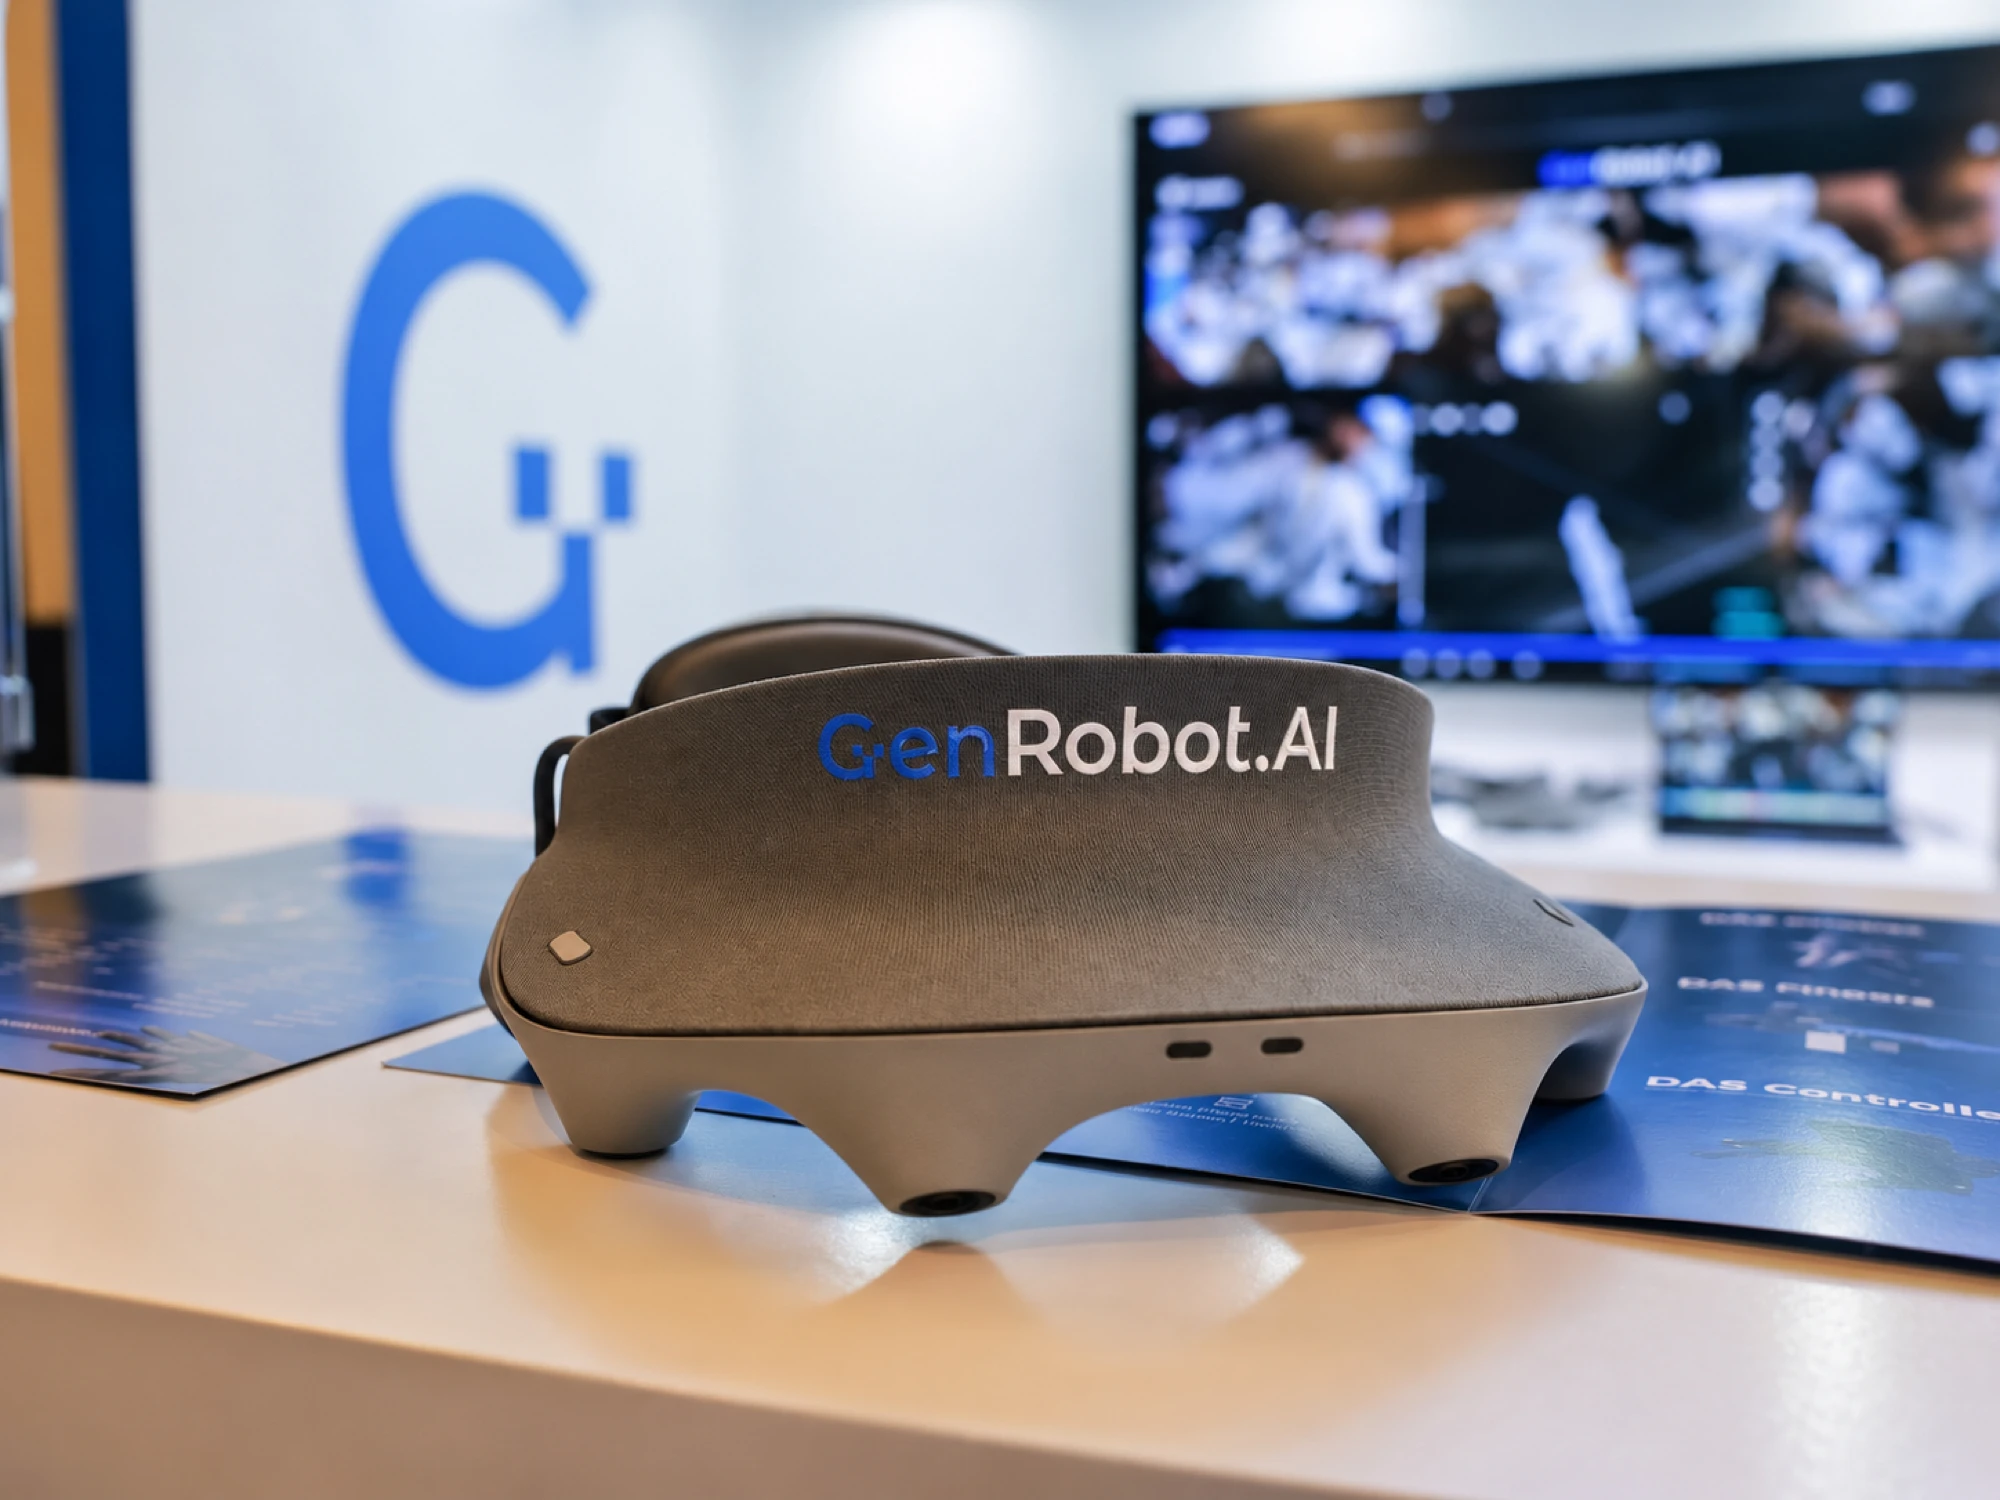
按照公司公布的规格,两套设备通过无线方式实现头手毫秒级同步;展台演示则把人的动作映射到机械臂与灵巧手上。它并没有证明人类数据已经可以普遍替代真机数据,却让简智的产品方向变得清楚:不再只记录「人看见了什么」,而是尝试记录人怎样接近、操作、接触并完成一项任务。
这个判断也解释了简智的产品形态。它自称一家物理 AI 数据基础设施公司,一边做 Gen DAS 采集设备,一边做数据治理和产线。官网展示的数据类型已经从 Ego 延伸到手指、全身、触觉和可供模型使用的结构化结果。这不只是「多装几个传感器」,而是一个更底层的判断:模型最需要什么数据,将会反过来决定采集硬件,甚至决定未来机器人该带什么传感器。
简智成立于 2025 年。2026 年 11 月公开信息显示,公司完成 1 亿美元 A+ 轮融资;按公司口径,单季度有效数据交付量已由十万小时级提升至百万小时级,并将单季度千万小时作为下一目标。这些数字让朱雁鸣的反问更有意思:一家正在追求规模的数据公司,却在强调规模不是答案。
朱雁鸣过去长期从事端到端智能驾驶量产产品,现在负责简智的产品、市场与北美业务。他把从智能驾驶转向机器人解释为「升维」:驾驶主要是二维空间中的决策,机器人需要处理三维空间、接触与人类知识。如果更高维的问题真被解决,驾驶可能只是能力的一个子集。
他不断追问模型的输入、真值和评测究竟是什么;又保留了对真实世界的警惕:仿真不是真实,Demo 不是部署,最后几步可能与前面二十步花费同样长的时间。
CoRL 2026 期间,我们在奥斯汀的一张饭桌上聊了近两个小时。餐盘刚端上来,朱雁鸣随手拿大米饭解释 Ego;聊到仿真、WAM、同行和融资时,他也没有收起自己的判断。
以下是 42 号电波与简智机器人联合创始人朱雁鸣的对话,经编辑整理。
增长之外,他更在意「升维」
42 号电波: 智能驾驶还没有结束,为什么这两年还是有很多人从智驾转向具身?你离开也是在寻找更快的增长吗?
朱雁鸣: 智能驾驶肯定没有结束,还有很多问题可以解决。
大家转到具身,第一个原因当然是想找增长更快的东西。智驾以前从 60 分长到 80 分,一年可以长很多;现在是从 90 分到 95 分,再从 95 分到 99 分。付出可能一样,但外界看到的增长会慢很多。
第二个原因,对我来说更重要:具身智能是一个更高维度的产品。大家会开玩笑说,如果 Robotics 做得足够好,可能都不需要单独的自动驾驶了,机器人可以像人一样坐在主驾开车。这当然有些夸张,但它代表一个问题:如果把更高维的问题做完整,其他任务可能只是降维。
42 号电波: 「升维」具体是什么?
朱雁鸣: 你到底是在解决一个更大的问题,还是一个更小的问题?
自动驾驶本质上更像二维空间的规划;机器人有身体,它是三维空间里的规划,还需要处理接触和更底层的人类认知。驾驶的问题当然也很难,但与人每天处理的全部问题相比,它可能只是其中一小部分。
所以,我转到这里有增长的原因,但更底层的思考是升维。
42 号电波: 你们做了一年多,行业发展比你预期快,还是慢?今年出现了百万小时数据,也出现了一些新模型和 Demo。
朱雁鸣: 我一直比较理性。刚开始融资时,很多资本会问:你们怎么看行业的发展速度?
发展得快有好处,大家可以更快拿到回报;坏处是,如果三年就做完了,反而说明这件事没有那么难,积累也没有那么高。
我们一直把具身看成比智能驾驶更长周期的事。智驾已经做了十年,现在大家还在 L2 上挣扎,因为真实世界的问题比实验室可以穷举的部分复杂得多。具身也一样,我觉得可能需要十年。今天更像十年中的头三年:还在争论技术路线,也在争论每条路线需要什么基础设施。
42 号电波: CoRL 上出现了很多 WAM(World Action Model)的讨论。你怎么看这条路线?
朱雁鸣: 把 Action 和 Video 同步预测,我觉得有突破性,也很有启发。
它可以在 System 0 或系统的某些特征模块上发挥价值,处理传统模型不擅长的空间和视频信息。但长期来看,我觉得 System 1 和 System 2 会被一个端到端方案吃掉,可能只有高频、快速的底层动作需要单独节点。
人拿起一个杯子时,假设、规划、决策和动作输出其实是一体的。把它们拆开,中间就需要不断交互。所以终局也不是今天纯粹的 VLA,但我认为 Language-based 架构的上限仍然比纯 Video-based 高很多。
42 号电波: 如果最后是 One Model,那是不是大语言模型公司会吃掉很多价值?
朱雁鸣: 这已经是趋势了。今天把大模型直接放到机器人上,它已经能够 Work;大模型公司已经有很好的基础,真要投入做机器人,这个起点在这的。
后面要做 Scaling,要面对非常多样的场景,一家具身公司的知识和大模型 Know-how 很难比大模型公司更多。比如让机器人去那家店取一瓶酒:什么是「那家店」,什么是酒,什么是品牌?这是很实在的价值。
数据开始反过来定义硬件
42 号电波: 但大模型公司就算吃掉了「大脑」,硬件与部署仍然是一条很长的链条。
朱雁鸣: 大家以前说硬件,更喜欢看机器人硬件。但本质上不只是这样,现在很多硬件其实是由数据决定的。
所有事情的核心一定是模型。模型用什么数据成长得最好,这应该是做很多决策的第一选择。如果一种数据不利于模型成长,却因为它采集方便就选它,等于自断一臂。
现在的方向是 Human Data,从人的角度出发,把人与世界的交互重建出来。如果训练数据使用某一类触觉传感器,部署时机器人上的触觉传感器大概也会向它靠近,否则就会出现分布差异。所以行业不只要考虑硬件能不能在部署中 Work,也要考虑它能不能生产出模型需要的数据。
42 号电波: 你们从今年 2 月就开始做触觉。对一个数据采集系统来说,触觉最难的是什么?
朱雁鸣: 触觉有一个三角:精度或灵敏度、可靠性,以及能否连续、完整地记录一个操作。精度很高,但只能记一个瞬间,也不够。
传统的一些磁触或电容方案,精度可以,但很多是一块较硬的板。人手是弧面,也是柔软的,接触物体时会变形,压力也在连续变化。硬板很难完整表达这个过程。
织物类方案可以跟随手的形状变化,但精度和稳定性又是问题,电路之间容易串扰。同一个拧瓶盖动作,两次检测结果可能不一致。
我们的方案想平衡这三点。按我们的产品方案,材料用石墨烯 3D 打印,是一种半柔性材料。它能够跟随手的形状变化,又尽量降低基底和材料本身形变带来的相互干扰。
42 号电波: 我们中午去展台试戴了,戴在手上确实没有太强的存在感。你们是因为客户提出了需求,才开始做触觉吗?
朱雁鸣: 这个要自己做判断。客户告诉你,到你能做出来,至少要半年。
具身行业就是这样,你要敢于去赌。更准确地说,你要先想清楚一条主线,再看主线下需要哪些能力,然后提前准备。它一定是不明确的;明确就说明已经被验证,也说明别人先做出来了。
42 号电波: 你们当初怎么确定 Human Data 这条主线?
朱雁鸣: 我们一直相信 Human Data,Ego 只是 Human Data 的一部分。
如果想让一个模型不断学习和进化,上一个阶段的方法是遥操:直接学某一个本体下的某一类操作。它的问题是,数据和学到的能力被困在这个本体里。如果今天用夹爪遥操,明天换成人形机器人,数据还能不能用?大量内容是很难直接使用的。
反过来,如果采的是人的数据,映射到夹爪上却有可能。可以只提取人的两根手指,映射到两指夹爪。
所以我们当时问:这个阶段里,最高维度的产品是什么?答案其实是人。人也是一种机器人,而且人的传感器比现在所有机器人都强。如果能把人的信息完整恢复出来,往其他本体上部署就是降维。
42 号电波: 你说「完整恢复人的信息」,不只是把动作记录下来吧?
朱雁鸣: 模型学的不只是动作,还有思考过程、反馈,以及反馈以后的重试。遥操可以让机器人学会怎么拿、怎么放,却不一定把前因后果和交互过程完整记录下来。
确定 Human Data 以后,我们再看它缺什么。视觉有了,人的逻辑可以通过文本表达;还缺触觉和力反馈。人判断东西是不是拿起来,不只靠眼睛看,也靠手上的力反馈。你看起来已经拿起来,但手里仍然轻飘飘的,就会知道结果不对。
42 号电波: 不少全身数据方案在人身上加外骨骼,你们却主要用视频重建 Whole Body。为什么?
朱雁鸣: 外骨骼很有价值,它很像模型评测里的 Ground Truth,可以校正关节动作。但它很难 Scale,而且这不只是硬件问题,还是思路问题。
我们要问,输入模型的究竟是一具骨架,还是一个人体?我拿杯子,胳膊接触桌面,真正发生交互的不是骨骼,是皮肤和身体表面。人还有高矮胖瘦,只看骨架,无法解释为什么某个人在离桌面还有一段距离时就停了。
所以我们做 Whole Body,先从空间重建中建立人体的体积和表面,再去推断 Contact。外骨骼可以作为辅助真值,但物理世界的交互主体仍然是完整的身体。
42 号电波: 那么设备会不会越来越复杂?
朱雁鸣: 精度一定会提高,复杂度却不一定。
在我看来,有两个必备主模态:视觉和触觉。视频本身能承载非常多信息,触觉可以先从手上做。其他东西很多是过程性方案:当视觉硬件或算法还不够好,就用外骨骼或电磁定位补足精度。如果像素足够高,手和全身重建也足够强,外挂的东西反而可以变少。
简单不代表能力要弱。相机、多视角、重建和触觉中的每一项都要足够强,否则就会不断加挂件。
42 号电波: 如果 Whole Body 主要靠视觉重建,精度怎样继续提高?只是换像素更高的相机吗?
朱雁鸣: 硬件和算法都有问题。
硬件上,第一要有多视角监督。单一视角不仅有遮挡,也很难准确恢复物体的相对空间位置。我们用自监督学习,多台相机从不同角度看同一根手指,本质上是多个信息源相互监督。一个角度下手指与背景的特征不明显,换一个光线和视角,特征可能就清楚了。
第二是像素。像素越稀疏,一个像素在真实空间中代表的误差就越大。提高像素并不是为了让画面更好看,而是为了降低空间重建中每个像素对应的物理误差。
算法上,如果继续用大量规则或传统 SLAM 做人的重建,迭代会很慢,也很容易为了一个场景 Overfit,另一个场景反而变差。我们想用一个大模型把人与空间的关系理清楚。这个问题以前很少有人做,也带来了新的问题:模型的输入是什么,真值是什么,评测又是什么?
42 号电波: 你们考虑过肌电数据吗?现在也有公司用肌电手环捕捉人的动作意图。
朱雁鸣: 我们不考虑,因为它太间接。
肌电信号会受到皮肤、脂肪厚度和个人生理状态影响,本身也不是手部动作的直接测量。既然可以通过视觉看到手怎么运动,也可以用外骨骼直接测量关节,为什么还要选择变量更多的间接信号?
Sensor Fusion 不是传感器越多越好,传感器之间要形成互补。摄像头、激光雷达和毫米波雷达有各自擅长的环境和精度区间,所以能够互补;如果一种信号增加了更多不可控变量,却没有补上现有模态的缺口,多加一个传感器不一定更好。
42 号电波: 所以你们的推导方式是先想象行业最后需要什么模型,再定义自己做什么。
朱雁鸣: 是的。我前面说了很多技术和工程,但最本质的问题是:我们到底在训练一台机器人,还是在训练一个人?机器人只是载体。
如果一个模型已经接近人的能力,把它部署到某一台机器人上,跨本体就不该是最大的挑战。
42 号电波: 今年大家都在讲百万小时。你们怎么看数据规模?
朱雁鸣: 百万肯定不够。但在「百万」后面,先要看接下来的数据产品还是不是 Ego,还是需要更多东西。
Only Ego 肯定不够。即使到了一千万小时,如果只有 Ego,也还是不够。Ego 对环境和操作中的语言信息描述得不错,但对手的精细操作描述不够。人抓住物体时,物体与手指的关系已经被手遮住,第一视角根本看不见。
所以 Ego 就像我们吃的大米饭。它是碳水来源,最便宜,但营养不够。
42 号电波: 那维生素、蛋白质是什么?
朱雁鸣: Ego 加 Whole Body 可能是维生素,Ego 加腕部相机可能是蛋白质,再加手部触觉,才是更完整的营养套餐。
Whole Body 能够解释人为什么做这个动作,也给模型一个更完整的学习样本。我不认为人有「错误的行为」,人有成功、失败和重试。比如毛巾掉到地上,人会换一种方法把它捡起来,除非他决定不捡了。失败与重试本身也是值得学的数据。
腕部相机能够更详细地描述手内空间、手指运动和接触。触觉则让模型知道接触后发生了什么。以后触觉可能还会从手延伸到胳膊,因为人干活时有很多接触并不发生在手指上。
42 号电波: 那什么时候能看到真正「有效的一千万小时」?
朱雁鸣: 现在不是大家不想要一千万小时,而是只有一千万小时 Ego,它不 Work。不是不愿意试,而是它没有那么大价值。
一家公司的千万小时应该由多种模态按一定配比组成,配比要跟着模型训练去试。所以本质不是谈一个粗糙的数字,而是问:这一千万或一百万小时到底要什么?如果基础模态和采集设备还没有建立起来,数字本身没有意义。
42 号电波: 很多公司会按场景买数据,这个方法不对吗?
朱雁鸣: 客户会提高价值场景,但需求背后的本质通常是多样性,不是只要某一个任务。
「吃什么补什么」在模型训练里不一定成立。只喂一类数据,模型在这个任务上提升一段以后就会遇到瓶颈,这时反而要加入更底层、更通识的数据。
想叠好毛巾,不能只采叠毛巾。什么叫「拿起毛巾」?人是拿过很多东西以后,才形成拿起物体的通识。最后解决的可能是毛巾问题,但训练的不只是毛巾。
42 号电波: 如果按落地先后排序,你们怎么看工业、商业和家庭?
朱雁鸣: 我的排序是工业、商业、家庭。家用最难,至少还要五年,因为它的泛化要求最高,需要解决的不只是在桌上叠一件衣服,还有人与人之间的交互。
但工业不等于先去流水线上替代最便宜的人。如果工人一天成本只有几十或一百元,一台二三十万元的机器人在商业上很难成立。
工业先落地,是因为场景和任务受限,泛化要求更低。在这个范围里,机器人会先进入高价值、高危和稀缺技能场景,比如半导体、生物制药。真正要找的,是价值高和泛化难度低的交集。
数采是脏活累活,数据不是
42 号电波: 现在具身数据的价格竞争已经很激烈。简智会降价吗?
朱雁鸣: 我们不降价,这个不忌讳。我们应该是行业里卖得最贵的那一批,老客户也会说贵。
但贵与便宜对一家公司很重要,却不是决定性因素。如果为了便宜两百万元、五百万元,买了一批数据,最后模型没训练出来,对公司的影响会非常大。现在模型按月发布,错过窗口就会影响后面的融资和迭代,甚至产生负循环。
所以客户在意价格,但最重要的问题是数据到底能不能 Work。
42 号电波: 你们凭什么维持高价?
朱雁鸣: 第一是模态。只是 Ego,还是 Ego 加手、全身和触觉,对模型来说不一样。
第二是同一个模态的精度。如果训练数据本身就有一两厘米的误差,为什么期待模型执行时的误差比它小?精度会非常直接地决定模型上限。
第三,我们交付的不只是传统意义上的原始数据,而是经过重建、处理和多模态对齐,能够向模型输入转化的数据。如果只卖视频、手部轨迹和一些标注,它未必能够直接进入模型训练。
当然,不同数据的配比仍然由模型公司在训练中实验,那是客户的 Recipe。我们要做的是让每一种数据真的可用。
42 号电波: 这次 CoRL 参展的还有很多数据公司,你会考虑竞争对手吗?
朱雁鸣: 从技术上看,仿真和评测是绑定的,应该与模型迭代非常紧密。它的主要价值更多发生在训练之后的测试,训练阶段的意义没有那么大,所以现在大家买仿真数据也很少。
智驾的仿真数据主要也用于评测。你见过哪家拿仿真数据当主要训练数据?真实路况这么复杂,仿真能仿多少?尤其进入端到端以后,输入就是 Video,中间没有人写的规则。如果给模型的是假视频,分布差异会非常大。
具身也一样。仿真不能没有,但它不具有决定性。仿真里的信息是人设计出来的,人很难设计出和真实物理世界一样稠密的信息。
42 号电波: 你们会觉得做数据是「脏活累活」吗?
朱雁鸣: 采集是,Collection 这件事是。但采集之后的事不是。
数据采完以后,怎么做重建,怎么处理,怎么做多模态对齐和推理,这些本质上都是算法问题。
数据公司的能力在两端。一端是运营:运营能力差,数据就无法 Scale,多样性也不会好。另一端是数据质量,背后是算法和硬件。我们为什么花很多精力做硬件?因为当你真正知道模型要什么,会发现很多基础模态并不存在,只能自己从零做硬件。
42 号电波: 头部六个相机、腕部两个相机、IMU 和触觉,都要处在同一条时间线上。你们声称头手多设备对齐误差小于 1 毫秒,怎么做?
朱雁鸣: 我觉得这是现在行业最好的水平。这件事我们花了非常多精力。
智驾时代没有同样的挑战,因为许多传感器集成在同一个车端系统中。但采集 Human Data 时,头和手必然是分开的设备。
一种办法是有线,但线会影响规模化和人动作的自然性。我们坚持无线,使用 Sub-1G 通信。这样既能保证人的动作足够自然,也不会破坏采集场景的多样性。
42 号电波: 你们连相机里的 CMOS 和 ISP 也自己做?
朱雁鸣: 对。只选定通信方案没有用,如果相机录制仍然有自己的循环和时钟,每台相机还是各自拍各的。
拍完以后当然可以把数据传到云端,再想办法切片对齐,但这种对齐本质上只是把不同的视频前后移动。中间一定会产生无法准确对应的区间。所以我们要做硬对齐,就必须往下做到相机里的 CMOS 和 ISP。
很少有数据公司把硬件做到这么底层,但我们在这件事上花了很多精力。
我们做的是硬件同步。头部六个相机和手上两个相机在同一时间拍摄,再与 IMU 时钟统一,让所有数据进入同一个时空。
硬件上的核心是基础模态、时空对齐和视觉;算法的核心是 One Model,能不能吃进多模态、输出多模态,以及能不能被数据驱动。我们卖的数据越多,用于训练数据基础模型的数据也越多;模型精度提高,又会反过来提高数据销售。这是我们想建立的商业飞轮和数据飞轮。
42 号电波: 简智把自己称为「具身智能数据解决方案公司」。在过去的 IT 和智驾行业里,「解决方案」经常意味着公司从高维的技术故事掉进定制化和低毛利。你们为什么主动用这个词?
朱雁鸣: 我们创业时先想明白一件事:要创造价值。
有些公司做的东西别人已经在做。行业有了第一,它做一个达到第一 80% 的产品,估值是对方一半,价格也便宜一点。它可以成为一个玩家,但我们不想走这条路。我们想做一件能够说服自己长期坚持,也确实解决了行业空缺的事。
技术创业者容易陷入一个误区:手里有一项技术,就认为它是公司的产品,但行业不一定需要。解决方案对我们的意义是,你创造的价值要进入产业闭环,而且能和行业一起成长。
我们不想把 Slogan 拉到「登陆火星」的高度。Scope 要清楚,太高会让今天做的事与目标离得太远。
42 号电波: 如果 Physical RSI(Recursive Self-Improvement,递归式自我改进)成立,模型开始自我进化,对数据公司有什么影响?
朱雁鸣: 不要把 RSI 神化。RSI 之后不是不需要数据,而是会更需要数据。
具身的数据与语言模型、自动驾驶都不同。智驾产品可以在路上持续生成数据,但真正有训练价值的很多仍然是人开车的数据,车犯错更多是用于 Debug。
机器人更难。我不可能买回机器人,再遥控它把人类所有事情重新做一遍。机器人产品本身不会天然生成大量正确的人类演示,所以这门生意天然是开环的,上下游会长期存在。
42 号电波: 你与陈建兴以前有过合作,你们在创业的方向上是怎么达成共识的?
朱雁鸣: 创始人之间的「品味」很重要。一个是对要做什么的品味,一个是对技术路线的品味。
具身时代里,大多数人会选模型或本体,因为好看、好听。我们也有过这种冲动。但冷静下来要问:你能做多久,你的优势是什么,它是不是在创造新价值?如果一直往下问,很多选择会让人越想越心虚。
我们在技术品味上也比较一致:相信端到端,相信从 Model 到 Data Generation 的路线。所以大家不需要在基础方向上讨论太久,更重要的是对未来的判断能不能一致。
真实世界还没有一把好尺子
42 号电波: 今年年中大家就在说,具身智能的瓶颈已经变成评测。几个月过去,为什么仍然没有明显进展?
朱雁鸣: 第一,看清评测的重要性,和建立一套能稳定衡量机器人能力的评测方法,是两件事。
智驾模型可以 OTA 到几十万台车,几十万台车本身就是巨大的评测集,还能持续收集数据。但现在一家机器人公司可能只有十台、二十台真机,评测的泛化性很差。
第二,Real-world Data 本身也可以是一种评测。把人的动作隐去,只给模型环境信息和目标,再看模型的输出与人的行为有多相似。如果这件事成立,就可以用真实数据做可规模化的离线评测。但现在这仍然非常难。
42 号电波: 现在的 Benchmark 也很快失效。下一代 Benchmark 会怎么变?
朱雁鸣: 现阶段的 Benchmark 为衡量机器人能力提供了很重要的基础。不过,从在标准化测试中取得好成绩,到在真实家庭里稳定完成家务,中间还有不少需要进一步验证的能力。
下一阶段要有两个变化:更贴近真实环境,也更复杂。
比如现在评测机器人叠衣服,往往先把衣服整齐地铺在旁边。但真实家庭里,人会把衣服往床上或沙发上一丢。机器人首先要知道怎么从一团衣服中找到可以抓的位置,再展开和叠好。一件衣服可能是衣角露在外面,另一件露出来的部位完全不同,解决方案不再固定。
现在很多 Benchmark 的最大问题,就是解法固定。而真实世界最有价值的部分,恰恰是解法不固定。
42 号电波: 既然大家能意识到问题,为什么不直接把 Benchmark 改得更难?
朱雁鸣: Benchmark 的设计不只是提高难度,还要让它能够客观衡量现阶段的能力差异。如果难度一下子超出当前技术水平,反而不容易看清不同方法的进展,以及具体需要改进的方向。
这很像早期智驾评测,测试场里摆几个假人,测一测 AEB,就只有那些标准工况。Benchmark 也要随时代发展。
我认为大厂最后会做新的 Benchmark,现在可能在内部做,以后会公开。评测是模型进步的重要变量,也是 Know-how。如果一家公司的 Benchmark 做得足够好,就像开源一样,它等于画了一条统一起跑线,其他人都要在这条线上迭代。
42 号电波: 除了评测,具身智能的基础设施还有哪些问题?
朱雁鸣:有些评测只看模型的 Loss 和某些指标变化,却没有指向具身智能最本质的应用。它们在评一个模型的「术」,却没有回答「道」——机器人究竟能不能在真实环境中解决问题。
评测也要想办法规模化。让一家餐厅先放一台机器人测试,即使它愿意,你能不能同时找到一百家餐厅?冷启动阶段极难 Scale。怎么把真实世界的评测与可规模化的方法结合,现在还不成熟。
Data 是一类问题,评测是一类问题,模型结构也是一类问题。比如行业还在纠结到底是 VLA 还是 WAM,我觉得它根本不应该被简化成一道二选一。
42 号电波: 你不认为未来是 WAM,也不认为是现在的 VLA。那你认为会是什么?
朱雁鸣: 我觉得会是以 VLA 为 Base 的下一个 One Model,但不会与现在的 VLA 完全相同。
现在的 VLA 太重 Language,语言与 Action 还不是一体的。但人在行动时,思考与行为永远是同步发生的,Action 与 Language 也不一定是简单的前后因果关系。
一个可能的方向是,Vision、Language 和 Action 都成为模型的输入,由语言或更高层的逻辑把它们串起来,并且同步输出。这样就不必纠结一定用 Video 还是 Action,也不必把 VLA 和 WAM 割裂成两条完全独立的路线。
WAM 有价值,可以作为系统特征去处理空间和视频信息;Video 很重要,Language 仍然可能串起整个逻辑,没有必要为了一个概念把它们彻底割裂。
42 号电波: 你觉得具身智能会在什么时候出现更大的泡沫?
朱雁鸣: 接下来两到三年,可能会出现更大的泡沫。最大的泡沫往往发生在你感觉「还差一步就能落地」的时候。
如果真有一家公司的机器人可以在餐厅里稳定端盘子,大家会怎么给它估值?因为一旦做到这个程度,它面对的是全球大量人类工作的价值。那时估值与今天会有很大差距,情绪也会被调动起来。
但做过智能驾驶的人知道,从看起来还差三到五步,到真正应用,可能要花与前面二十步同样长的时间。外面的人却会觉得,下个月就行,下下个月就可以落地。这时候泡沫会迅速膨胀,然后行业才会发现,它仍然需要更长的时间和更长的链路。
42 号电波: 那明年呢?
朱雁鸣: 明年会是新的起点。
发现文章有错?告诉我们