

物体
共 97 篇相关内容
ACE-Data-0 开源背后:我们和大晓机器人聊了聊具身数据的下一步
机器人看视频就能学会一切?那你就太高估它了。 比如生活中最简单的场景,从桌面拿起水杯。这件事人类几乎不需要思考;对机器人而言,却是一条由感知、移动、抓握、接触、物体状态变化和任务记忆共同组成的长链条。 视频可以告诉模型「拿起水杯」,但手指在…
模型之外,Ego2Robot 让数据处理管线当回主角
一台机器人在固定桌面上完成任务,和换了桌布、改了光照、挪了相机位置之后仍然做对,是两种完全不同的能力。前者说明策略已经收敛,后者才决定它能不能走出实验室。 众所周知,机器人遥操作天然比人类中心视频慢、贵。而此前工作仅在小规模单任务上验证过「…
上交卢策吾、浙大等团队提出 Track4Action:把「动作后的 3D 世界」蒸馏进 VLA
VLA 模型可以把图像和语言指令转换成机器人动作,训练的过程中,研究人员通常只评价机器人的动作像不像专家。至于机器人的动作会怎样改变物体、空间关系和任务状态,通常没有被明确交给模型学习。短任务可能掩盖这个缺口;一旦任务变长,或者视角、背景和…
中美韩三篇具身智能体力作,串起机器人 Agent 的现在与未来
近期,随着 Anthropic 发布报告,具身智能的牌桌上坐满了所有能叫出名字的大语言模型巨头。 Anthropic 在 2026 年 7 月发布了一份独特的实验报告《Claude plays robotics》。他们直接把 Claude …
机器人学新忘旧?港大、原力无限等团队用真机给 VLA 做了一场压力测试
机器人的神经网络中,有个由来已久的问题:灾难性遗忘。 今天机器人学会了整理餐具,明天又学会了叠毛巾,后天学会了打包纸箱。等多个任务都学完之后,再回到第一个任务,它可能就退化到像没学过一样,不知道如何处理。对于家庭、工厂这些场景而言,学新忘旧…
首次!北大、南洋理工等 30 位研究者联手厘清具身数据金字塔
7 月 28 日,来自北京大学、南洋理工、港科大、新加坡国立、港大、上海交大等十余所机构的近 30 位研究者联合发布了一篇 72 页长文综述《Data Pyramid for Embodied Manipulation》。该综述通过一个五层…
0.04B 通吃异构相机,与地瓜机器人隋伟谈 X-Lens 取舍逻辑
鱼眼相机看得广但画面边缘是畸变弯曲的,针孔相机看得直但视野窄。 一台机器人身上往往同时挂着这两种相机,用于感知环境深度,而像 DAC、MapAnything 等深度估计模型,几乎没有既能同时适配好这两种相机,又能端侧跑起来的方案。 对此,地…
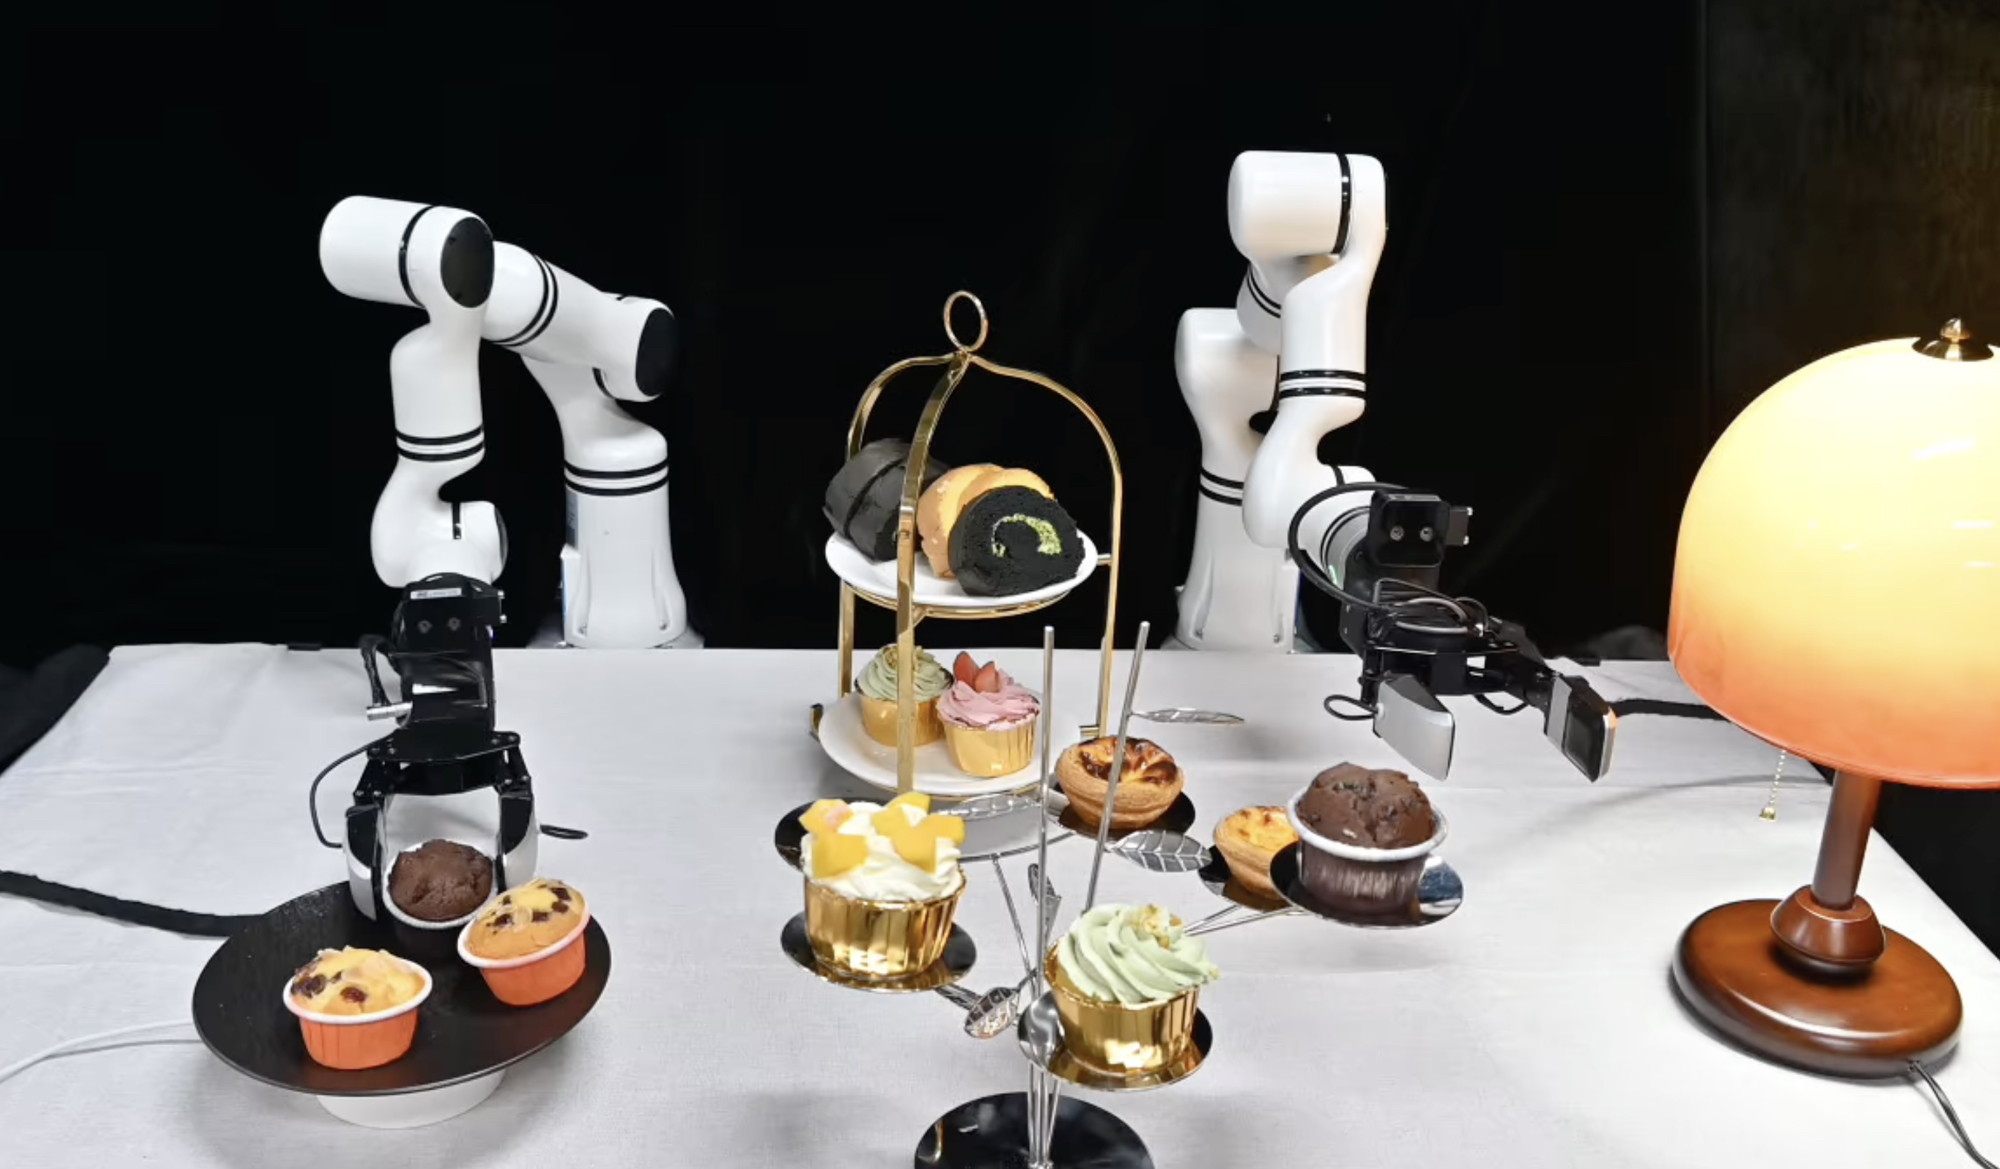
50 万小时第一视角视频,如何给具身世界模型补上「触觉」
一只机械手把葡萄从一串果实中摘下来,难点不在于「看见」葡萄,而在于何时接触、哪根手指承力、力道多大才不会把果肉捏坏。挤牙膏、从软袋里摸出被遮住的物品、用软笔写字,都是同一类问题:视觉能描述物体和姿态,却很难直接给出接触已经发生了没有、接下来…

一次开源三大模型,腾讯机器人正在「超车」
继 2025 年 WAIC 腾讯 Robotics X 实验室发布首个模块化具身智能开放平台 Tairos,在今年 WAIC 上,腾讯 Robotics X 实验室、福田实验室联合腾讯混元发布具身智能系列新成果。 新成果包括发布并开源基于混…

和王啸峰聊聊 Gigaworld-1:当世界模型成为具身智能的物理裁判
语言模型的评测几乎是即时的。训练一停,把测试集丢给 GPU,几秒钟就能拿到一串分数,好还是不好,一眼就能看出来。 换成机器人的「大脑」就完全是另一回事了。一个 VLA 模型刚迭代出新版本,研究员没法在屏幕前把它评完——他们得把新策略刷进真机…
不止于预测,小米将世界模型打造成数据引擎
7 月 14 日,小米放出其自研机器人在工厂中连续作业的任务视频,视频中可以看到机器人在面对不同尺寸工件依然可以长时间稳定作业。 然而,机器人在工厂里的稳定作业,只是最终呈现出来的结果。真正支撑这一结果的,是机器人背后的模型能力。模型能力决…
半年狂揽 4 亿美元的逐际动力,按下上市快进键
具身智能赛道的百亿独角兽,再添一员猛将。 7 月 14 日,通用人形机器人公司逐际动力宣布完成 Pre IPO 轮融资,融资金额近 2 亿美元,投后估值达 150 亿元。在过去的半年时间里,逐际动力已经累计完成 4 亿美元融资。 同时,这也…