

轨迹
共 62 篇相关内容
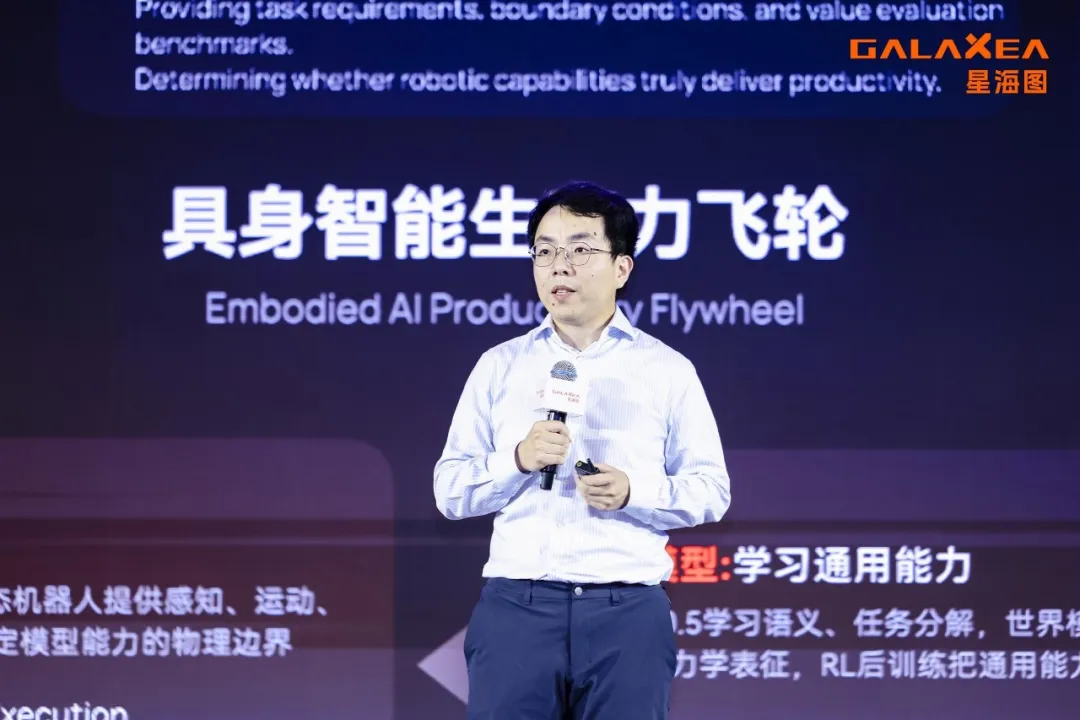
星海图赵行:机器人的下一次 Scaling,不只发生在预训练
机器人抓起一个商品,只能说明它会做一个动作。展台上的机器人完成一次抓取,与它进入前置仓持续接单、拣选和打包,是两种不同的考验。 前者可以被压缩成一条成功轨迹,后者却要求机器人理解订单、定位货架、自主导航、处理随机摆放的商品,还要在多机协同时…

智元为什么突然成了机器人运动会的「奖牌收割机」?
8 月 26 日晚间,为期五天的第二届世界人形机器人运动会在北京闭幕,来自 16 个国家的 666 支队伍、2,056 台机器人参加了本届运动会。 究竟哪一支队伍更强?奖牌榜说了算。本届人形机器人运动会上,共诞生了 50 枚金牌、49 枚银…
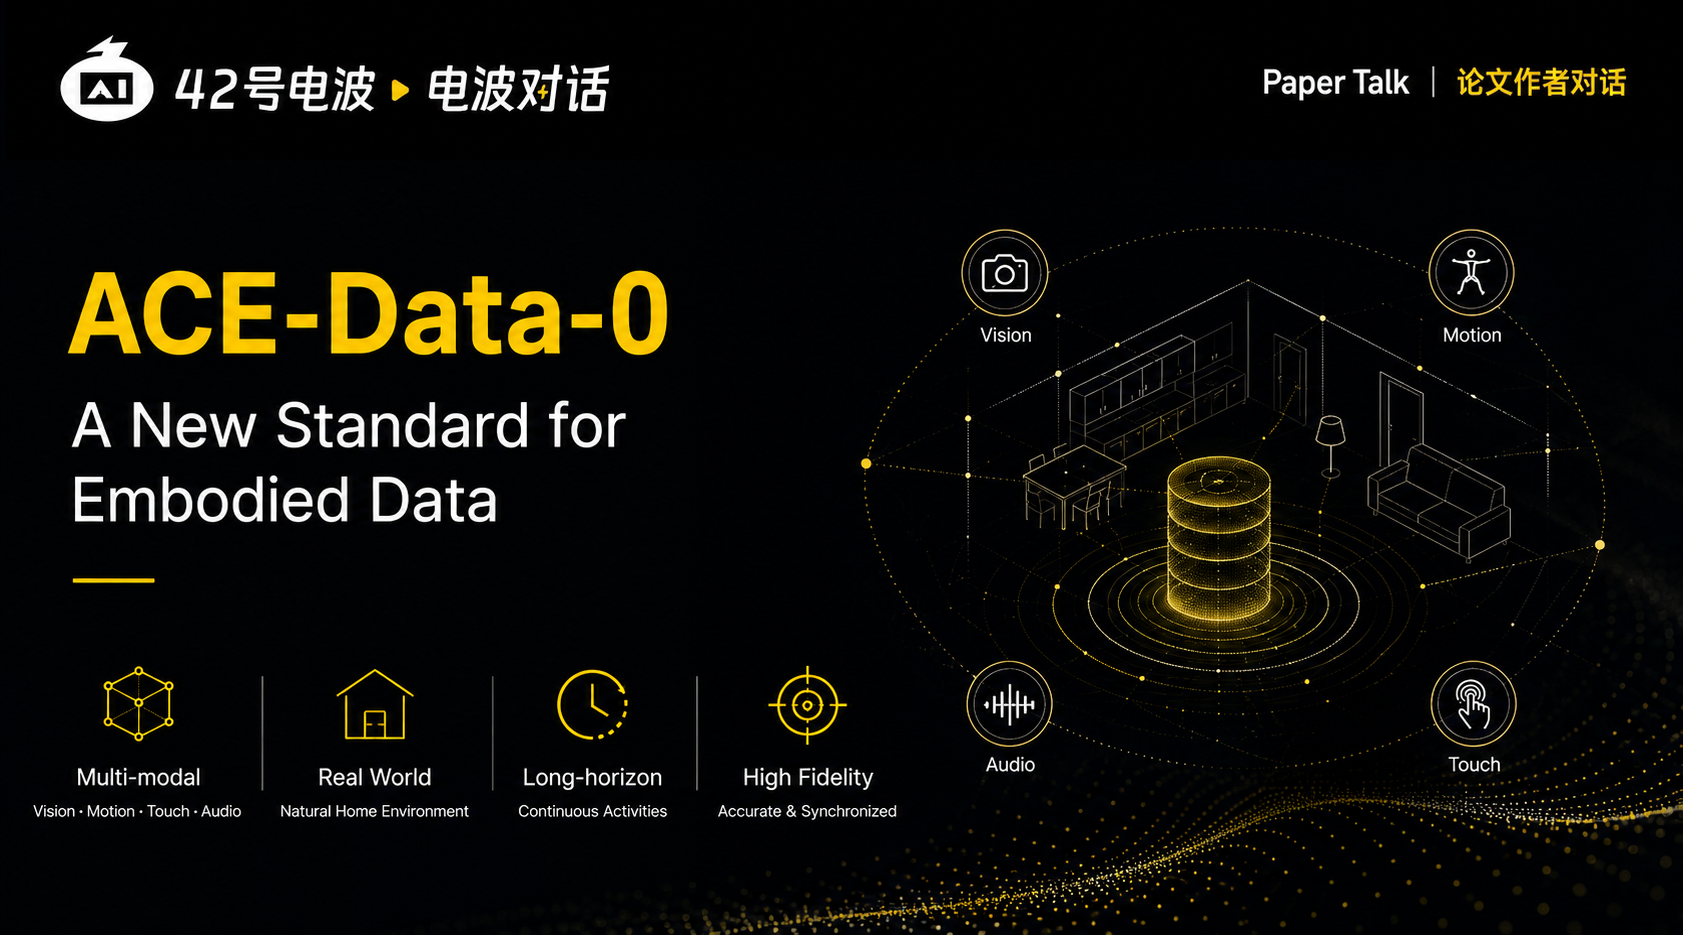
ACE-Data-0 开源背后:我们和大晓机器人聊了聊具身数据的下一步
机器人看视频就能学会一切?那你就太高估它了。 比如生活中最简单的场景,从桌面拿起水杯。这件事人类几乎不需要思考;对机器人而言,却是一条由感知、移动、抓握、接触、物体状态变化和任务记忆共同组成的长链条。 视频可以告诉模型「拿起水杯」,但手指在…

独家对话周顺波:就算没有 AGI,也能做一台大家喜欢的机器人
在创立欧拉万象以前,周顺波已经做了近 12 年机器人。 2015 年,他进入香港中文大学徐扬生院士的实验室,才真正开始做机器人。他参与研发过一只熊猫形态的疗愈机器人,后来被送进香港沙田医院,陪伴自闭症儿童和阿尔茨海默病老人。那时,这类机器人…
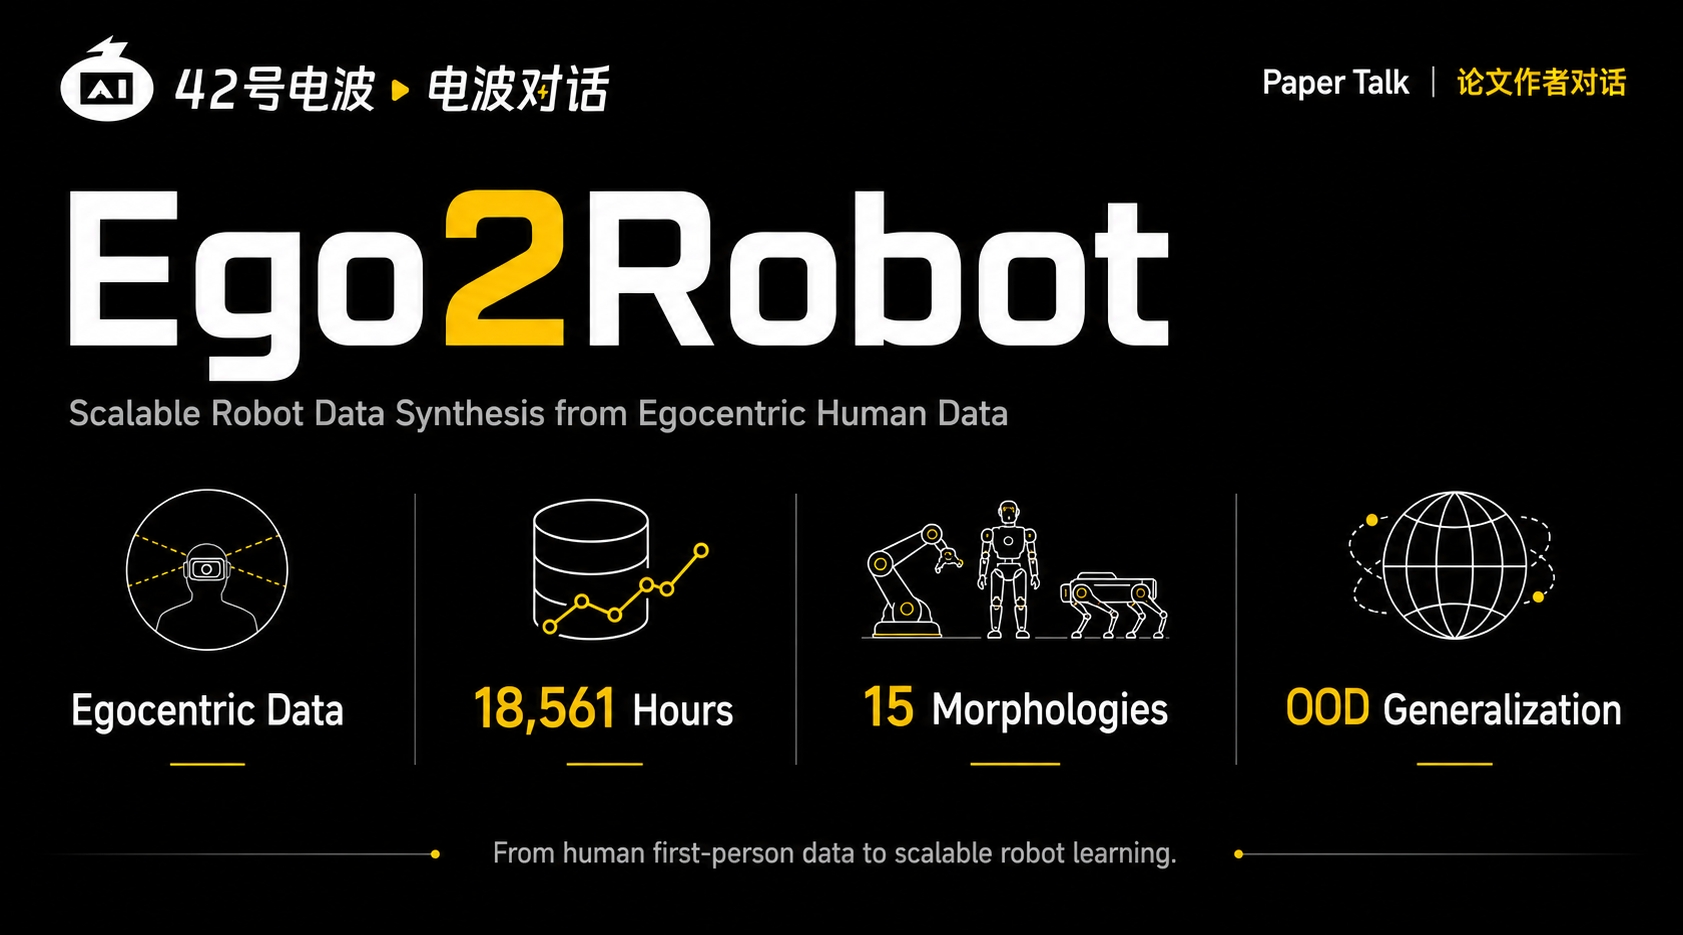
模型之外,Ego2Robot 让数据处理管线当回主角
一台机器人在固定桌面上完成任务,和换了桌布、改了光照、挪了相机位置之后仍然做对,是两种完全不同的能力。前者说明策略已经收敛,后者才决定它能不能走出实验室。 众所周知,机器人遥操作天然比人类中心视频慢、贵。而此前工作仅在小规模单任务上验证过「…
上交卢策吾、浙大等团队提出 Track4Action:把「动作后的 3D 世界」蒸馏进 VLA
VLA 模型可以把图像和语言指令转换成机器人动作,训练的过程中,研究人员通常只评价机器人的动作像不像专家。至于机器人的动作会怎样改变物体、空间关系和任务状态,通常没有被明确交给模型学习。短任务可能掩盖这个缺口;一旦任务变长,或者视角、背景和…
中美韩三篇具身智能体力作,串起机器人 Agent 的现在与未来
近期,随着 Anthropic 发布报告,具身智能的牌桌上坐满了所有能叫出名字的大语言模型巨头。 Anthropic 在 2026 年 7 月发布了一份独特的实验报告《Claude plays robotics》。他们直接把 Claude …
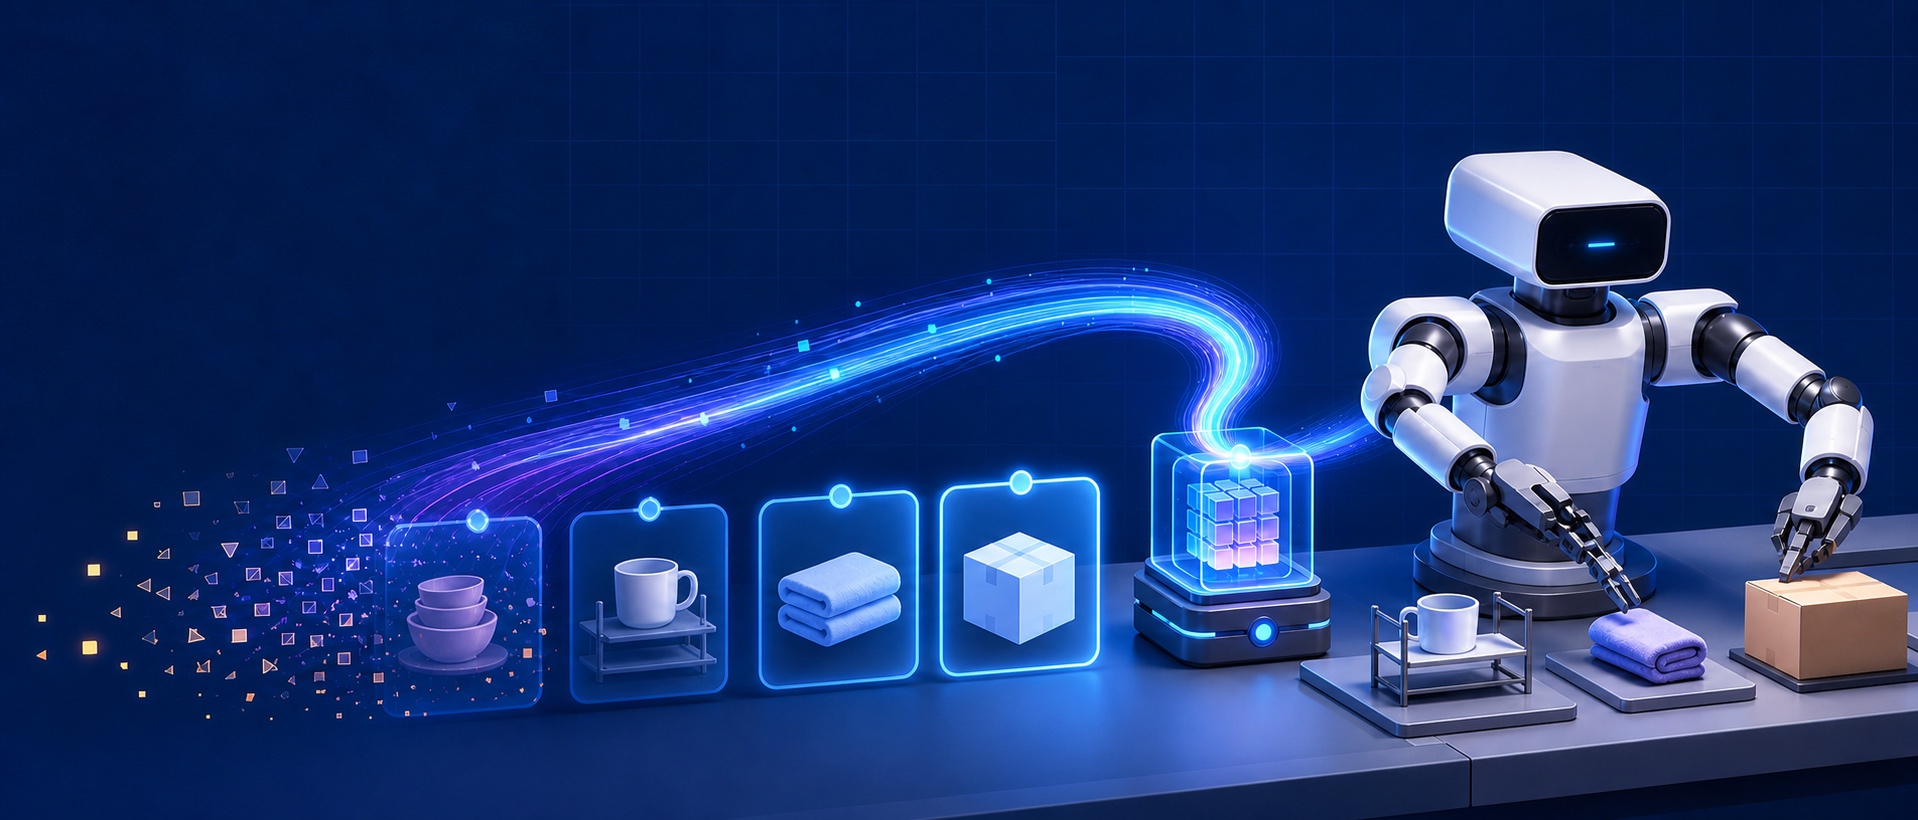
机器人学新忘旧?港大、原力无限等团队用真机给 VLA 做了一场压力测试
机器人的神经网络中,有个由来已久的问题:灾难性遗忘。 今天机器人学会了整理餐具,明天又学会了叠毛巾,后天学会了打包纸箱。等多个任务都学完之后,再回到第一个任务,它可能就退化到像没学过一样,不知道如何处理。对于家庭、工厂这些场景而言,学新忘旧…
杨立昆点赞,浙大孙俊涵、清华赵昊等提出 INTACT:免去 JEPA 世界模型的「搜索税」
世界动作模型的核心在于,先预测「下一步发生什么」,并为其设立目标,再让机器人看一眼目标,自己决定执行的每一步该做什么。 然而当前的主流方案有一个别扭的设计:训练时,模型学会「给定当前画面和动作,预测接下来发生什么」;部署时,控制器却从随机噪…
首次!北大、南洋理工等 30 位研究者联手厘清具身数据金字塔
7 月 28 日,来自北京大学、南洋理工、港科大、新加坡国立、港大、上海交大等十余所机构的近 30 位研究者联合发布了一篇 72 页长文综述《Data Pyramid for Embodied Manipulation》。该综述通过一个五层…
0.04B 通吃异构相机,与地瓜机器人隋伟谈 X-Lens 取舍逻辑
鱼眼相机看得广但画面边缘是畸变弯曲的,针孔相机看得直但视野窄。 一台机器人身上往往同时挂着这两种相机,用于感知环境深度,而像 DAC、MapAnything 等深度估计模型,几乎没有既能同时适配好这两种相机,又能端侧跑起来的方案。 对此,地…
50 万小时第一视角视频,如何给具身世界模型补上「触觉」
一只机械手把葡萄从一串果实中摘下来,难点不在于「看见」葡萄,而在于何时接触、哪根手指承力、力道多大才不会把果肉捏坏。挤牙膏、从软袋里摸出被遮住的物品、用软笔写字,都是同一类问题:视觉能描述物体和姿态,却很难直接给出接触已经发生了没有、接下来…