

RoboMIND
共 6 篇相关内容
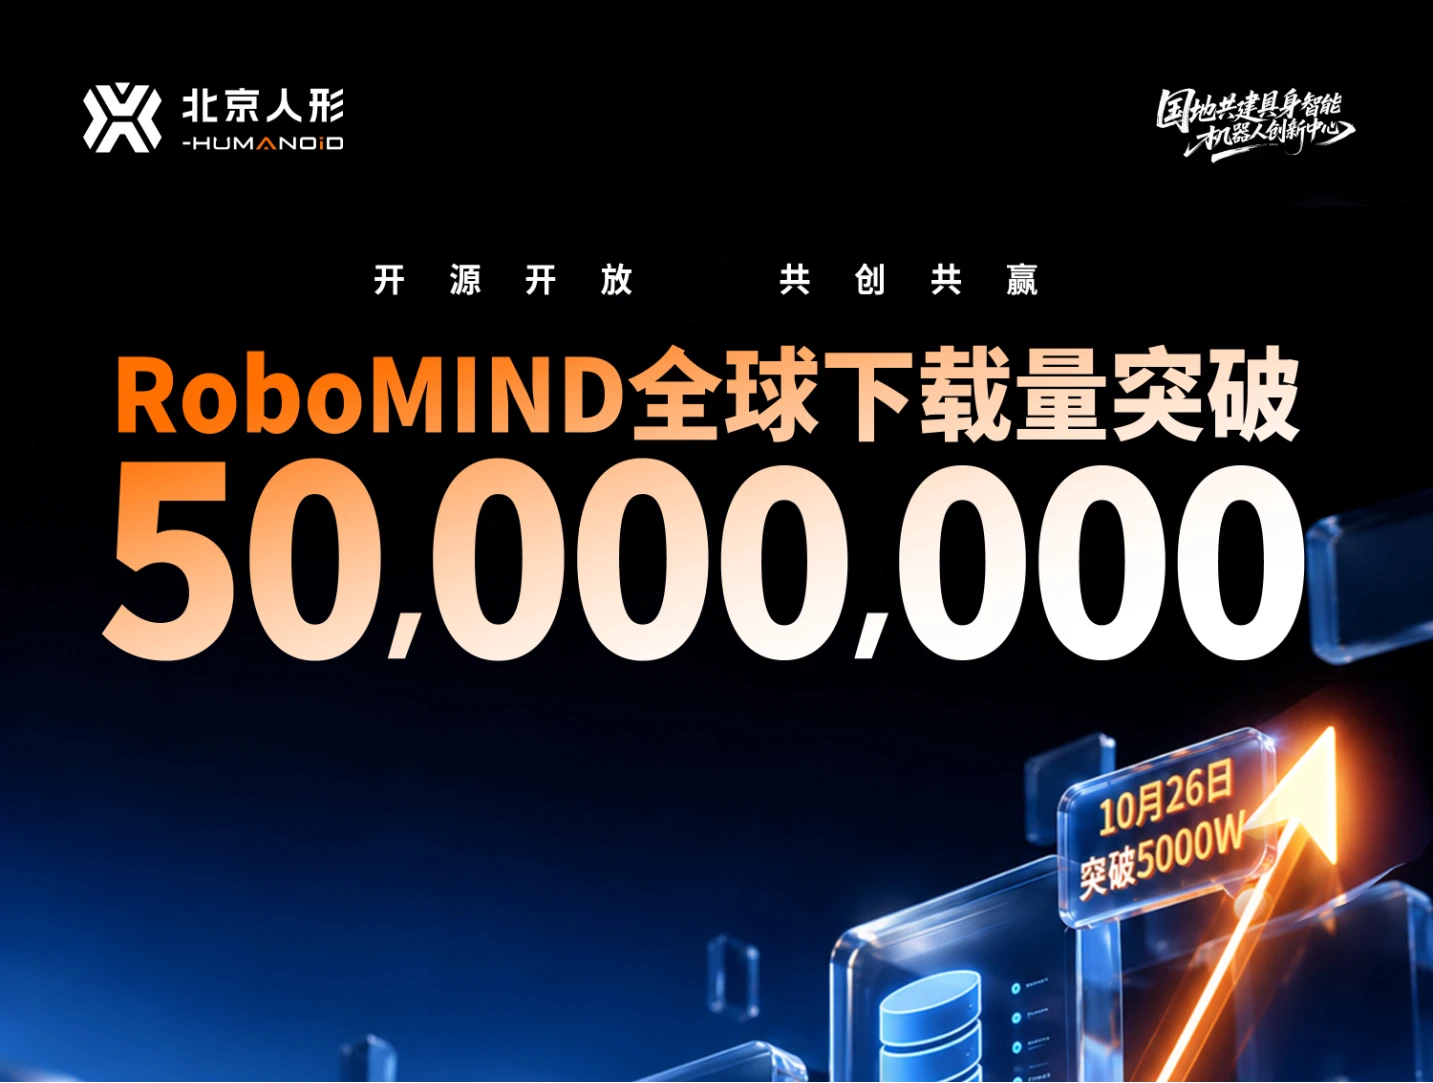
RoboMIND 下载量突破 5,000 万次,最近 1,000 万次仅耗时 18 天
10 月 26 日,北京人形机器人创新中心官宣,开源数据集 RoboMIND 全球累计下载量突破 5,000 万次。据官方披露,最新一轮 1,000 万次下载仅耗时 18 天;作为对比,首个 1,000 万次下载耗时 223 天,第二个 1…
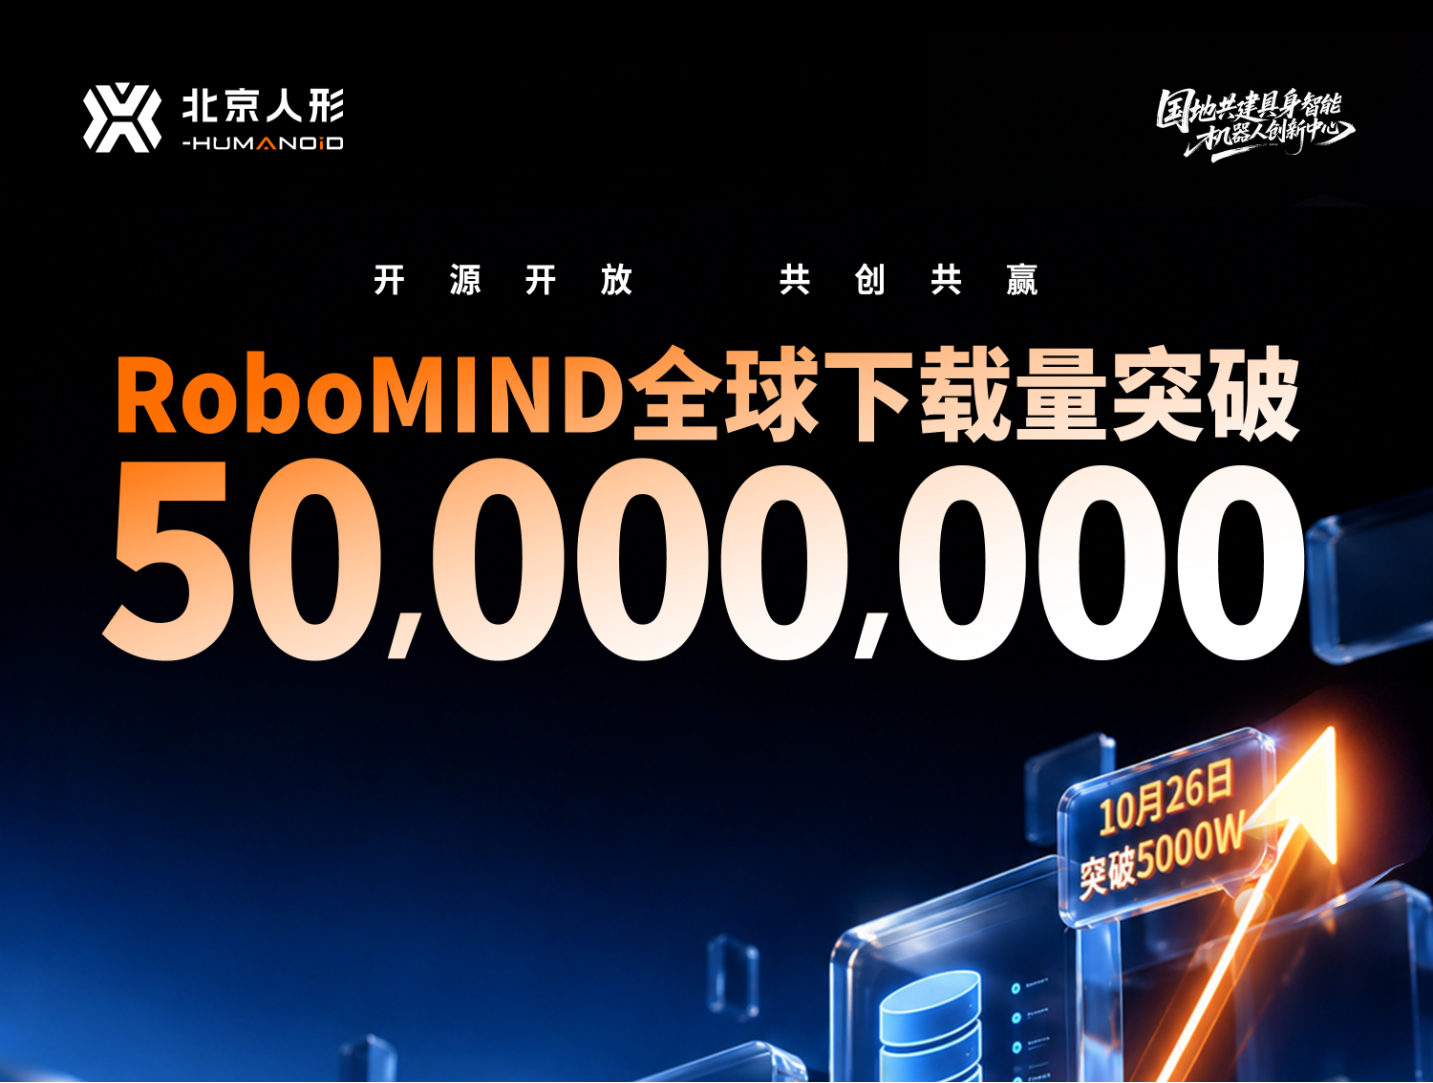
RoboMIND 下载量突破 5,000 万次,最近 1,000 万次仅耗时 18 天
10 月 26 日,北京人形机器人创新中心官宣,开源数据集 RoboMIND 全球累计下载量突破 5,000 万次。据官方披露,最新一轮 1,000 万次下载仅耗时 18 天;作为对比,首个 1,000 万次下载耗时 223 天,第二个 1…
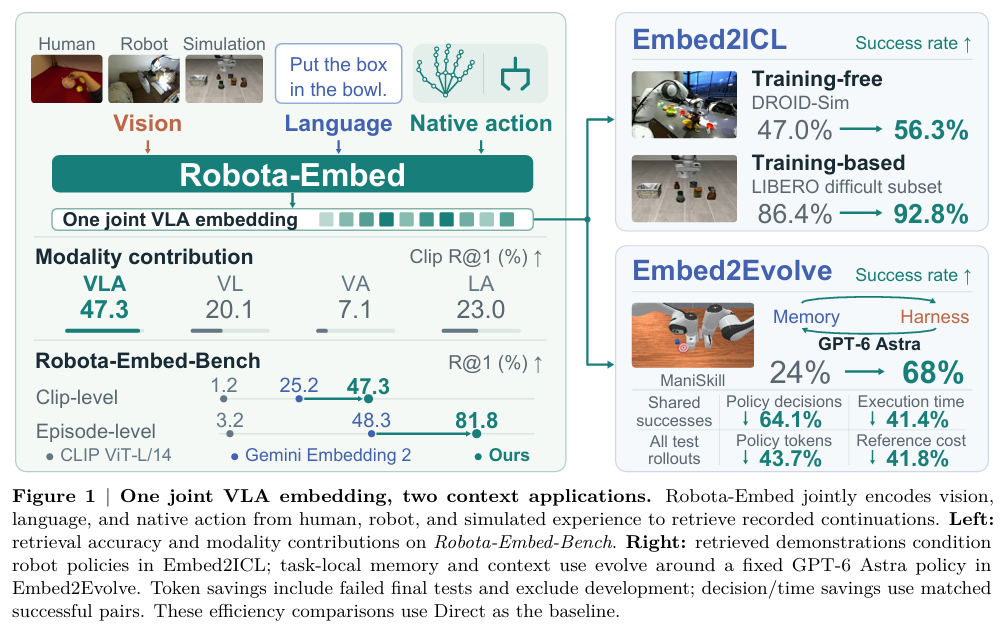
Jim Fan、韩松团队提出 Robota-Embed:机器人检索经验,动作比画面更关键
具身智能机器人想要复用过往操作经验,普遍会检索历史示范视频,模仿曾经成功的操作。 但传统检索大多只比对画面外观:只要桌子、物体看起来一致,就判定是匹配片段,忽略机械手当下的运动方向。同样的纸箱、同一段胶带,封箱和撕胶带两张画面几乎看不出差别…
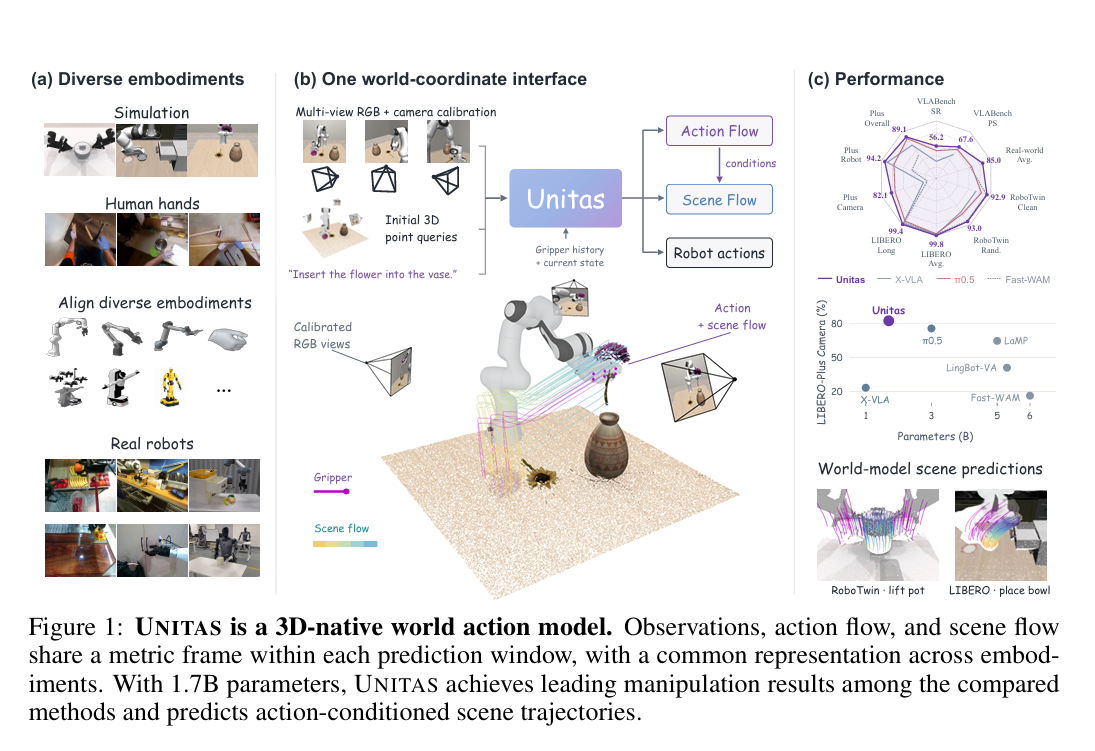
贾奎团队新作:让世界动作模型真正理解三维空间
UNITAS 将观测、动作与场景变化统一至同一个米制三维坐标系:以点轨迹表征人手与夹爪的运动,用场景流描述场景点的位移,让世界动作模型不再单纯依靠图像推测环境演化。模型参数量仅 1.7 B,在 LIBERO 基准测试上取得 99.8 % 任…
中科院自动化所与高德团队提出 DreamTrue,将机器人动作统一渲染为画面条件,实现高精度未来视频预测
DreamTrue 将机器人动作渲染为画面内的机器人作为训练条件,为世界模型补充示范数据中缺失的失败动作,并依托人工标注训练得到的奖励模型开展强化学习。当动作执行失败时,模型能够如实预测对应的结果,它在 AgiBot 平台上将交互缺陷率从 …
首次!北大、南洋理工等 30 位研究者联手厘清具身数据金字塔
7 月 28 日,来自北京大学、南洋理工、港科大、新加坡国立、港大、上海交大等十余所机构的近 30 位研究者联合发布了一篇 72 页长文综述《Data Pyramid for Embodied Manipulation》。该综述通过一个五层…