

Jim Fan、韩松团队提出 Robota-Embed:机器人检索经验,动作比画面更关键
具身智能机器人想要复用过往操作经验,普遍会检索历史示范视频,模仿曾经成功的操作。
但传统检索大多只比对画面外观:只要桌子、物体看起来一致,就判定是匹配片段,忽略机械手当下的运动方向。同样的纸箱、同一段胶带,封箱和撕胶带两张画面几乎看不出差别,后续动作却完全相反。只看视觉相似的检索方式,很容易让机器人选错参考轨迹。
10 月 14 日,英伟达、麻省理工学院、加州大学伯克利分校、牛津大学、卡内基梅隆大学联合团队发表论文《Robota-Embed: Unified VLA Embeddings for Robot In-Context Learning and Evolution》。论文共 19 位作者,刘昀泽、Jing Wang 为共同第一作者,英伟达研究科学家蔡涵担任通讯作者。
作者名单中还有多位知名学者,包括机器人学习学者、英伟达 GEAR 团队共同负责人朱玉可,伯克利人工智能研究实验室 BAIR 创始共同负责人 Trevor Darrell,英伟达 GEAR 团队共同负责人 Jim Fan,以及以模型压缩和高效 AI 计算研究知名的麻省理工学院副教授韩松。
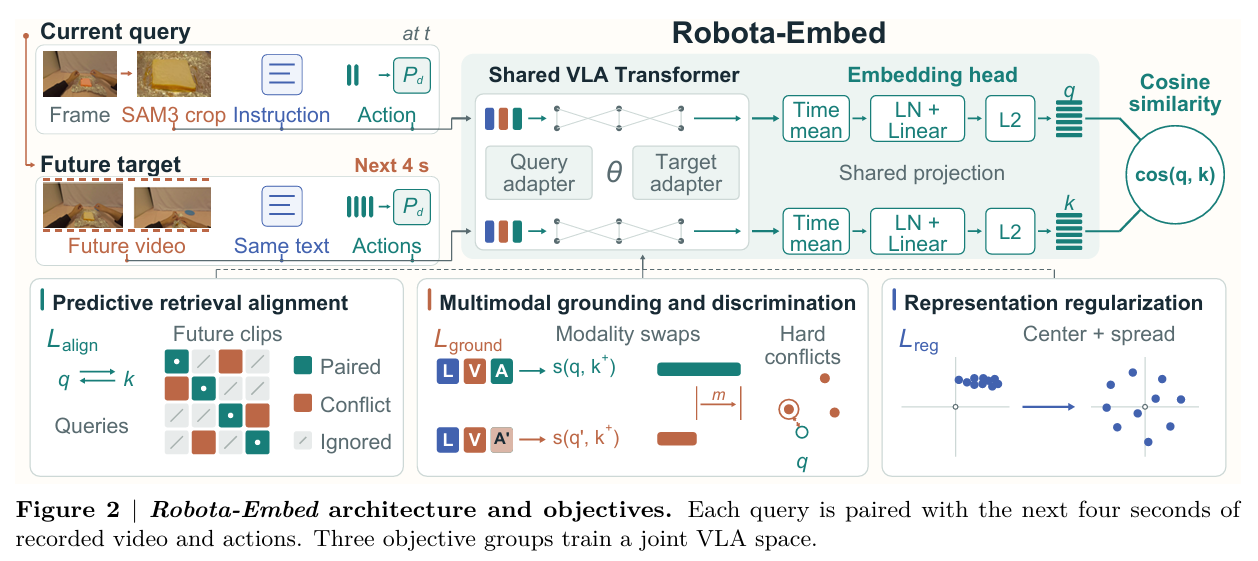
Robota-Embed 将画面、文本、动作三路信息联合编码至同一向量空间,查询样本与候选样本均纳入动作维度。机器人检索历史经验时,找到的不再只是画面近似的片段,而是匹配后续行为逻辑的参考。
让机器人调取过往经验,是机器人学习领域一条逐步成型的技术路线。机器人策略不再单纯依赖模型权重内固化的知识,而是在推理阶段调取历史示范、回放轨迹作为上下文,依托已有经验完成决策。GEN-1.5、S1 等研究已经实现基于传感器动作样本与视频的现场学习,GPT-6 Astra 这类策略也可以依据观测与执行历史生成动作。当经验被纳入上下文,如何筛选出最有效的片段,就成为机器人控制的关键难题。
传统经验检索的核心逻辑是外观相似。通用嵌入模型对齐图像与文本,动作感知度量学习将感知信息、文本关联到行为,但绝大多数检索方案仅比对场景外观,并未将动作本身纳入相似度计算。这就产生了信息错位:机器人当前状态描述的是「当下」,而候选录像记录的是那次交互之后将要发生的行为。例如纸箱封胶带和撕除胶带,视觉画面几乎一致,但后续动作截然相反,仅依靠场景匹配很容易检索到错误片段。ROSER、RAEA、REGENT 等方案,要么检索动作序列,要么使用不含动作的索引去调取动作,都没有在查询端和候选端同时纳入动作信息。
Robota-Embed 则实现动作在检索两端的双向嵌入。查询端包含任务指令、交互区域裁剪图像与当前动作;候选端为同一指令,搭配一段严格晚于当前时刻的 4 秒视频以及对齐动作。查询与候选各自输出归一化向量,依靠余弦相似度完成排序。为适配不同数据源的动作,研究团队为每个数据源配备独立动作投影器,并设置三项训练目标,分别负责预测对齐、多模态定位区分与表征正则化。团队同时构建多源数据集与检索基准 Robota-Embed-Bench,这套统一向量还对接两类下游任务:为策略补充上下文,以及持续积累任务记忆。
01 给经验检索装上动作
Robota-Embed 核心解决机器人经验检索难题:给定机器人当前状态,从历史轨迹库中匹配后续将要发生的动作片段,而非仅仅寻找视觉场景近似的画面。团队将查询与候选样本统一拆解为指令、画面、动作三类信息。查询端组合任务指令、交互区域裁剪图像、当前原生动作;候选端使用相同指令,搭配时间上晚于当前时刻的 4 秒视频与对齐动作。两端信息分别编码为归一化向量,依靠余弦相似度完成检索排序。
查询端与未来候选端共享主干网络、视频分词器和投影头,各自挂载独立适配器;不同数据源的动作,则通过专属投影器映射至主干空间。这套设计让动作信息直接参与相似度计算,而非检索完成后才作为附加结果输出。动作纳入检索键,意味着模型比对时,会同时考量机器人正在执行的行为,不再只依靠画面外观做判断。
模型由三项目标联合训练。预测对齐采用双向 InfoNCE,将查询样本和对应的未来片段设为正样本;把任务、物体、动作存在冲突的样本作为负样本,语义模糊、存在歧义或重复的候选样本不作硬性负样本标注。多模态定位区分目标,保证相似度分数对输入变化敏感:任一模态替换、语义冲突,都会带来分数下降。表征正则化目标,则将两个批次向量中心约束至近零,防止表征坍缩为低秩空间。三项目标协同,让向量空间既能检索相关经验,又能判断片段能否接续当前动作。
02 169 万条经验怎么攒
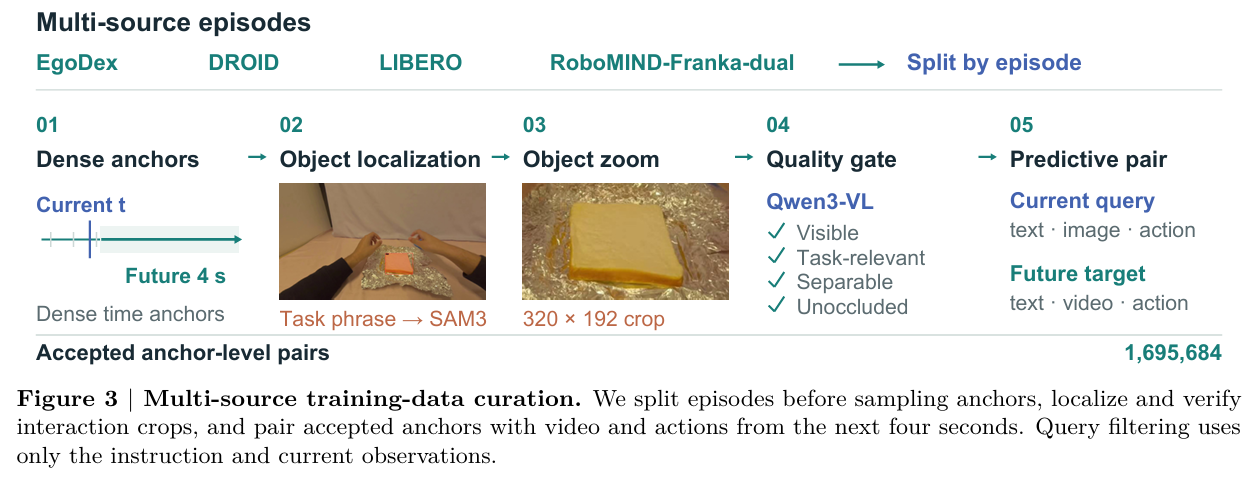
训练数据来自四个数据源,经过过滤后,一共包含 1,695,684 组「当前状态 - 未来片段」配对样本。
-
EgoDex:第一人称人类手部动作数据,贡献 134 万余条;
-
DROID:Franka 双臂真机机器人轨迹,2.6 万余条;
-
RoboMIND:Franka 双臂真机数据,18 万余条;
-
LIBERO:仿真环境数据,13 万余条。
训练阶段对四个数据源等量采样,配对仅在同源数据内部完成。尽管体量最大的 EgoDex 占整体语料近八成,团队依旧采用均等采样策略,避免海量人类样本压制三类机器人数据的学习效果。
单条样本需要经过四步加工。研究人员先将完整轨迹切分为无重叠片段,在片段内密集选取时间锚点,锚点后预留完整 4 秒后续内容。锚点确定后,借助 SAM3 依据指令定位交互物体,裁剪出 320×192 的局部放大图像。裁剪图像还会经过 Qwen3-VL 质量校验,要求目标物体可见、匹配任务指令、可区分同类物体、无遮挡;不达标的样本会退回,重新选取更早时间戳。校验通过的锚点,搭配后续 4 秒动作序列与 16 帧视频,构成一条训练样本。整套筛选流程仅使用指令与当前观测信息,不会泄露未来数据。
训练主干选用 Cosmos3-Edge 4B,28 层 Transformer。主干与共享投影头使用较低学习率,适配器与动作投影头使用更高学习率;训练迭代 26,275 步,全局批大小 512,视频分词器全程冻结。评测采用最终迭代的模型检查点,四类数据源按 1:1:1:1 比例采样。
03 缺动作比缺画面更伤
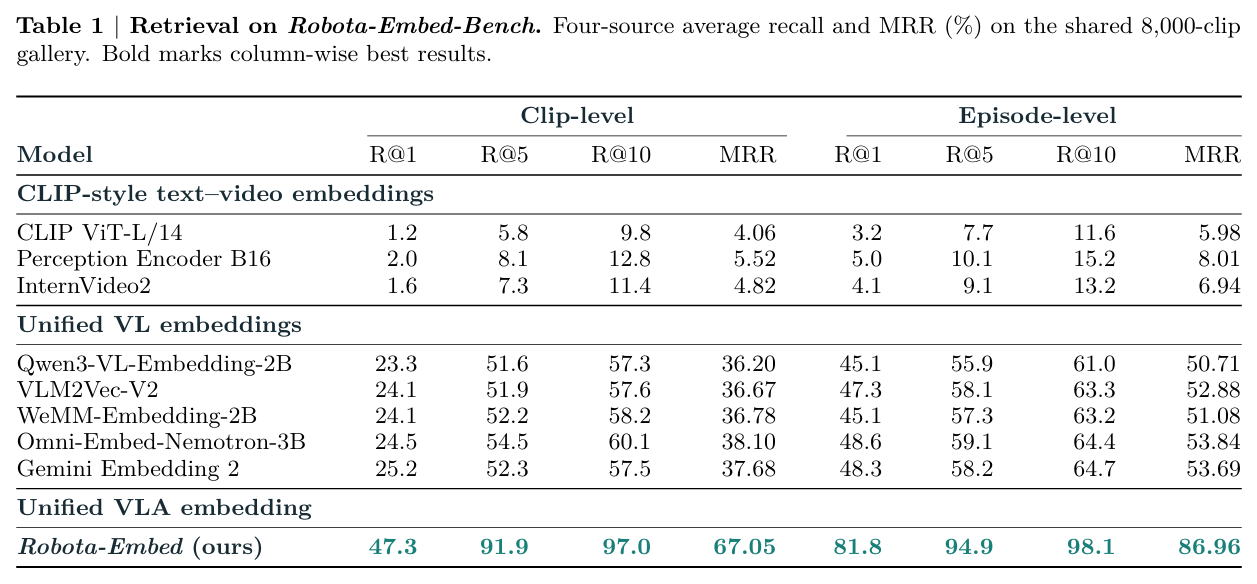
本次评测基准为 Robota-Embed-Bench,将人类、仿真、真机机器人三类经验纳入统一检索池。评测设置 4,000 条查询样本,在包含 8,000 段片段的共享候选库内检索。四类数据源各提供 1,000 条查询,源自 800 段完整任务轨迹;每组查询配套 1,000 条严格对应的未来片段、以及 1,000 条同轨迹内的邻近片段。评测采用两项统计口径:clip 级仅命中完全匹配的目标未来片段才算成功;episode 级只要检索结果出自同一段任务轨迹,即判定为相关。排序全程基于归一化向量的余弦相似度,不额外引入重排操作。
实验共对比八个体量相近的基线模型,包含 CLIP 这类文本检索视频模型,以及统一视觉语言嵌入模型。四类数据源综合均值下,Robota-Embed clip 级 R@1 达到 47.33%,episode 级 R@1 为 81.77%。表现最优的两组不含动作信息基线 —— Gemini Embedding 2、Omni-Embed-Nemotron-3B,对应 clip 级 R@1 分别为 25.24% 与 48.59%,Robota-Embed 分别领先 22.09、33.18 个百分点。分数据源来看,DROID 数据集难度最低,clip 级 R@1 可达 74.10%;EgoDex 难度最高,仅 36.70%。团队解释,EgoDex 单条轨迹内存在大量视觉近似片段,识别所属轨迹相对简单,但精准定位到目标配对片段难度很高,这也是区分 clip 级、episode 级两项指标的原因。
能增益并非主干网络原生具备。使用同一主干直接提取向量,clip 级 R@1 仅 0.65%;经过检索专项训练后才提升至 47.33%。在 DROID 受控切分实验中,仅训练读取头,指标为 13.8%;主干与读取头联合训练可达到 78.7%。研究还量化了三项目标函数各自贡献:仅使用预测对齐目标就能达到 75.6%;叠加正则化目标提升至 77.0%;再加入多模态定位区分目标,最终来到 78.7%。这说明后两项目标主要优化检索排序精度,而非从零建立召回能力。
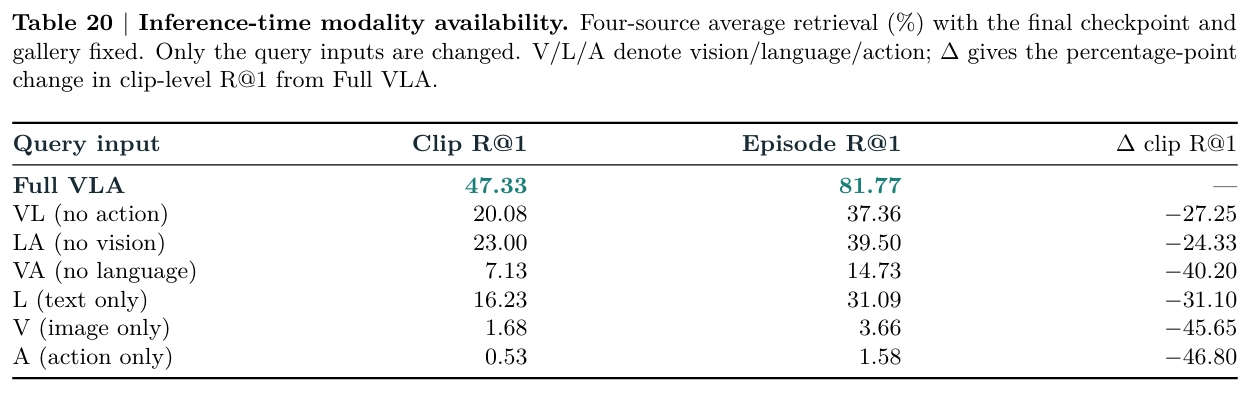
受控重训实验得出全文支撑「动作需要纳入检索」的核心证据:移除动作模态,clip 级 R@1 下降 18.9 个百分点;移除画面模态仅下降 1.9 个百分点。 而在已训练完成模型上做输入遮蔽实验,结果有所区别:移除查询内的动作信息,指标下降 27.25 个百分点;移除画面则下降 24.33 个百分点,两组差距缩小。团队强调两组实验衡量的是不同维度:重训实验观察剩余模态能否弥补缺失信息;遮蔽实验衡量训练完毕模型对各类输入的依赖程度。因此重训中画面指标衰减小,不代表最终模型可以舍弃画面输入。
本节同时给出工程性能数据。候选库规模由 100 万段扩充至 1,500 万段时,单张 NVIDIA A100 显卡上,查询编码 + 检索总延迟从 160.36 毫秒增至 195.17 毫秒。其中编码耗时固定为 157.70 毫秒,增量耗时基本来自检索环节。该计时未计入交互区域预处理、参考片段重排、下游策略推理耗时,实际部署需要叠加以上环节开销。
04 检索到的经验怎么用
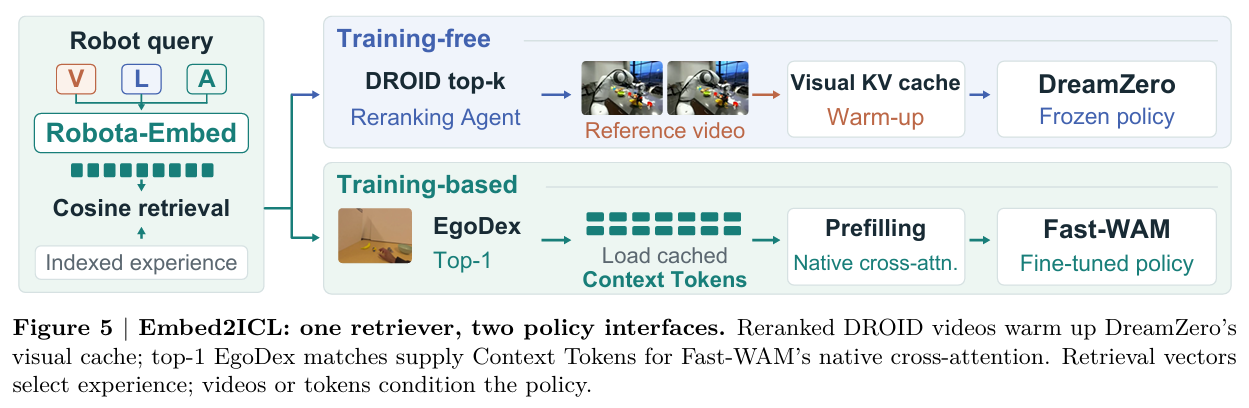
检索得到的片段仅为中间输出,团队设计两条技术路径,将检索经验对接机器人策略。第一条路径为 Embed2ICL,分为冻结模型与可微调模型两套方案:冻结方案利用检索得到的真机机器人录像,初始化固定不变的 DreamZero 策略视觉缓存;微调方案则将检索筛选的人类演示转为上下文词元,输入微调后的 Fast-WAM 模型。
冻结方案在 DROID-Sim 的三项任务中,每组设置 100 轮测试。无参考预热时平均成功率为 47.0%;随机选取参考片段,成功率反而回落至 36.0%;采用 Robota-Embed 检索参考可提升至 50.3%,叠加重排步骤后达到 56.3%。这组结果印证,选错参考样本,效果甚至不如不使用任何参考。
微调方案在 LIBERO 的五个高难度任务子集上验证。模型基线版本平均成功率 86.4%,接入检索生成的上下文词元后提升至 92.8%;替换为随机上下文词元仅为 88.0%。性能提升来自检索筛选的有效样本,并非单纯增加输入词元带来的增益。
真机实验中,团队将 DreamZero 适配至 YAM 机器人,仅依靠 55 条演示轨迹完成基础训练。冻结方案测试「把香蕉放入碗中」任务,平均任务进度从 21.67 提升至 40.00,任务成功率由 0 提升至 16.7%;微调方案在两项任务里,分别将任务进度从 75.00、66.67 提升至 79.17、87.50。冻结方案实现任务进度近乎翻倍,但绝对成功率依旧偏低,说明检索参考能够带来正向帮助,距离稳定可靠完成任务仍有差距。
第二条路径为 Embed2Evolve,将检索机制用于任务记忆管理。依托权重冻结的 GPT-6 Astra 策略,机器人每完成一轮尝试,无论成败,都会将本次接续轨迹存入任务记忆。检索模块会根据执行反馈动态调整配置:控制召回片段数量、记忆刷新频率与历史留存规模。记忆库与检索配置协同迭代,策略权重全程保持固定。
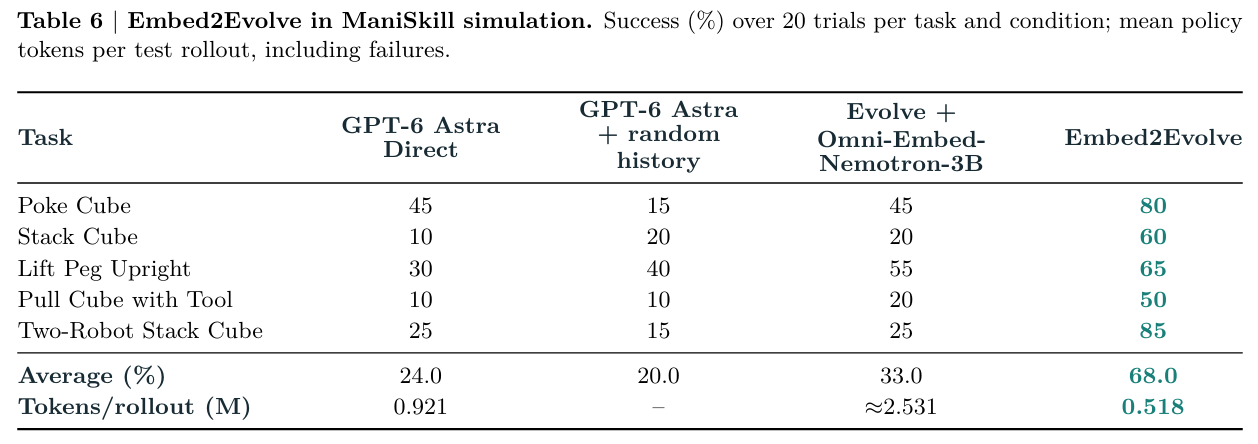
在 ManiSkill 五项任务中,每种设置重复 20 次全新初始化测试。原生 GPT-6 Astra 基线平均成功率 24%;接入固定随机历史样本后下降至 20%;启用 Embed2Evolve 可达 68%。相同实验设置下,替换检索模型为 Omni-Embed-Nemotron-3B 进行迭代,成功率仅 33%。同时 Embed2Evolve 的策略词元消耗量相比该基线降低约 79.5%;对比原生策略,词元用量减少 43.7%,参考接口成本由 9.96 美元降至 5.80 美元,成本节约主要来自输入侧优化。
两套方案共用同一套融合动作感知的检索向量。一方面,策略能够即插即用,复用外部示范经验;另一方面,机器人可以积累随任务推进持续生长的专属记忆。团队提出后续研究方向,聚焦动作空间、机器人本体与变长检索,目标让检索片段的接续时长随任务类型与执行阶段自适应,不再固定为 4 秒。