

贾奎团队新作:让世界动作模型真正理解三维空间
UNITAS 将观测、动作与场景变化统一至同一个米制三维坐标系:以点轨迹表征人手与夹爪的运动,用场景流描述场景点的位移,让世界动作模型不再单纯依靠图像推测环境演化。模型参数量仅 1.7 B,在 LIBERO 基准测试上取得 99.8 % 任务成功率;在基于动作条件的场景预测任务中,移动点的位移预测误差较 PointWorld 降低 35 %。
10 月 8 日,香港中文大学(深圳)、跨维智能、佛山大学、中山大学与华南理工大学联合团队发表论文《Unitas: A 3D-Native World Action Model for Embodied Manipulation》。论文共 17 位作者,香港中文大学(深圳) Ruixiang Wang 与佛山大学邢晓芬为共同第一作者;香港中文大学(深圳)数据科学学院助理教授、跨维智能强化学习技术专家刘桂良参与研究;佛山大学苏永怡、香港中文大学(深圳)数据科学学院教授、跨维智能创始人贾奎担任通讯作者。刘桂良主要研究具身智能与强化学习,曾在 NeurIPS、ICML、ICLR 等顶级会议发表多篇论文,并担任 NeurIPS、ICLR 领域主席。
世界动作模型需要回答一组耦合问题:给定任务指令,机器人应当执行何种动作,以及该动作将如何改变周边环境。
过往相关研究大多依托预训练视频生成器构建,依靠未来图像或视觉潜变量表征环境变化。但机器人交互发生在真实三维空间,图像只是三维空间的二维投影。同一个动作、位移或是接触事件,更换拍摄视角后,画面呈现效果就会发生改变,像素位移也无法直接等价于物理距离;一旦相机内参、相机与机器人之间的相对位姿发生变动,这套映射关系也会随之偏移。这就导致模型学到的世界只是「视觉上近似」,而非「物理上可度量」。即便生成的预测画面足够逼真,物体位移、刚性几何属性与静态区域的预测结果仍可能出现隐性偏差。UNITAS 试图更换底层表征底座,将观测、动作与推演结果全部纳入共享的米制坐标系,让世界动作模型直接在三维物理空间内完成预测与仿真推演。
01 三维标尺,重构模型表征
UNITAS 改动的首要部分是表征体系。它重新定义动作的表达方式,摒弃一串关节角,转而使用人手与夹爪在三维空间中形成的分段点轨迹,团队将其命名为动作流;场景内各点在动作驱动下产生的位移,则记作场景流。二者统一落在同一个米制坐标系内,在单次预测窗口中,观测、动作、场景变化共享这套坐标基准。
为何要更换这套度量标尺,论文给出的示例十分直观。同一物体移动相同物理距离,在近处相机与远处相机下,像素位移差距悬殊;一旦相机内参、相机与机器人的相对位姿发生改变,这套换算关系也会同步变化。基于视频路线的世界动作模型,将环境变化存储在像素或视觉潜变量当中,使用的正是这套可变标尺。因此即便生成画面足够逼真,物体位移、刚性几何特征与静止区域依然可能出现隐性偏差。将观测、动作与推演结果锚定在共享的米制坐标系,模型学习的度量标准,就从「画面上移动了多少像素」转变为「物体真实移动了多少厘米」。
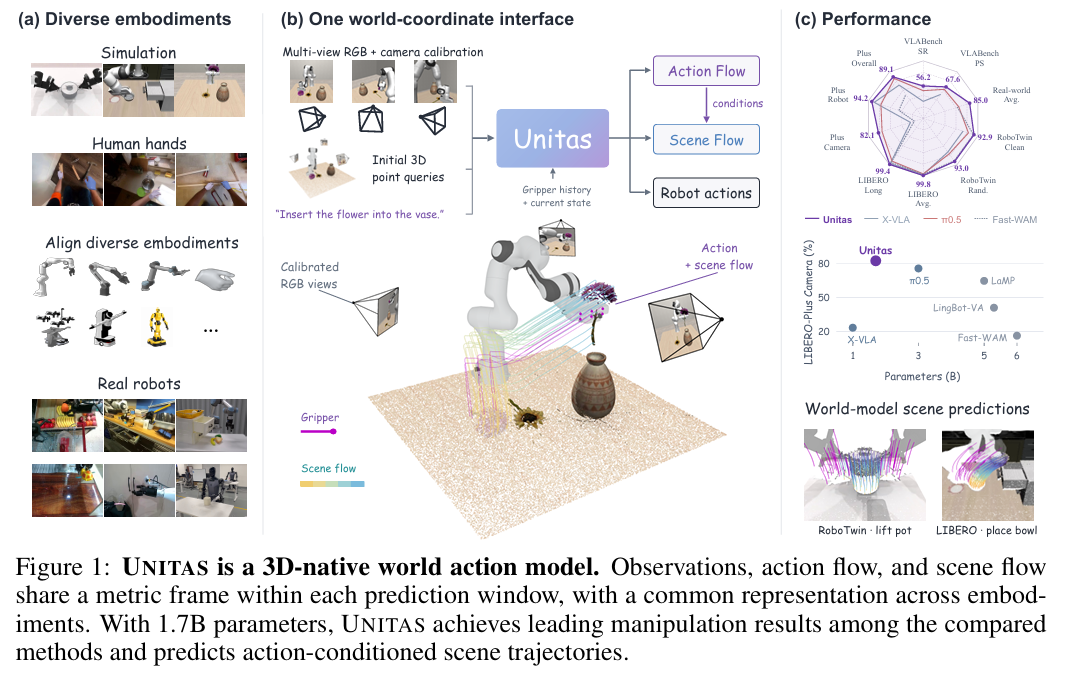
坐标能够绑定到视觉信息,依靠世界对齐的三维位置嵌入。每一个视觉 token 都关联世界坐标系下的空间位置。当有效深度可用时,团队将像素依托深度完成反投影,再经由相机外参转换至世界坐标,采用一组固定傅里叶特征对该位置编码;缺少深度信息时,则在每条相机光线上,从 0.1 米到 2 米均匀采样 64 个候选位置,由 patch 特征为候选位置打分,加权求解得到世界坐标。该设计的优势在于,模型可同时接收带深度与无深度两类数据,推理阶段即便缺失深度输入也可正常运行。依托相机光线上候选位置加权求解世界坐标,是该模型在无深度输入条件下依旧能够完成三维对齐的核心支撑。
无深度分支并非无监督凭空学习。在具备可靠深度的区域,团队约束光线上候选位置的加权结果,与真值深度反投影得到的位置保持对齐,通过监督信号修正路由权重,仅有效深度对应的像素参与该对齐过程。训练阶段可同时使用 RGB 与 RGB-D 两类数据;推理时移除深度输入,模型性能不会明显下降。三维位置嵌入并不依赖硬件深度传感器,同一套权重,测试时可将深度输入替换为光线路由方案。
动作点与场景点的选取也经过设计。机械臂夹爪依据 URDF 几何模型,每只夹爪选取 20 个点,跟随正运动学,随关节与手指姿态同步运动;人手采用每只手 21 个 MANO 关键点,使人手与机械夹爪拥有统一表征形式。场景点按照体素划分,上限 12,000 个并做随机下采样,仿真数据集采用 5 毫米体素。
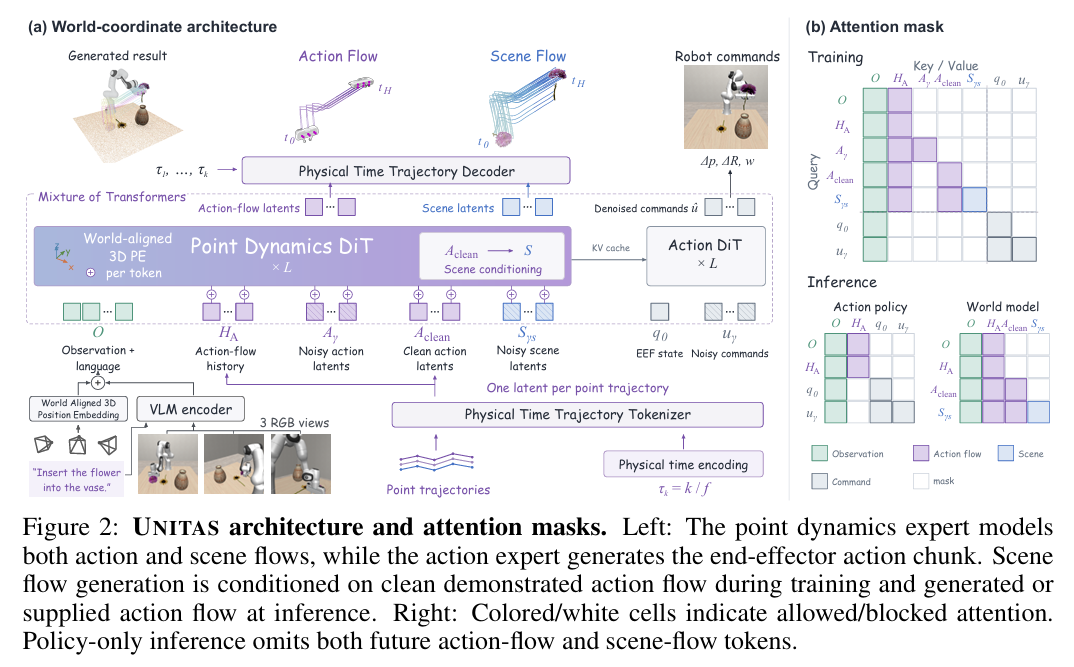
第三个核心组件是物理时间轨迹分词器。不同数据源的帧率、时长各不相同,如果把每一个时间步单独作为一个 token,相同时长在不同数据源里占用的模型容量会不一致。团队改用秒而非帧号标记时间,采样率记为 f,第 k 个时刻对应的 τ = k /f;借助跨数据集共享的固定基函数,将相同的真实流逝时间映射为相同特征。输入 MLP 将每一段位移转化为向量,时间 MLP 把时间特征转化为调制参数,编码器将整条轨迹池化为单个潜变量,解码器可在指定时刻读取还原。如此一来,无论轨迹长短、采样疏密,每条轨迹仅占用一个 token。
三者的联合分布拆解为三项因子:优先生成动作流,动作块以动作流与机器人当前状态为条件,场景流再以动作流为条件。拆分后,动作流与动作块支持并行采样;场景预测既可以使用模型自主生成的动作流,也能在模拟器模式下,以外界输入的一段轨迹作为条件。仅运行策略分支时,可只计算动作块分支,直接省略两支点流的全部计算。单模型因此具备双重能力:既能直接输出机器人动作指令,也能给定动作序列推演环境变化。
这套表征体系还天然支持跨本体泛化。人手与机械夹爪的点全部落入同一坐标系,共用同一个分词器;观测 token 依照世界坐标排布,动作流与场景流的 token 锚定在各自对应的三维位置,网络在固定空间锚点上学习运动规律。将点轨迹统一理解为「从当前位置出发产生的位移」,是让不同来源、不同视角的数据合并进同一表征空间的关键。
模型主体由一组耦合专家模块构成。点动力学专家负责动作流与场景流,动作专家负责输出可执行的末端动作块;二者均为扩散 Transformer。动作专家体量更小,逐层读取点动力学专家的观测与语言键值,叠加自身当前状态与带噪指令。训练阶段,场景预测以示范样本中干净的动作流作为条件;推理阶段,动作流与动作块在同一套欧拉时间表并行去噪,生成的动作流再作为条件驱动场景去噪。仅执行策略任务时,可跳过未来动作流与场景流两个分支,直接输出动作。
视觉语言骨干基于 Florence-2-large 搭建,点动力学专家维护动作流、场景流双分支;动作专家体量更小,逐层读取点动力学专家的观测与语言键值,叠加自身当前状态与带噪指令,预测每个未来时间步的相对平移、旋转以及夹爪开合。两个专家均为 28 层:点动力学分支宽度 640、10 个头;VLM 骨干为 28 层、宽度 1280、20 个头;分词器潜变量维度 256。大骨干搭配轻量化动作专家的架构,让动作分支仅保留浅层耦合,无需从头重构骨干网络。推理阶段可缓存上下文与干净动作流的键值,场景去噪的每一步计算都能够复用缓存。
02 九个数据源,两段式训练
在数据层面,团队整合九个数据源开展预训练,包含公开数据集 RoboTwin、LIBERO、VLABench、DROID、AgiBot、RoboMIND、RH20T,以及人体手部数据集 VITRA 和团队自研采集数据集 W1。不同数据之间运动速率的差异,依靠物理时间对齐机制消解:AgiBot 与 RoboMIND 的原始轨迹为 45 赫兹,团队以步长 3 下采样至 15 赫兹,让单个动作块覆盖更长物理时长,使其空间跨度与其余数据集保持相近;VITRA 内部,Ego4D 采用 6 赫兹,EgoExo4D 与 Something-Something V2 采用 8 赫兹,EPIC-KITCHENS 采用 10 赫兹。
轨迹分词器并非冗余组件。团队在预留的 600 条轨迹窗口上开展逐点验证:将整条点轨迹编码为单个 token,再依据原始物理时间戳解码还原,重建误差达到毫米量级。这证明单个 token 足以完整承载一条轨迹的运动信息,无论该轨迹来自机械臂、人手或是场景点。
选用秒而非帧号作为时间基准,存在明确考量。九个数据源的帧率区间为 6 赫兹至 45 赫兹,同一个动作在不同录像中占据的帧数相差数倍;如果以帧计量时间,相同长度的物理时间,在不同数据源里分配到的模型容量并不均等。对齐至真实秒数之后,快慢不一的动作才能在统一度量尺度下学习。
九个数据源各司其职。RoboTwin、LIBERO、VLABench 提供仿真环境下的单臂与双臂任务;DROID 为真实场景大规模演示数据;AgiBot、RoboMIND、RH20T 来自不同机器人本体的真机采集;VITRA 提供第一视角人手动作数据;W1 是团队自采数据集。机器人分支输出夹爪点轨迹,人手分支输出关键点轨迹,仿真数据集还可提供场景点真值;缺失标注的部分直接屏蔽,不参与损失计算。
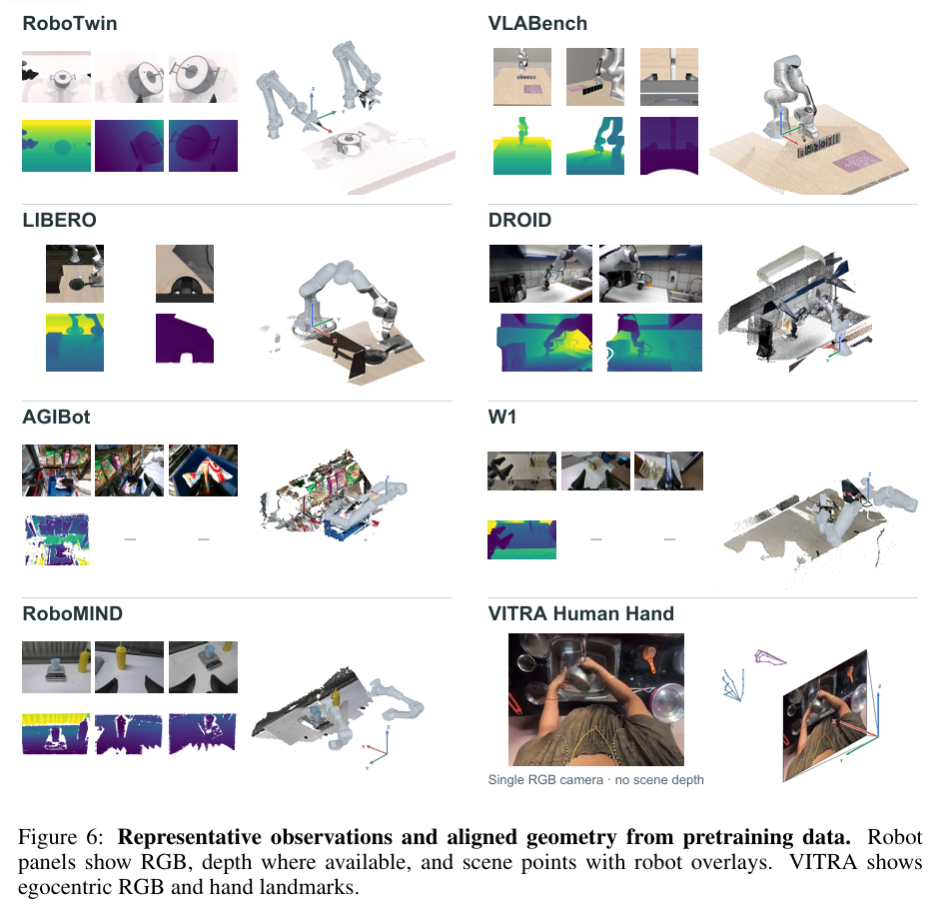
训练流程分为两个阶段。第一阶段单独训练轨迹分词器,任务是重建历史与未来动作流,以及可用的场景轨迹,训练完成后冻结分词器权重。第二阶段由两组专家模块基于修正流联合训练,总损失由四项叠加构成:动作流、场景流、动作块各自对应的均方误差,外加位置嵌入监督损失。前三项损失权重均设为 1,位置嵌入损失权重设为 0.1,缺少标注的目标样本直接屏蔽。视觉语言骨干基于 Florence-2-large 初始化,VLM 为 28 层、宽 1280、20 个头;点动力学专家与动作专家均为 28 层、宽 640、10 个头;分词器潜变量维度为 256。预训练共计 20 万步,总批大小 1024,优化器选用 AdamW;专家模块学习率设置为 1e-4,VLM 学习率设置为 1e-5,权重衰减 1e-8,经过 1,000 步线性预热后学习率保持恒定,训练占用 64 张 BW1000_H。
分词器先行训练并冻结、专家模块后续学习,这套两段式架构,将「运动表征学习」与「动作生成」拆分为独立阶段,避免两个任务互相干扰。
推理效率也是这套设计带来的附加优势。仅执行动作输出任务时,UNITAS 无需生成动作流与场景流,在单张 RTX 5090 D 上,单个动作块推理耗时 55.77 毫秒,相比同时生成动作与动作流的版本提速 2.20 倍;在 1.7 B 参数规模下,相比不含视频生成能力的 Fast-WAM,推理速度提升 2.81 倍。当模型作为模拟器使用时,场景查询点数量可在推理阶段动态调整,从 3,000 降至 1,024,联合预测延迟从 561.60 毫秒下降至 305.49 毫秒,可在场景覆盖密度与算力开销之间按需权衡。上下文与干净动作流的键值会被缓存,在场景去噪的每一步复用,减少重复计算。
03 策略成绩:小模型,硬核指标
在策略层面,UNITAS 在多项标准基准测试中取得领先结果,且模型参数量保持轻量化。LIBERO 基准平均任务成功率 99.8 %;即便不开展混合数据预训练,也能达到 99.5 %。RoboTwin 2.0 的 50 个双臂任务中,干净条件下成功率 92.94 %,随机扰动条件下为 93.04 %。该结果由 1.7 B 参数模型实现,参数量低于 Fast-WAM 的 6 B 与 Motus 的 8 B。VLABench 上成功率 56.2 %,高于 π0.5 的 48.1 %,进度分同样更优。1.7 B 的小模型性能超越 6 B、8 B 级别的视频世界动作模型,证明将交互行为纳入三维坐标表征本身就具备参数效率优势。

抵御分布漂移是模型另一项突出优势。LIBERO-Plus 集合七类观测、指令与初始状态扰动,UNITAS 以 89.1 % 的总分排名第一;相机扰动场景取得 82.1 %,优于 Cosmos Policy 的 75.8 % 和 LaMP 的 64.5 %。混合数据预训练可将总分再提升 2.6 个百分点,其中机器人初始状态变化带来的增益最为显著,从 84.8 % 提升至 94.2 %;语言改写任务得分从 77.6 % 提升至 85.0 %。团队还做了对照验证:保持 RoboTwin 样本数量不变,仅额外引入其他数据源,RoboTwin 测试集上的末端误差反而下降,证明跨数据集迁移效果为正向增益。
先厘清各基准的评测侧重点。LIBERO 面向单臂操作任务,分为 Spatial、Object、Goal 以及长程任务 LIBERO-10 四个子集;RoboTwin 2.0 包含 50 项双臂任务,设置干净环境与随机化扰动两组条件;VLABench 检验物体与指令泛化能力,分为五条赛道,采用成功率、进度分、意图分三项指标评估;LIBERO-Plus 专门构造七类扰动,覆盖相机、光照、背景、噪声、布局、机器人状态与语言指令,用于衡量模型在分布外场景下的鲁棒性。所有模型均在同一评测协议下运行,成功率采用统一口径统计,支持横向对比。
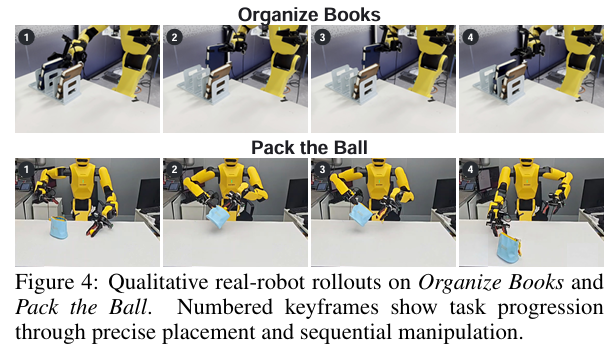
真机实验中,团队对两项任务各重复测试 20 轮。整理书架任务要求将书本对齐放入书架格子,UNITAS 成功 18 次,成功率 90 %;对比 π0.5 的 15 次成功、Fast-WAM 的 13 次成功。打包球任务需要将球体装入袋子并拉上拉链,UNITAS 成功 16 次,成功率 80 %;对比 π0.5 的 11 次成功、Fast-WAM 的 12 次成功。
消融实验逐项拆解各模块的贡献。移除三维位置嵌入后,LIBERO-Plus 总分由 85.74 % 下降至 81.35 %,相机扰动项衰减最为明显,从 79.11 % 跌至 66.73 %;移除动作流监督,总分降至 78.89 %;移除动作流历史 token,总分降至 75.92 %,机器人初始状态扰动指标下降 19.87 个百分点;三项模块一并移除后,模型退化为普通 VLA,得分仅 67.58 %。与之相对,为基准模型增加场景流监督,总分从 85.74 % 提升至 86.47 %,说明对场景变化的预测能力,能够反向优化动作学习效果。
04 动作驱动的三维场景预测
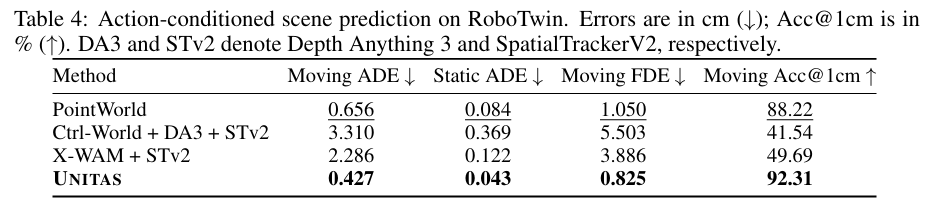
UNITAS 的另一项核心能力是模拟器模式:输入当前观测与一段动作序列,模型即可预测三维点后续的位移变化。团队在 RoboTwin 的预留轨迹集上开展评测,将 UNITAS 与直接预测三维轨迹的 PointWorld、视频路线方案 Ctrl-World、X-WAM 进行对比;视频类模型的预测结果先提升至三维空间,再依托初始帧真值深度完成标定。UNITAS 在四项指标上全部取得领先:移动点平均位移误差 ADE 从 PointWorld 的 0.656 厘米降至 0.427 厘米,静止区域漂移从 0.084 厘米降至 0.043 厘米,端点误差 FDE 从 1.050 厘米降至 0.825 厘米,落点 1 厘米内准确率由 88.22 % 提升至 92.31 %。四项指标全面占优,静止区域漂移近乎减半,这正是「在三维里量得准」和「在图像里看着像」两类方案的分水岭。
场景预测的训练监督信号仅来自仿真数据,但模型可以泛化至未见过的真实场景。团队在 DROID、RH20T 数据集上,仅输入真值夹爪轨迹作为条件,令模型预测真实场景的三维变化。即便没有在真实场景流数据上做监督训练,模型依旧能够贴合画面内物体的位移与空间构型,输出合理的运动推演结果。
评测环节统一了对比口径。团队基于 RoboTwin 的预留轨迹,采用同一组初始观测、同一段机器人动作作为条件,以仿真器状态作为三维真值;视频路线模型的预测结果先映射至三维空间再参与对比,标定过程仅使用初始帧真值深度。四项指标各司其职:移动点 ADE 代表平均位移误差,FDE 代表最后一步端点误差,Static ADE 衡量背景静态点的漂移量,Acc@1cm 统计移动点预测位置落在真值 1 厘米范围内的占比。
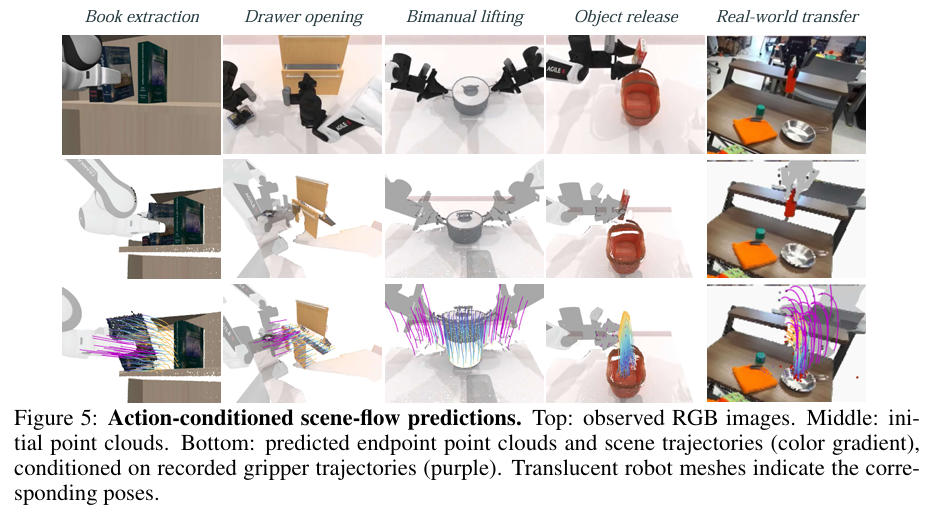
这套接口天然支持跨本体通用。人手与机械夹爪共用同一套动作流表征,动作流、场景流与历史轨迹共享同一个分词器,不同本体、不同观测视角的数据能够纳入同一表征空间参与计算。真实世界的三维变化,正是依托这套跨本体共享表征,实现从仿真域向真实场景的迁移。
将策略生成与场景推演整合至同一套接口,是本文另一处关键设计。同一个模型,仅运行策略分支时输出动作指令;切换为模拟器模式,则预测场景演化,两种使用方式共享同一套三维表征。动作流与场景流是物理交互的一体两面,并非两个独立模型分别负责。团队将这条技术路线命名为物理空间的世界动作建模:交互几何从隐性背景转变为显式预测目标,动作学习与世界建模由此衔接在同一根逻辑轴上。