

清华丁宁团队发布灵巧手仿真基准 HandsOn,放出 18,000 条示范
作者:江思奇
机器人操作领域的主流评测基准,大多围绕两指夹爪搭建。面向五指灵巧手的评测数量少、规模有限,任务设置与计分口径各不相同,不同团队的实验结果难以横向对比。
10 月 19 日,清华大学、北京邮电大学、自然意志与北京大学联合发布论文《HandsOn:面向可泛化灵巧操作的大规模仿真基准》。论文共 17 位作者,Tianwei Luo、Yiming He、Hongjin Wu、Ting Pan、Debin Ren、Haorui Guo 为共同一作;通讯作者丁宁为清华大学电子工程系助理教授、博士生导师,同时隶属于自然意志。丁宁长期深耕人工智能方向,成果曾发表于 Nature Machine Intelligence、ICLR、NeurIPS 等顶刊与顶会。
团队同步开源这套灵巧操作仿真基准 HandsOn:内含 66 项任务、18,000 条人类遥操作示范,代码与数据集全部对外开放。
研究团队依托该基准对多款主流机器人模型开展测试,结果显示灵巧操作方向仍存在较大提升空间,同时验证这套基准能够有效区分不同方案的性能差异。
灵巧手评测,缺一把共同的尺子
过去几年,机器人操作数据集与评测方案大多面向夹爪设计,现有大规模仿真与实物操作数据集以夹爪为主。夹爪擅长「抓起来、放下去」,但大量日常动作离不开多根手指配合:拧旋钮、按按钮、握锤敲击、对准孔位插接插销。这类动作很难在夹爪评测体系里合理出题。
灵巧手评测并非一片空白,早期灵巧操作评测多依托强化学习,或是示范样本规模很小;今年陆续诞生一批基于示范学习的基准。
DexJoCo 包含 11 项任务、1,100 条人类示范,DexVerse 包含 100 项任务、3,180 条,Bench2Dex 包含 26 项任务、约 1,300 条。各个基准的任务清单、评测边界并不统一。相关工作同时提及面向实验室场景的分层基准 LabDex。
行业硬件标准已有明确进展。根据国家标准馆登记信息,由中国电子学会归口的团体标准 T/CIE 387-2026《人形机器人灵巧手通用技术要求》于 3 月 25 日发布、4 月 1 日实施,起草单位包含中国工业互联网研究院等机构。这份标准约束灵巧手硬件本身,适用于灵巧手的测试与评价;但灵巧手控制模型的任务完成能力,依旧缺少业界公认的横向对比方案。
而这正是 HandsOn 希望补齐的一环:为灵巧手控制模型,提供任务丰富、示范充足、支持横向对比的统一评测体系。
HandsOn 做了什么
HandsOn 是一个可组合的仿真平台,基于英伟达 Isaac Sim 5.1 搭建,支持 5 款机械臂、6 款灵巧手和约 200 件刚体、铰接体与柔性物体。平台配套 18,000 条人工筛选过的遥操作示范和 66 项任务。按论文的统计口径,这个示范量是代表性灵巧操作基准人类轨迹数的 5.7–16.4 倍。论文还复用并改造了 DexJoCo 和 DexVerse 的部分任务设计与物体资产。
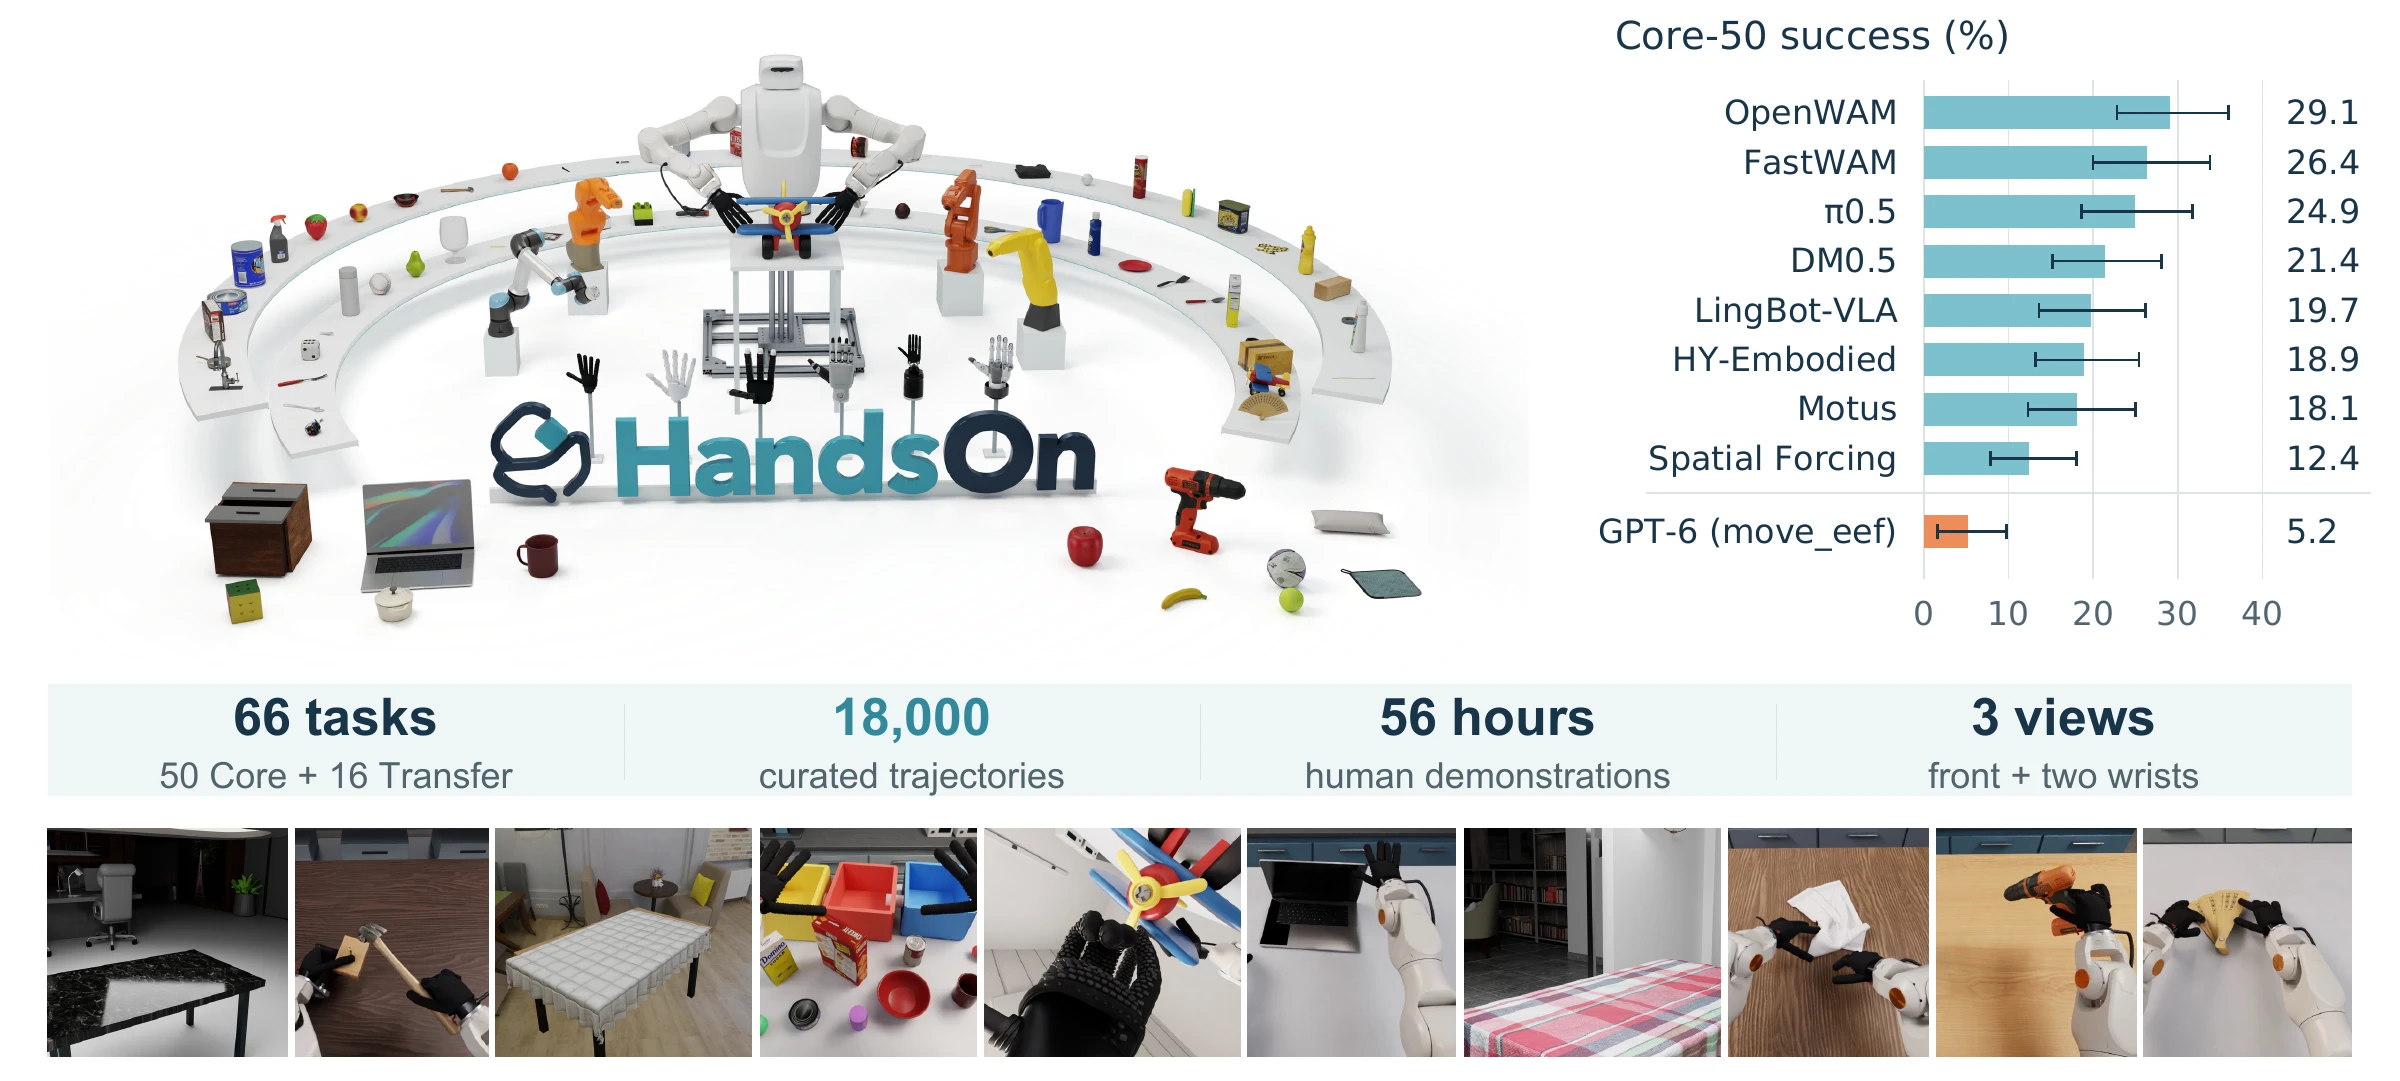
开源方面,代码仓库以 MIT 许可公开了任务环境、成功判定规则、评测配置和论文所测 9 个模型的接入代码;PhysX 后端采集的示范数据已在 Hugging Face 公开。Newton 后端的数据集标注为「即将发布」,它的评测器目前只覆盖「插销」和「水果放桶」两项任务。论文评测用的模型权重没有公开,想完整复现论文分数,需要按论文的方法自己训练。
66 项任务划分为两大集合。
Core-50 是「练过再考」:50 项任务都配有示范数据,检验模型能不能从示范里学会并稳定执行。按对手指的要求,它分成基础操作 17 项、功能性操作 18 项、接触密集型操作 15 项,覆盖用工具、数量与空间理解、铰接物体和双手协作。
Transfer-16 是「只考不练」:16 项任务没有对应的训练示范,其中 7 项换了没见过的物体或物体关系,6 项要求把学过的技能按顺序串起来,3 项是柔性物体操作,而整个数据集里没有柔性物体的示范。
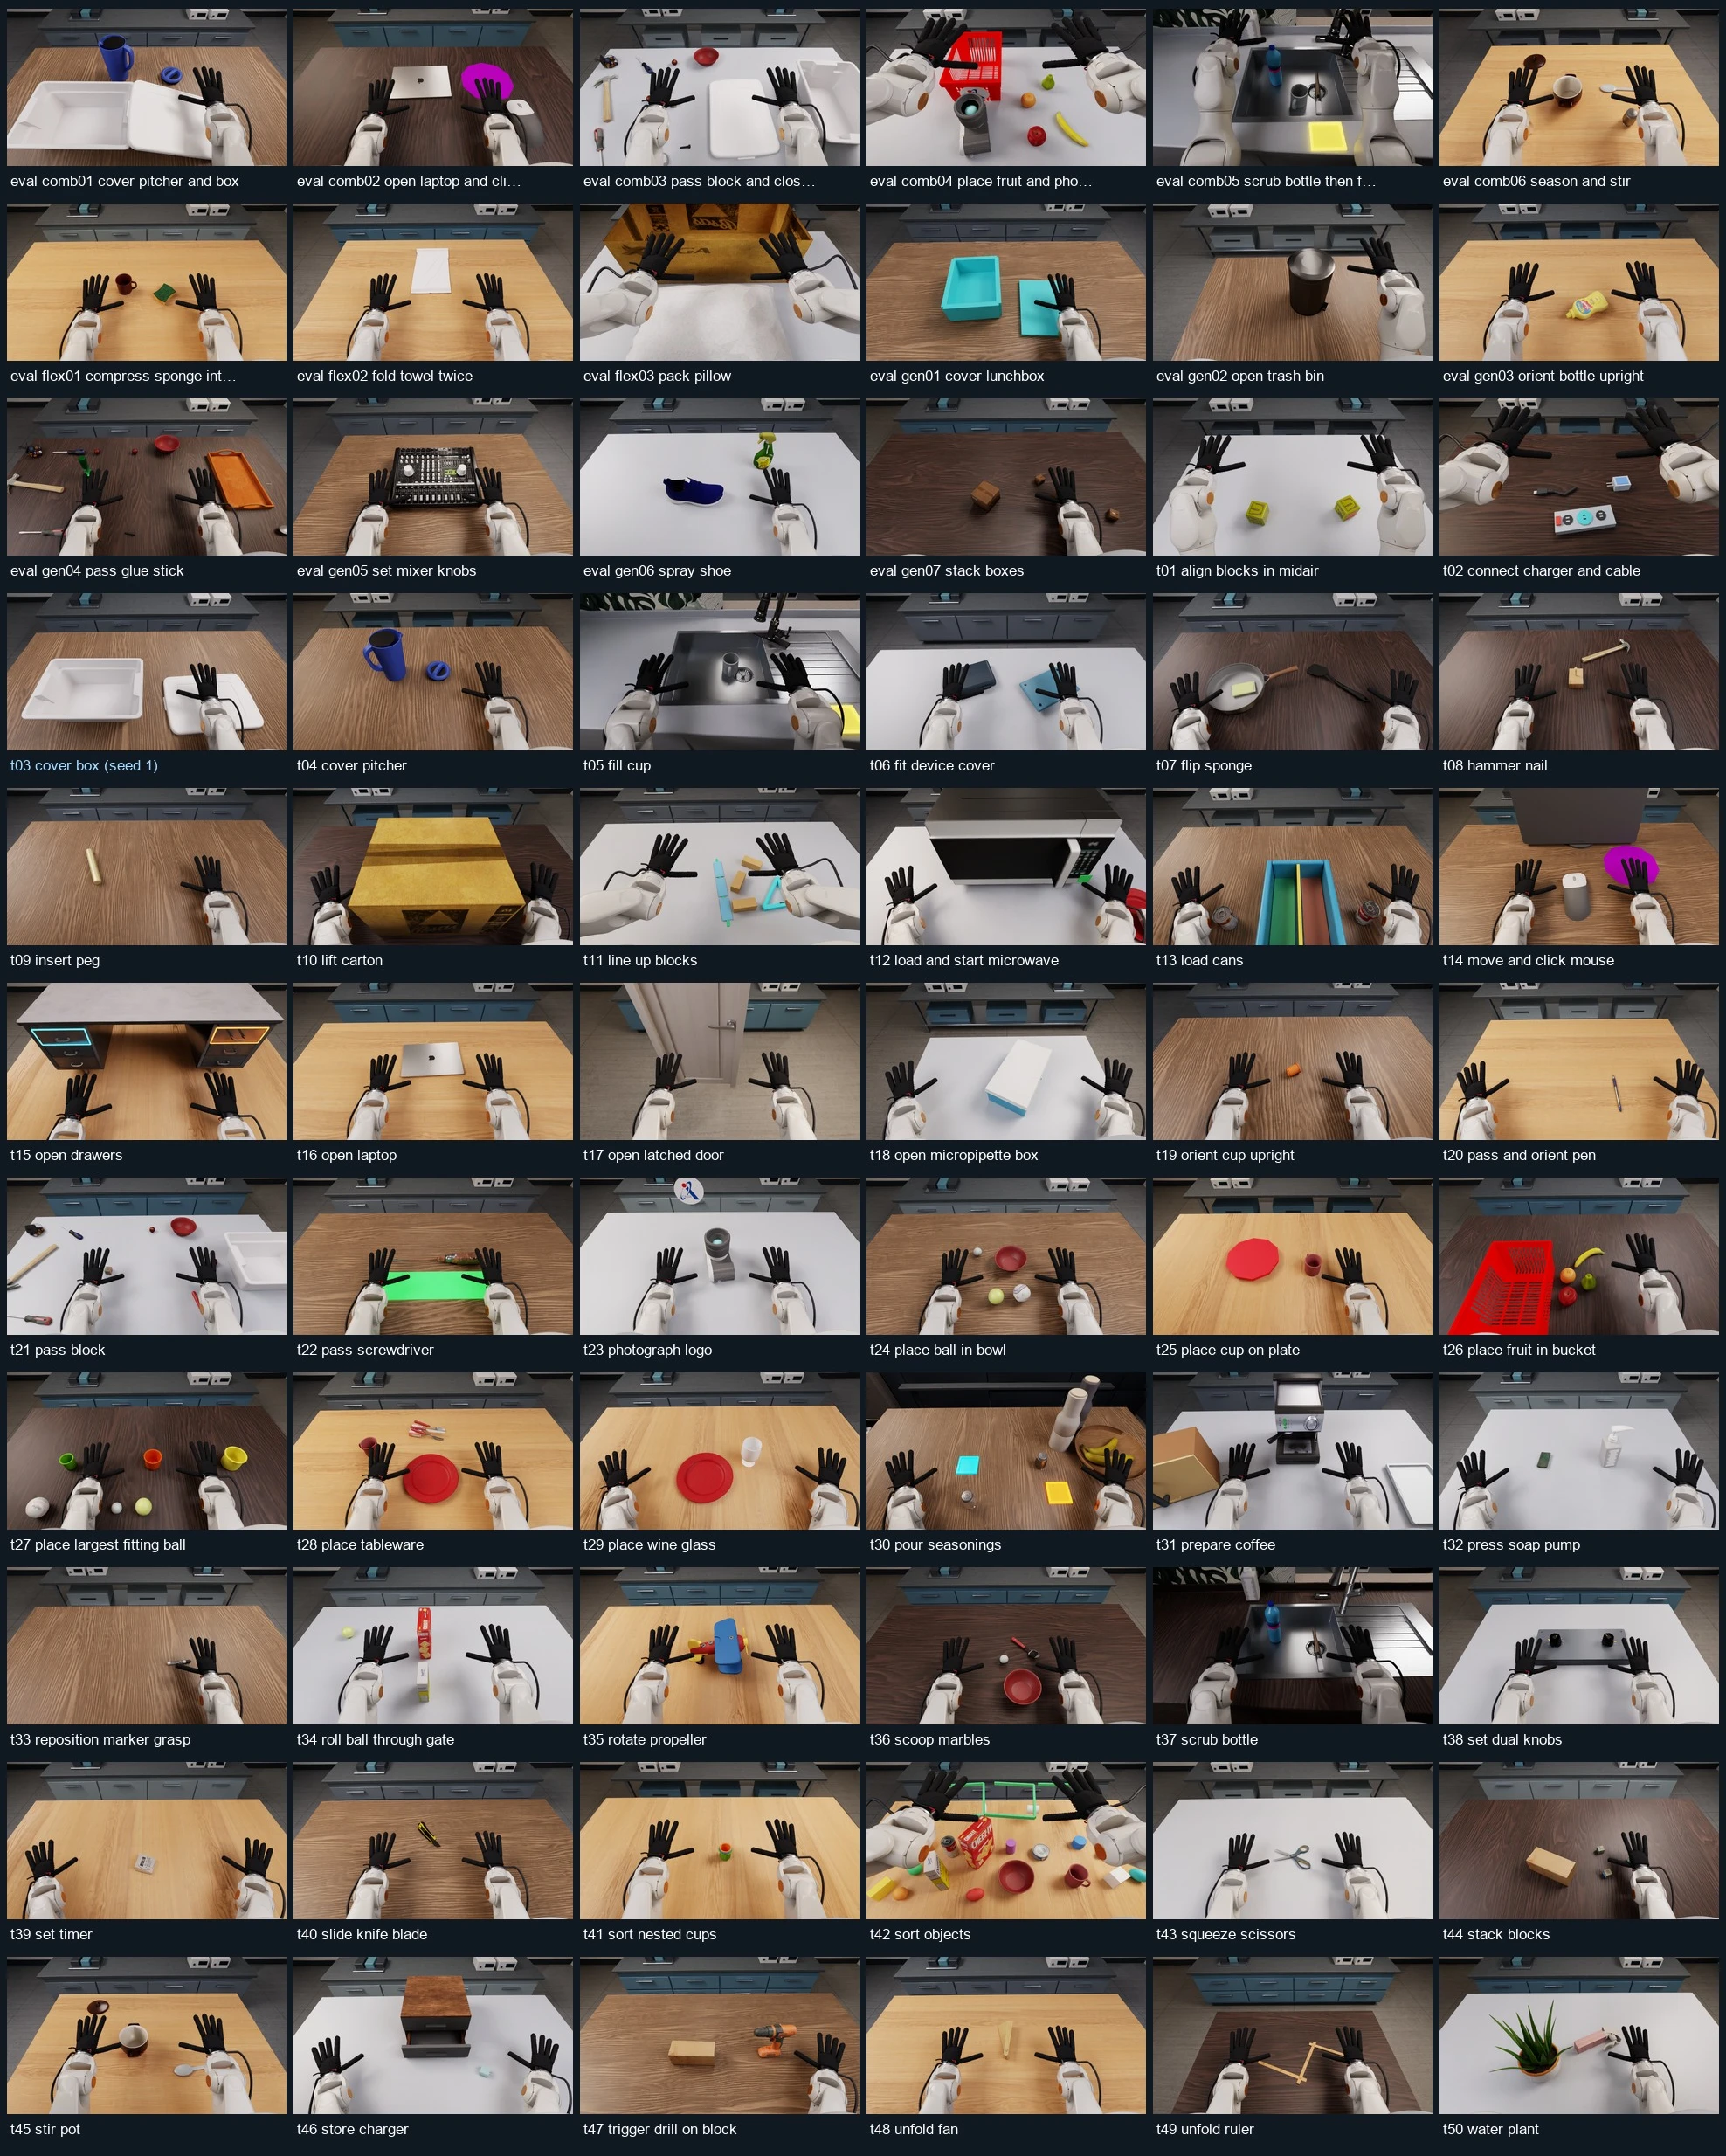
任务场景都十分具象。
Core-50 里有「搅拌锅」「设定计时器」「倒调料」「捏剪刀」「给标志拍照」,有的要双手同时拧两个旋钮,有的要一只手把方块递给另一只手。
Transfer-16 里有「先刷瓶子再接水」这样的组合题,也有「把毛巾对折两次」这样的柔性物体题。每道题都写明了怎样算完成,比如鼠标要先往垫子上挪进 8 厘米才能点击,两个旋钮要同时停在目标 5 度以内并保持住。
Core-50 每项任务的时限是专家示范用时第 75 百分位(P75)的 3 倍,给模型留出余量;Transfer-16 没有对应示范,时限按估算时长设定,三项柔性任务另设 240 秒或 180 秒。
整套任务拥有标准化的出题审核流程。每项任务先写「任务卡」,规定场景、成功标准和失败条件;新任务上线前至少试采 20 条,标签和客观证据的一致率要达到 98% 以上。采集员、审核员和仲裁人三方分开,任何人不审自己的数据;每批数据随机盲审约 20%,通过的数据再抽 5%–10% 复审。66 项任务在发布前都由采集员在发布版环境里亲手验证过,保证题目本身做得出来。
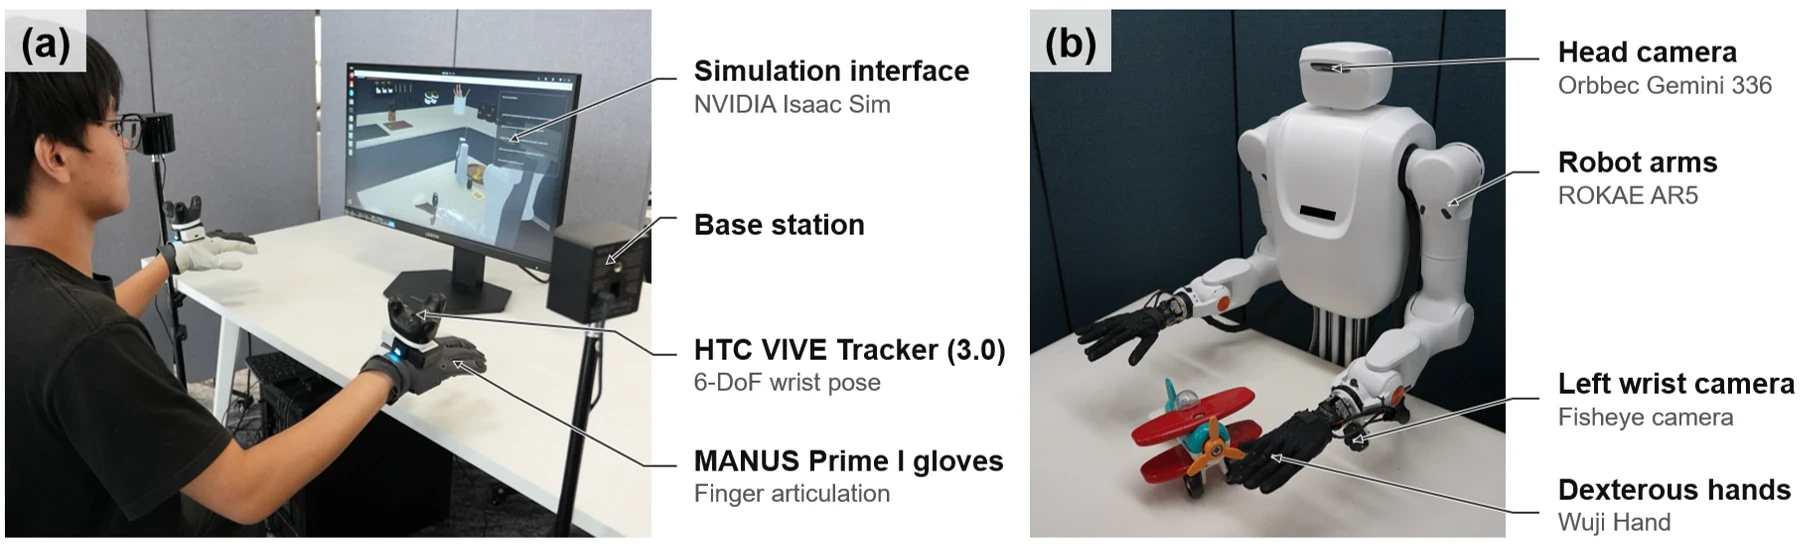
示范数据靠人类遥操作采集。操作员戴 MANUS Prime I 数据手套捕捉手指动作,用 HTC VIVE 追踪器记录手腕位置,在 PhysX 物理引擎里实时驱动机械臂和灵巧手。论文报告,至少 10 位操作员参与,累计超过 1,050 次采集,得到 18,000 条轨迹(训练集 15,178 条、验证集 2,822 条),约 56 小时,每条都有三路同步视角,控制频率 30 Hz。
为避免模型单纯记住固定画面,团队对采集轨迹做高保真重渲染:换 4 种桌面材质、3 种背景、3 种天花板,再给相机加 ±2 毫米、±0.3 度的微小扰动,动作标签保持不变。语言指令也做了扩充,91 条指令各配 32 条训练用的同义改写和 8 条留作测试的改写。
结果:难度和区分度
论文一共评测了 10 种方法:5 个视觉-语言-动作模型(VLA,π0.5、DM0.5、LingBot-VLA、HY-Embodied、Spatial Forcing)、3 个世界-动作模型(WAM,OpenWAM、FastWAM、Motus)、逐任务训练的扩散策略(DP),以及不做任何微调、直接被提示的 GPT-6 Astra(下称 GPT-6)。VLA 模型把画面和语言指令直接映射成动作;世界-动作模型在预测动作的同时,还会预测接下来的画面。8 个多任务模型都在 Core-50 的示范上训练,训练模型在 Core-50 上累计评测了约 4.5 万个回合(含扩散策略)。
8 个多任务模型的成绩拉开了明显差距。 OpenWAM 成功率最高,为 29.1%,FastWAM 和 π0.5 分别为 26.4% 和 24.9%,DM0.5、LingBot-VLA、HY-Embodied、Motus 依次为 21.4%、19.7%、18.9%、18.1%,Spatial Forcing 为 12.4%;扩散策略为 9.7%(逐任务训练,评测协议与多任务模型不完全一致)。如果每项任务都挑表现最好的模型,成功率为 35.4%。OpenWAM 在 11 项任务上达到或超过 50%。50 项任务里有 47 项至少被某个模型成功完成过一次。如果只统计在专家 1 倍用时内完成的回合,π0.5 以 14.6% 排第一,OpenWAM 降到 8.3%,排第六。
难度随手指要做的事逐级上升。 研究按任务对手指的要求分组,把 8 个模型的回合合起来统计:只需推或拨的任务成功率 51%,开合铰链、抽屉、拉杆、盖子 43%,抓起-搬运-放下 35%;用手指扳扳机、按按钮、拧旋钮为 14%,倒水 13%,手内换握或翻转物体 11%。握着工具作用于另一个物体,4,800 回合成功 137 次(2.9%);插销、堆叠、对齐这类精密配合,4,800 回合成功 107 次(2.2%)。在控制示范数量和专家用时之后,手指驱动、手内操作、用工具、精密配合四组仍比抓起-搬运-放下低 20–25 个百分点;精密配合任务的示范数量和抓放类相当(中位数 413 对 392 条)。
进入 Transfer-16 零示范迁移任务,所有经过训练的模型成功率均不高于 0.9%,6,232 次有效试验里成功 13 次,柔性物体任务全部为零。成功率太低难以排序,论文改用「有序进度」计分,按顺序完成了多少个阶段来算。按这个口径,OpenWAM 以 12.9% 排第一,比 HY-Embodied、LingBot-VLA 和 Spatial Forcing 分别高 6.0、3.7 和 2.6 个百分点,且配对统计区间不含零;其余四个模型与它相差不超过 1.7 个百分点。即便在几乎都做不成的题上,这套评测仍能分出高下。
错在哪一步
HandsOn 给每项任务埋了阶段检测点,能看到模型在哪一步出错。8 个模型平均下来,21.4% 的回合成功,13.9% 提前结束,64.8% 超时。超时的回合大多陷入停滞:65%–83% 在超过专家用时之后再没有新的进展,手却一直在小幅来回动。论文发现,拿起物体这一步失分不多,大部分失分集中在多指双手控制的三个环节上,组合任务还多出一类。
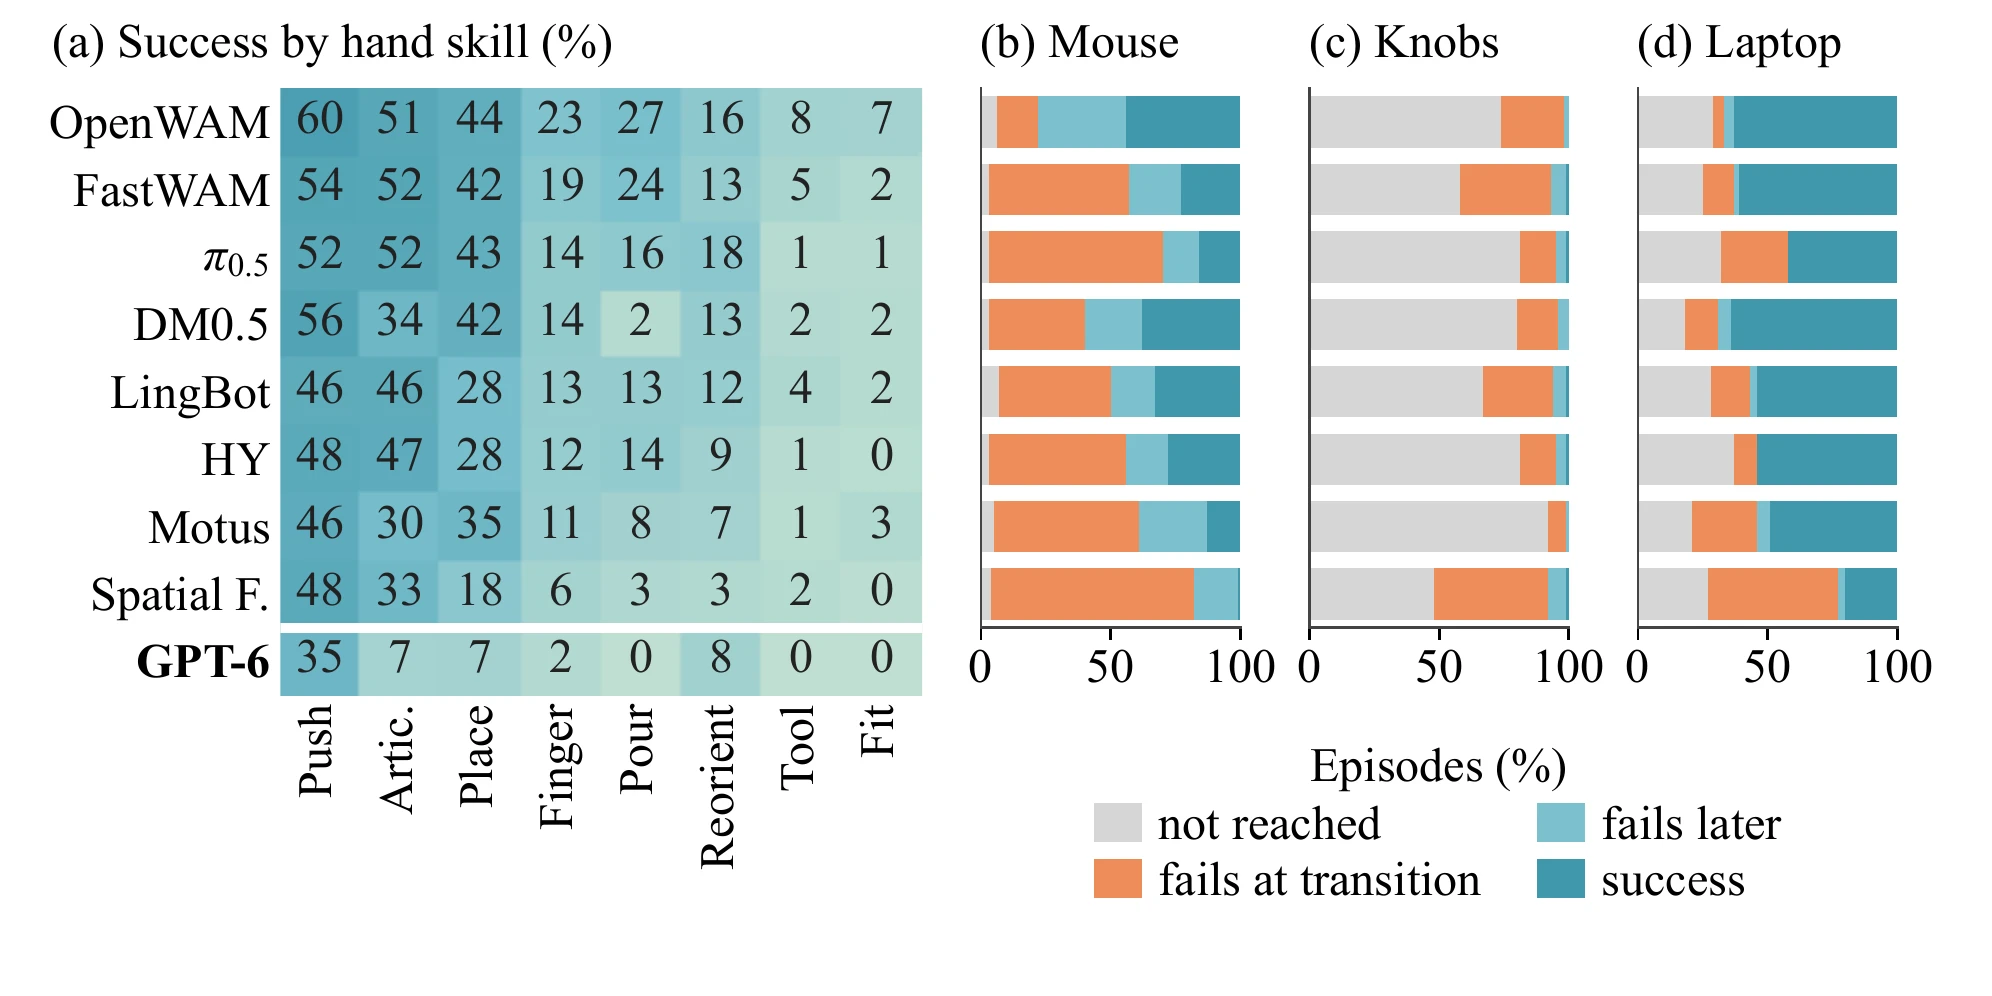
一握住就按下去了。 握工具的手指常常就搭在按键或扳机上,一合拢就可能触发功能。「点击鼠标」要求先把鼠标挪到垫子上再点,800 个回合里有 443 次因为提前点击直接结束,OpenWAM 有 16 次,Spatial Forcing 有 78 次。「给标志拍照」里,778 个回合中有 774 次第一次按快门发生在瞄准之前。
两只手各自到位,却凑不到一起。 「双旋钮」要两个旋钮同时停在目标角度。800 个回合里,左、右旋钮分别有 411 次和 416 次转到过目标,同时到位只有 38 次,最终成功 5 次。第一个旋钮到位后,在 608 个回合里有 570 次又转出了范围,其中 505 次是转过了头。
到了目标,却守不住。 「打开笔记本」要求把屏幕开到指定角度。Spatial Forcing 和 OpenWAM 把屏幕开到位的次数接近(100 回合里 73 次和 71 次),到结束时仍在位置上的分别只有 23 次和 67 次,失守的几乎都是手还压在屏幕上,把它推过了头。「传递方块」中,两只手都握住方块的 367 个回合里,接手的一方只在 188 次真正接了过去;没接住的 179 次里,方块掉了 175 次。
步骤重复或提前。 组合题「盖水壶和盒子」要求先盖水壶,400 个回合里有 340 次先动了盒盖;「放水果再拍照」399 个回合里有 311 次在水果入桶前就按了快门。
语言理解也有漏洞。论文在 314 个初始画面上做了离线测试:把指令里要拿的球换个名字,HY-Embodied 和 LingBot-VLA 分别在 57% 和 71% 的情况下仍然伸向原来那个球,DM0.5 是 10%。
加数据、换大模型,能补上吗
短板能不能靠更多数据补上?团队先用 π0.5 做了数据量实验:在两项任务上分别用 10、50、100、200 条和全部示范训练。在这两项任务上,示范越多成功率越高:「把球放进碗里」从 7% 升到 83%,「捏剪刀」从 1% 升到 44%;从 200 条到全部数据,两项任务还分别涨了 18 和 26 个百分点。
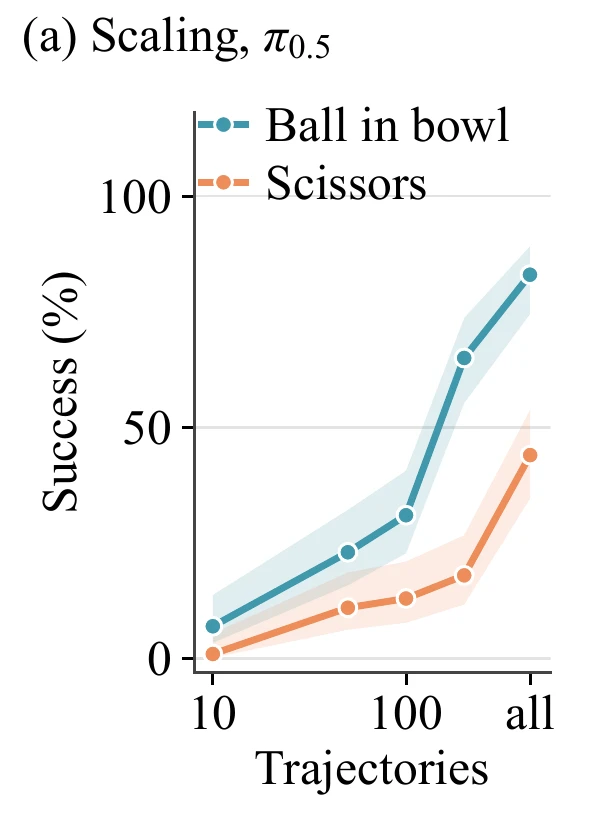
但放到全部 50 项任务中,示范数量对成功率的解释力度有限,专家完成一项任务要花多久更能预测难度。同样配了 500 条示范,精密配合类平均成功率 2.8%,抓放类 37.8%。论文强调,这两条曲线不能推出跨任务的规模规律。
团队还测试了另一条技术路线:不用 HandsOn 的数据,也不微调,让 GPT-6 看三路相机画面,直接输出手掌位姿和最多 40 个手指关节目标,一步步控制双手。它没有现成的抓取动作库、没有避障规划器,也拿不到物体位姿和触觉。
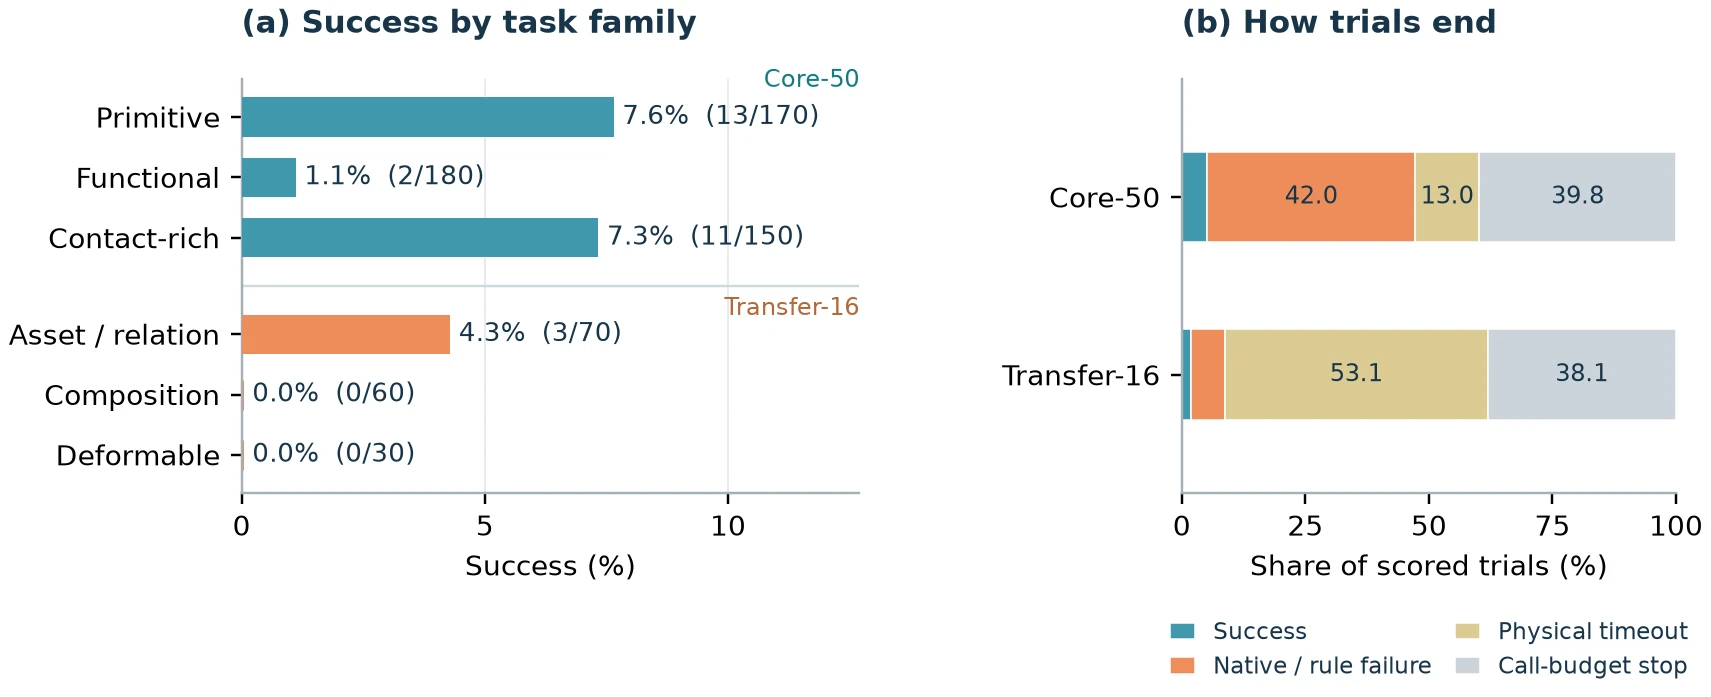
结果是 Core-50 上 500 次试验成功 26 次(5.2%),Transfer-16 上 160 次成功 3 次(1.9%)。66 项任务里有 12 项成功过,最好的是「转螺旋桨」,10 次成功 7 次。分组来看,基础操作 7.6%、功能性操作 1.1%、接触密集型操作 7.3%,后者的成绩全部来自「转螺旋桨」和「抬纸箱」两项,论文说明这不代表它会做精密配合。660 次试验里有 260 次(39.4%)因为调用次数用完而结束,150 次(22.7%)撞上物理时限。
模型输出的「操作笔记」,体现出它对任务逻辑具备一定理解。在叠毛巾任务里,它计划先小幅提起,「确认布边跟着动了,再往前做第一次对折」;在「打开笔记本再点击鼠标」这道组合题里,它提醒自己「两个物体都还没动,先别抬手、别点击」。两次都失败了。论文认为,这些笔记值得进一步研究:让大模型做高层规划,再配上物体状态估计和可复用的底层技能。但现有实验分不清失败有多少来自接口本身。
边界、同类对比与意义
先聊一聊这项研究工作的边界。
第一,全部量化结果都来自仿真。论文附录展示了真机运行视频,用来说明仿真到真机的迁移,但只是定性演示,没有给出真机成功率。
第二,平台虽然支持多种硬件,论文的全部实验只用了一种组合:珞石(ROKAE)AR5-08 机械臂(7 自由度、额定负载 5 公斤、臂展 683 毫米)加第一代舞肌(Wuji)灵巧手,每只手 20 个主动关节,物理后端都是 PhysX,不同灵巧手之间的对比还没有报告。
第三,模型只能靠视觉和自身状态判断接触,没有触觉。论文也提到,手腕相机装在手上,抓住物体后容易被遮挡。第四,GPT-6 每项任务只试 10 次,论文把它作为参照,并注明它的输入和调用预算都与训练模型不同。
作者的后续规划包括加入触觉、做更定量的物理评测、更长程的任务和更强的大模型智能体框架。
放到同类工作里看,论文的对比表把 HandsOn 和 DexJoCo、DexVerse、Bench2Dex、DexMimicGen、SPD 放在一起,并注明各家的任务目录和评测范围不同。按表中数字,HandsOn 的 18,000 条人类示范最多;DexMimicGen 只有 60 条人类示范,另用自动生成扩充到 21,000 条。任务目录上,DexVerse 的 100 项多于 HandsOn 的 66 项。HandsOn 是表中唯一报告了「只考不练」任务的基准(16 项),其余五个都未报告。测试的方法也更多:除了扩散策略,还有 5 个 VLA、3 个世界-动作模型和 GPT-6。
其他基准同样具备 HandsOn 当前没有覆盖的能力。按各自论文的标题,Bench2Dex 评测视觉加触觉的双手操作,并跨多种灵巧手;DexVerse 是模块化、多任务、多本体的基准。HandsOn 目前没有触觉,论文实验也只用了一种机械臂加灵巧手组合。真机层面,表中 DexJoCo、DexVerse、Bench2Dex 未报告真机评测,SPD 做了真实任务微调,HandsOn 只有定性视频。
AI 资讯聚合网站 AI Weekly 在摘要中评价,对押注通用灵巧机器人的人来说,这是一份清醒的成绩单。截至发稿,尚未看到同行学者或产业方对这项工作的公开评论。
这项工作的作用可以分研究和产业两头看。
对研究者,HandsOn 提供了一套可以直接拿来比较的任务、开源的示范数据和评测代码,阶段检测点能把「成功率低」拆成具体卡在哪一步,适合用来检验新方法到底改进了接触、协调还是保持目标。论文的数据也给出了方向:用工具、精密配合、双手交接和迁移到新任务,是现有方法最薄弱的环节;单纯堆示范量,未必能补上这些差距。
对灵巧手和具身模型企业,这套平台支持多种机械臂和灵巧手,后续有条件在同一套任务上比较不同硬件和模型。按论文目前的数据看,推、开合、抓放这类任务的成功率明显高于用工具和精密装配,在论文测试的条件下,「通用灵巧操作」离稳定可用还有距离。
综合这些边界和对比来看,若后续有更多团队在 HandsOn 上提交结果,并补上真机和跨硬件的定量评测,它有望成为灵巧操作领域一套常用的公共评测。