

英伟达 Jim Fan 团队新作:只拉长历史解决不了 WAM 短板,核心需靠自回归预测
Long-WAM 发现「能拿到历史」不等于「会用历史」:只有视频底座先以自回归方式学会从过去推未来,拉长上下文才能真正实现性能上涨。基于这一结论,团队将这套世界动作模型打造为可在边缘设备实时运行的系统。上下文时长从 0 秒拓展至 19.2 秒后,RoboCasa GR-1 的任务成功率从 63.3% 提升至 78.7%;真机动态叠杯任务成功率达到 95%,而对照组的 π0.5 与 Fast-WAM,二十次测试无一成功。
10 月 7 日,英伟达、麻省理工学院、香港大学与加州大学圣迭戈分校联合团队发布论文《Long-WAM: Scaling the Context of World-Action Models》。论文共有 16 位作者,黄炜和 Bohan Zhang 为共同第一作者;英伟达 GEAR 通用具身智能实验室联合负责人 Jim Fan 是这项研究的核心参与者。作为斯坦福大学李飞飞门下博士,Jim Fan 是具身智能领域代表性华人学者,主导过 VIMA、MineDojo、Voyager、Eureka 等知名项目,长期深耕通用机器人智能体与世界模型方向。麻省理工学院韩松、香港大学祁小娟也位列作者名单。
世界动作模型将视频预测接入机器人控制闭环,让视觉历史成为动作决策的天然信息来源。但读取更长历史会拖慢响应速度,这就引出核心问题:机器人控制能把视觉上下文拉长到什么限度,又该如何在实时约束下保住性能收益。近年研究大多依靠因果缓存、记忆模块留存历史,而该团队看到了更深层的关键:「能拿到历史」,和「学会从历史里预测」,是两件完全不同的事。现有方案要么将双向预训练视频生成器改造为因果视频动作预测,要么联合预训练因果视频与习得的潜动作;Long-WAM 开辟了第三条路线:先单独完成自回归视频预测的学习,再把它对接至动作模块,同时完整保留「历史到未来」的时序先后结构。
01 让模型学会用历史
Long-WAM 的研究起点来自一组对照实验。团队将三种视频底座接入同一套世界动作模型,在 RoboCasa GR-1 平台上将上下文窗口从 0 秒逐步拉长至 19.2 秒:双向预训练底座增加历史几乎没有净收益,性能从 2.4 秒时 61.7% 小幅升至 9.6 秒时 64.1%,到 19.2 秒又回落至 61.6%;而两款自回归底座的成功率持续上涨。其中面向机器人领域预训练的底座,上下文从 0 秒拓展至 19.2 秒,任务成功率由 63.3% 提升至 78.7%。它相对双向底座的性能优势,也从无历史条件下的 3.3 个百分点,扩大到 19.2 秒时的 17.1 个百分点。能拿到更长的历史,和学会从历史里预测,是两件事;只有先把「拿过去推未来」学进底座,多出来的历史才换得成分数。
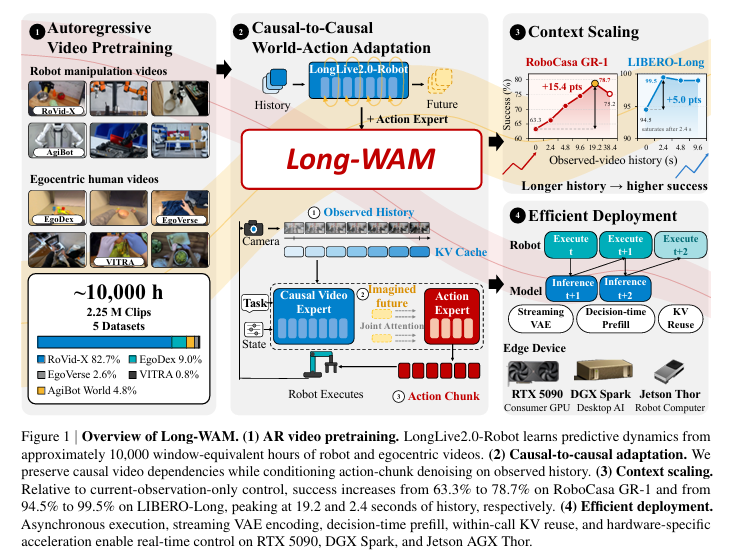
这一底座名为 LongLive2.0-Robot。团队在现成 16 秒自回归视频模型基础上继续训练,训练数据为约一万窗口当量的机器人视频与第一视角视频,数据源包含 RoVid-X、AgiBot World、EgoDex、EgoVerse、VITRA 五套数据集。训练仅采用视频作为监督信号,不依赖动作标签,因此模型可以兼容多种机器人本体的数据,无需统一动作空间。预训练针对最长 30 秒序列开展,采用块因果注意力机制;每个带噪区块都由真值前缀提供监督,条件图像保持干净,不参与损失计算。
对接动作模块的核心,是保留预训练习得的因果时序。视频、动作两条支路通过非对称接口耦合:视频查询仅读取自身以及更早的视觉区块,不会读取动作信息;动作查询既能读取观测历史,也能读取部分去噪后的未来信息,再读取完整带噪动作区块。如此一来,「历史到未来」的时序关系在预训练阶段就已经习得,而不是接入动作模块后临时构建。输出动作时,视频支路先预测后续若干潜变量至指定噪声水平,将对应的键值缓存提供给动作专家复用。这套「先预测、后出动作」的范式,团队将其命名为逆动力学建模。
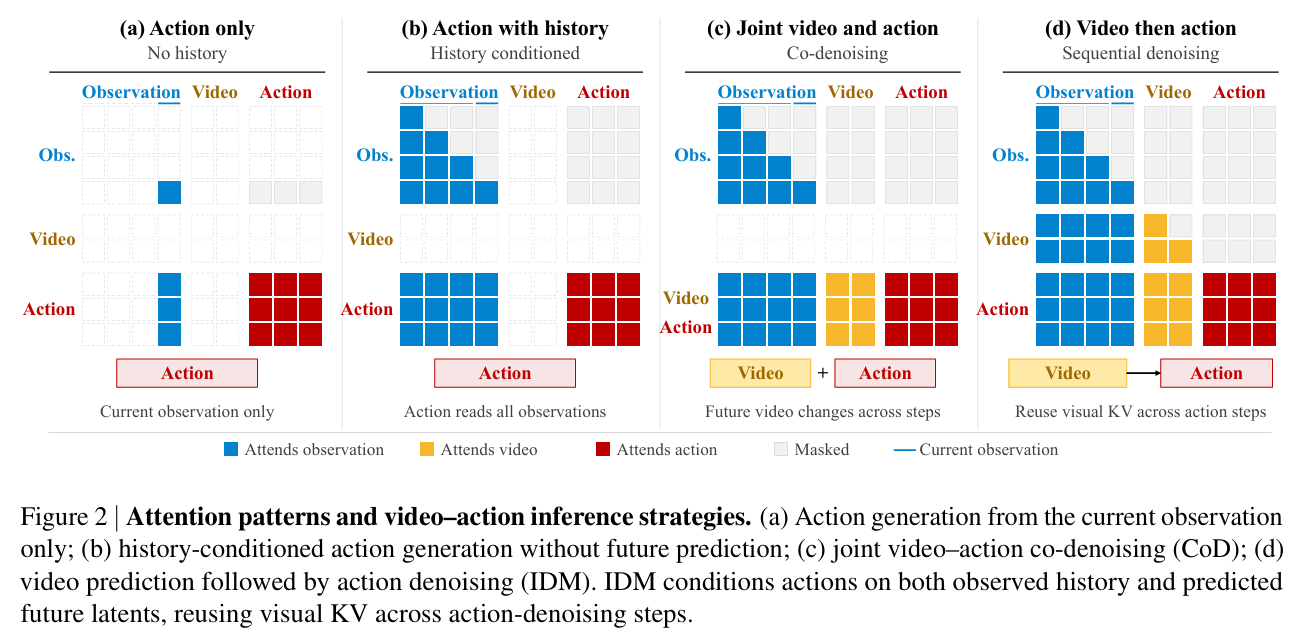
有一个细节值得单独强调:推理阶段,视频支路不会将未来潜变量解码成像素画面,只保留在中间噪声层级,把缓存供给动作模块做去噪。在这里,预测不再是生成完整视频的任务,而是服务于机器人控制的中间表征。消融实验也佐证该设计的价值:采用先预测未来再输出动作的方案,在 LIBERO-Long 任务上达到 99.5% 成功率;联合去噪方案为 97.8%;不预测未来的基线版本仅 94.5%。
放在整个技术路线谱系中观察,思路会更加清晰。现有方案分为两类:一类改造双向预训练视频生成器,将其转为因果视频动作预测;另一类联合预训练因果视频与习得的潜动作。Long-WAM 走出第三条路线:先独立完成自回归视频预测的学习,再接入动作模块,并且在对接全过程保留原生因果结构。团队解释,自回归预训练已经把「从历史推到未来」的能力嵌入表征,接入动作时不破坏这套机制,新增的历史信息就能顺着这条通路流入控制流程;而双向初始化模型没有习得该时序逻辑,存入再多历史数据,也无法有效利用。
预训练与动作对接拆分为两个独立阶段。前一阶段只学习画面运动规律;后一阶段接入动作模块,采用两轮交替训练:首先基于干净历史做视频流匹配,再基于历史与加噪的真值未来做动作流匹配。第二步会切断视觉缓存,动作损失仅更新动作专家与本体适配器。这种拆分设计的优势在于,动作学习不会反向干扰预训练阶段已经学好的因果预测能力。
02 把长上下文塞进实时控制
长历史一旦能够产生价值,下一道难题就是高效计算。预训练阶段共消耗约 30720 GPU 小时,在 64 张 H100 显卡上完成;下游世界动作模型使用 16 张 GB200 训练,优化器选用 AdamW,峰值学习率设为 1e-4,采用余弦衰减、5% 学习率预热,精度为 BF16。团队将上下文长度与响应时间放在同一维度考量:更长的前缀会同步拉高预填充、注意力计算与缓存开销。因此上下文被视作一项需要消耗的执行资源,而非单纯追求越长越好。
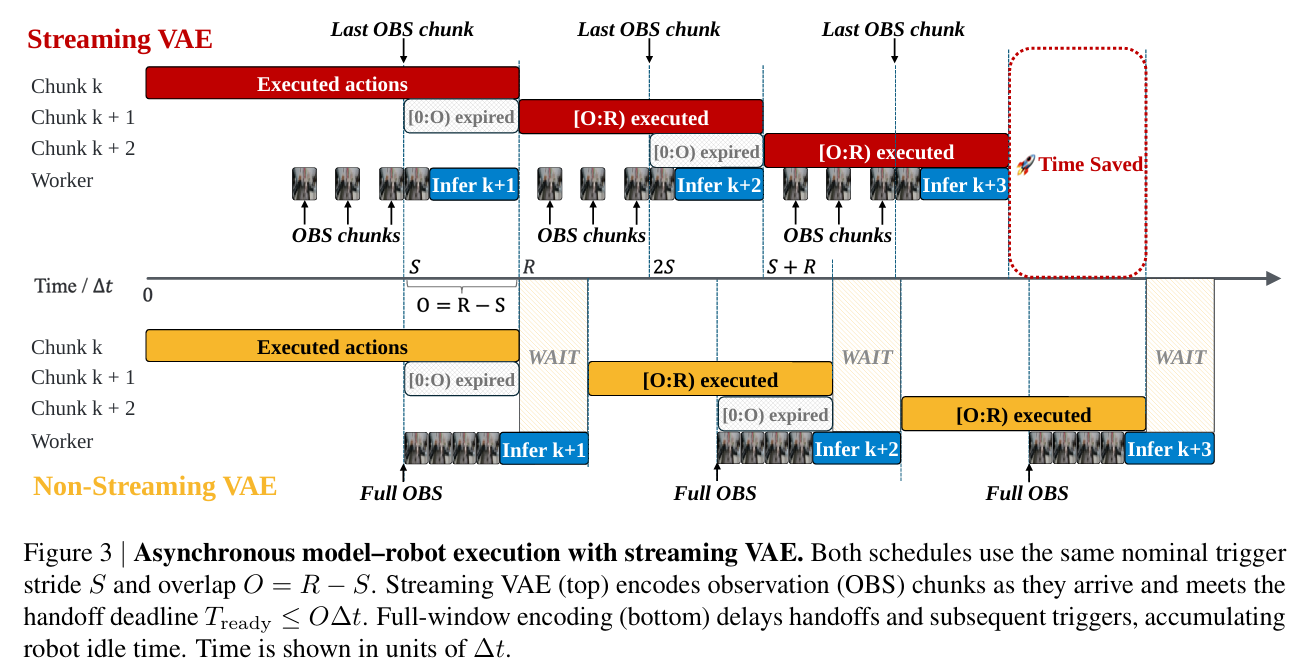
在实时推理端,团队采用推理与机器人执行重叠运行的方案。控制步骤按固定周期触发,推理、执行两条流程并行推进;模块交接时丢弃已经过期的前缀,执行经过新块对齐后的后缀,出现延迟则等待同步。这种纯异步机制原本容易破坏动作连续性,常规解法要么在推理阶段增加引导约束,要么在训练时增加动作条件。而团队发现,只要模型依托时序连续的视频预测作为条件,相邻区块在重叠区间的输出会自然趋于一致,仅靠纯异步机制就可以稳定运行。在 RoboTwin 2.0 测试中,Long-WAM 从同步模式切换为异步模式后性能几乎没有衰减;作为对照,Fast-WAM 下降 15.4 个百分点,LingBot-VA 下降 45.5 个百分点。
另一处提速设计在图像编码环节。流式因果 VAE 在画面逐帧抵达时就启动编码,将前缀观测的编码工作放在推理触发前完成,推理启动后只需处理剩余帧。与之对比,整窗编码需要持续等待完整窗口,不断累积机器人的空闲耗时。将上下文视作可消耗资源,搭配异步执行、流式编码协同设计,是长历史能够落地于实时控制的前提。
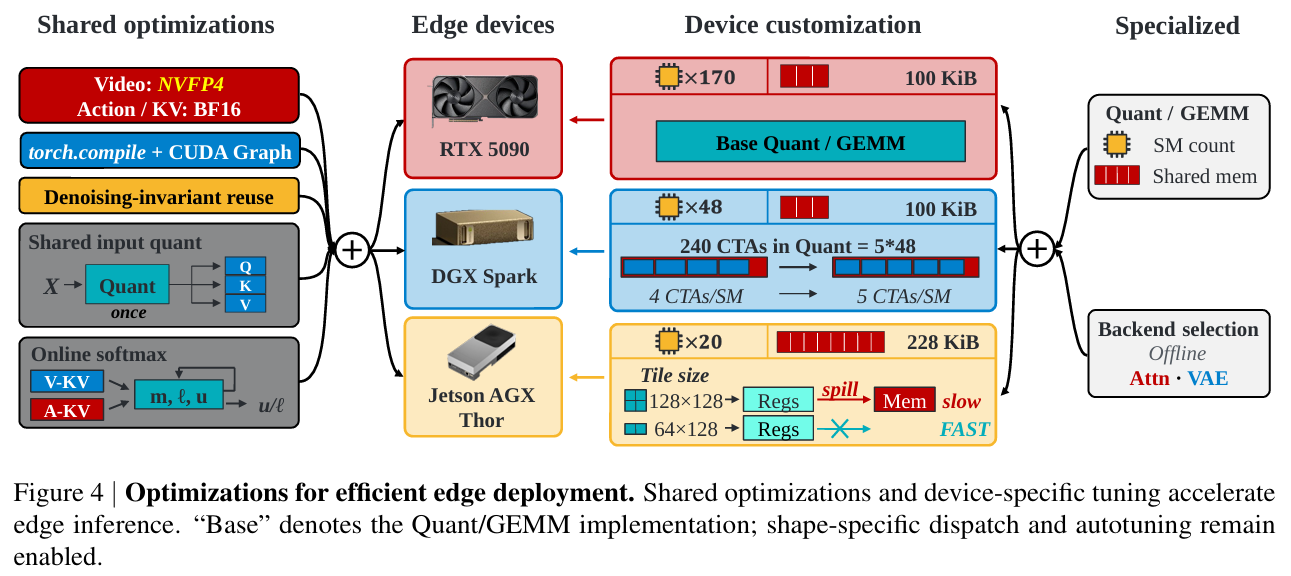
针对边缘设备,团队采用全局共享优化 + 设备专属调优的方案。视频专家的线性层,在生成与键值预填充环节采用 NVFP4 四位权重与激活量化;动作分支维持 BF16 精度 —— 动作模块量化带来的加速收益有限,还容易损害控制精度。NVFP4 搭配 CUDA Graph 重放与编译技术,可以压低量化内核的启动开销。多重优化叠加后,在 RTX 5090、DGX Spark、Jetson AGX Thor 三款硬件上,运行速度相比原生 BF16 实现 3.2 至 4.1 倍提升。包含未来视频潜变量预测在内,单个动作块耗时 107.4 毫秒,对应 4 步去噪、单专家架构,完整观测的 VAE 编码也计入其中。代价是上下文拉长会推高计算成本:当历史长度扩大 8 倍,RTX 5090 上的延迟上升至 341.0 毫秒。
03 上下文并非越长越好
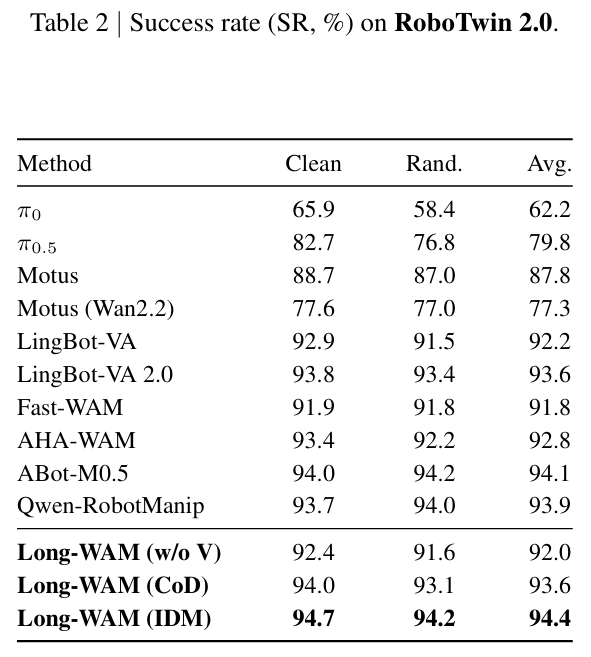
先看几组标准基准,主实验采用 2.4 秒上下文。在 LIBERO 数据集上,这套「先预测未来再出动作」的方案平均任务成功率达 99.5%;在长任务子集 LIBERO-Long 上同样取得 99.5%,较 LingBot-VA 高出 1.0 个百分点,较 Fast-WAM 高出 4.3 个百分点。在 RoboTwin 2.0 上平均成功率 94.4%:干净条件下为 94.7%,随机化条件下为 94.2%,与当前最优的几个模型处于同一梯队,且小幅领先。DOMINO 数据集引入动态移动物体,模型在动态数据微调后,取得 34.9% 的任务成功率与 45.1 的操作用分;相比最强基线 Fast-WAM,成功率高出 15 个百分点,相比 PUMA,操作用分高出 10.1。
团队在 GR-1 平台针对上下文变量做了最详尽的测试,该平台的每项任务都包含多次物体转移操作。当上下文从 2.4 秒拉长至 19.2 秒,任务成功率从 66.3% 提升至 78.7%,相比 GR-1 上性能最强的基线 Cosmos Policy(67.1%)高出 11.6 个百分点。LIBERO-Long 则呈现不同规律:仅增加 2.4 秒历史,成功率就从 94.5% 跃升至 99.5%,继续拉长上下文,性能增益便趋于有限。上下文能带来多大提升,由任务本身决定;短历史足以应对的任务,无需强行拉长窗口,只有多阶段接续任务,才需要更长记忆。
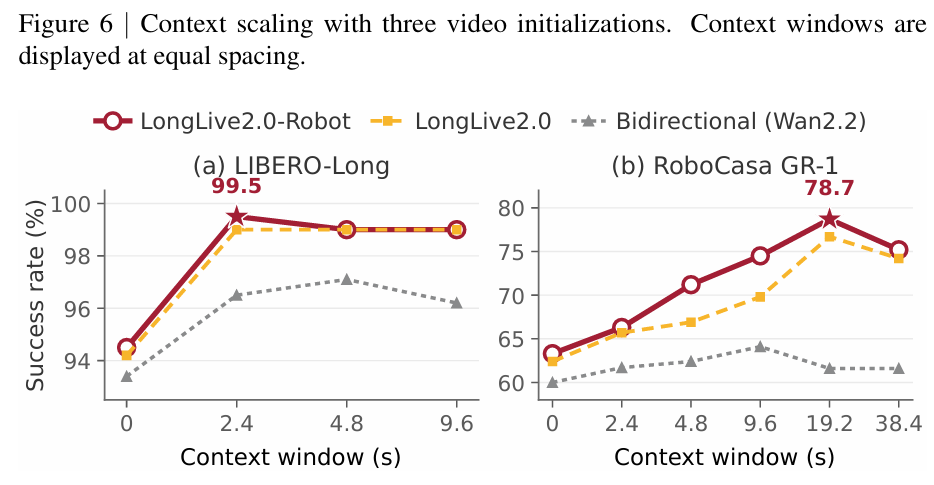
性能并非随上下文无限上涨。当上下文拉至 38.4 秒,成功率反而回落至 75.2%、74.2%。这个窗口长度达到训练轨迹平均长度 12.1 秒的三倍,其中 80.4% 的历史帧属于填充补齐内容。团队判断,性能回落的根源是真实历史样本覆盖不足,而非记忆能力本身抵达上限。消融实验还验证:「先预测未来再出动作」的方案,表现优于联合去噪、不预测未来的基线,长任务场景下差距最为突出。这说明预先估算交互演化走向,能够帮助后续一连串子动作相互对齐。
04 真机验证:接住传送带上的杯子
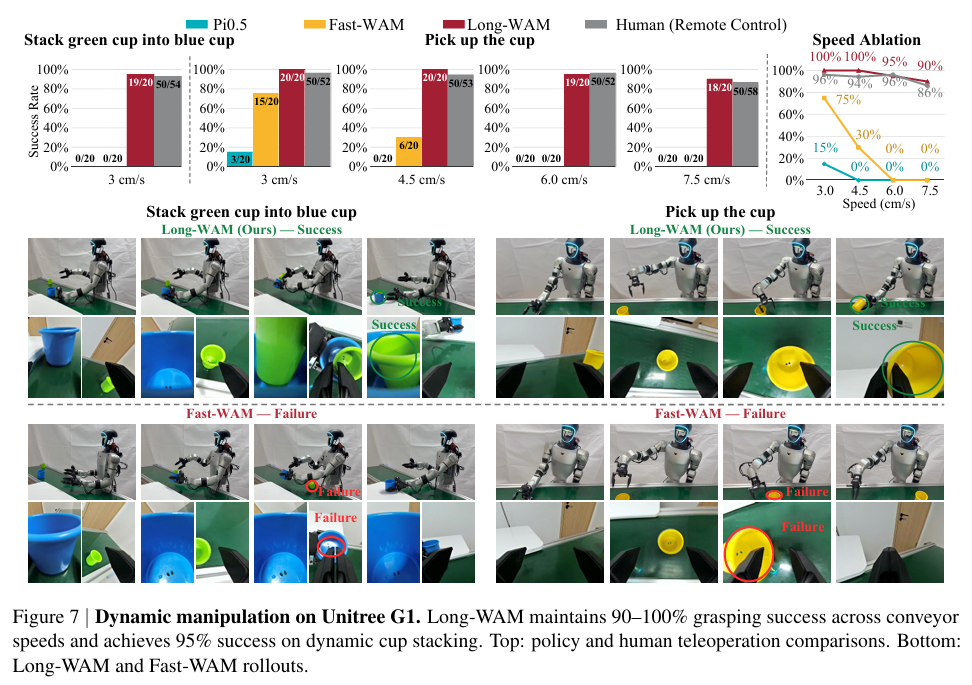
真机验证环节,团队采用宇树 G1 与 YAM 双臂操作平台,测试八种模型配置,任务覆盖传送带抓取杯子、长时序家务类操作。动态任务最能拉开模型性能差距。传送带移动速度从 3 厘米 / 秒提升至 7.5 厘米 / 秒,Fast-WAM 抓取成功率从 75% 跌至 0%,π0.5 由 15% 降至 0%;Long-WAM 始终稳定维持在 90%~100%,四个速度档位的成功率依次为 100%、100%、95%、90%。在传送带上完成将绿色杯子叠入蓝色杯子的动态任务,Long-WAM 二十次测试成功 19 次,另外两组基线模型一次都未能完成。能够接住高速移动物体,核心在于模型提前推演后续多步的交互状态。
长历史能力在长时序任务中同样具备价值。YAM 平台上三项任务的单次时长平均超过 40 秒;Long-WAM 完成按颜色分拣积木、将饺子放入平底锅、叠碗的成功率分别达到 80%、80%、85%,平均 81.7%。评测场景由此从「快速拦截」拓展至「持续执行」。
该模型还可以作为高层规划模块的底层执行器。团队在 RoboCasa365 上设置五十项任务,划分为见过的原子任务、见过的组合任务、未见过的组合任务三类,将 Long-WAM 与高层规划器 GPT-6 Astra 进行串联。Long-WAM 独立运行时,已见过的原子任务成功率 67.9%,两类组合任务仅为 15.8% 与 6.1%;接入规划器后,三类任务指标分别提升至 85.6%、38.8%、35.0%,整体均值由 31.4% 上涨至 54.4%。同一规划器搭配 π0.5,整体仅 30.5%,π0.5 独立运行则为 25.2%。规划器为 Long-WAM 带来的性能增益远高于 π0.5,这说明底层执行能力越强,上层规划的策略就越容易落地。低层控制器负责管理短时间尺度的物理交互历史,小时级目标、逻辑推理与任务拆解交给上层规划器,二者形成互补;记忆窗口的长度,也应当由任务需求与算力共同决定。