

Jim Fan 喊出「凛冬将至」,机器人公司还要自研大脑吗?
作者:熊有笛
「我从没见过人类历史上有这样一个东西,能打碎这么多梦想。」
美国当地时间 11 月 9 日,在 CoRL 2026 机器人学习大会上,NVIDIA GEAR 研究团队负责人 Jim Fan 用这样一段玩笑开启演讲。
他用「悲伤的五个阶段」描述同行面对 GPT-6 Astra 时的心情:否认、愤怒、讨价还价、抑郁,最后接受现实。到了第五阶段,他给出的结论是:「凛冬将至。」
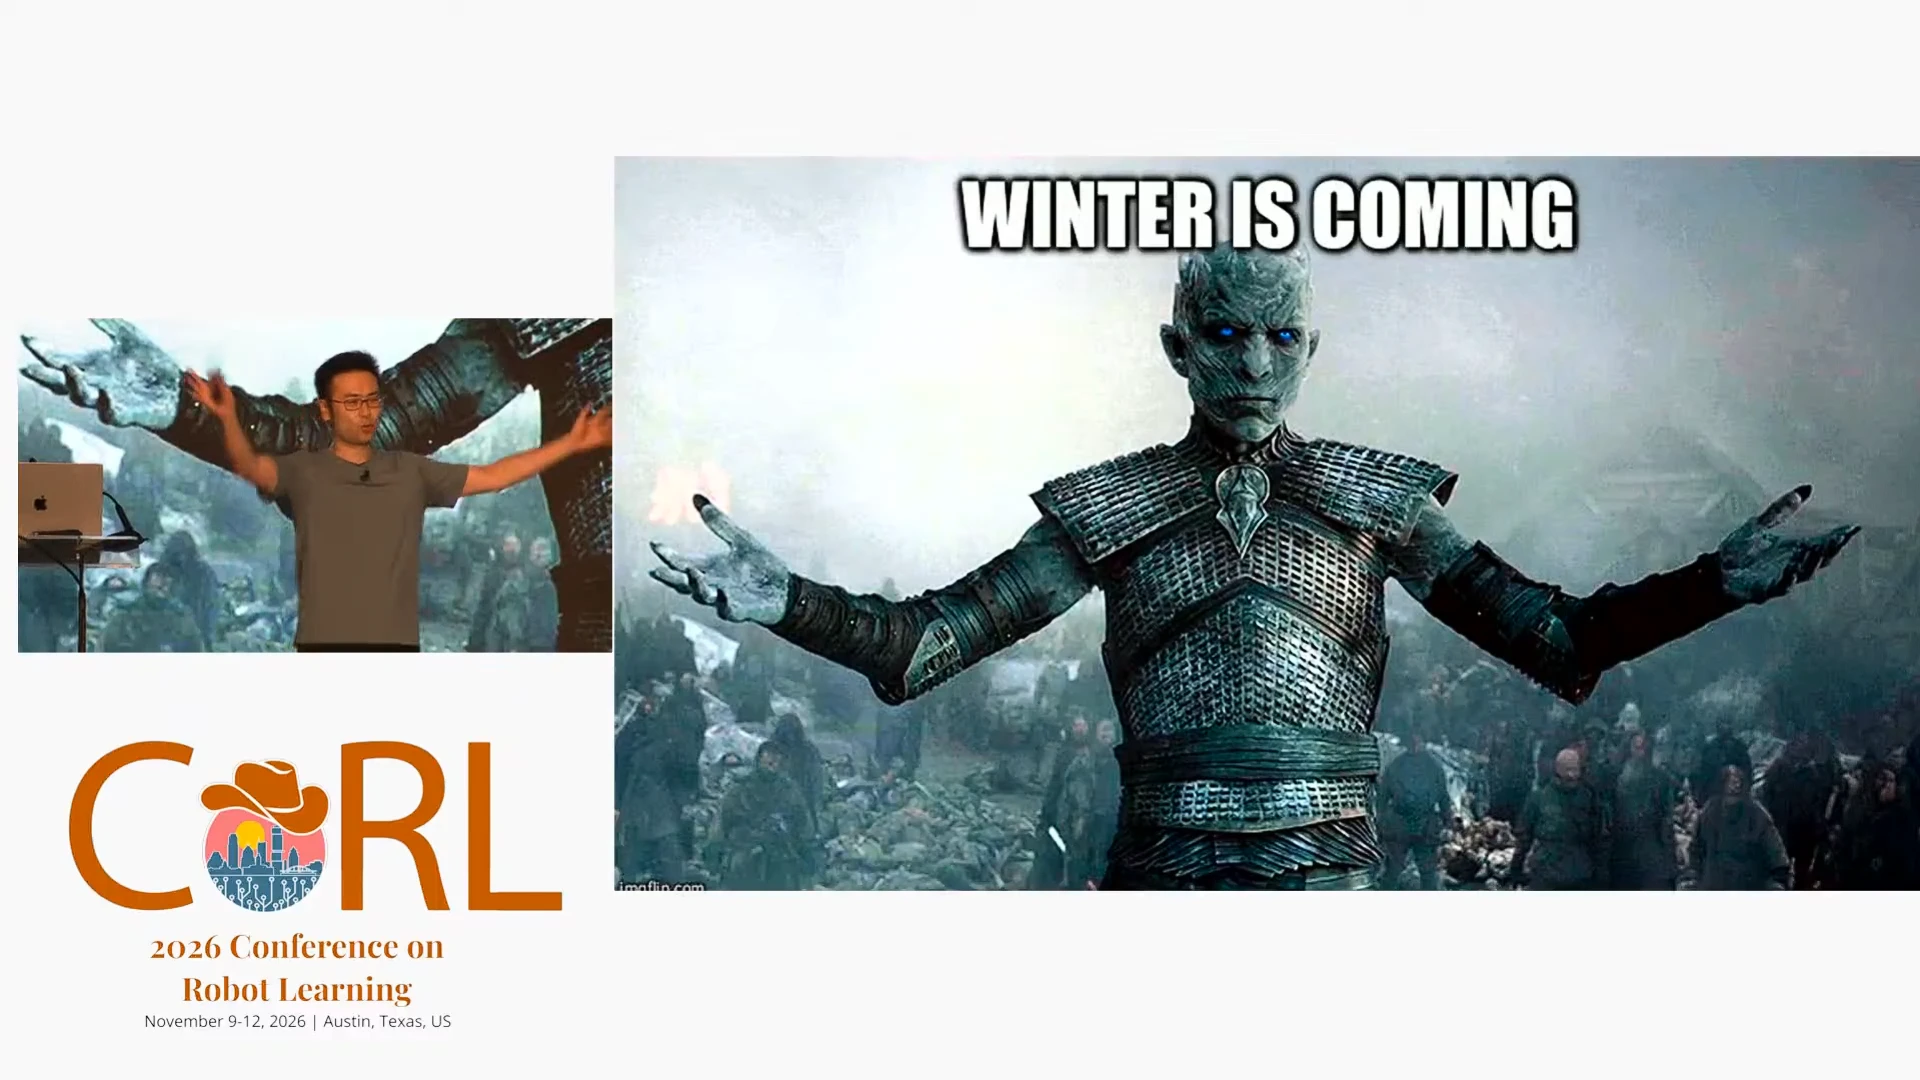
玩笑背后是个绕不开的产业问题:当通用推理模型已经能够理解场景、自主规划、编写程序,甚至调用工具控制机器人,专门负责实时动作的机器人基础模型,还有多少存在的必要?
Jim Fan 没有沿着这个问题继续争论。「一切都将成为技能,包括 System 1。」在他看来,真正的问题是,什么才算一项好的技能?能否通过示范轻松教会它,又能否通过推理轻松引导它?
GR00T 2 正是沿着这两个方向发展:一方面,让机器人能够从人类和其他设备的示范中学习操作;另一方面,让上层推理模型通过接口调用、引导和修正这些操作。
NVIDIA 将这种协作方式称为「统一认知」(Unified Cognition):让负责推理的模型与负责物理执行的模型分工,再通过接口进行调用、引导和纠错。
在同一场演讲中,NVIDIA 还宣布将逐步开放 GR00T 2 模型、数据集、仿真工具、智能体框架,甚至数据采集硬件的设计图纸。
这些进展共同指向一个变化:过去需要机器人公司分别研发、再与自身硬件深度绑定的部分智能能力,正在变成可以从外部获得、在不同设备上适配,并通过软件持续积累的能力。
当机器人大脑开始可以被拆分、调用和复用,机器人公司还有多大必要从零训练一套完整的智能系统?
机器人大脑,不需要包办一切
对机器人来说,理解任务和执行动作是两种不同的工作。
垃圾分类、汉诺塔需要语义理解和逻辑规划;剥离标签底纸、将内存条插进插槽,则需要持续的视觉反馈和低延迟动作控制。
一个模型同时承担两类任务,往往顾此失彼。Jim Fan 认为,让一个 20 亿参数的动作模型自己去写递归代码,完全没有必要。
NVIDIA 选择把这两件事交给不同的模型,再用接口连起来。
今年 4 月,Jim Fan 曾在红杉 AI Ascent 大会上,半开玩笑地为 VLA 范式「默哀」,转而强调世界动作模型的潜力。
他的判断是,单纯依赖视觉语言模型获得的表征,再学习如何输出动作,不一定是机器人理解物理交互的最佳路径。模型还应该通过预测未来世界的变化,学习动作与环境之间的关系。当时,NVIDIA 展示了 DreamZero 等世界动作模型研究。半年多后发布的 GR00T 2,进一步发展了这条路线。
与许多主要学习观测到动作映射的 VLA 不同,GR00T 2 在同一个扩散 Transformer 里,同时预测未来的视频画面和机器人动作。Jim Fan 将这一过程形容为机器人「做梦」。这种设计让机器人不仅学习某个动作应该如何执行,也学习动作会对物体和环境产生什么影响。对需要精细操作的机器人而言,后者尤其重要。
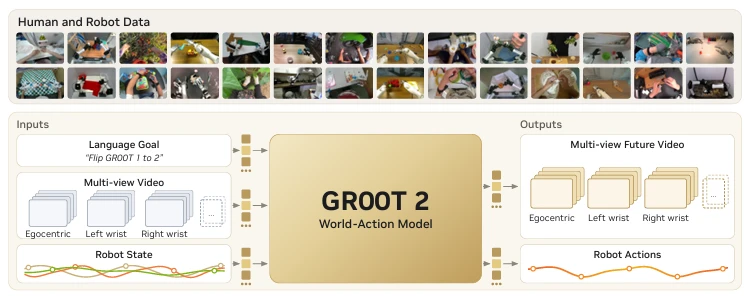
在此基础上,NVIDIA 又引入 WAM API,让上层推理模型能够把 GR00T 2 当作操作工具使用。
例如,在垃圾分类任务中,Astra 负责判断物品类别,直接在相机画面里标出抓取点和放置点;GR00T 2 照着标记完成动作。这项机制被称为 Visual Steering(视觉引导)。
在 YAM 机器人的一组目标选择与放置测试中,仅提供任务指令时,GR00T 2 的成功率为 40%;增加上层规划生成的步骤指令后,提高到 66%;再加入视觉标记,成功率达到 92%。
而且,视觉标记可以从已有示范中的手部和夹爪状态提取,不需要为这种交互方式额外采集新的示范数据。
NVIDIA 还展示了另一种交互机制 WAM Edit。Astra 持续观察画面和机器人本体状态,只在必要时对动作施加增量修正,其余时间 GR00T 2 照常执行。
在化学实验的演示中,Astra 根据任务要求判断操作是否应该继续,并通过显微镜画面指导机器人调整旋钮,直到完成对焦。
两种机制背后是同一个思路:上层推理模型负责决定做什么、判断做得对不对;机器人动作模型则负责解决具体应该怎么做。
在更底层,NVIDIA 还需要解决机器人实时执行的问题。为此,它推出了 GR00T 2 Turbo。这个采用 20 亿参数联合视频—动作 Transformer 的轻量版本,通过压缩视频表示、缩小模型和优化推理,让世界动作模型可以直接运行在机器人本体上。
在 Unitree G1 上,Turbo 模型以 124 毫秒的单次延迟在 Jetson Thor 上运行,每秒输出一段约 1.6 秒的全身动作规划;这些规划再由 Jetson Orin 上的 SONIC 控制器以 50 Hz 的频率分解为底层关节指令。
由此,整套系统形成了三个不同的时间尺度:Astra 负责相对耗时的任务理解与规划,GR00T 2 负责生成动作片段,SONIC 负责将其转化为连续的关节控制。推理、动作预测、运动控制,各干各的。
类似的分层设计也出现在其他公司的产品中。
今年 1 月,Figure 发布的 Helix 02 同样采用 System 2、System 1、System 0 的分层结构,将语义推理、视觉运动策略和全身控制连接起来。区别在于,Figure 更强调自有本体、传感器和模型之间的深度协同;NVIDIA 则进一步将不同层级之间的协作做成开发接口,让上层智能体能够调用、引导和修正操作模型,并与外部代码技能配合执行。
但 NVIDIA 并没有否定端到端学习。GR00T 2 内部仍然联合学习视觉变化与动作,只是在完整机器人系统层面,把不同性质、不同时间尺度的工作交给不同模块。
如果机器人大脑可以拆分,操作技能能否进一步摆脱特定硬件的限制?
学习新技能,不必每次都从零开始
长期以来,机器人训练数据与采集设备和目标硬件紧密绑定。一套机械臂的遥操作数据,记录着特定关节、夹爪和控制系统的状态。换成另一种夹爪或不同结构的灵巧手,数据未必能够直接使用。即使任务相同,不同机器人也可能需要额外采集示范、重新标定和训练。
GR00T 2 提出的 X-Adapt(Cross-Adaptation,跨域适配),希望降低这类重复成本。
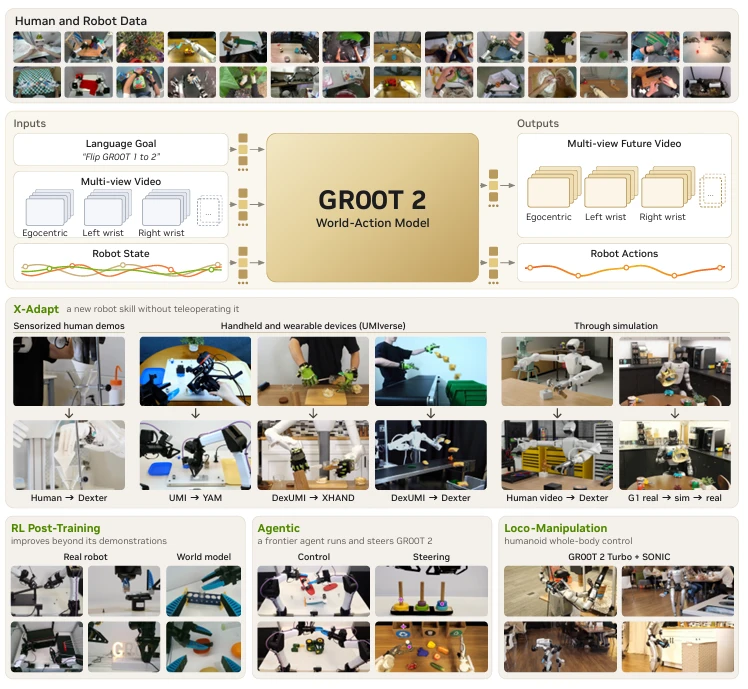
它的思路是,先在更容易采集数据的设备上学习操作,再把技能迁移到目标机器人。这样不必针对每项新任务都重新采集大量专用示范。
例如,人类使用 UMI 手持夹爪完成玩具自卸卡车的装配示范,NVIDIA 仅用这些 UMI 任务示范微调模型,再让采用不同夹爪的 YAM 机械臂执行整套装配。
在官方测试中,这项最长约 4 分钟的任务取得了 60% 的成功率。
另一个实验中,人类佩戴相机和动作捕捉手套完成化学实验操作,机器人由此学会放置、润湿滤纸等任务,而不需要采集这些任务的目标机器人遥操作示范。
NVIDIA 还开发了 DexUMI 外骨骼设备,通过与目标灵巧手相匹配的关节结构,采集更加精细的人手动作。
这些实验证明,学习一项任务所需的数据,不一定全部来自最终执行任务的机器人。
这种迁移能力与 GR00T 2 的大规模预训练有关。NVIDIA 披露,其预训练数据包含 402,730 小时人类第一视角视频、10,184 小时 UMI 手持设备示范,以及 23,500 小时机器人遥操作数据。按照原始时长计算,人类视频占比超过九成。它们提供了大量不同任务、物体和场景中的交互经验;UMI 和机器人数据则补充了更明确的操作信息,以及不同本体的动作经验。在一组消融实验中,随着模型使用的人类视频增加,真实机器人在 72 项下游任务上的平均完成进度从 50% 提高到 70%。
最能体现差异的,是面对新任务的时候。NVIDIA 选取了 50 项目标机器人没有专门训练过、但在人类视频或其他机器人数据中出现过的任务。未经任务专属微调时,GR00T 2 的零样本平均成功率为 40%;每项任务提供一次目标机器人示范并完成 LoRA 微调后,提高到 71%;提供五次示范后,达到 95%。其中,每项任务的五次示范合计不足 3 分钟,在单张 RTX 5090 上完成一次微调约需 30 分钟。
这组实验说明,前期获得的通用能力可以被反复利用,从而减少新增任务所需的专属示范。对于不断进入新工位、适配新任务的机器人公司,这有可能减少重复采集和训练的工作量。
不过,掌握任务流程距离稳定完成高精度操作还远。GR00T 2 的少样本实验中,许多失败并非模型不理解任务,而是具体执行步骤的精度不足。例如,模型知道应该把插头放入插座,也能正确组织操作顺序,但最后几毫米的插入动作,仍然可能因为位置、姿态和接触误差而失败。
NVIDIA 因此又引入了真实机器人强化学习。
在三项接触密集型任务中,经过真实机器人强化学习后,策略成功率从监督后训练阶段的 40%–76%,提高到 88%–96%。在另一组包含 Agent 任务编排与恢复机制的连续操作实验中,将监督训练的操作策略替换为强化学习优化后的 GR00T 2,使连续插入五个充电器的整轮成功次数从 2/20 提高到 20/20。
可见,通用机器人模型的边界也很清晰:预训练可以提供广泛的操作知识,少量示范可以帮助模型适应任务,但真实物理接触中的精度问题,仍然需要针对性的训练与反馈。
仿真则成为减少这部分试错成本的另一种工具。
NVIDIA 的实验显示,在保持真实训练数据不变、额外加入仿真数据后,GR00T 2 Turbo 在一组分布外真实机器人任务上的成功率从 6.7% 提高到 63.3%。
与此同时,NVIDIA 利用 SimFoundry 等工具重建真实任务的仿真环境。在覆盖 25 项 YAM 任务、14 个 GR00T 2 策略的对照评测中,仿真与真实机器人任务成功率的 Pearson 相关系数达到 0.92。
研究人员据此可以在仿真中提前筛选数据处理方法和模型推理配置,再决定哪些方案值得投入真实机器人测试。
由此,机器人学习新任务的流程可能逐渐从「针对每项任务采集大量专属数据」,转向「通用预训练、少量适配、仿真验证、真实交互修正」。
当机器人开始自己编写和修复技能
学会单个动作,只是一整套工作流程的一角。在真实工位中,机器人不仅需要知道如何抓取、放置和装配,还需要处理执行过程中的各种异常。
例如,装配任务中一个零件掉落,后续流程应该怎样继续?抓取位置发生偏移,机器人是否需要重新定位?如果前一步装反了零件,系统能否发现,并在不重新开始整个任务的情况下完成恢复?
这些问题,过去依赖工程师的经验和专用程序处理。NVIDIA 通过 ASPIRE 让智能体承担其中一部分工作。
ASPIRE 智能体框架采用代码即策略的方法,让推理模型能够自主编写、测试和修复机器人控制程序。
整个过程包含三个环节:首先,系统记录机器人执行时的视觉信息、动作轨迹、抓取候选和碰撞反馈,让智能体定位失败原因。随后,智能体修改控制程序,或者生成不同的解决方案,通过多轮测试和并行探索筛选可行结果。最后,将经过验证的程序和修复方法保存到持续扩充的技能库中,供后续任务调用。
在 Jim Fan 演示的玩具装配系统中,GR00T 2 负责大部分需要物理交互的动作,上层 Agent 负责观察进度,并在出现错误时调用通过 ASPIRE 学到的恢复技能。
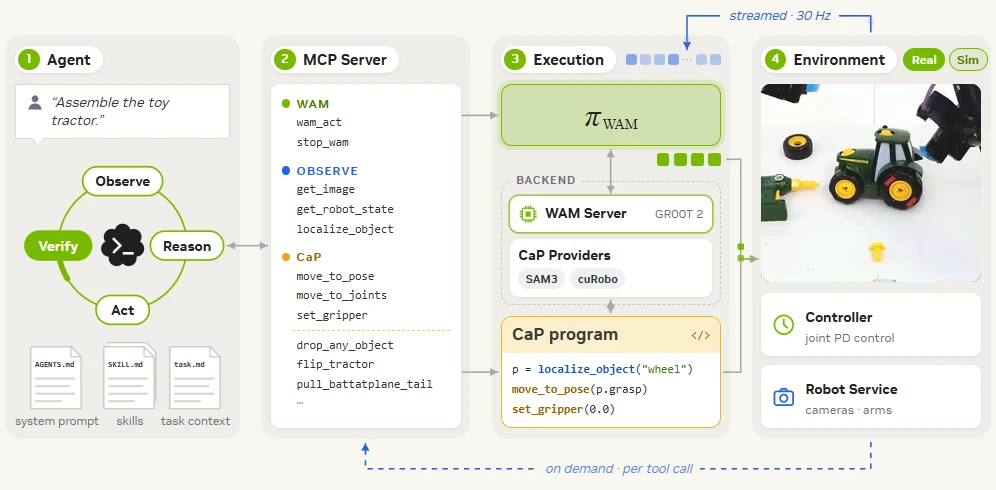
每次装配测试开始前,研究者都会重新将零件倒在桌面上,以改变初始布局。上层智能体需要根据当前场景组织任务,在机器人掉落零件或执行受阻时进行恢复。
NVIDIA 披露,在三类玩具装配实验中,引入智能体后,飞机、拖拉机和汽车各完成 100 次测试,分别成功 98、97 和 97 次。不使用上层智能体、仅依赖后训练动作策略时,三类任务的成功率为 71%–84%。
这个结果说明,长任务可靠性不仅取决于动作模型本身,也取决于系统能否检查任务进度、发现失败并恢复执行。
ASPIRE 的独立研究还显示,随着技能库积累,在其测试的一组未见过的长时程任务中,系统零样本成功率达到 31%,高于对照方法的 4%。而当仿真中获得的技能被迁移到不同结构的真实机器人上时,智能体生成和调试可用程序所消耗的 token 也有所减少。
这意味着,机器人开发中原本分散在工程师经验、专用程序和现场调试过程里的部分知识,有机会被转换成可积累、可复用的软件资产。
不过,ASPIRE 的研究团队承认,真实机器人要实现完全自主的持续学习,仍需要可靠的成功检测、安全重置、设备标定和安全监控,自动调试也会消耗大量模型调用和仿真资源。实验室里修好一个装配错误,和客户工厂里保证设备长期稳定,不是同一个问题。
当基础模型能够通过少量示范适配新任务,Agent 又能够辅助编写、调试和组合操作技能,部分重复开发工作就有机会自动化。
对于已经拥有长期部署设备的公司,真实运行中积累的失败案例、工艺约束和维护经验,可能成为它们区别于通用基础模型供应商的重要资源。而对于缺少自研基础模型能力的公司,外部模型和自动化编程工具则可能降低进入复杂操作场景的门槛。
这也是 ASPIRE 留下的产业问题:当机器人操作能力开始软件化,谁来提供、管理和持续改进这些技能?
NVIDIA 要做机器人开发的基础平台
把同场宣布的其他技术放在一起,NVIDIA 的目标显然不止一个模型。
除了计划于 12 月开放的 GR00T 2 和 Turbo 模型权重,NVIDIA 已经发布或开放的项目还包括:将真实视频转换为可交互仿真环境的 SimFoundry、用于代码技能开发和积累的 ASPIRE,以及用于视频标注、任务评价和奖励建模的 Flora。
NVIDIA 还开放了 Human-1M 数据集的首批 100,000 小时人类视频,采用 CC BY 4.0 许可,允许在满足署名等条件下用于商业用途;GEAR 团队也公开了 UMI、DexUMI 等数据采集设备的机械、电气设计及制作文档,部分配套资源仍在完善。
这些工具覆盖了从数据采集、标注、模型训练、仿真验证,到技能执行和错误恢复的多个环节。
NVIDIA 连采集设备的设计图纸都开放的一个重要原因是,机器人行业尚未形成能够在不同硬件之间广泛复用的开发体系。
通用基础模型只是其中一环。开发者即使获得模型权重,仍然需要解决训练数据格式、机器人控制接口、仿真环境、动作适配和任务评测之间的差异。要让这些能力真正组合起来,开发者需要的不只是一颗大脑,还有配套的工具。
而放眼整个行业,机器人智能的供给方式正在出现不同选择。
Physical Intelligence 在 10 月 13 日推出 Pi API 测试版,允许开发者上传机器人数据,在 PI 托管的计算资源上微调模型,并通过云端接口运行适配后的策略。机器人公司不必独立建设完整的基础模型训练基础设施,也能使用和持续改进前沿机器人模型。
Google DeepMind 则通过 Gemini Robotics 2 系列,将具身推理、视觉语言动作和端侧控制能力分层提供,覆盖不同的机器人硬件。Figure 选择了更深度的软硬件一体化路线。其 Helix 02 深度整合自有机器人本体、视觉、触觉和运动控制,让感知与全身执行在同一套系统中协同。
本体公司可以像搭积木一样组合智能能力。不同环节的技术选择,开始可以独立计算投入与回报。
以 Pi API 为例,机器人公司能省去自行建设大规模基础模型训练基础设施的工作,却仍然需要采集任务数据、完成微调和真实测试,也需要考虑云端推理的网络可靠性、运行成本和模型更新节奏。PI 在公布早期合作案例时,就提到部分机器人实际使用过程中遇到了网络连接问题。NVIDIA 计划开放 GR00T 2 模型权重,赋予开发者更多模型部署与运行的自主权,但相应的算力、适配和维护工作仍然需要自己承担。
拥有大规模设备、持续数据反馈和充足研发预算的公司,有理由长期投入自研基础模型,因为模型能力可以反过来强化其硬件和数据优势。对于资源有限、主要服务于特定场景的公司,使用外部基础模型,再把研发投入集中于硬件适配、专有技能和客户交付,则更经济。
而对于 NVIDIA 来说,无论最后谁家模型胜出,训练、仿真和部署都要消耗算力。开发者用不用 GR00T 2 不重要,用不用 GPU、Isaac Lab 和 Jetson 才重要。开放 GR00T 2,更像是给自家的计算体系修路。
NVIDIA 的平台布局已经有人试水。NVIDIA 在 CoRL 披露,Foxconn 正将 GR00T 2 用于服务器制造相关工厂自动化,Siemens 正在评估其工业应用,Nexuni 正测试机器人洗衣操作。MicroAGI 则使用经过强化学习后训练的 GR00T 2,让 YAM 机械臂执行以太网线插拔,同时借助 Isaac Lab 3.0 和 Newton 构建、校准训练所需的仿真环境。
不过,这些合作大多仍在测试和评估阶段。机器人基础模型未来会不会形成类似大语言模型的独立供应市场,尚无定论。
但在这场竞争中,一些趋势已然显现。一方面,机器人公司获取通用智能能力的门槛正在下降。过去需要从头研发的部分模型、数据和工具,开始可以通过外部供应获得。另一方面,模型和工具的普及,并没有消除现实部署的差异。机械结构、触觉与力控、客户场景、工艺理解、异常处理和长期运维,仍然决定着机器人能否从实验演示走进实际工作流程。
这种分工一旦深化,影响也将沿着产业链传递。基础模型公司可以不依赖自有机器人销售模型能力;开发平台可以服务多种模型路线;系统集成商有机会将项目经验转化为可复用的软件技能;本体公司则需要重新判断,哪些能力值得自己持续投入。
演讲最后,Jim Fan 又回到了开场时的「凛冬」。他认为,Astra 没有打碎机器人研究者的梦想,而是打破了他们之间的围墙。
他宣布开放模型、数据、软件和硬件设计,并以一段需要高频控制、点燃一簇火焰的演示收尾「夏天要来了。」
对于行业而言,夏天是否到来,还需要真实部署和商业结果回答。
如果机器人大脑逐渐成为可以获得、可以拼装、可以逐层替换的通用能力,未来机器人公司的壁垒就变成了能否把这些能力转化为低成本、可复用、能够长期稳定运行的实际生产力。
自研与否不再是信仰问题,是 ROI 问题。