

LiberAI 发布 Liber-0,打通人类动作经验到机器人
作者:江思奇
11 月 4 日,物理世界模型初创公司 LiberAI 正式发布世界动作模型 Liber-0。
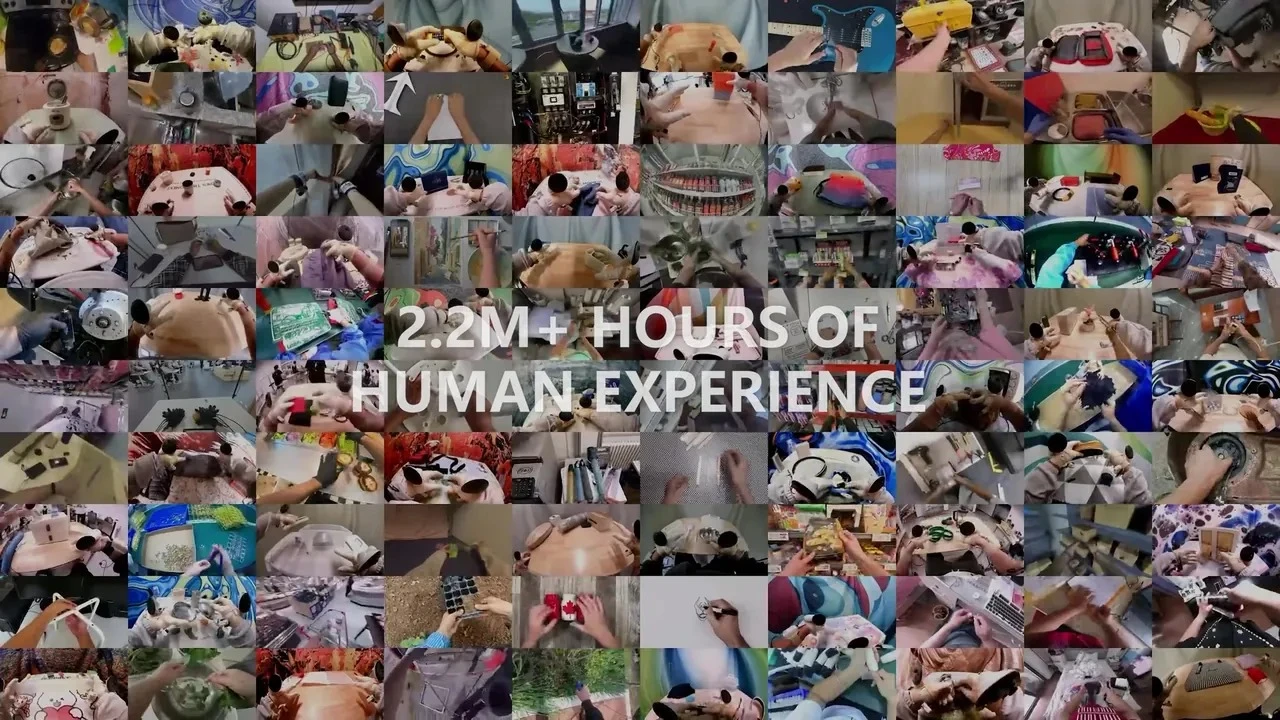
根据官方信息,Liber-0 在超 220 万小时的人类经验数据上完成预训练。团队采用 GPT-6 提出的 60 项操作任务做零样本评测:任务分为三类,每类 20 项,每项重复测试 10 次,总计 600 轮。用于测试的权重 checkpoint,没有用这批目标任务专属的机器人示范数据做定向训练。
最终整体成功率 36.0%:抓取放置(PnP)63.5%,短程非抓取放置(short Non‑PnP)34.0%,多步高难度 Non‑PnP 任务 10.5%。
Liber‑0 属于世界动作模型(World Action Model,WAM),基于 Mixture-of-Transformers 架构搭建,由语言、视觉、动作等多个专家模块构成。它联合预测未来视觉帧与动作,并引入统一本体表征,用来跨越人类和机器人在几何、运动学上的差异,实现动作迁移。训练阶段同时共训视觉问答、图像分割、图像编辑、视频理解等语义任务;模型也可以对接推理 Agent(例如 GPT‑6 Astra),由后者负责中间目标规划。
在同样的 60 项任务里,如果只用 GPT‑6 Astra 单独作为机器人策略(Astra-only)作为基线,三类任务成功率分别为 8.3%、5.0%、1.7%,依次对应抓取放置、短程非抓取放置、多步高难度非抓取放置;该项基线每组任务测试 3 轮,合计 180 次试验。官方数据显示,Astra 单次决策平均推理耗时 87.3 秒,成功完成一项任务的端到端平均时长达到 17.8 分钟。
它的预训练数据分为五大类:LiberSense 数据手套采集数据、跨本体机器人数据、公开第一视角数据集 OpenEgo、外部采集的 VendorEgo,以及互联网人类视频数据,另外搭配用于共训的视觉理解数据。预训练分为三阶段:先完成通用视觉预测,再联合学习世界与动作建模,最后调高手套和遥操作数据的采样权重,重点打磨操作能力。官方规模实验还发现,把互联网人类数据扩充到 200 万小时后,抓取放置、非抓取放置的进度分(0–100)分别是 64.6 和 51.2,表现仍然不如仅使用 1 万小时手套数据的版本。
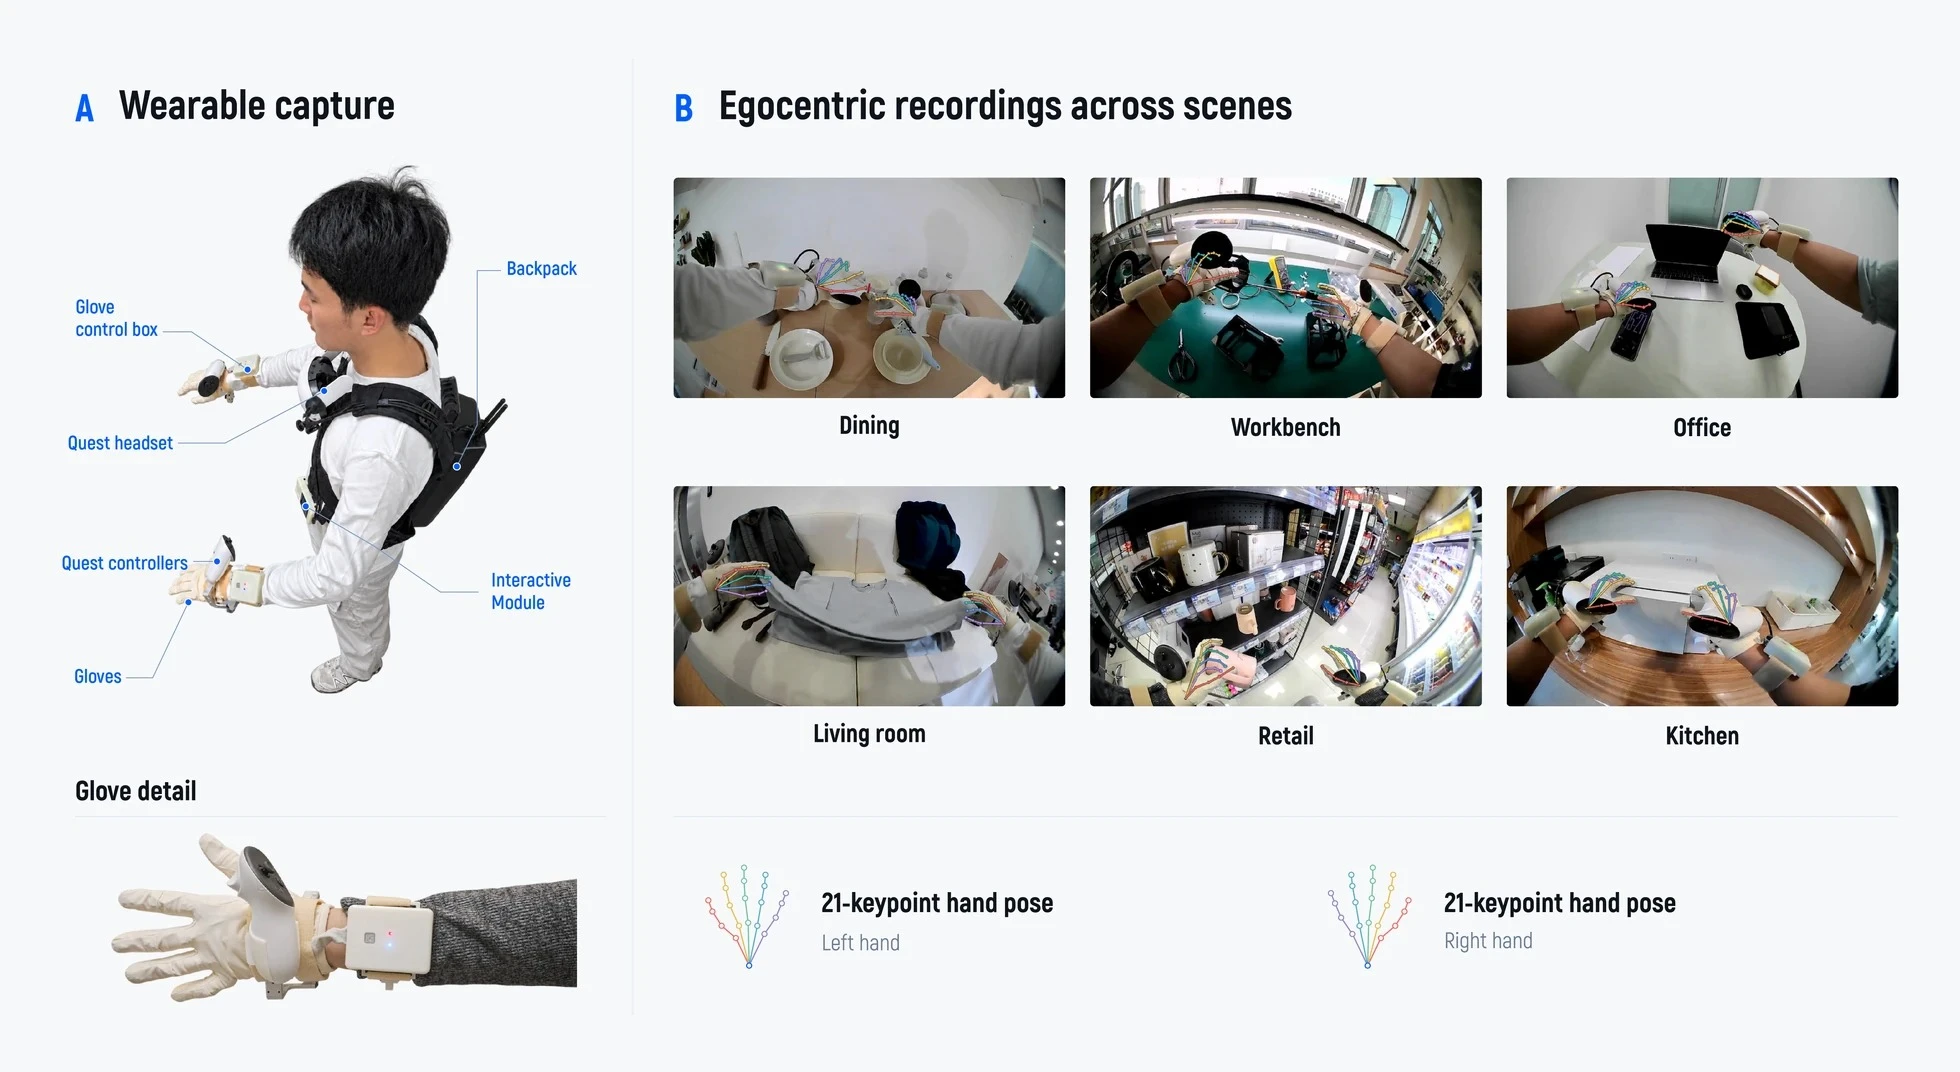
配套的 LiberSense 数据手套厚度仅 0.3 mm,重 131 g,外观接近肤色。它可以同步采集手部姿态轨迹、主视角画面以及两路腕部相机画面,不用搭配机器人就能单独采集动作数据。据雷峰网消息,这款手套已经批量投入真实的工作与生活场景采集数据。
在少真机数据迁移实验里,团队在搭载 WUJI2 灵巧手的 LEO 平台上测试了 8 项任务,每项重复 10 次,一共 80 组试验:只用全部机器人示范数据时,进度分为 72.8。随后固定机器人示范占数据池的 25%,逐步把手套数据占比从 25%、50% 提升至 100%,对应的进度分分别是 61.2、68.4、75.6。这套方案在真机示范削减 75% 的前提下,效果反而超过纯机器人数据组的 72.8。
他们还验证了手套数据能够教会模型新能力:只靠遥操作抓取放置数据时,非抓取放置任务进度仅 2.2;补充手套采集的非抓取放置数据后,直接涨到 47.5;再接入完整手套数据集,可以进一步到 54.6。
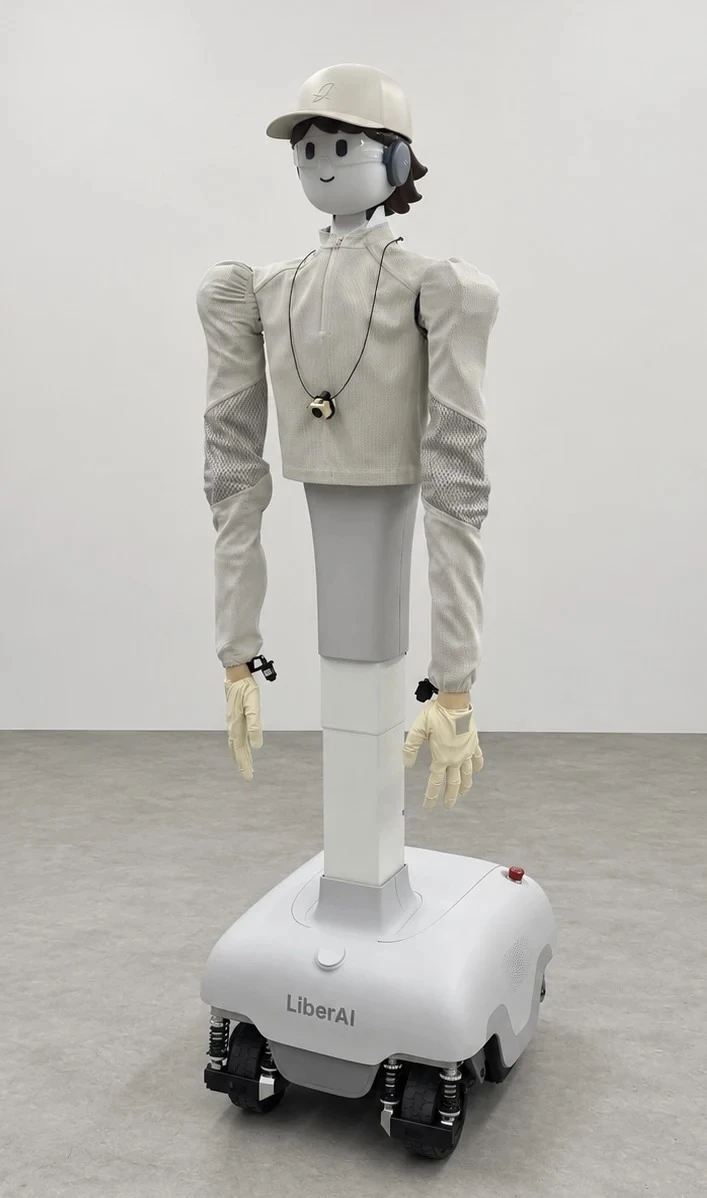
自研机器人本体 LEO 搭载灵巧手、纤细前臂、类人手腕与可活动腰部,腕部拥有三个旋转自由度,不用移动前臂就能实现接近人类的手腕转动;胸腔和腕部相机的视角和手套采集体系对齐,用来缩小人类经验迁移到真机时,在视觉、运动学上的落差。根据智东西信息,LiberAI 创始人刘松铭是清华大学计算机系博士。
官方表示,经过预训练的模型能够快速接入各类落地流程,公开演示里就包含制作奶茶这类生活化场景。
公开资料中,Liber-0 尚未披露模型开源与定价信息。在 100 小时仿真遥操作数据上完成 Liber-0 的后训练后,用户可在 https://sim.liberai.work/ 上传自定义物体,无需针对该物体额外训练即可在仿真中观察操作表现。