

开源模型也能直接操作机器人!清华 x 伯克利重磅发布 uni-robot-agent,迈向 RUA 训练和本地部署
作者:王星宇
开源模型也能直接操作机器人!清华 x 伯克利重磅发布 uni-robot-agent,迈向 RUA 训练和本地部署
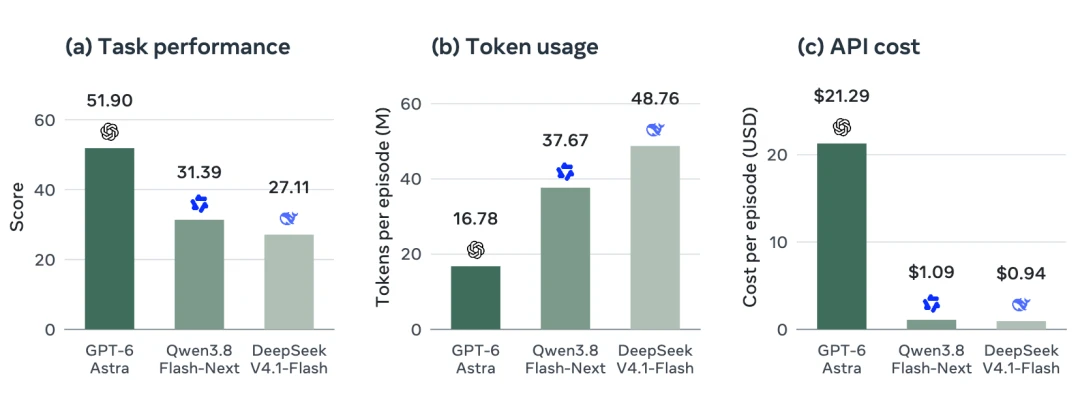
在 RoboDojo 上,Qwen3.8-Flash-Next 通过直接操控机器人的方式拿到 31.39 分。这个分数,比 GPT-6 Astra 此前榜单上公开的 28.97 分更高。Qwen 以约 6.6% 的成本跑赢 Astra 公开成绩。
一个开源、权重可以下载、单局调用成本只有 1 美元出头的模型,竟然超过了前沿闭源模型交出的成绩单。
这份成绩背后,团队更关心的是如何为之后的开源 RUA(Robot-Use Agent,即具身智能体)的训练,提供全新的可能?
11 月 3 日,清华大学、加州大学伯克利分校组成的研究团队联合发布了统一具身智能体框架 uni-robot-agent。这项重磅研究名为《Democratizing Robot-Use Agents: A Unified Harness with Open Models》,Jiarui Yuan 为第一作者,Yuxin Zuo、Xiaoyu Huang 为项目负责人、核心贡献者,此外该工作还包含其他数位核心贡献者,另有清华大学电子工程系助理教授丁宁博士、加州大学伯克利分校电气工程与计算机科学系教授及人工智能研究实验室(BAIR)联合主任 Pieter Abbeel、清华大学计算机系副教授刘知远、清华大学交叉信息研究院助理教授徐梦迪等具身智能界知名学者赫然在列,共计 28 人。
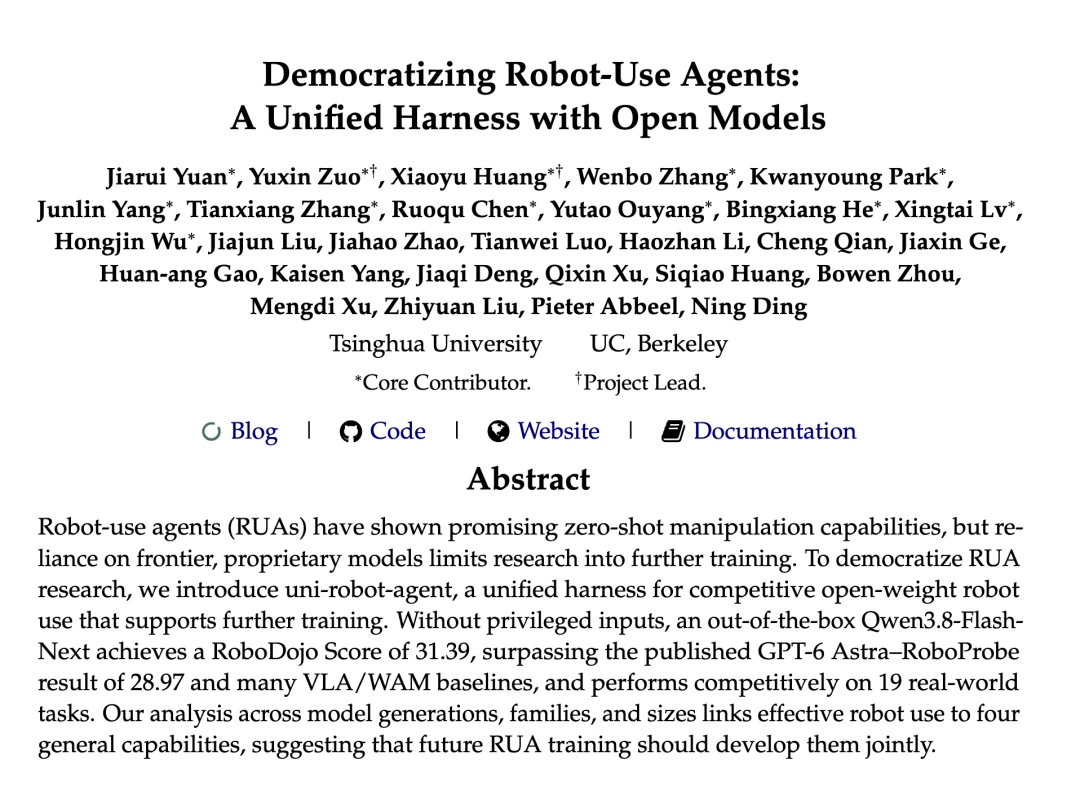
**该研究的核心贡献在于设计了一套模块化可插拔、跨环境统一的 Harness 基座。**结果显示,uni-robot-agent 不仅在开源模型上表现出优异效果,模块化设计还允许研究者对 RUA 的各个组件进行消融研究,并为之后 RUA 的多环境训练奠下工程基础。
团队主页:https://openrua.ai/
uni-robot-agent 源自于 OpenRUA。OpenRUA 是由世界顶尖高校和前沿实验室研究员发起的前沿科技研究项目,研究背景覆盖具身智能、基础大模型。该项目的目标是创造能够进入物理世界、实现交互的开源、通用智能体基座。截至目前,uni-robot-agent 是该项目发布的第一个开源成果,具有标志性意义。
Astra 之后,具身智能体如何更进一步?
机器人研究的传统范式是针对不同任务和机器人本体,分别构建专用模型。GPT-6 问世后,其在机器人操作与导航方面展现出的能力曾让研究者为之震撼。在包含 42 个任务的 RoboDojo 基准上,GPT-6 Astra 已经展示出零样本操作能力,这些任务覆盖泛化、精确操作、长程执行、记忆和开放词汇指令跟随。面对陌生任务,Astra 已可以观察场景、编写代码、调用机器人工具,再根据执行反馈调整下一步动作。原本用于解决数字世界问题的能力,开始延伸到真实的抓取、移动和操作中。
但要把这条路线从演示推进到可持续的研究,仍存在三道门槛。
机器人操作需要持续观察和纠错,多视角图像与交互历史被反复送入模型,一个任务可能涉及几十甚至上百次调用。少量演示可以承担,扩展到大规模实验和数据采集,成本就成为实实在在的限制。过往研究表明,Astra 的闭环协同虽然确实有效,但成本较高。
而在自主性上,由于模型权重不开源,研究者只能通过 API 使用现有能力,难以在自己的硬件上部署,也无法针对机器人交互优化模型、缓存和推理过程。实验的速度与规模,很大程度上取决于外部服务。更重要的是,机器人每次尝试都在产生经验,但研究者无法直接用这些轨迹更新闭源模型的权重,形成有效闭环。当前最关键的挑战即是将 benchmark 中的成功转化为可靠、高效并且可扩展的真实世界部署能力。
因此,Astra 展示出的能力也引出了下一个问题:能否让开放权重模型同样有效地使用机器人,让研究者既能运行它,也能训练它,让今天的交互成为明天的能力?
uni-robot-agent 正是朝这个方向迈出的一步。
设计选择
如今,具身智能体(Robot-Use Agent)已经展现出颇具前景的零样本控制能力。它的基本流程并不复杂:读任务,看图像,调用工具,观察结果,再决定下一步。模型负责决定做什么,Harness 则让这些决定真正进入物理世界。看似简单的交互流程背后,其实涉及不同机器人的能力差异、工具接口、执行反馈和异常处理等一系列问题。uni-robot-agent 团队的最终目标是构建一套统一、易用、可泛化的 Harness,让不同模型都能以一致的方式与不同机器人交互。
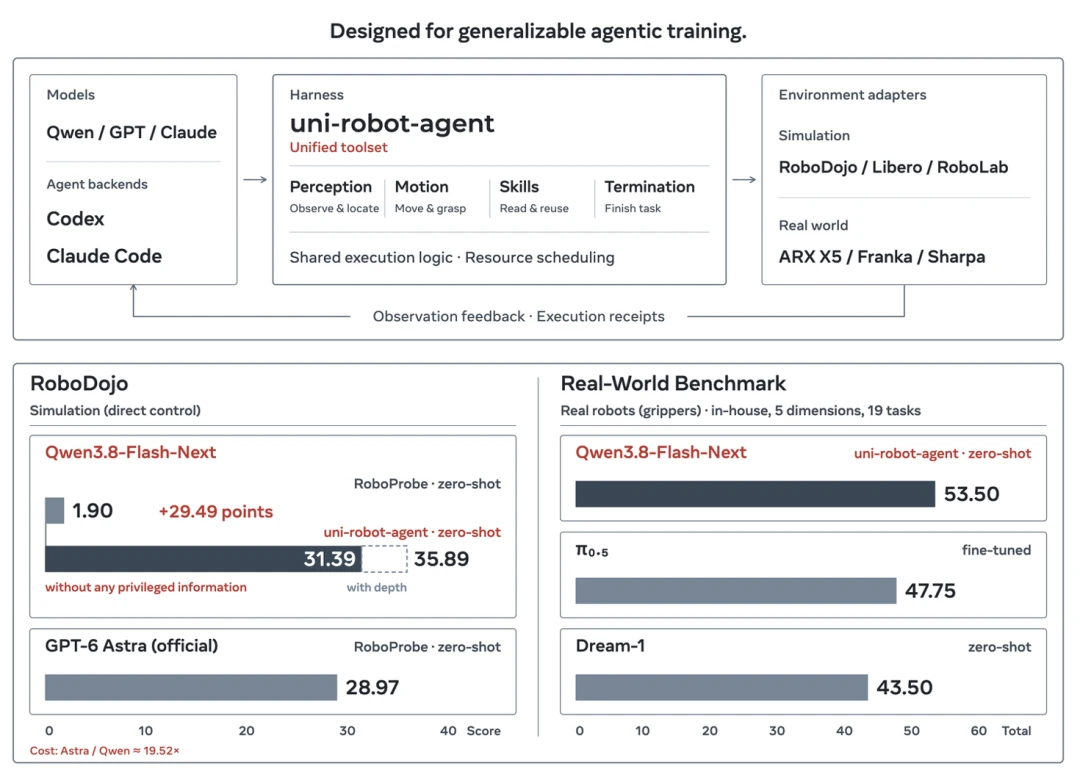
**uni-robot-agent 的最大特征是跨环境统一与模块化。**设计之初,uni-robot-agent 即瞄准为 agentic training 打造底座。在仿真和真机环境内,感知、运动、技能、episode 控制四类工具共用一套定义,环境差异交给各自环境的适配器。这意味着不同环境里学到的能力可以互相迁移,工程上只要维护一套工具。
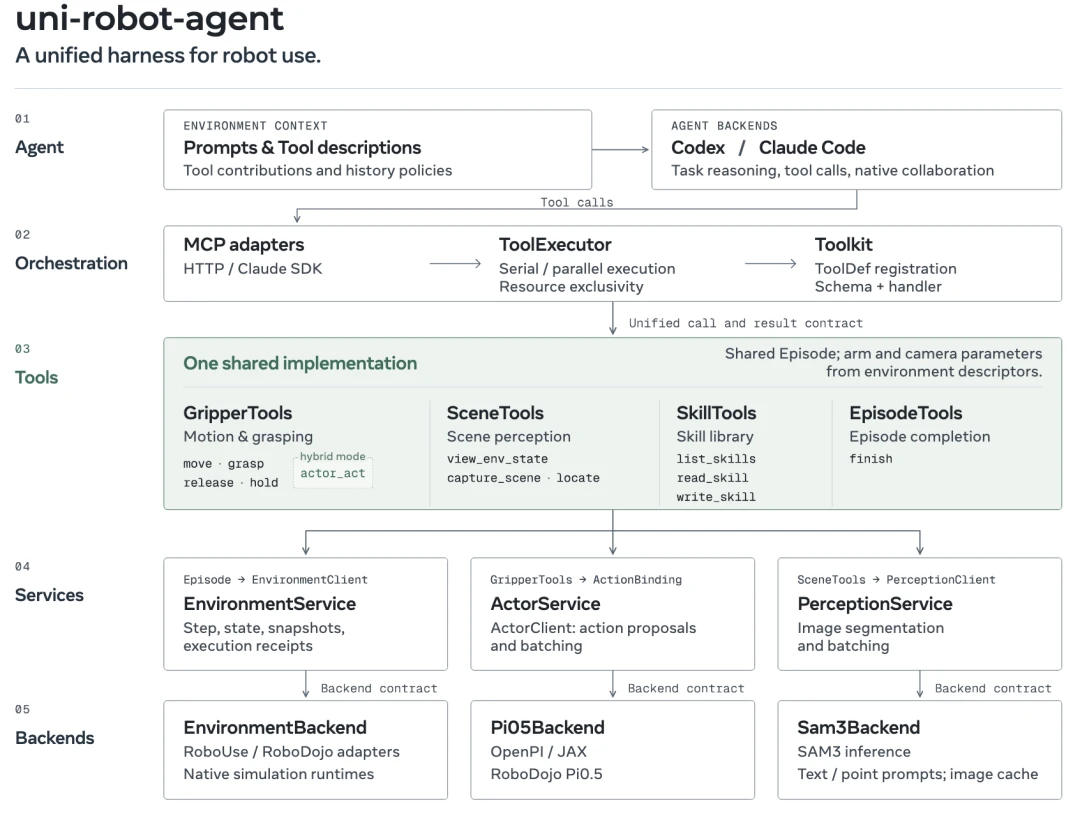
而从完整的 Harness 框架来看,uni-robot-agent 的形态更像一盒可拼搭的「乐高积木」。当 Agent 运行时,无论是上下文策略、感知后端,还是动作模型、环境适配器,每一个都能单独开关、单独替换。基于这种设计,研究者一方面可以更好地进行二次开发,一方面可以更好地进行消融实验,验证各个组件对于具身 Agent 的重要性。
团队把 Agent 能拿到的信息严格限制在真机上也能拿到的范围,本体感知、机器人描述文件、固定相机的 RGB 及标定参数、任务指令。仿真器里的精确深度、物体 CAD 模型、隐藏标注一概不给,任务执行过程中的分数不回传给模型,技能也是通用的,不为某个基准任务定制。没有资源上的 hack,也没有信息上的 hack。
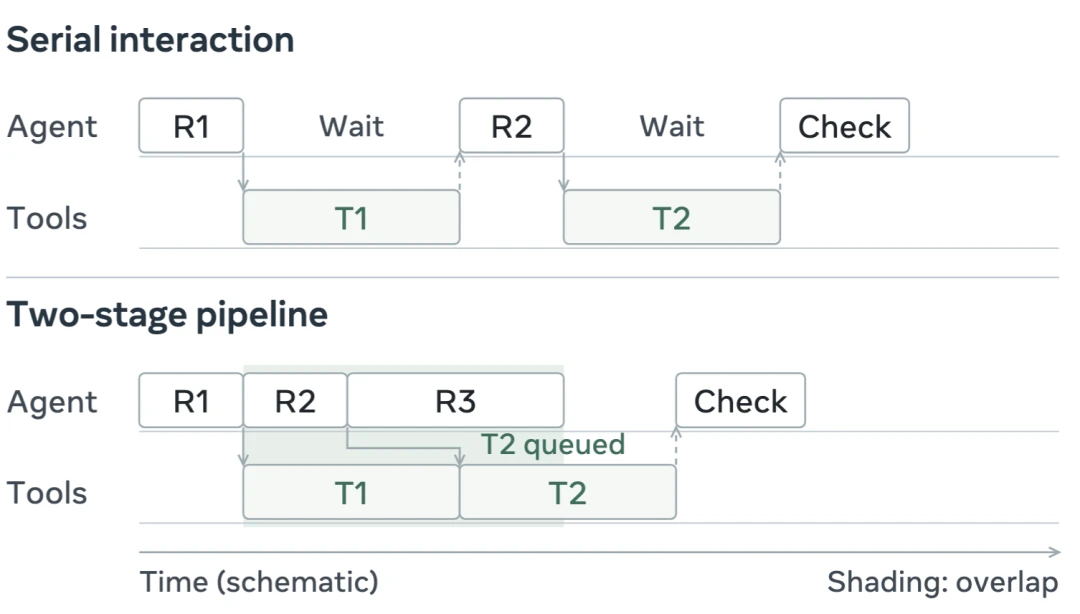
uni-robot-agent 带来的并行加速同样重要。当需要执行的物理动作非常耗时,工具可以立刻返回一个任务句柄,模型接着准备进行下一步准备。同时,共用同一资源的动作按顺序规划,计划随着世界变化发生改变,Agent 还能够撤销相关动作,当机械臂在动的时候,模型已经在考虑下一步。这种方法支持模型在多个子任务之间保持并追踪整体进度,从而将 uni-robot-agent 的优势发挥至最大。
为了连接视觉理解与物理动作,uni-robot-agent 为模型提供相机内外参,来建立图像坐标和机器人坐标之间的关系。这些信息可以通过实际相机与机器人的标定获得,无须读取仿真器中的深度信息,也不依赖针对任务编写的定位捷径,在真机环境下也容易获取。模型可以利用这些信息通过三角标定的方式建立空间坐标,只是相比于深度标定,模型需要结合不同视角和几何关系进行推断。
「我们的考虑是,如果定位可以更直接,效果会好多少?反过来,如果连标定信息都没有,模型又能做到什么程度?」
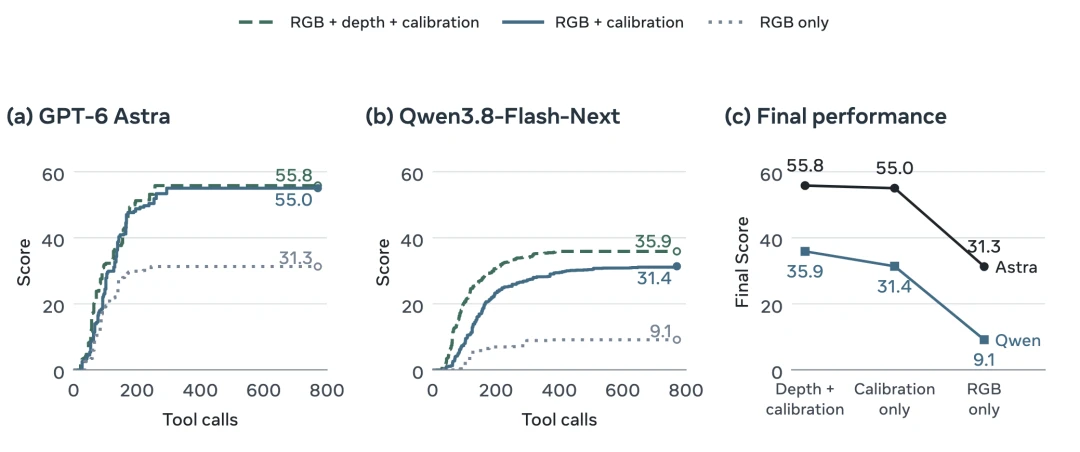
团队因此比较了提供深度与相机标定、只提供相机标定,以及仅提供 RGB 图像的三种设置。
有深度时,工具可以结合相机内外参,将目标像素直接转换成三维坐标。移除深度后,模型还需要在不同视角中找到对应点,通过三角测量恢复目标位置。测试结果显示,Astra 的得分仅从 55.83 变为 55.04,几乎不受影响;Qwen 则从 35.89 降至 31.39。这一差异表明,Astra 更善于利用已知的相机几何建立空间定位,而 Qwen 在跨视角对应与几何推断上仍有差距,更依赖直接提供的深度信息。
进一步移除相机内外参,考验就从「利用已知几何定位」,变成了「自行推断视觉观察与物理动作之间的空间关系」。模型不仅要判断物体在哪里,还要理解图像中的方向和距离意味着机器人该如何移动。在这一设置下,Qwen 的得分降至 9.13,Astra 仍达到 31.29。这更直接地体现了模型自身的空间推理能力,也充分说明了标定信息能够为开源模型连通视觉与动作,帮助空间能力尚不充分的模型完成有效操作。
仿真与真机结果
为了验证 Harness 的泛化性,uni-robot-agent 团队在仿真和真机上都做了评测。
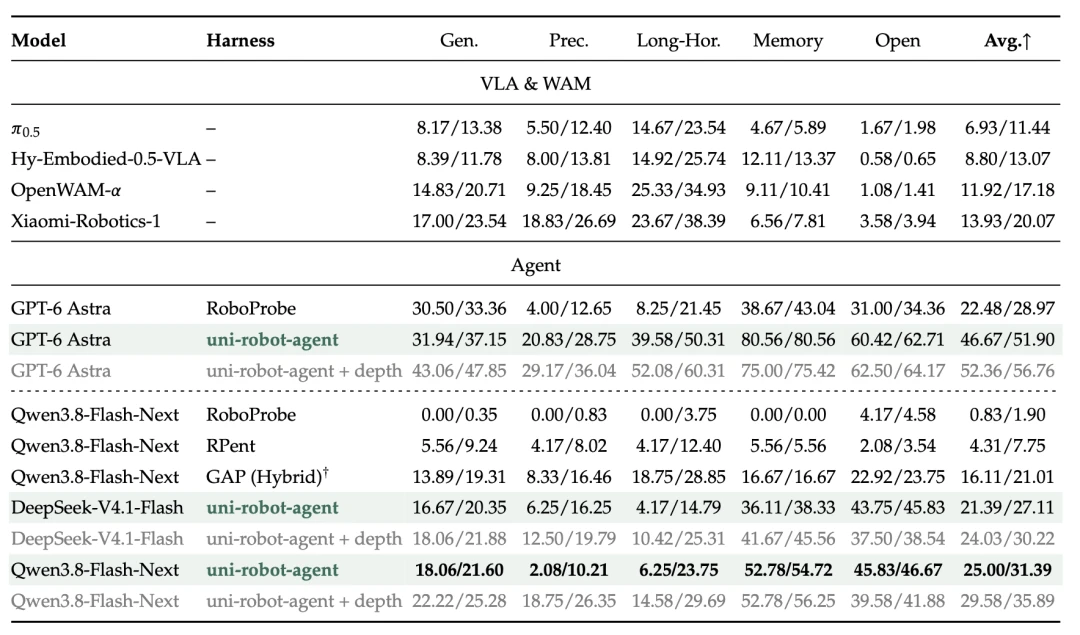
在仿真环境中,Qwen3.8-Flash-Next 加上 uni-robot-agent 的组合取得了 31.39 分,表现均显著优于 GAP 以及 Astra 与 Roboprobe 的结合,这验证了开源模型完成具身任务的能力。另值得注意的是,DeepSeek-V4.1-Flash 同样在本次测试中取得了 27.11 分,GPT-6 Astra 取得了 51.90 分。这说明了 uni-robot-agent 并不针对 Qwen 专门优化,而是一套可以泛化到任意模型的 Harness。
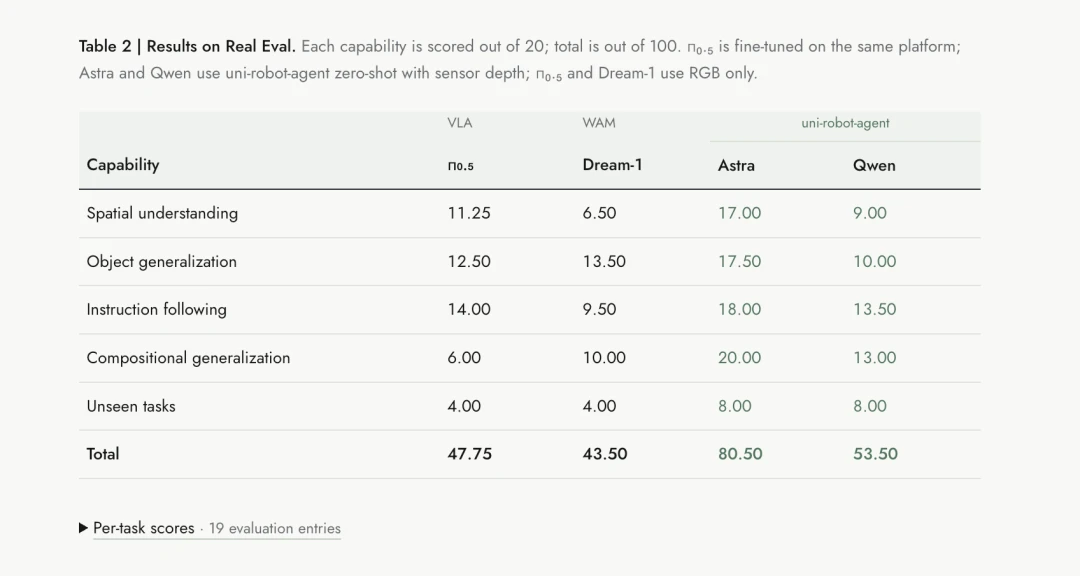
**uni-robot-agent 在真机测试中有更亮眼表现。**团队在一台双臂夹爪平台上搭了一套涵盖 19 项任务的真机评测 Real Eval,分为空间理解、物体泛化、指令遵循、组合泛化和未见任务五个维度,每个维度 20 分。Qwen 在一条评测任务的真机数据都没见过的情况下,拿到 53.50 分,高于微调过后的 π0.5 。而 Astra 在这套 Harness 下更是达到了 80.50 的高分。
当然,这套 Harness 的适用范围也不止于平行夹爪,同样也可作用于灵巧手等涉及灵巧精细操作的相关载体。在演示中,团队把它接到了 Franka 机械臂与 Sharpa 灵巧手上,仅需简单扩展灵巧手相关工具,uni-robot-agent 搭配 Astra 就完成了抓取小鸟玩偶、按下绿色按钮、把苹果放进盘子这类灵巧操作。
uni-robot-agent 还不止于此。尽管在一般的 Harness 框架中,技能库可以复用积累下的操作经验,但也容易让人疑惑,系统是否有能力提前为每道题准备了解法?
为此,团队又做了一次消融实验。实验同时关闭了 Qwen 对机器人技能库的访问和技能写入能力,而仅保留任务说明、环境描述与基础机器人工具。在移除技能后,系统的整体得分从 31.39 仅略微下降为 30.31**。结果表明,uni-robot-agent 的整体表现并不过度依赖技能库提供的任务知识。当然,这并不意味着技能模块本身就失去了价值,它仍然为经验复用和后续扩展提供了接口。**
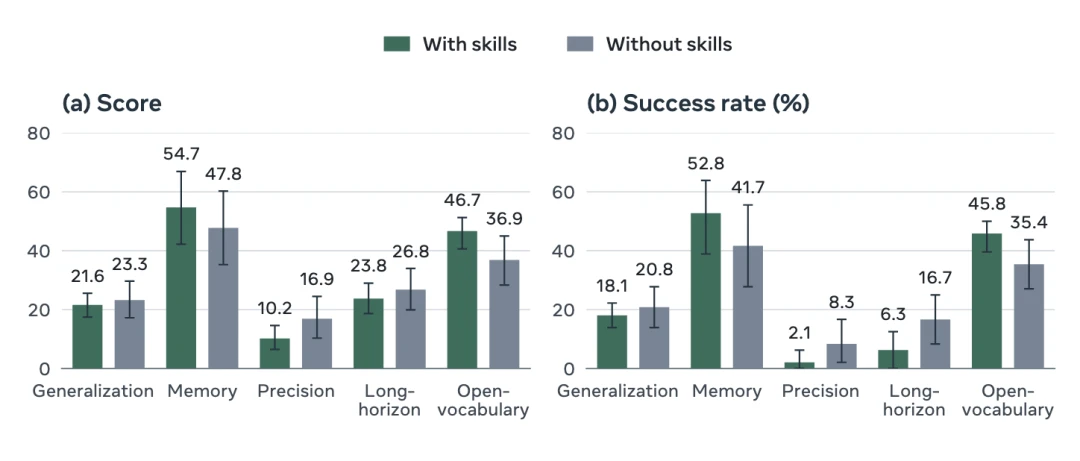
**两组实验共同指向了 uni-robot-agent 设计思路的有效性。**Harness 要提供有助于推理的信息,让工具可靠地执行动作、返回有效反馈,把具体问题留给模型解决。 相机标定和机器人本体描述帮助模型建立空间关系,可靠的运动工具与执行反馈则支持它行动、检查和纠错。这正是 uni-robot-agent 希望为开源模型搭建的基础。
在开源模型上获得了令人兴奋的分数后,团队并没有就此停留,而是开始思考,开源模型究竟需要怎样的能力才能做好具身任务?
分数之外:开源模型究竟需要怎样的能力
为了研究模型完成具身任务需要哪些能力,团队还在 RoboDojo 上评测了 Qwen、GPT、DeepSeek 等不同系列、代际和规模的模型,期间发现了一个意料之外的反差。测试结果显示,Qwen3.8-27B 已经能够完成部分任务,而参数量更大的 Qwen3.7 Plus 则未能在评测任务中取得成功。
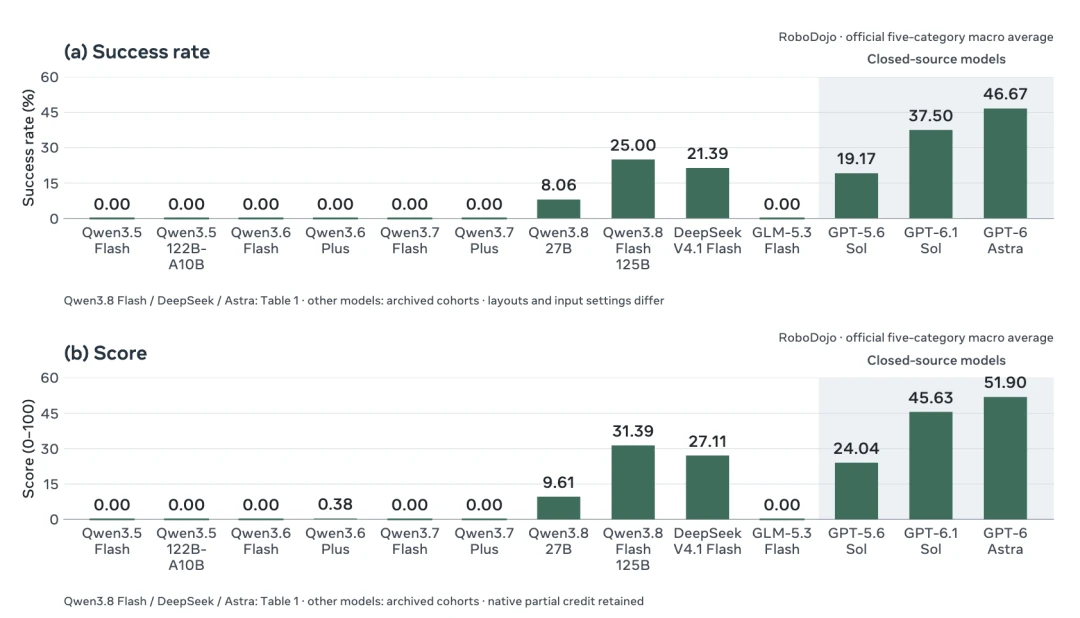
类似的反差也出现在模型代际之间。GPT-5.6 Sol 已经展现出一定的机器人操作能力,而部分更新的模型依然难以完成任务。显然,模型的参数量和版本迭代的新近程度,都不足以单独解释它在机器人任务上的差异。
为什么会产生这样的情况?
在任务执行中,机器人会把一个看似简单的指令拆成连续的考验,先看清场景、找到目标、算出动作,再判断这个动作在物理世界中是否可行。任何一步的开始或者结束出现与预期不同的细微差异,都有可能让错误积累,导致后续操作偏离目标。团队表示,他们进一步检查了模型的交互轨迹后,发现失败主要集中在四个方面:
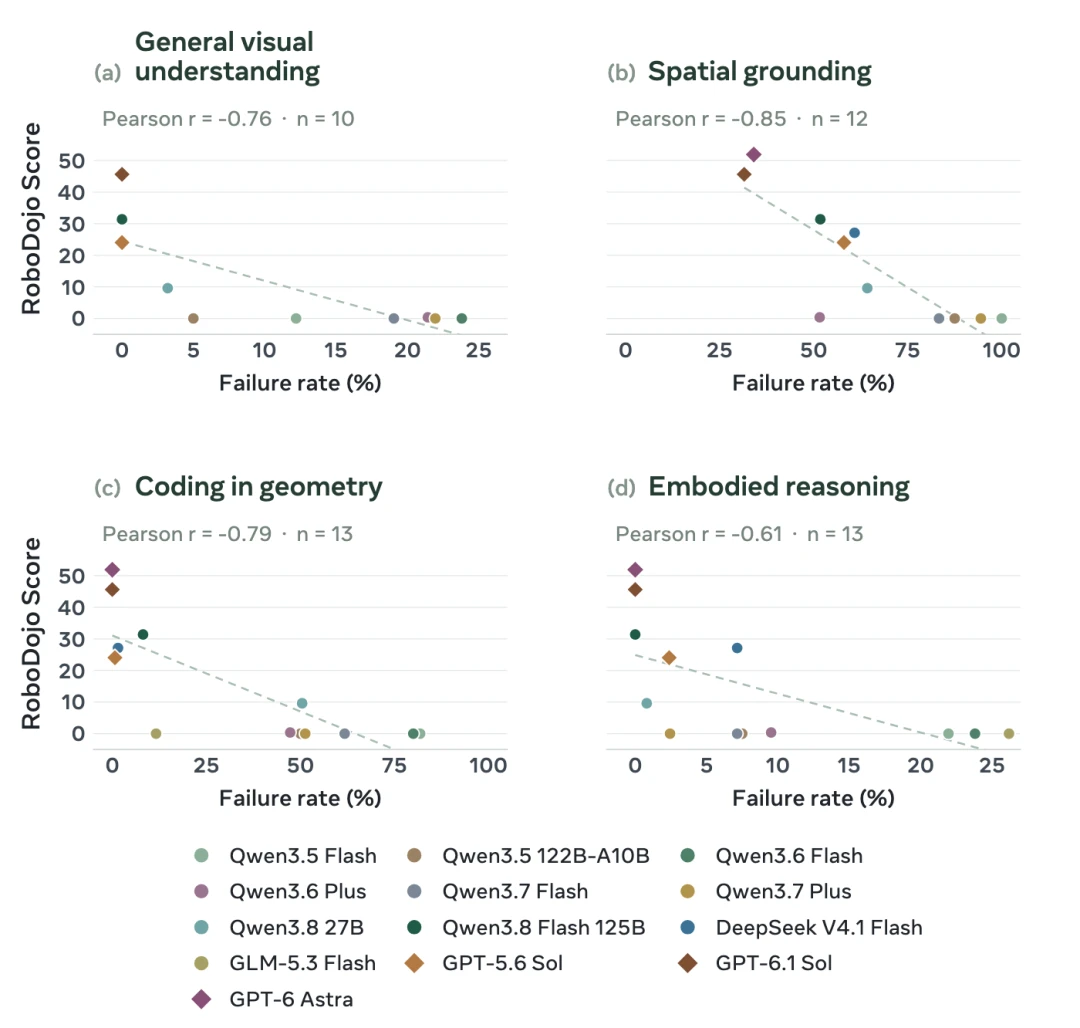
- **看懂场景。**把数字「0」认成「9」,或把倒扣的杯子当成正放,都会让操作从一开始就走错方向。在较早的 Qwen Flash 和 Plus 模型中,这类未能纠正的视觉错误出现在约 12.2%–23.8% 的试验中。
- **找准位置。**模型需要在不同视角中找到同一个物理特征,才能利用相机几何恢复空间位置。即使是这项表现最好的 GPT-6.1 Sol,相关调用仍有 31.5% 因对应点不一致、重投影误差过大而标定失败。
- **算对几何。**从图像到机器人动作,需要坐标变换、姿态计算和代码执行。较早的 Qwen Flash 和 Plus 模型在 47.3%–81.8% 的几何计算中出现错误,而 Qwen3.8-Flash 的这一比例降至 8.2%,DeepSeek 则为 1.5%。
- **理解物理操作的合理性。**手腕朝向是否合适、夹爪能否接近目标、双臂如何配合,都需要模型理解动作的物理含义。
除了结合轨迹进行分析,我们是否能对通用模型评测与具身表现进行串联分析,从中得出端倪?基于这样的考虑,团队将六个基础大模型的 RoboDojo 表现与具身推理、多模态理解、视觉定位和代码生成基准进行比较,发现四类指标均呈正相关,其中模型的具身推理和多模态理解与具身表现的关联更强。
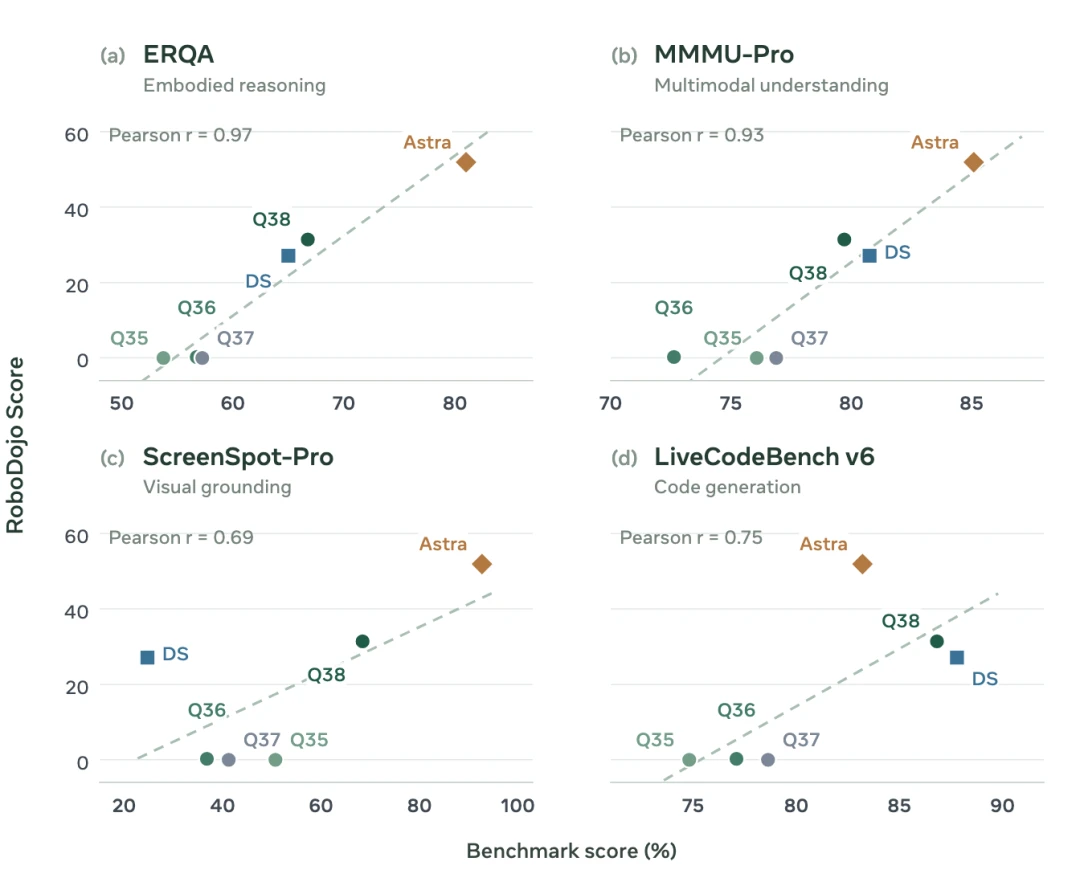
**因此,基础大模型的表现并不一定随着参数的扩大而提升。要更精准有效地提升机器人能力,除了学习动作本身,还要求人们有针对性地训练模型如何观察、定位、计算和判断。**这为后续基础大模型的具身训练提供了明确线索。
为什么 uni-robot-agent 重要
过去,大家谈到 RUA,往往会想到那些能力最强的闭源前沿模型。而现在的 uni-robot-agent 佐证,一个参数规模更小、使用成本更低、还可以本地部署的开源模型,也能在不少有挑战的操作任务上取得不错的表现。
**不仅如此,研究成本也实现了堪称「自由落体」式的下降,更利好中小型研究团队。**据团队估算,Qwen 每局的 API 成本为 1.09 美元,Astra 则为 21.29 美元。若完成如本研究采用的完整评测,前者不到 300 美元,后者则超过 5,000 美元。这意味着,RUA 的研究不必再局限于少数闭源模型,更多开发者也可以基于开源模型搭建自己的系统、开展实验,探索新的方向。
**更值得期待的是,模型可以在真实交互中不断积累经验。**权重开放后,研究者不仅可以把模型部署在本地,减少对外部 API 的依赖,也可以利用机器人交互过程中积累的轨迹继续训练模型。机器人每一次尝试、成功和失败,都有机会成为下一轮训练的数据,反过来提升模型的能力。这样,Agent 就有机会形成一个持续改进的循环:与机器人交互、积累经验、训练模型,再把训练后的模型放回机器人上继续尝试。这也是开放权重带来的一个更长远的研究空间,在正确的方法下,开源模型做好机器人操作不再是一纸空谈。
「我们给这套东西找了个参照:编码 Agent 领域的 mini-swe-agent。它的目标是一个简单、通用、谁都能拿来二次开发的 Harness,带有统一的接口和结构化记录,让不同环境里的交互经验可以按同一格式收集。当前,我们已经实现导出 Codex 的交互轨迹,这些正是可用于 SFT 和强化学习的原料。」
**uni-robot-agent 罕见聚集了中国和美国具身智能研究界的顶尖团队,其 Harness 的提出显著降低了基础大模型应用于具身智能的训练门槛。**部分场景下 Qwen 一度超越 GPT-6 的可喜表现足以表现出 Agentic 潜在技术突破的可能。基于这项研究,机器人的经验或许能够通过训练持续回流,直到真正形成学习闭环。秉持着开源精神,相信 uni-robot-agent 还有很大的探索空间,值得期待。
延伸资料
论文链接|https://arxiv.org/abs/2611.01560
博客链接|https://openrua.ai/uni-robot-agent