

对话 Copper-Policy 团队:从像素预测走向紧凑世界表征
作者:王星宇

为了让机器人具备更强的认知与物理交互能力,研究者开始探索世界动作模型(WAM)。WAM 通过视觉动力学预测场景的演化,将「世界应当变成什么样」与「机器人如何实现这一变化」联系起来。即使测试时不生成未来,联合训练的收益仍然存在。
那么,WAM 动力学学习中的哪个方面真正改善了控制?我们已经在 Fast-WAM 中看到,即使测试时不生成未来,视频联合训练仍然有益。更近的研究则指出,将有用的未来信息编码成表征,并用于策略学习,也可能改善控制效果。例如,有的研究将预训练联合嵌入预测架构(JEPA)的表征作为策略输入或固定预测目标,也有研究在特定约束下学习可预测的潜变量。因此,WAM 的价值似乎更多地在于训练所塑造的表征,而非它实际生成的未来。既然如此,可否直接在表征空间中预测未来状态,并与策略共同演化?
这正是 Copper-Policy 所提出的思考。
论文链接:https://arxiv.org/abs/2609.32779
项目主页:https://zexinfeng-cn.github.io/works/copper-policy/
**Copper-Policy 的核心思路,是让潜在世界预测与动作策略联合学习预测目标空间,而不是直接沿用预训练编码器或分阶段学习得到的固定表征。**为此,模型采用非对称的预测与控制接口:未来专家侧重学习任务相关的世界演化,动作专家则保留执行所需的细节,让预测目标空间专注于任务相关演化,而不必保留执行层面的全部空间细节。实验发现,即便未经大量的具身预训练,Copper-Policy 仍能够同时实现与 π0.5 相媲美的控制表现,并具备较高训练效率,甚至在一系列干扰测试下,世界表征仍维持惊人的稳健,视频的当前帧视觉特征亦能够提供补充。
为了解 Copper-Policy 背后的更多细节,42 号电波同该研究第一作者冯泽欣开展对话。
Copper-Policy 第一作者冯泽欣,香港大学(HKU)土木工程系博士生,师从严鑫涛教授;本科毕业于南方科技大学(SUSTech),主修计算机科学。研究方向包括物理人工智能、自动驾驶和机器学习,曾获 Best Undergraduate Thesis Award (2025)、China National Scholarship (2024) 等。
如何「压缩」
**早期验证阶段,团队内部曾对技术路线产生分歧。**一部分成员认为,视频生成已经证明了像素路线的价值,没有必要轻易转向其他方法。但冯泽欣注意到,对缺乏大厂算力支持的研究团队而言,像素级世界建模的计算成本很高,训练一个全尺寸模型可能需要约 8 张 H200。团队由此开始尝试验证:能否在自监督学习形成的紧凑潜在空间中直接进行世界建模,并与控制策略共同学习,从而避免像素级未来预测的繁重开销?Copper-Policy 正是在对这一问题的探索中逐步形成的。
**团队首先要厘清的是:像素级未来预测中,有多少信息是机器人控制真正需要的?**像素级 WAM 需要生成视频帧,也就必须处理光照、材质和噪声等细节,有时连场景中的无关扰动也会一并生成。这些信息却不一定与机器人要完成的任务相关。团队认为,像素生成会增加训练成本,也可能影响推理效率,但它未必是学习控制策略的必要环节。因此,团队尝试将预测目标转向紧凑的潜在表征,检验能否在不重建完整未来画面的情况下学习对控制有用的世界动态。
**冯泽欣认为,从机器人控制的角度看,不同路线的差别还体现在训练信号所处的空间。**WAM 通常在视频模型基础上增加动作解码专家。相比 VLA,它多了来自下一帧预测的训练信号,从学习角度看相当于增加了一项辅助损失。但更值得关注的是,WAM 的输入与预测目标都围绕观测空间(Observation Space)展开。用他的话说,模型几乎一直「浸泡在 Observation Space 里」,因而能够更直接地学习观测序列之间的关联。
「以把杯子从左边拿到右边为例,人并没有必要完整地想象杯子在运动过程中每个像素点是怎么走的,每一帧图像里的材质、水滴如何运动,这些冗余信息都不重要,重要的是与任务相关的信息。」
分工上,冯泽欣曾提出早期想法,和几位合作者一起讨论、验证。最早的验证是拿玩具任务做的,过程很复杂,进行了很多基准测试与实验。作为本文的第二作者,悉尼大学冯宜湑承担了真机辅助工作和前期验证,其发表于 ICML 2026 的前作《See What Matters: Differentiable Grid Sample Pruning for Generalizable Vision-Language-Action Model》也带来了视觉旁路的紧凑方案。因此,Copper-Policy 的技术思路依然沿承了这种紧凑性。
「那篇文章给我们很大的启发,我们补充的视觉通路同样是紧凑的,整个模型在 Backbone 上的信息通路基本都经过抽象或压缩。」
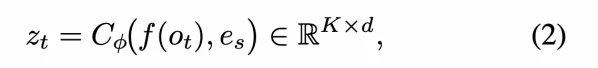
Copper-Policy 还受到来自杨立昆团队 LeWorldModel 、LeJEPA 的研究启发。LeWorldModel 在建模一个任务时,只用 64 个维度就能相当完整地表示这个任务。如果按每个维度 16 bit 计算,64 维只相当于约 1024 bit,远少于一帧原始图像的信息量。这也说明,完成任务所需的表征有可能比原始图像紧凑得多,任务相关的信息还能有更抽象化的萃取空间。这些研究为团队提供了另一种值得验证的思路:能否通过单阶段联合训练,在更抽象的潜在空间中学习世界动态,同时保留动作控制所需的信息?
**紧凑表征的直接收益之一,是减少不必要的建模与训练开销。**Copper-Policy 不必像像素级 WAM 那样重建大量视觉细节,也无需使用完整的视频生成主干。形成的 2B 参数量的模型中,世界建模专家模型参数量仅约为 870M,对于 WAM 来说,这个参数相对轻量。这样一来,World Representation 编码器只需要管理抽象与压缩,相对于基于 Video Gen 的 WAM 更抽象,相对 VLA 则又多了一些动态信息,整体更紧凑。
呈现世界
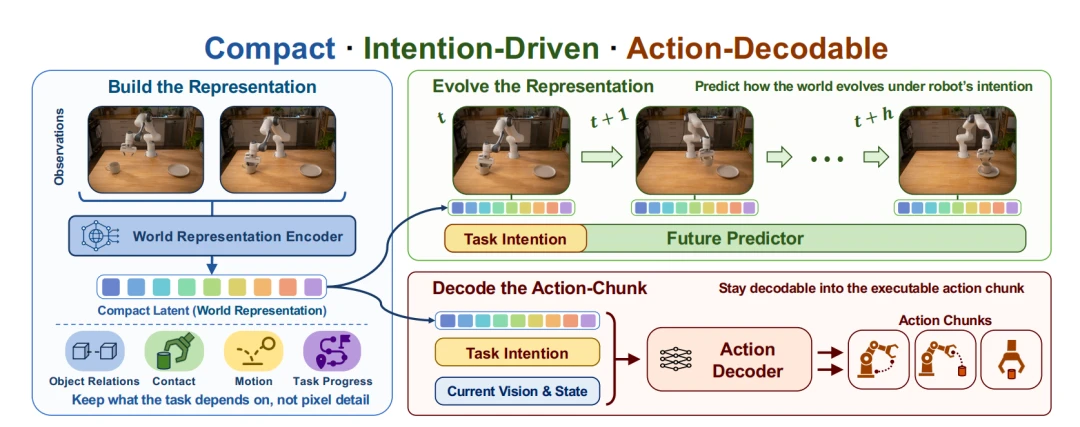
**Copper-Policy 的模型架构强调三个特点:紧凑、意图驱动和动作可解码。**模型首先将多视角相机画面送入世界表征编码器,得到压缩后的潜在表征。这个编码器由两部分构成,前半部分是被冻结的 3 亿参数模型,主要负责理解画面,而后半部分主要负责压缩和编码。结构图中的彩色方块代表编码器输出的潜在 Token。物体关系、接触状态及任务进展等信息,被组织为 20-40 个 Token(依任务设置而定),而不必通过像素级画面重建来表达。随后,模型根据任务指令预测表征变化,并生成机械臂可执行的动作。
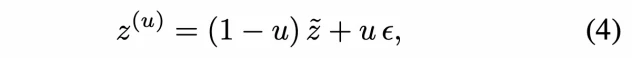
未来预测器以压缩后的当前表征和任务意图为输入,学习预测世界表征随时间的变化。与此同时,动作解码器结合该表征、任务意图、当前帧视觉信息和机器人状态,生成一段动作块。多个动作块连续执行,构成完整操作。
**在设计架构时,团队并未预设某条技术路线必然更好,而是根据实际问题选择方法。**冯泽欣认为,JEPA、DINO 与 BYOL(Bootstrap Your Own Latent) 等方法的训练目标虽各有不同,但都为自监督表征学习提供了重要思路。Copper-Policy 则借鉴了其中的联合嵌入预测与目标编码器机制。
「杨立昆团队的工作路线是希望每个状态都被精确表达、彼此分得很开,再用类似交叉熵或某种启发式的方法把路径搜索出来。我们并不要求编码器能把每个状态都完整地、隔离地表达出来,也不需要这种分辨能力。所以这里借鉴 JEPA 的预测结构并适配到 Temporal 上,而非整个照搬。」
值得一提的是,团队虽借鉴了 JEPA 的联合嵌入预测思路,将表征与策略放在一起训练,但具体的预测目标有所不同。由于 JEPA 训练要求在时序维度上做掩码,再预测未来,让当前与未来映射到同一个空间,「我们相当于直接把未来整体遮掩掉,用当前去预测未来,形成联合嵌入预测。」这种联合训练将使模型有机会弱化与任务无关的细节、保留动作解码所需的信息,从而在学习过程中形成面向控制的紧凑表征。
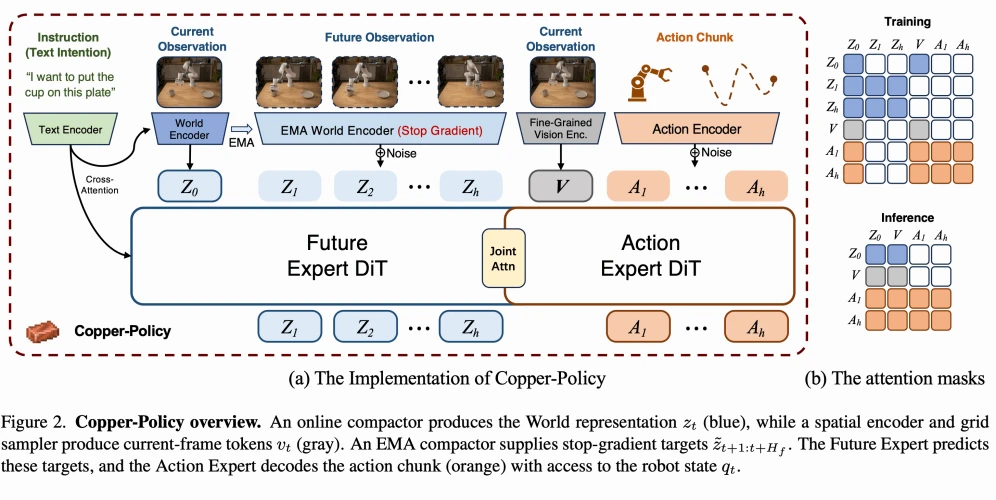
未来专家主要从紧凑世界表征学习未来演化,动作专家则额外读取当前帧视觉细节和机器人状态,不直接读取生成的未来 Token。与将世界信息和动作同等处理的方法相比,这种非对称设计更强调各司其职。
训练时,真实未来帧并不直接作为像素级预测目标。为了降低表征坍塌的风险,Copper-Policy 使用通过 EMA 缓慢更新的目标编码器,将未来画面压缩成目标表征,再由当前表征生成预测并与目标对齐。如果目标端和预测端同步快速调整,模型就可能找到不需要学习有效信息的捷径,使表征失去意义。
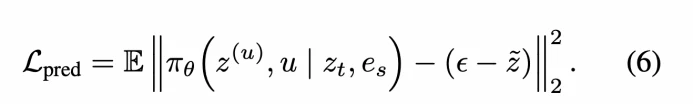
在训练方式上,Copper-Policy 采用条件流匹配(Flow Matching),分别对未来表征预测和动作生成进行监督。未来专家学习预测紧凑空间中的未来表征,动作专家则负责生成动作,两者通过联合优化,共同塑造服务于控制的世界表征。推理阶段,模型无需显式生成未来表征,而是由动作专家直接完成动作解码。
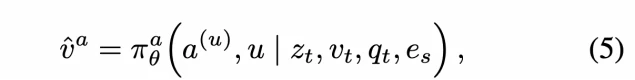
由于未来专家 DiT 负责预测表征的时间演化,动作专家 DiT 负责生成动作,两者要通过联合注意力交换信息,在推理时,动作专家不直接依赖生成的未来表征,未来预测则主要通过训练阶段塑造的表征来帮助控制。训练阶段,两条损失共用一次反向传播,动作损失也会反向影响世界表征编码器,使其更倾向于保留抓取、对齐和放置等操作所需的信息。
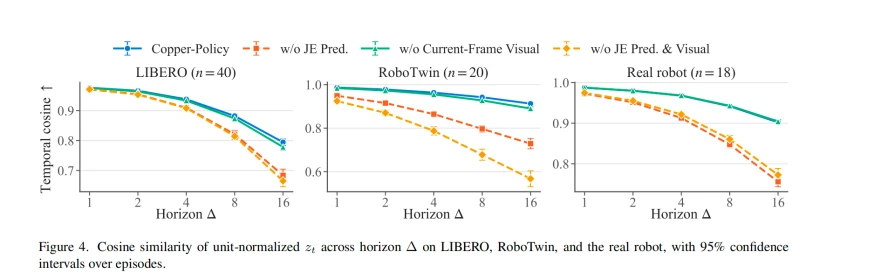
于是可以看到,在相隔 16 帧的表征相似度测试中,Copper-Policy 的相似度随时间下降得更慢,表现出更好的时间稳定性。
另一个值得关注的问题是:模型能否将任务相关变化与环境扰动区分开?Copper-Policy 团队认为,关键不在于消除扰动,而在于把它分离出去。
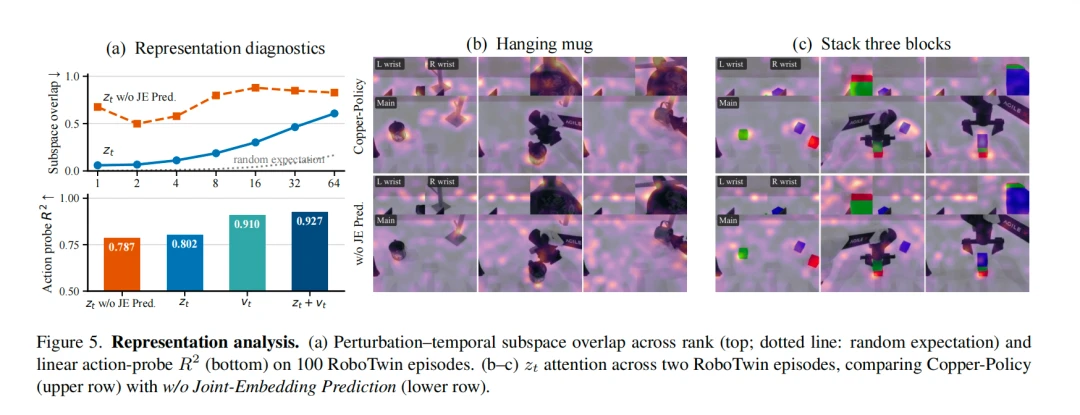
团队分别计算任务变化与环境扰动在表征空间中的主要方向,并比较两者的重叠程度。结果显示,加入联合嵌入预测之后,在秩为 8 时重叠度非常低,而当没有这个目标时,重叠度会在 50% 以上。这就是说,扰动严重影响了整个场景的语义。Copper-Policy 的模型没有把扰动「抹除」,而是在隐空间里把它分配到了不同的轴上。随着任务进行,场景也随之变化。经过 Token 层面的联合嵌入预测得到的抽象表征,对噪声、光照、初始状态,以及相机抖动等因素的扰动影响得到显著改善。换言之,这样处理过后,Copper-Policy 的抗干扰性更好,也就是更鲁棒。
实测效果如何
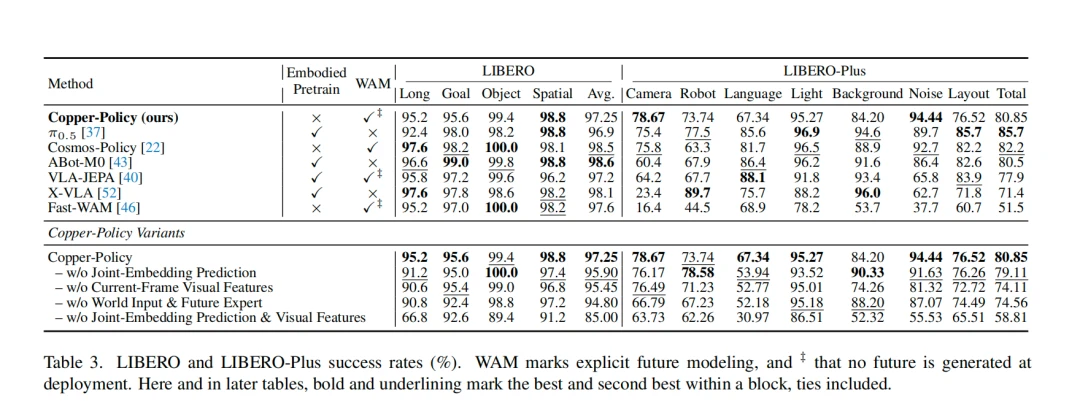
仿真测试显示,在标准 LIBERO 及 LIBERO-Plus 上,Copper-Policy 总体发挥了明显较好的表现。虽然没有经过具身预训练,但其在物体和 Spatial 任务上的成绩优于 π0.5,其他任务与 VLA-JEPA、X-VLA 等经过具身预训练的模型也有一定竞争力。而在 LIBERO-Plus 的相机与噪声扰动测试中,Copper-Policy 在相机与噪声扰动下表现出较强的鲁棒性。语言指令跟随则是其表现相对薄弱的部分。
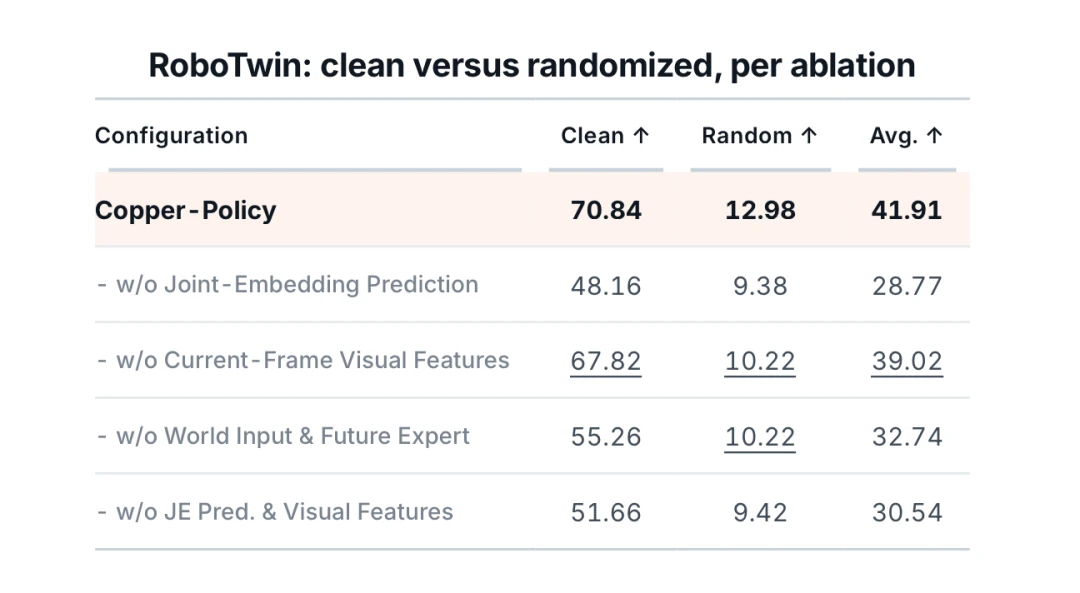
在 RoboTwin 干净场景中,Copper-Policy 以 70.84% 与 π0.5 的 70.70% 接近;在综合干净与随机化场景,其平均成绩为 41.91%,在未做具身预训练的方法中排第一,领先 EventVLA 的 40.65% 和 Fast-WAM 的 39.85%。不过,强随机化条件下,当布局、干扰物、背景、光照同时改变,Copper-Policy 的性能仍明显下降。
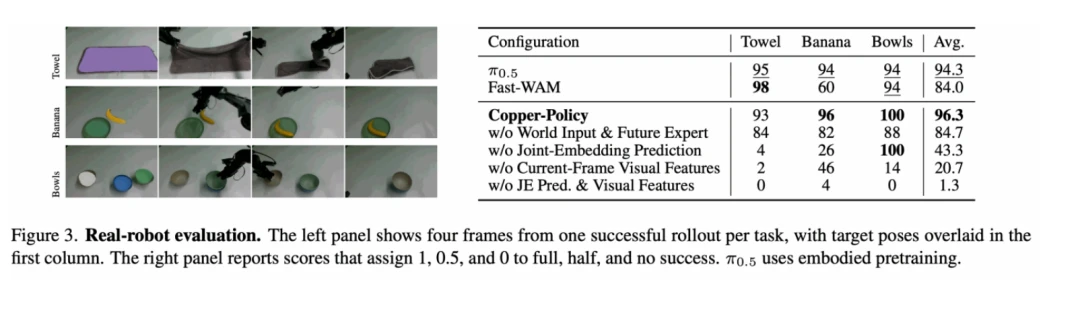
三项真机任务上,Copper-Policy 取得了 96.3% 的平均成功率,普遍高于 π0.5 和 Fast-WAM。拆分任务发现,Copper-Policy 在放香蕉、摆放碗这两项任务上优势显著,而在叠毛巾任务上略逊色于 Fast-WAM。这些结果说明,该方法在部分真机操作中具有优势,但在长时域的可变形物体操作上仍有提升空间。
冯泽欣认为,对 VLA、WAM 的研究者来说,有些事情「做对」比「做好」更重要。良好的代码基础与实验设置可能显著影响最终成绩。
「所以仿真测试发现分数不高,有时候并不是模型的设计有缺陷。Ablation 反而更能体现问题——你可以观察自己的模块是否真的带来了提升,或者进一步做探针或者 Probing 分析。至于最终分数高不高,对研究本身没有那么强的指导性。很多时候大家调的,其实是与方法无关的设置。」
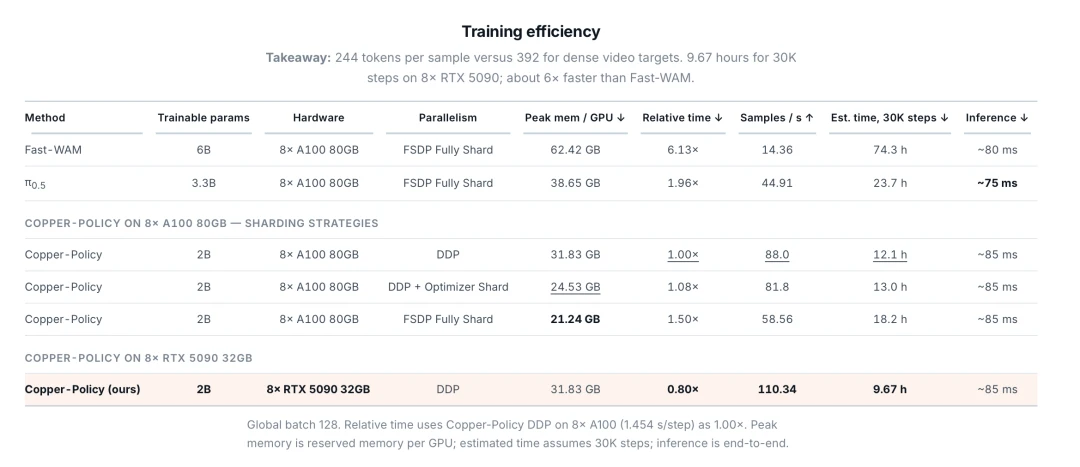
训练效率同样是 Copper-Policy 的一项优势。团队使用 8 张消费级 RTX 5090,约 9.67 小时便完成了约 2B 可训练参数模型的训练。相比部分依赖 A100 等高端算力的方案,这一成本更加利好中小型研究团队的复现与迭代。「团队最新的进展中,经过更多 Infra 相关优化,训练速度进一步提升了 30%。」冯泽欣透露道。
不过,目前的 Copper-Policy 在指令跟随上尚存在部分局限。现有训练数据多使用 Episode-Level 的任务描述,细粒度语言监督较为有限,不同评测基准的提示词与 Embedding 设置也存在差异,因此语言指令跟随仍对 Copper-Policy 构成挑战。这也是社区最近关注的问题。
「语言泛化不能靠许愿。我们不能指望 VLA 天然就能 Follow 得很好,现有后训练数据集更多是把语言当作 Condition 来用:给一个任务描述,让它打一套动作,或者执行某一种特定任务;它最后其实收敛成了一个 Task Id,学会了区分任务,但没有做细粒度的区分。这个问题也不是靠一个更强的基座模型就能解决。」
另一方面,在 Background Layout、Language 等泛化指标上,模型得分仍相对偏低。团队认为,这与缺乏具身预训练直接相关。
下一步,团队计划重点改进数据使用方式与指令跟随能力。一方面,他们希望借助更多数据检验表征的稳定性,尤其关注具身预训练是否能够进一步改善表现;另一方面,针对 Instruct Following(指令跟随),团队希望进一步有所推进,解决当前社区中 VLA/WAM 等控制模型的痛点。
让技术普惠,像铜一样
谈到近期具身智能的发展,团队认为,一些智能体策略(Agentic Policy)已经能够较好地分解任务,但仍需要可靠的执行模型。将这类策略与 VLA 或 Copper-Policy 等控制模型结合,可能是一条有价值的方向。另一种设想是:如果紧凑表征能够充分保留任务相关信息,基于模仿学习的模型也许能发展出更强的抽象能力和行动能力,最后展示出类似 GPT-3 那样的效果。无论是哪一种,冯泽欣对领域内的技术进展保持开放态度。
「我们目前的看法是 Work Is Everything,技术迭代如此快速的今天,没有必要坚定地守住某一种路线。」
**团队表示,训练效率是 Copper-Policy 值得继续发展的优势之一。他们希望在保留模型通用性的同时,进一步减少对外部复杂模块的依赖。**在这一设想下,未来的 Copper-Policy 可能更接近原生的上下文「模仿」模型,而非依赖额外的 Agent、Memory 或其他复杂组件。
「我们一直提模仿学习(Imitation Learning)这个路线:有一串专家轨迹,让它产生梯度来优化模型。如果一个模型能在不依赖梯度去模仿的情况下衍生出某种能力(类似 ICL),也是有可能的.这样的能力范式最后或许不需要后训练微调来做任务。」
**Copper-Policy 的命名也寄托了团队对技术普惠的期待。**他们希望模型能够以更低成本被复现,或被其他研究者用作基座。更长远的目标,是让具身智能研究逐步转化为人们日常生活的产品与服务,走入千家万户。
「给这项研究取名 Copper 是因为 —— 铜是人类最早被用于制作工具的金属之一。」