

蚂蚁灵波挑战赛:年轻开发者的 48 小时「真机战争」
蚂蚁灵波挑战赛:年轻开发者的 48 小时「真机战争」
11 月 14 日至 16 日,上海浦东张江科学会堂迎来了首届蚂蚁灵波具身大模型挑战赛线下总决赛。
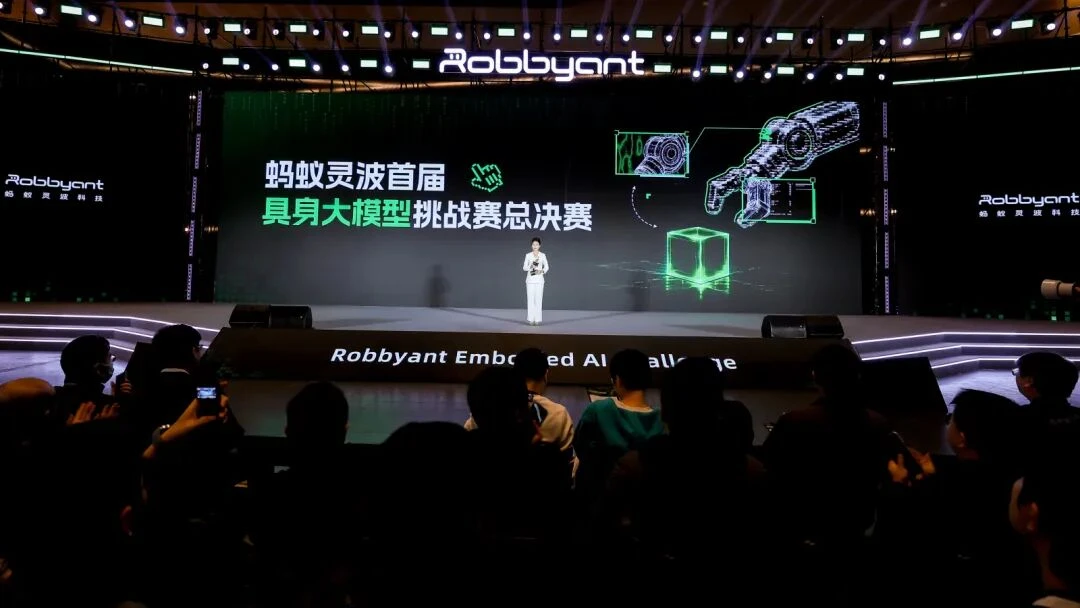
这既是蚂蚁灵波面向开发者举办的首届具身大模型挑战赛,也是迄今为止业内规模最盛的具身开发者大赛。据悉,初赛吸引来自 13 个国家的 1,855 支队伍、3,252 名顶尖高校选手报名,所在单位包括中国内地及香港,以及美国、英国、德国、新加坡、澳大利亚、瑞典和日本。总决赛 48 小时内,15 支队伍在开源模型 LingBot-VLA 2.0 和统一设备上采集数据、调优模型,再上真机完成任务,共同争夺蚂蚁灵波具身大模型挑战赛的 28 万元奖金。最终,来自天津大学、深圳福田实验室的吴昊楠带领 TARS团队获得本次赛事冠军。
为了让开发者最大限度地投入具身模型的真机开发,蚂蚁灵波为参赛者提供了基础设施层面支持。所有选手都得到了真实机器人平台、数采设备、任务物料、标准预采数据集和边缘推理算力资源支持,在规定时间内完成模型调优、部署调试和任务评测,让开发者在初赛期间的想法能够在现实中「跑起来」。蚂蚁灵波还在现场为一众开发者提供了解压道具和可供短暂休憩的场所,帮助开发者减缓开发压力。
本次开发者挑战赛现场有哪些亮点,48 小时黑客松究竟为一众参赛者带来怎样的体验?42 号电波走入 16 日蚂蚁灵波具身大模型挑战赛暨首届开发者大会现场一探究竟。
截然不同的开发者们
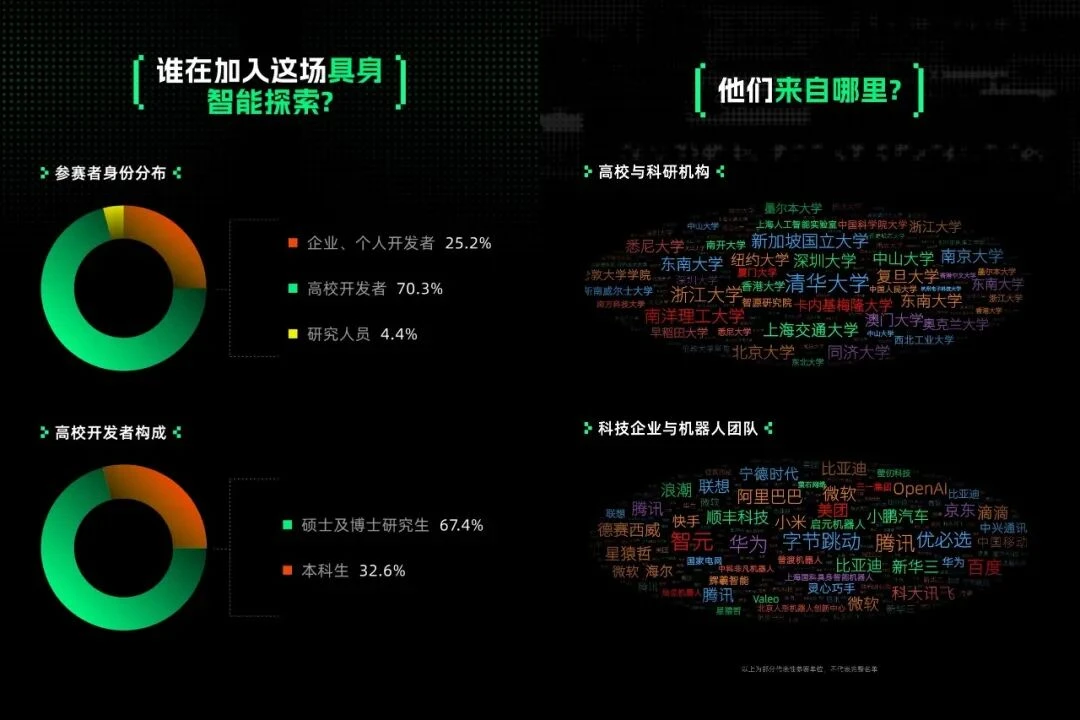
参赛者画像显示,高学历人才的集中参与成为本届赛事选手画像的一大亮点。其中,硕士及博士研究生为主力,另有企业、个人开发者,以及高校研究人员进入决赛。不仅如此,部分开发者本身就来自阿里巴巴、字节跳动、腾讯、微软、小鹏、宇树、智元()等头部科技企业与机器人企业,其中不少人已在视觉—语言—动作模型(VLA)、多模态大模型、深度学习、强化学习、真机调试等方面具备不少经验。出于不同的因缘际会,很多年轻的开发者走到了一起,尽管其中一些人此前甚至素不相识。
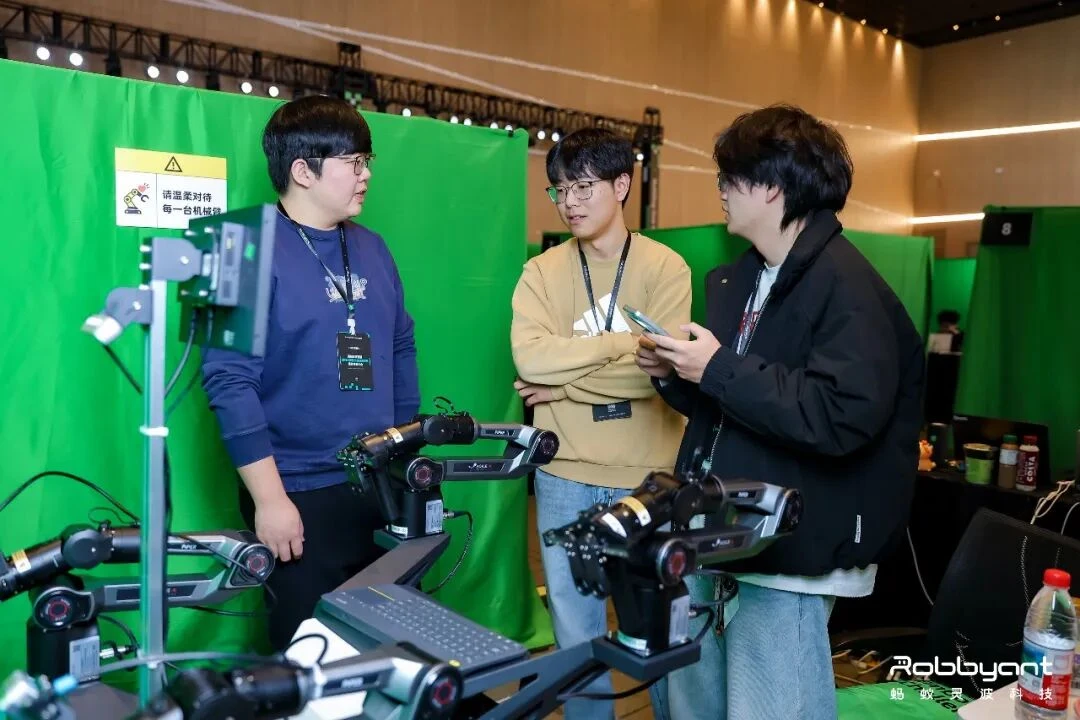
「EVA」是一支横跨北京、武汉、深圳三地的云端联军。队长武显瑾是华科博士一年级学生,目前正在北京一家科技企业实习,队友包括华科博士方珩,以及远在清华深研院的张昱。
三人曾在同一学校求学,本科毕业后各奔东西,各自在算法领域深耕,几人在推理优化、大模型数学推理及视觉方向积累了丰富的实战经验,彼此惺惺相惜。由于分处异地,初赛时,三人构建了一套精密的分布式协作机制:张昱负责前线真机数据采集,武显瑾主导模型训练与全量微调,方珩则协助进行后续的数据处理与验证。
「我们分开很久了,彼此还有联系,因为这个比赛,深厚的同窗情谊和对技术的热爱让我们重又走到一起。」
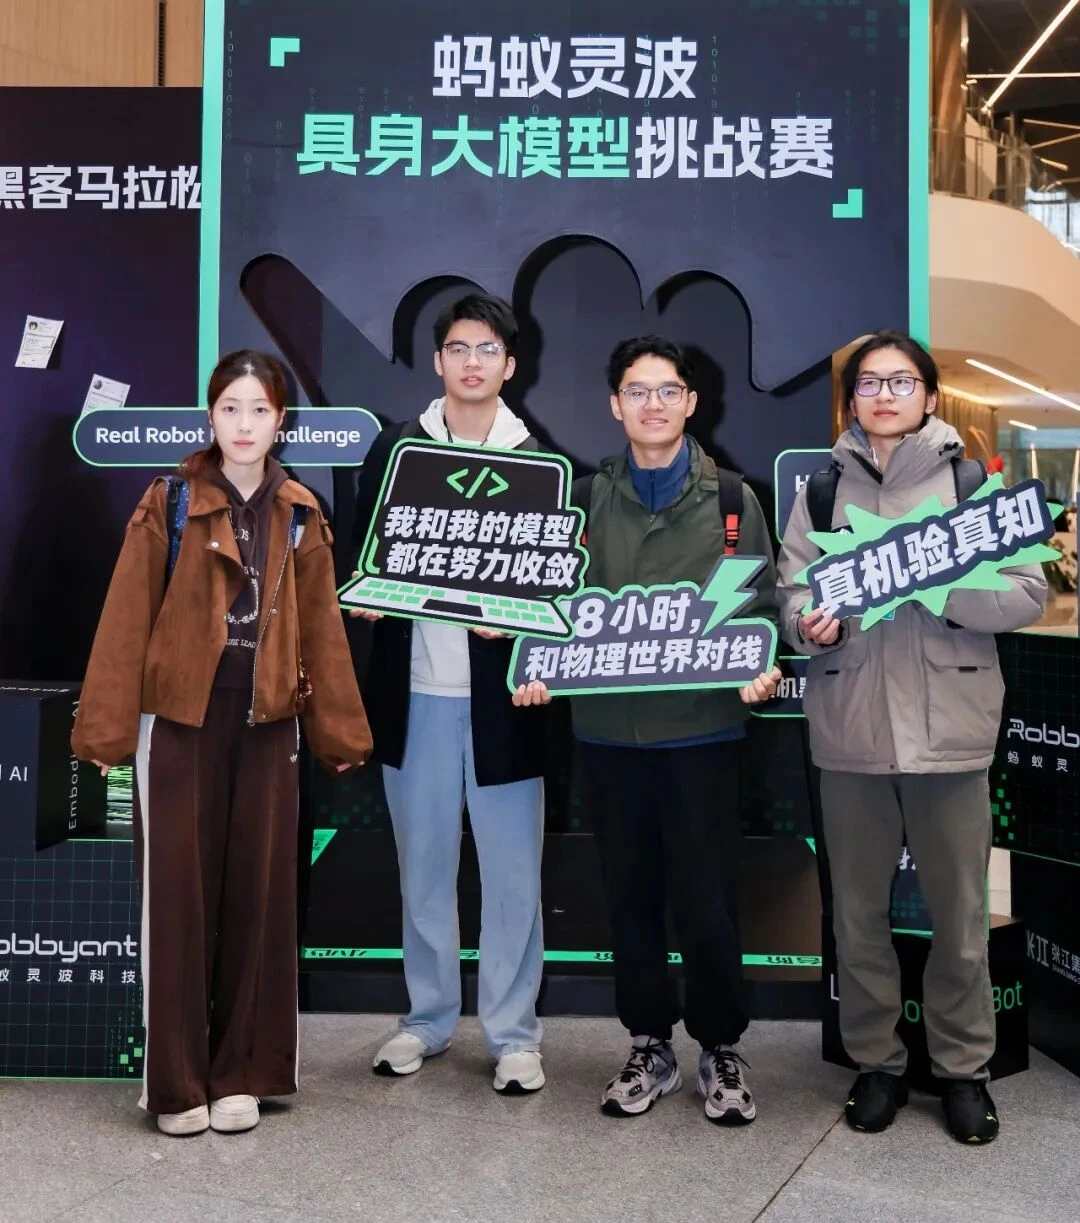
对 VLA 真机技术的好奇同样让陈森、陈欣、庄子硕、朱亚琨加入了这场黑客松。陈森是同济大学计算机学院直博一年级学生,四人都属于同济大学博士生导师宾燚的课题组。他表示,课题组在具身方面刚刚起步,虽然已经在仿真方面形成了 GeoAAC 等方面的成果,但他们此前从未参加过黑客松这类时间紧、需要高密度输入与输出的技术赛事,「我们之前也在真机上测试过 GeoAAC,但是没黑客松那么紧张。我们希望通过这种形式把真机整条流程快速跑通,有更多收获。」
在三个表现均不错的团队中,同济 VIDA 是一个颇具沉稳特色的团队。在初赛中,团队曾凭借 GeoAAC 的视觉工作成果让模型成绩挺进决赛,这份成果在紧锣密鼓的限时开发中有着奠基作用。陈森认为,用视觉提示来做数据增强的路径非常有效。团队在决赛的第一、二项任务中将需要抓取的物体用bbox框选出来,特别在第二项任务中,还将透明化妆盒需要放置的层级框起来,这些技术巧思均取得了很好的效果。「在放东西环节,如果处在抓取阶段,确定性比较强,就可以把 Action 长度放长一些,减少推理过程中的时间和开销;而到了对接环节,需要精确操作和比较快的伺服闭环,就要相应缩短。这些都让我们对自己的工作更有信心。」
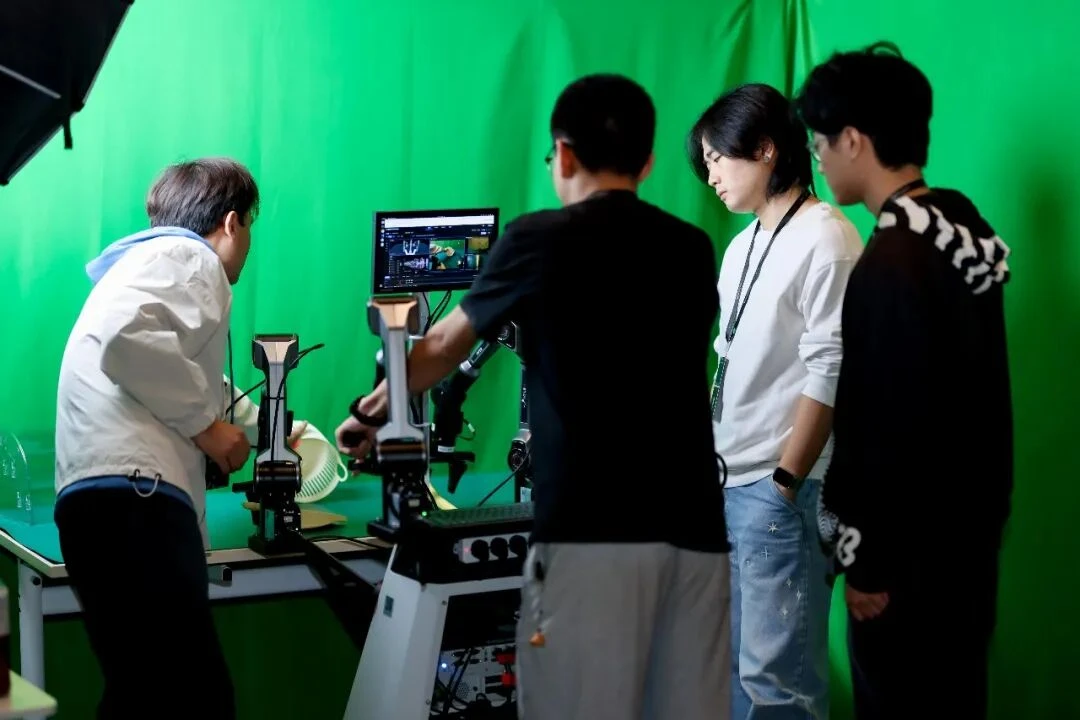
在众多的开发者队伍中,不乏受缘分驱使、因信任团结到一起的年轻人。这支以经典科幻电影《星际穿越》()中的机器人为名的「TARS」战队由天津大学的吴昊楠在网上发起而成,比赛初期,吴昊楠独自承担了繁重的仿真工作。直到 10 月下旬,他和室友白奇立组队,凭借初步取得的亮眼成绩,在社交平台上招募到了西北工业大学王晓腾、天津大学李浩浩,以及拥有多年工作经验的普渡机器人工程师顾睿成。
团队成员的性格不尽相同。王晓腾和顾睿成性格更加活跃,除了投入算法探索与工程优化,也时刻关注社交平台和官方交流群的动态,及时为团队带来其他队伍的最新战绩与赛事规则变化。李浩浩和白奇立则更多时候习惯于安静地做自己的工作。虽然性格各异,但几人都积极参与技术工作,在算法思路验证、模型训练与推理优化等方面相互配合,也在遇到困难时相互鼓励,最终携手拿到了决赛的入场券。
「我当时想参加,已经跑出了一定的成果,召集室友和网友,很快就走到了一起。我们是非常高效的一个团队。」
多方焦灼、意外时刻
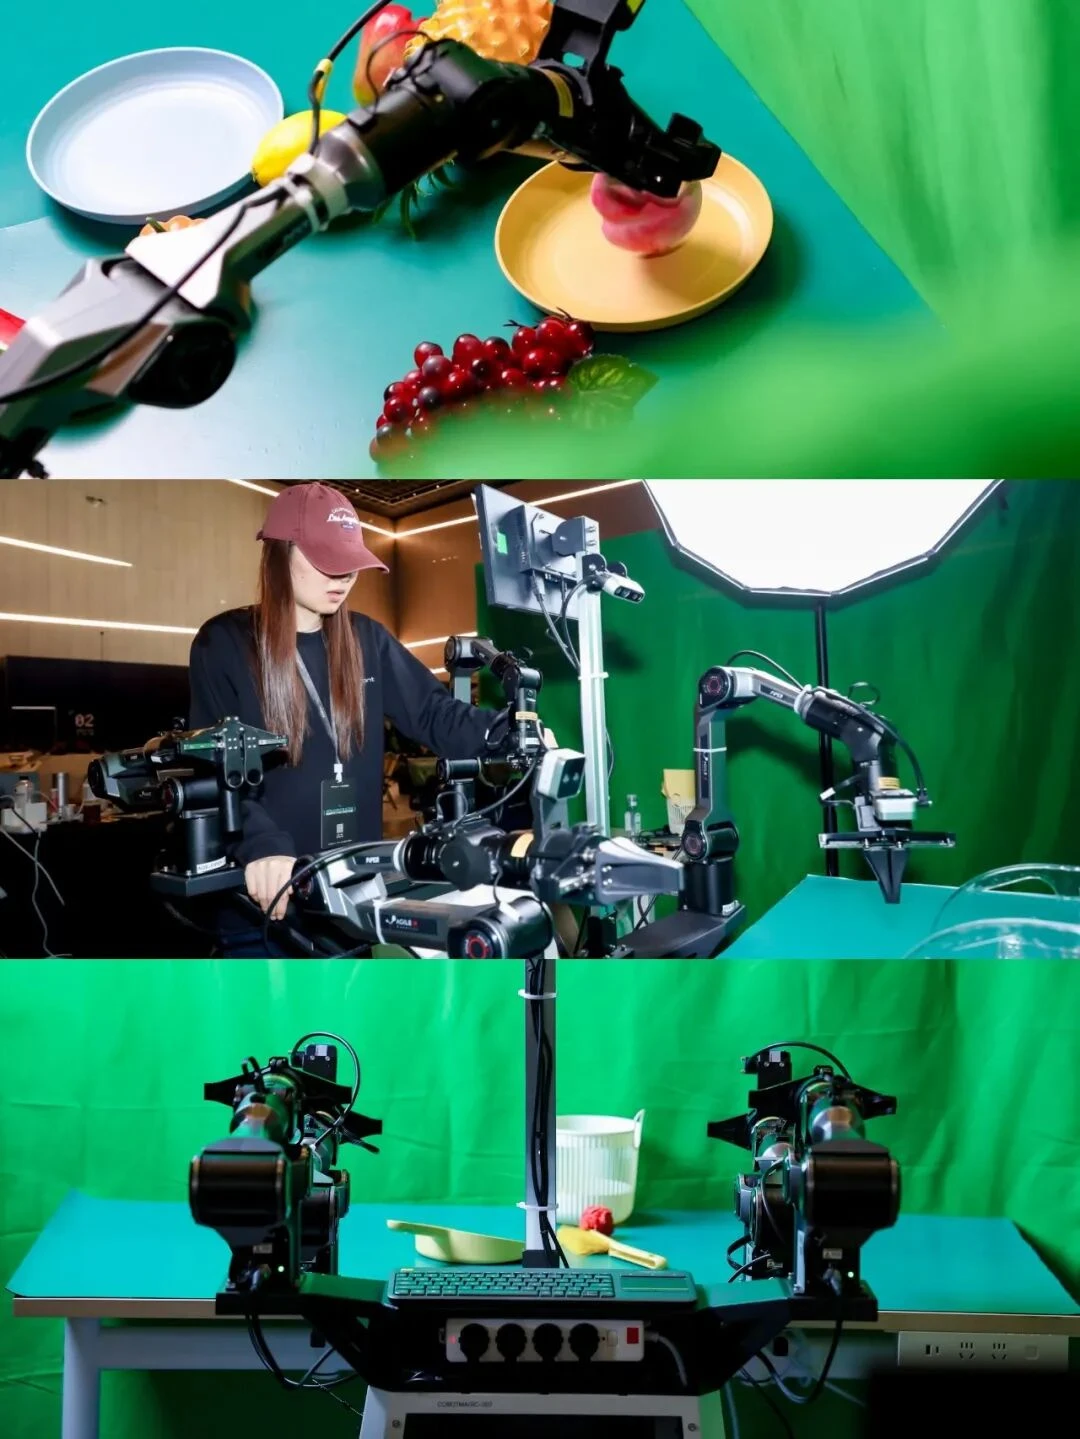
真机部署是这次赛事最大的技术焦点。与初赛不同,决赛告别仿真,进入了真机比拼,难度完全不同。 48 小时内,开发者要深度上手开源 VLA 模型,在统一任务范式与真实机器人场景下完成模型调优、部署和调试。机器所需要完成的任务分别为识别指定果蔬放入果盘、收纳透明分层化妆盒、将垃圾扫入簸箕并放入垃圾桶。组委会根据机器人在现场完成任务的表现打分,总共有三轮提交测评机会。
然而,每种任务均存在分布于数据集之外的情况,如,数据集的果蔬中恰好缺乏任务指定水果,化妆盒层次不分明、垃圾桶数据缺失,对参赛团队均造成不同程度阻碍。同时,真机部署中的经典难题,如光照变化、相机和机械臂的夹爪与物体的实际接触等真实干扰因素,也会影响团队的实际表现。
受访团队均提到决赛的难度之大。「第一个困难是真机和仿真的区别比较大。真机上会遇到很多真实场景的问题:场景可能会有偏移,推理和训练的数据对不上,效果就会掉下来;物体、机械臂本身也可能出故障。仿真里不会有这些问题,真机只能一点点去解决;第二个困难是人少、时间紧、任务重。要把数据量堆上去,采集的基线必须先打牢,手也得练熟。」
蚂蚁灵波首席科学家沈宇军在采访中表示,由于 48 小时的黑客松有着巨大不确定性,他一度担忧这次办赛是否能够取得较好效果。「我们最初担心这个时间对于不够熟悉 VLA 的外部开发者来讲是否太过紧张,万一最后大部分都是 0 分或者分数特别低,那就尴尬了,这样也会打击开发者们的信心。现在从结果来看,其实还不错。」
焦灼阶段发生在比赛中程。在三个具有代表性的开发者团队中,陈森是首个明显遭遇紧张时刻的小组负责人。
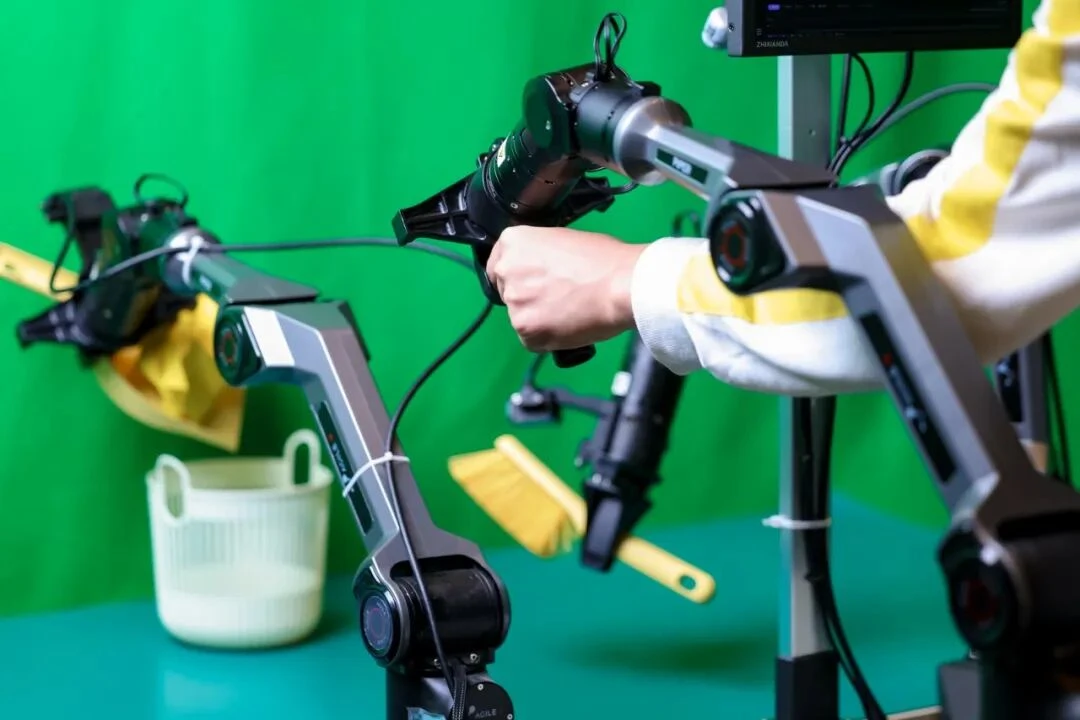
攻克前两项任务后,VIDA 团队一度在第三项任务(即双臂操控将垃圾扫入簸箕,再倒入桶内)犹豫不决。「赛前看到任务,我们就想到这个任务的关键问题:官方提供的数据集里只有抓着簸箕把柄的数据,实际上这种夹持方式很有可能是抓不住簸箕的,真实情况中会松动。」
陈森表示,他过往参加其他开发赛事时,也会遇到数据脏、需要剔除的问题,但由于这次的数据集看着似乎没什么问题,团队一度在紧张中陷入犹豫,难以抉择。一番集体讨论后,VIDA 团队还是没忍住官方数据集的诱惑,把第三个任务按照数据集的样子训了上去。数据一旦进入模型、形成分布,再想改变就需更多的数据训练才能把权重追回来。这也意味着要付出更多的沉没成本。
此时,团队又想回头。朱亚琨、庄子硕提出,将动作从拿簸箕边框调整为用另一只原本拿扫帚的手去抓垃圾桶,通过拉近物体距离来让倾倒动作更好完成。尽管如此,因为技术层面的犹豫,团队不愿抛弃已有数据,追加训练的改动并没有过多奏效。此时距离二人想法提出已过去了 10 个小时,团队最终在星期日下午提交了第三轮测试,以 63.40 的成绩获得第四名。
陈森表示,原有那批比较脏的数据接近 9,000 步,追加数据只多训了 1,000 步左右,总共 1,500 到 2,000 步。要把原来走歪的路扳回来,这样的训练量远远不够,「沉没成本太大了」。他还认为,这次参赛,团队对数据的处理不够好,如果数据更多、更干净,结果肯定还可以更好,甚至赛事期间,供他们使用的整条机械臂还出现了损坏,只能换一条新的。
「大家比较沮丧,现在想来,我们一开始就应该坚持自己的判断,不能犹豫,后面发现第四名成绩还不错,所以就还好。」
TARS 队长吴昊楠同样察觉到了第三个任务的技术难点,但与 VIDA 不同的是,他在推进策略上更大胆、更跳脱。面对现场提问,吴昊楠详细解释了这种做法背后的考虑。
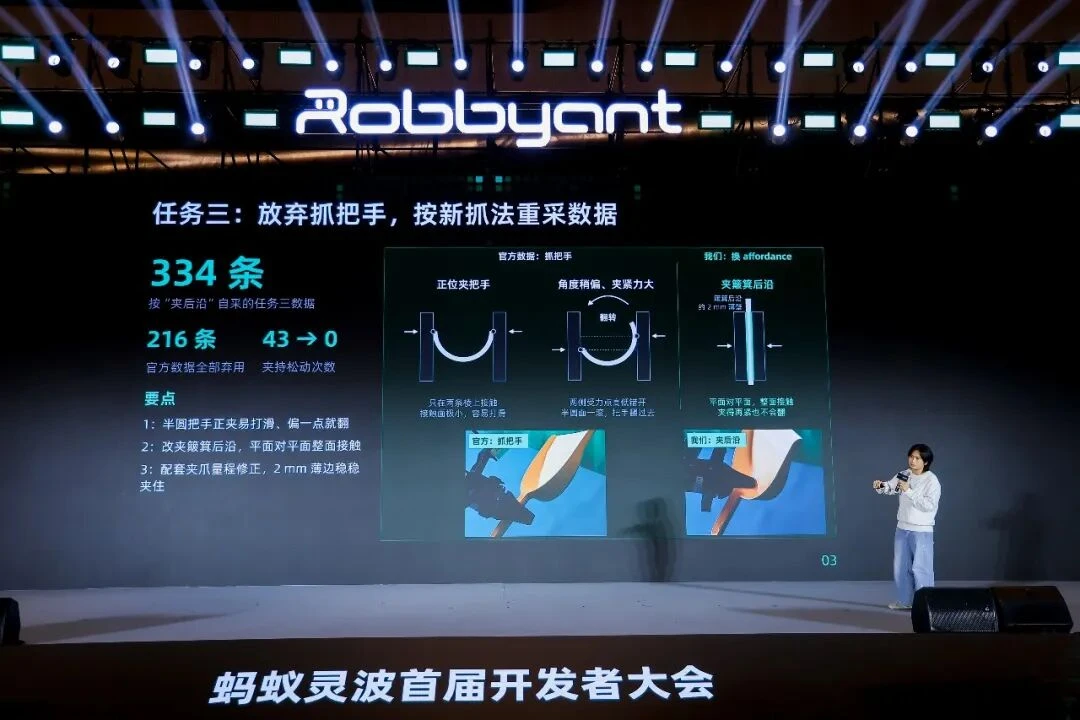
他认为,大赛提供的标准数据集固定了夹爪的抓取姿态,而这种器具不利于抓取手柄细长的簸箕。由于所有数据都是按照一个正把位去采,夹爪与物体的实际接触面很小,角度一旦稍偏、力度变化,夹爪重心就会变化,造成侧翻。因此,TARS 采取了针对性的通关策略,将整个团队数据管线的产量全都放在任务三上面,重新采任务三的数据。团队利用矿泉水等周遭物品进行重物测试,从而对抓取簸箕的力度进行对照调整。在他说服下,团队直接放弃了官方给予的数据集,最终按照自己的方法形成了 334 条更适配任务的新数据用于少样本训练。
可见,他更关注数据的有效性。如果数据本身的 Affordance 存在明显问题,那么还不如不用。「最辛苦的是数据采集和素材分配,本身是一件很重复的事,手指都会疼,需要不停地讲、不停地示范,大家都很辛苦。另一件事是在方法上分工配合:如果只是让他们 24 小时不停地造数据,反而更难。我们用的数据量其实比别人少——别人官方给 200 条,自己再造 200 条,我们只用 300 条就把问题解决了。」
提到 VIDA 与 TARS 所遇到的共性问题,吴昊楠表示,TARS 察觉到数据集存在问题后果断换了方案。关键点在于,VIDA 与 TARS 团队虽给出了相同判断,但二者之间存在约三小时的时间窗口。在竞争中,这种时间窗口对成败常常起到决定性的作用。「当时我的模型只跑了一百多步就发现了问题,他们比我晚两三个小时,已经跑了五六百步,沉没成本就摆在那里,越往后越难做这个决定。一方面队友信任我,二是运气确实比较好,我们稍微早一点发现了问题。」
参赛期间,他的心态总体保持沉稳。尽管团队的第二轮、第三轮提交均卡在了星期一早上的 6 - 8 点与 8 - 10 点,堪称「压线提交」,但没有很多让他真正紧张的时刻。
他还坦言,有相当一部分技术考虑来自于「直觉」。由于初赛和决赛时间均十分紧张,团队有时不得不依靠在研究中积累的直觉「赌」出一套训练配方。期间,一次由 Codex 引发的参数设置偏差使训练配置意外偏离了官方推荐的配方,却在随机场景下取得了出乎意料的效果。团队随后通过实验验证了这一发现,并将其保留在后续训练方案中。凭借此前在小鹏机器人、影石等企业的实习经验,吴昊楠解决实际工程问题的直觉更加敏锐。在小鹏机器人实习时,他就遇到过与任务三相似的 Affordance 问题。比如,在对窗帘这种物体进行数据标注时,到底应该给模型打整个窗帘的框,还是只关注手要交互的那一小块?他早有思考。
「Affordance 问题的根源,是人的理解和机器人的理解之间的差异。有了这种经验,形成直觉,再看比赛里的场景,很快就能想到,哎?这个问题我以前遇到过。」
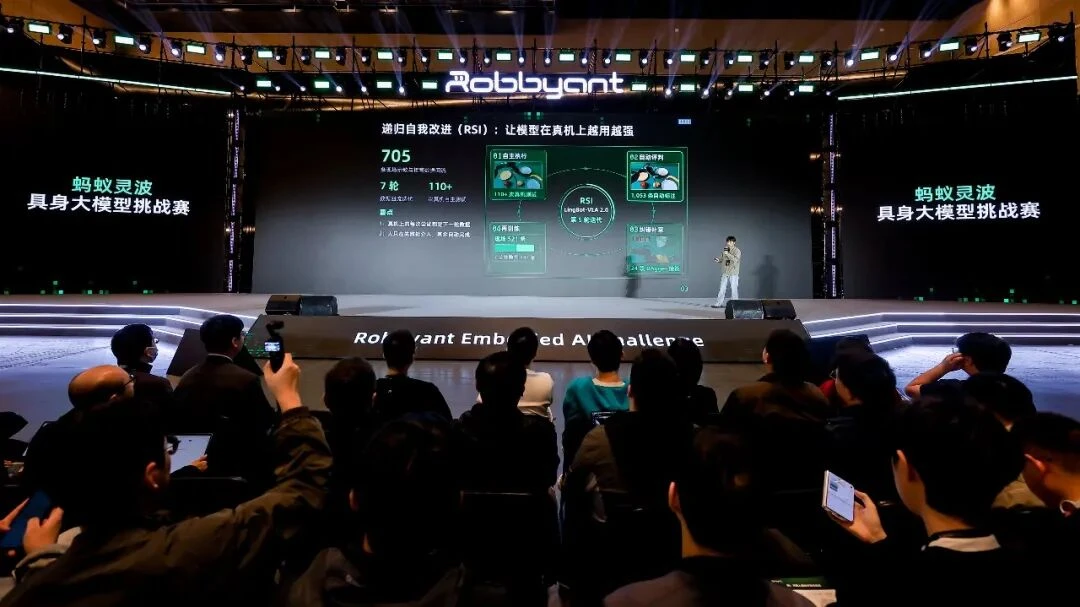
同样的紧张时刻也在 EVA 团队的 RSI 迭代当中有所表现。张昱表示,团队第一次采了一批数据拿去做推理,专门收集那些模型在某些场景下表现比较差的样本,再把这些样本混进数据里续训,以专门解决这些短板,得到一版新模型,再推理,这样慢慢迭代。但实际过程中,团队发现第一版 RSI 的效果不太好。武显瑾最开始认为,原因可能发生在模型、推理端代码、数据和场景对齐等多方面。「刚开始比较迷茫,不知道问题到底在哪,只能一点一点排查。」
于是,武显瑾等人选择先在离线评测上看模型端,发现模型端没什么问题,再看真机,最后定位到真机推理这个环节有问题。解决后,团队进一步扩大数据训练量,形成约 700 条现场示教,才有了第二轮 74.77 的成绩。
常规的,与非常规的
蚂蚁灵波市场运营及技术生态负责人江波认为,本次赛事的设置有意地考察选手的综合能力,数据训练、模型微调、工程任务、Infra 工程等均更加贴近实际场景需求。另一方面,时间限制、现场突发状况也考察开发者团队面对常规之外的困难攻关与协作效率。由于时间限制、赛事结果带有一定偶然性,不同团队之间或出现成绩咬合紧密,或在轮次之间产生较大波动均属正常情况。
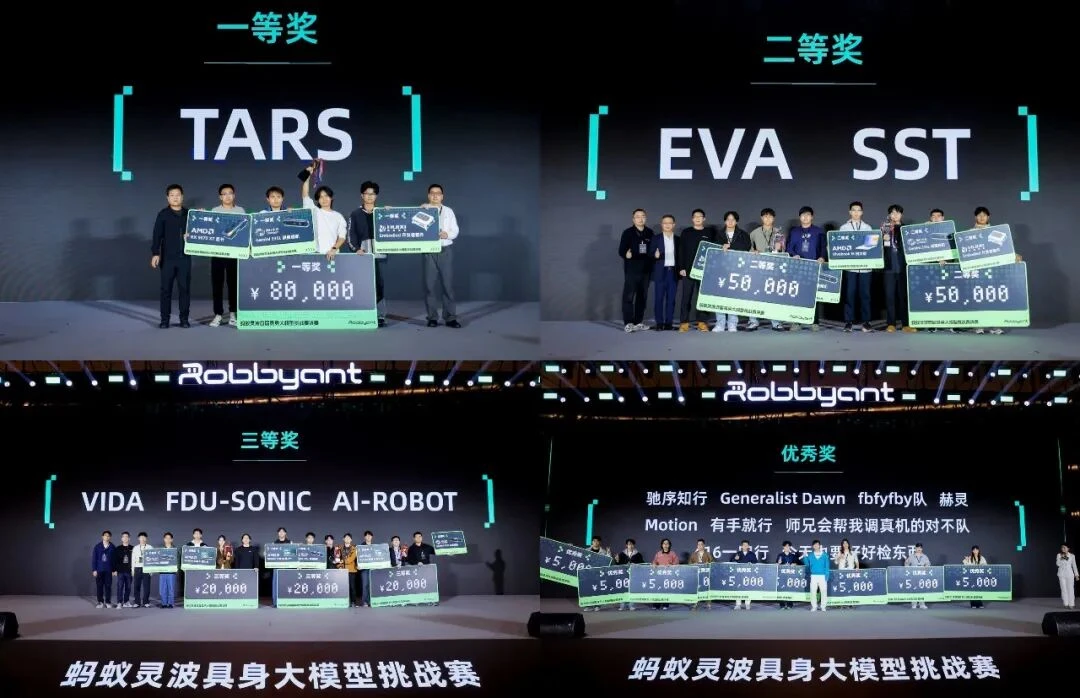
经过 48 小时的激烈比拼和多方评审,最终,吴昊楠带领 TARS 战队从 15 个团队中脱颖而出,夺得决赛冠军及一等奖,武显瑾带领的 EVA 与杨泽鸣的 SST 团队分别获得二等奖,同济 VIDA、FDU-SONIC、AI-ROBOT 分别获得本次赛事三等奖。另有 9 支队伍获得优秀奖,3 支队伍获得观察团特别奖。
本次赛事中,每一位开发者的选择截然不同,个人性格特质、专业背景与团体羁绊紧紧交织。其中,TARS 吴昊楠应被认为是一个特质尤其鲜明的人。作为 TARS 的代表性人物,他表现出了与其他团队领导者截然不同的压力反应。纵使许多技术层面的抉择事后看来有其必然性,但作出这些决定无一不需要非凡的人格魄力。在 48 小时紧锣密鼓的开发流程内,不少团队均有多种技术巧思,他们最后或采取保险方案,或选择短时间内最有效的方案,或稳扎稳打,或哪里不足补哪里、拆了东墙补西墙。同样的疲劳与压力反应下,吴昊楠突破了周遭多数人的常规思路,他仍在不断地提出新的想法,且提案有着较强的策略性:新的想法与想法之间保持着整体工程上的连续,支持一步步快速验证、最大程度降低沉没成本。这或许是 TARS 与后来者拉开足足 8 分差距的根本原因。
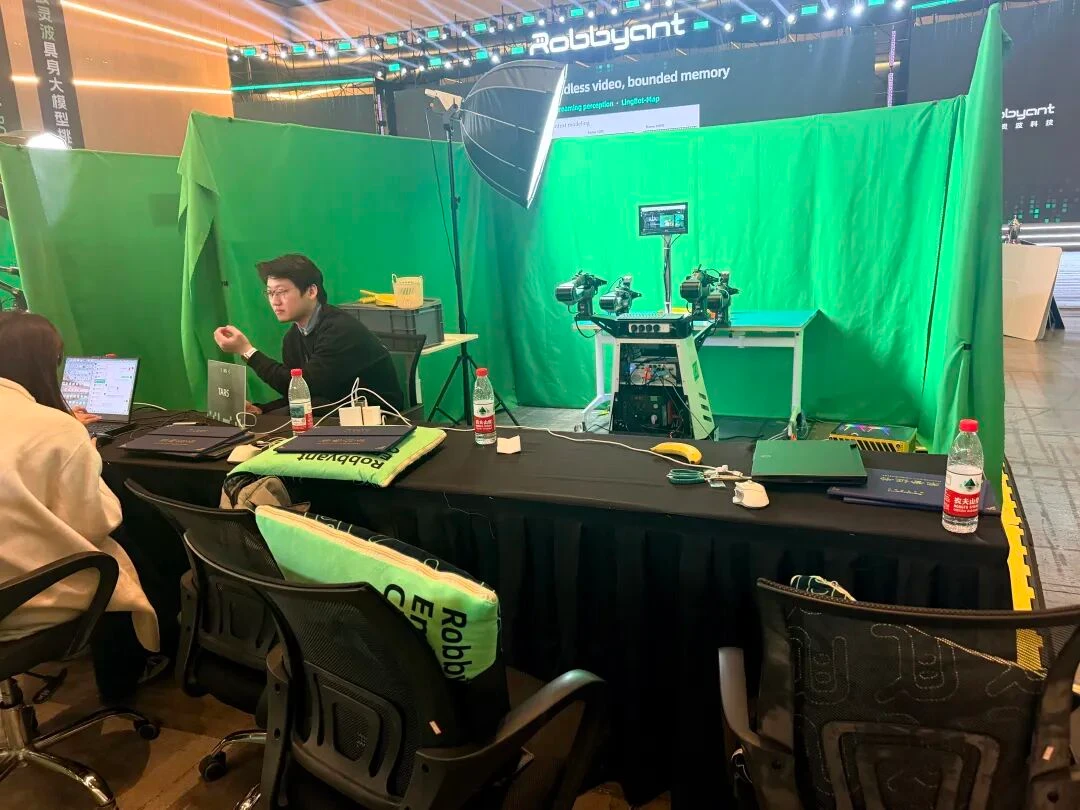
吴昊楠带着我们去了 TARS 的工作区,桌上静静摆放着他们刚拿到的荣誉证书,此时工作区已略显空荡。他表示,上午完赛后,有一些成员又匆匆收拾行囊,各奔东西。他会将这笔奖金平均分予每一位团队成员,以感谢他们对自己的信任。提到自己的奖金规划,他说会用它先交一部分在深圳生活的房租。
「我虽然租在深圳 2,000 块的城中村里,但完全不介意。我从家骑车 5 - 10 分钟就能到海边。初赛那会儿,每天晚上六七点放着实验跑,我不甘寂寞,就会去海边看日落,在那里坐一会儿。我喜欢深圳湾、前海,还有那个大梅沙半岛。」他认为,在深圳的生活一定程度上放大了他勇敢、跳脱的特质。提到这些时,他眼里闪烁着年轻开发者独有的光芒。
开发者生态与「开源精神」
建立在机器人真实场景和业界难点上,蚂蚁灵波希望能够借赛事带来更有效益的技术传播。一方面,机器人前沿技术呈高速发展,创新发生在企业内部,而另一方面,许多对技术有着好奇与热忱的外部开发者想进入该领域投身一线,首当其冲便面临算力、设备不足的资源梗阻。不少开发者反馈, LingBot-VLA 2.0 开源预训练模型「确实是一个非常好的模型,各方面有着很好的通用性,也为参赛团队保留了针对赛事进一步调优的空间」,这让参赛者可以基于领先的 VLA 开源模型直接开展训练、微调和推理优化,极大降低了开发者门槛,也让他们能够把更多精力放在真正有挑战、有意义的问题上:如何提升模型在具体任务中的表现?如何增强模型的泛化与真机表现?这种「站在开源基座上继续创新」的方式,比从零开始训练模型更容易形成实际成果,也确实吸引了众多一线的年轻开发者们。
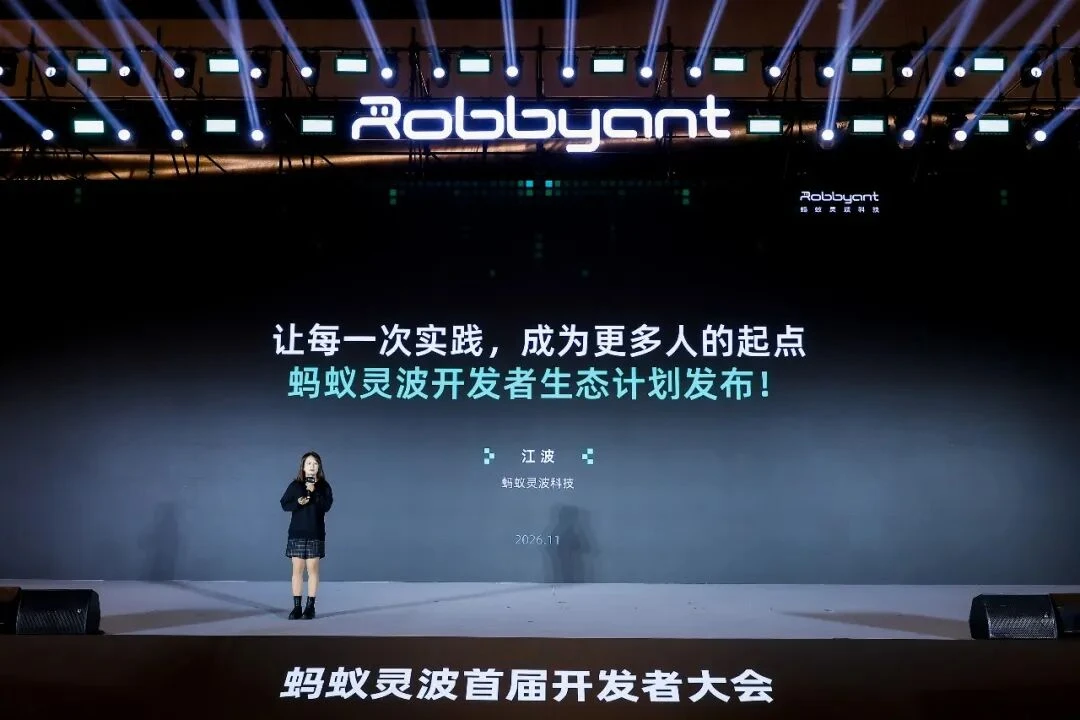
而随着 LingBot-VLA、LingBot-Vision、LingBot-World 等前沿技术投入高校、研究机构、企业的广泛应用,蚂蚁灵波已形成百花齐放的开发者生态。当日的首届开发者大会上,蚂蚁灵波发布了开发者生态计划,承诺邀请 20 位最有价值专家,支持教学与学术创新,共育具身智能人才,同时招募 40 位开发者专家,支持技术实践与专业成长,共建开发者生态,为更多投身人工智能与机器人前沿的一线开发者带去更多支持。
「我们希望实打实地支持技术社区的专家,进入真实场景、研究与课程里面,支持开发者成长、形成良性生态循环,最终帮助我们把模型迭代得更好,给行业去提供一个更强大的这个技术基座。」
蚂蚁灵波举办的首届具身大模型挑战赛在产业一线的开发者和极客的掌声中落下帷幕。不少受访团队对参赛体验给出好评并表示,这次黑客松激发技术热忱,给高校学生、研究者以及外部开发者带来极大的实战认知。如果时间更充足,不少方法不仅有显著提升空间,还间接启发了一些人接下来的研究方向。EVA 团队张昱表示,这次具身层面的比赛由于打通了数据、模型、推理、场景链条,强度虽高,但也使得他对真实场景的理解确实更深了,对他正在研究的分层 Agent 架构或许有帮助;TARS 吴昊楠表示,这次比赛让他发现了新的想法,尽管尚未在赛事中验证,他将在福田实验室开展下一步工作,沿着赛事的方向持续探索。
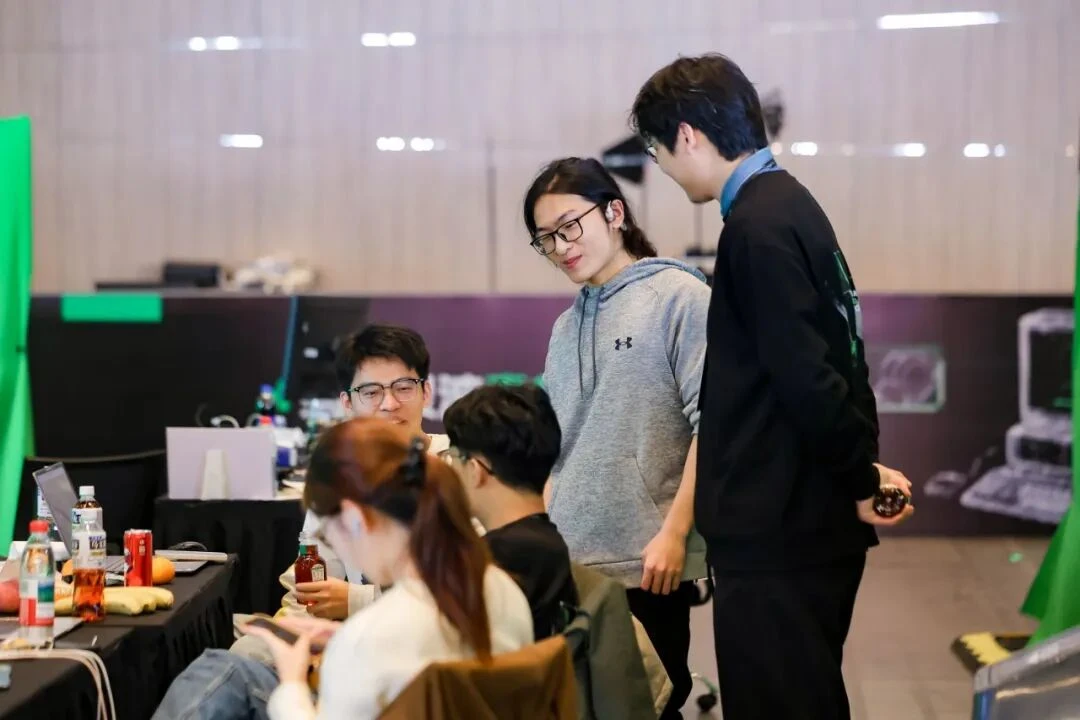
同时,VIDA 陈森亦提到,由于参赛者普遍对人工智能技术有着一致的热爱和好奇,决赛期间,团队不仅密集开展内部攻关,偶尔还会略微交流思路,「比赛中我们当然是竞争关系,但长期来看,大家都在往前沿走,那就都是同行者。另外,名次在我看来不重要,如果对方有 Insight,让我们知道一些自己不知道的东西,那这就很有价值。有些团队用的设备我不认识,那就赶紧上网去搜、去学。能看见这些比较优秀的团队使出浑身解数、各显神通,本身就是件好事。」这种良性的竞争氛围使得多数团队在高压环境下发挥了理想表现,挑战赛的平台效应亦在开发者的交流互鉴中进一步放大。
不少开发者还表达了自己的技术愿景。有的人认为,基础大模型在具身领域会有比较大的空间,通过 Agentic VLA 将基模的能力利用起来,撬动更大的具身收益很重要;也有的人认为,机器人还有形态拓展的空间,不过得先把人类这套体系做好,在真实世界中的适用性才会改善。当前,技术路线的不收敛是开发者们决定在类似的赛事上多走走看看的主要因素,即便他们此前对个别路线并不熟悉。
16 日下午,蚂蚁灵波 CEO 朱兴同样提到,对于技术尚处快速变化的人工智能产业,要让更多开发者进入行业,交流互鉴比胜负更加重要,对技术本身应持开放态度,「不要盲目乐观,也不必过度悲观」。不少开发者组成团队、初入赛事,普遍带着焦虑、自我怀疑而来:「我能够做得好吗?有那么多优秀的竞争者参与,我们能否脱颖而出?我对 VLA 并不熟悉,该怎么上手模型?......」他们都在参赛的过程中逐渐坚定。在一项众星云集的赛事中全身心地投入、经历失败,解释失败、调整战略,这种纠错经验、韧性积累和各种 know how 的沉淀对年轻的一线开发者和技术社区来说都是宝贵的经验。无论是实现具身智能体部署还是具身原生,既需要各界对开发者的技术支持与不断鼓励,也需要开发者自身具备足够勇气。我们在上海张江科学会堂的大赛现场看到了二者兼具的真实写照。
事实上,这样的开发者故事早已不止发生在赛场之内。自 LingBot 系列模型开源以来,来自美国、德国、日本、新加坡等地的高校与研究机构,已将其应用于各自的科研与教学场景,海外社区中基于 LingBot 系列的二次开发与成果复现也持续涌现。蚂蚁灵波塑造的全球开发者生态正百花齐放,或许能够进一步奠定其行业声望与长足的技术潜力。可以期待,更多年轻开发者的故事会在这一开放、技术友好的生态版图上碰擦出全新的智力火花。
发现文章有错?告诉我们