

启元具身研究中心发布 PrimeSim,探索用视频生成模型构建机器人仿真器
作者:江思奇
11 月 4 日,启元具身研究中心发布世界模型仿真器 PrimeSim,面向机器人操纵任务开展策略训练。它以预训练视频生成模型为基础,经过中训练和后训练,尝试让模型根据机器人动作指令推演环境变化。团队称,相关权重、推理代码与训练代码计划于 11 月 6 日开源。
机器人策略训练常借助仿真环境,但人工搭建场景需要投入较多工程工作。视频生成模型可以生成逼真的画面,却未必能准确响应动作,也可能无法保证不同相机视角中的物体和机器人状态一致。PrimeSim要解决的,是让生成模型不仅画面连贯,也能根据动作指令持续推演,作为策略训练和评估的仿真环境。
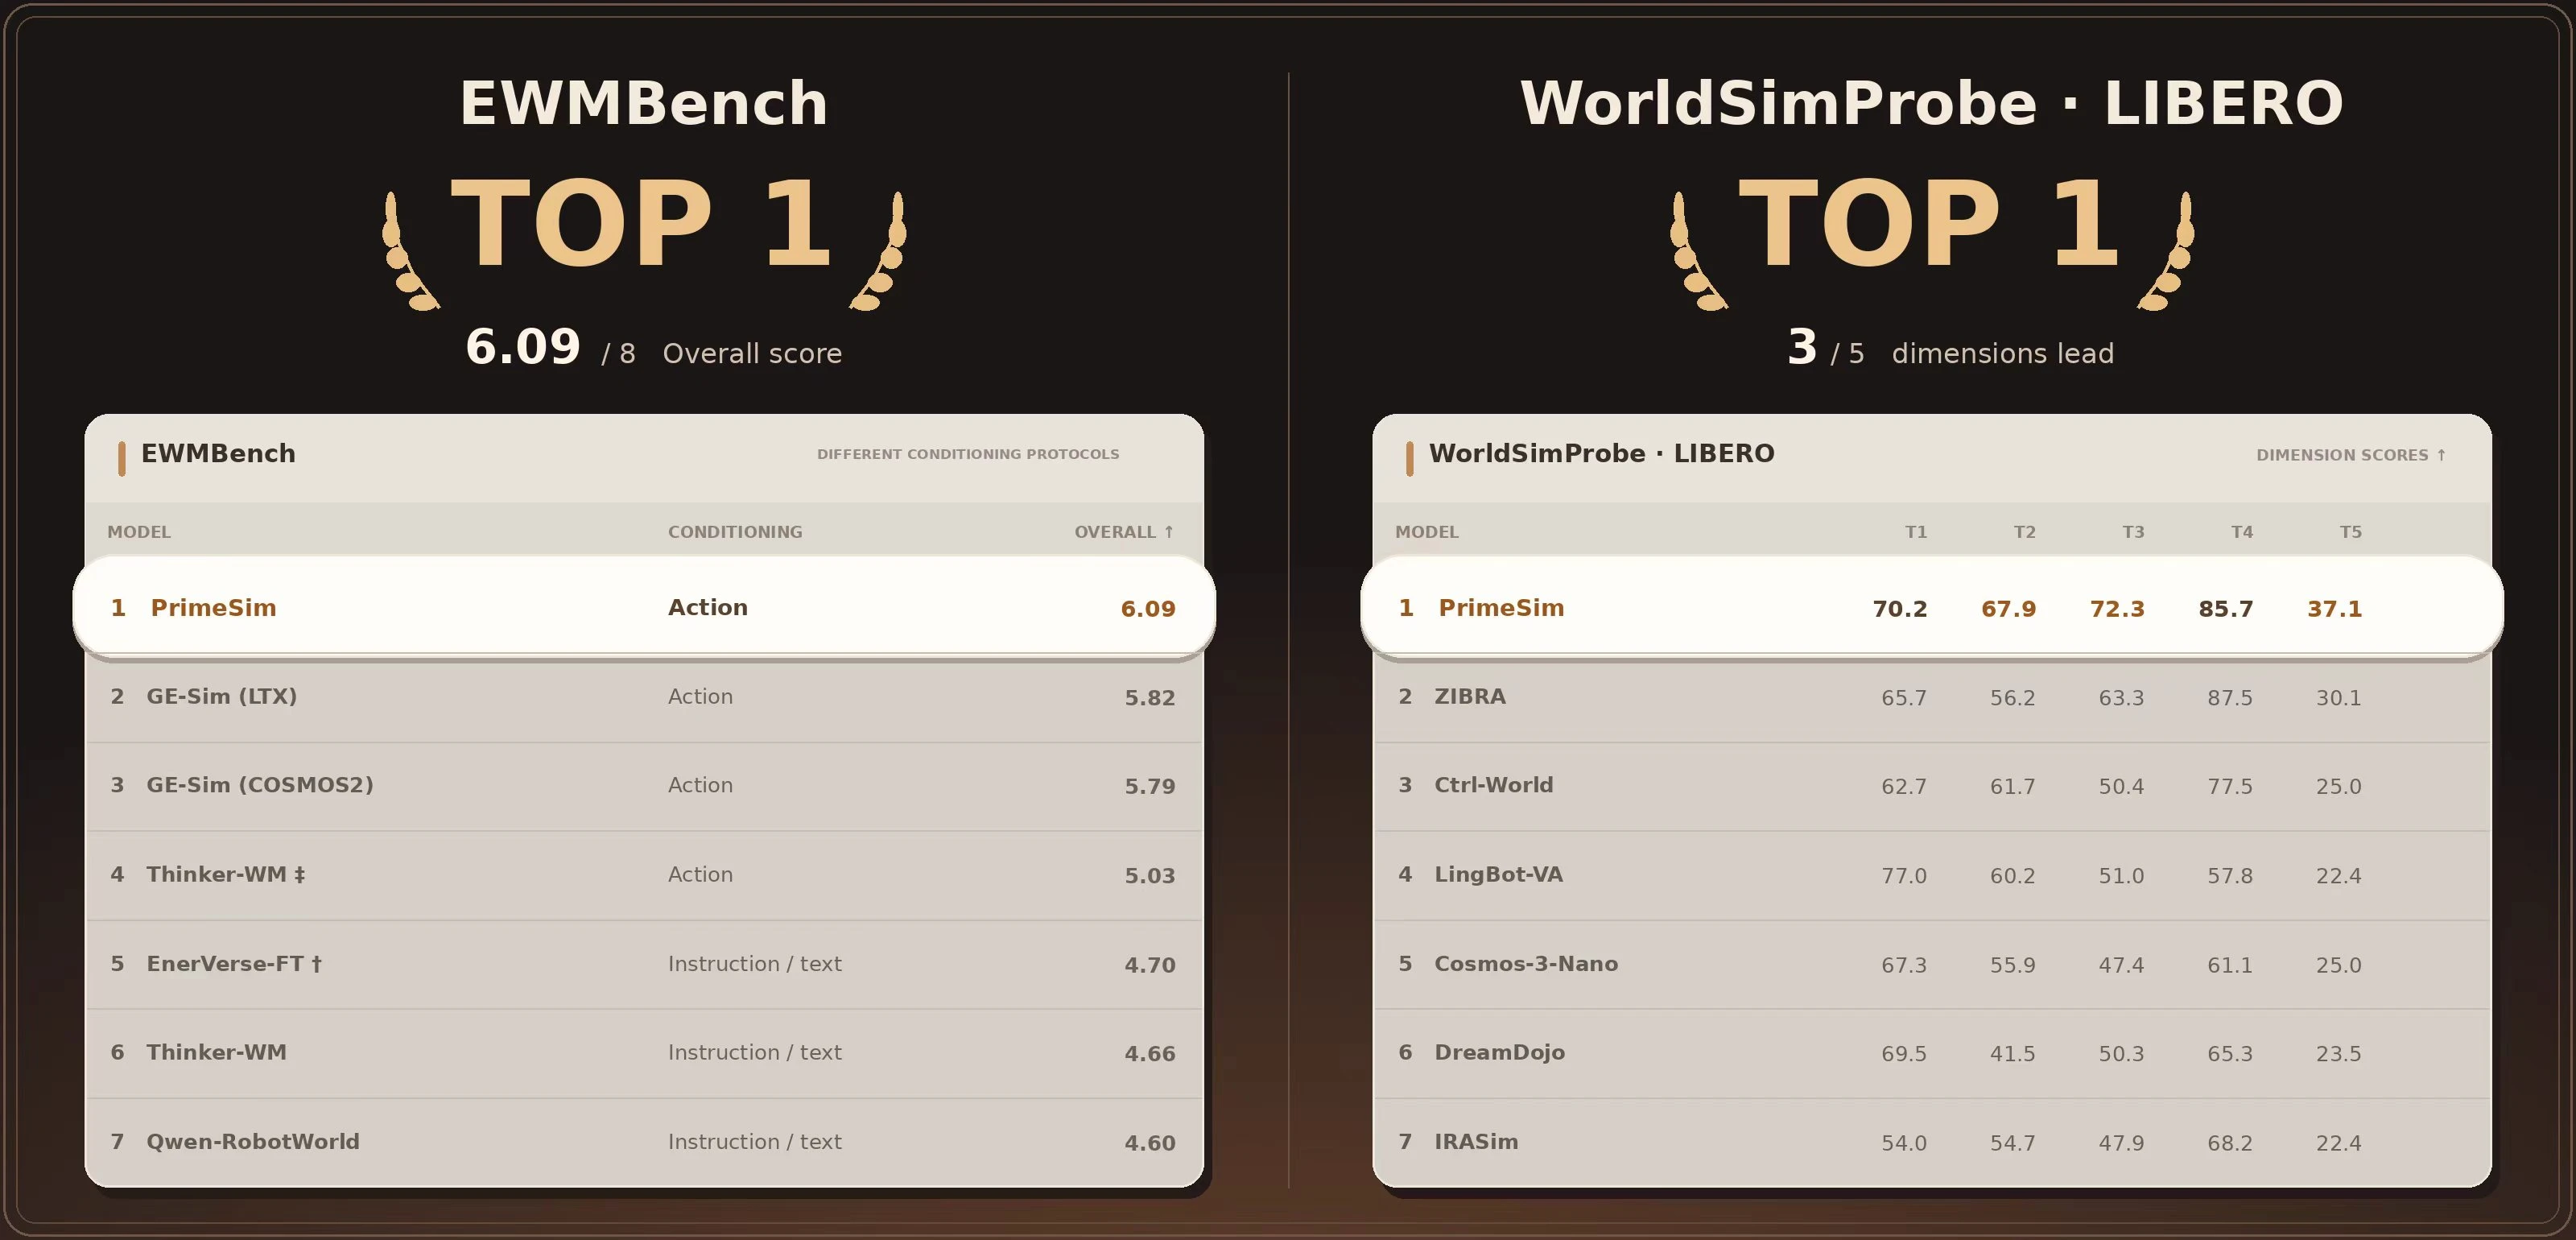
据团队公布的评测结果,PrimeSim 在 EWMBench 上取得 6.09 的综合得分,位列榜首。在基于 LIBERO 设计的 WorldSimProbe 五项测试中,它在全局轨迹覆盖、动作来源行为保持和交互动态三项指标上排名第一。
PrimeSim采用两阶段训练。中训练阶段使用 30,110 小时机器人演示数据,涵盖 22 种机器人平台,并通过统一动作表征和多视角处理等设计,让控制指令与生成结果保持对应。后训练阶段则针对连续推演进行优化,使模型在超出训练上下文长度后仍能维持状态连贯,最长支持两分钟以上的连续推演。
在 RoboTwin 2.0 留出集、单张 A100 测试中,团队将模型去噪步数从 50 步压缩至 4 步,生成速度从每秒 1.12 帧提升至 10.04 帧,画面质量指标也有所改善。另一组实验比较了 PrimeSim 与 LIBERO 原生仿真器:8 个 OpenVLA-OFT 策略在 300 个共享初始状态下的成功率相关系数为 0.99,平均绝对误差为 2.8。团队还报告称,在 PrimeSim 中进行强化学习后,策略在原生仿真器上的成功率提升了 11.5%。
这些结果显示,PrimeSim生成的仿真轨迹与传统仿真环境中的策略表现具有较高一致性,也为在神经仿真器中训练策略提供了初步证据。