

清华团队提出 Utility-WAM,按需启用未来视频做机器人动作规划
作者:江思奇
把「先想几帧未来画面,再出动作」写进策略,是具身智能近两年很受关注的技术路线。机器人可以在模型内部推演后续场景画面,让动作规划获得动态前瞻能力,理论上更适配长程、多阶段任务。
但是,预测未来画面会改动模型输出的动作,改动有好有坏,正负效果互相抵消后平均成功率几乎没有净收益,生成这些预测画面的算力开销却一分不少。
10 月 29 日,清华大学联合约翰霍普金斯大学、美国东北大学、东南大学、中国科学院自动化研究所与引望智能科技发表论文《Utility-WAM: Correcting Future-Induced Action Changes》(Utility-WAM:纠正未来诱导的行动变化)。Feihong Zhang、Xi Lin 与 Yulong Shi 为共同第一作者,其中 Feihong Zhang 来自清华大学,也参与过机器人灵巧手项目《UniDex》。通讯作者 Zihao Liang、Yinuo Wang 与 Zhaowen Li 来自引望智能技术有限公司相关实验室。
这条路线的基本结构,是让视频与动作共用一套扩散骨干,视频支路负责生成未来几帧,动作支路据此去噪出动作块。动作支路能不能看见未来,成了部署时最贵的一个开关。
针对这个黑箱问题,团队提出 Utility-WAM,一套校正未来视频带来的动作偏差、并依据效用判断是否生成视频的方法。它在同一个共享权重快照上并行搭建两条动作流,依靠残差适配器抵消有害的动作偏移量,再由一个仅读取当前观测的门控模块,判断本次是否需要消耗算力生成未来视频。
在 LIBERO、RoboTwin 2.0 数据集上,开启未来预测原本仅带来 0.8 与 −0.8 个百分点的平均性能波动;经过校正与动态选择后,两项任务成功率达到 98.9% 与 93.3%。双臂真机三项任务一共 60 次测试,Utility-WAM 成功 53 次;同等条件下,FAST-WAM 仅成功 43 次。
这套方案的可拓展性取决于两点:
- 校正后的动作偏移规律,能否在更换骨干模型、机器人硬件后稳定生效
- 门控机制能否从离线动作误差代理指标,升级为基于闭环任务回报做决策
拆解未来视频,量化动作增量
过去两年围绕世界动作模型的讨论,大多围绕「要不要为想象付钱」展开。Utility-WAM 换了一个切入角度:一段预测出来的未来画面,究竟会让动作发生多大改变。
团队基于同一个共享 Stage-1 检查点做对照,分出动作支路可以读取未来视频、以及无法读取未来视频两条路径,将两条路径输出动作的差值定义为动作增量 Δa。这个增量有可能提升任务表现,也有可能带来负面影响,或是几乎不起作用,但只要触发查询,视频生成带来的延迟开销就一定会产生。
团队沿用负迁移的经典定义,将相比无未来路径性能下滑的现象称为**「未来诱导负迁移(future-induced negative transfer)」**。它和传统负迁移存在区别:两条策略共享参数与训练数据,唯一新增的信息源就是合成出的未来画面。闭环成功率变化 ΔJ,是单次 Δa 在整条任务轨迹上不断累积得到;实验表格里的负值,就代表引入这段未来预测之后,策略表现反而变差。
两条动作流可以并行对照,依靠注意力掩码实现。
第一阶段联合训练共享的视频 DiT 和动作 DiT:Mwo 掩码阻断动作支路读取未来视频 token,Mw 掩码放开读取权限,两条路径都保留当前观测信息,参数完全共用。权重一致,唯一变量只有动作支路能否访问未来视频 token。正因如此,后文所有 Δa、ΔJ 的对比,都可以解释成同一个模型、同一批数据下,仅增加未来预测带来的变化,避开两套独立训练策略带来的随机差异干扰。
先校正、再决定是否生成的顺序,由动作流本身的特性决定。一旦本次查询选择开启未来条件路径,有害的动作增量已经进入控制流程;就算之后切回无未来路径,也只能影响后续步骤,无法挽回当前这一步的偏差。如果简单把它当成路由选择问题,相当于放任本次已经产生的负面影响,延后处理。
切换到这个视角,不少以往的讨论都可以重新梳理。
始终生成未来画面,相当于预设 Δa 的预期收益能够覆盖延迟成本;部署阶段直接关闭未来预测,相当于认定动作增量不值得付出算力代价,同时放弃它在长程任务里的正向价值;按任务阶段做路由切换,则默认任务阶段可以作为效用好坏的判断依据。
Utility-WAM 的思路是直接评估效用:先判断校正后的动作增量能否降低动作误差,再基于当前观测判断是否启动视频生成,不再依赖阶段标签,但必须保留效用信号。
和相近方案对比,差异体现在信息的使用方式上。
FAST-WAM 在训练阶段接触未来信息,部署时直接关闭视频生成;AdaWAM 根据执行阶段选择是否运行视觉推理,路由规则依赖阶段监督信号;PFD 将特权未来信息蒸馏到仅观测当前画面的策略里,推理阶段不再做视觉预测。这条方向更早可以追溯到基于模型强化学习里的 I2A、STEVE、MBPO,这些研究同样需要处理仿真 rollout 有价值但也会出错的难题。
Utility-WAM 的独特之处在于:固定参数与数据不变,把合成未来本身视作诱发负迁移的额外信息源,直接校正它带来的动作偏差。
三阶段训练与选择性推理
**第一阶段仅在联合训练过程中引入注意力掩码,不单独训练独立策略。**总损失包含三部分:视频损失,以及两种掩码条件下的动作损失,依靠 λwo 与 λw 调节权重。训练完成后,模型内部天然形成两条动作流:不读取未来信息的 πwo、读取未来信息的 πw;该阶段不新增任何额外参数。
**第二阶段冻结共享 WAM,只训练残差适配器 ϕ。**适配器在推理阶段接收模型生成的未来特征,训练阶段也对齐同样的数据分布。在统一噪声水平下,冻结后的 WAM 分别输出三组速度:无未来条件速度 vwo、基于自生成未来的速度 vw、加噪真值未来条件速度 vGT。适配器根据动作查询与池化后的未来特征预测速度残差,修正后的速度写作 v̂w = vw + Δvϕ。
训练监督信号分为三项。动作项持续拟合专家演示速度;对齐项约束修正后有未来速度和无未来速度之间的差值,向真值未来给出的有效修正量 δ 靠拢。如果真值未来无法带来明显提升,相对改进边际 ρ 取 0.05 时,δ 直接置零,约束适配器不要随意偏移;超额误差项,专门惩罚局部流匹配误差超出无未来基线的部分。
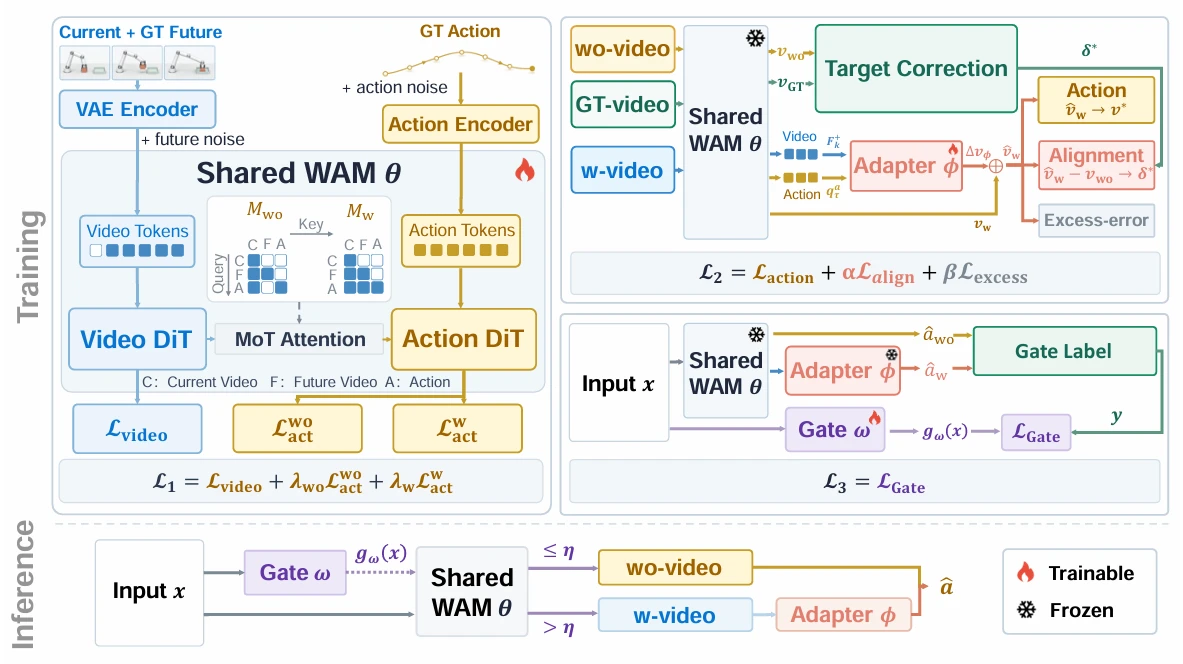
三项监督各司其职:对齐项给出修正方向,超额误差项划定误差上限,构成一套不对称安全阀。多数常规任务里它不会介入,一旦出现破坏性漂移,就把误差拉回无未来基线以内。单独只用其中任意一项,都达不到完整效果,二者配合才把精密任务的性能拉回可用区间。
简单来说,适配器相当于带着参考答案做纠偏。真值未来轨迹如同开卷参考:如果它能明显优化速度预测,就把这部分有效修正作为学习目标;如果它没有增益,就约束有未来路径不能偏离无未来基准太远。自生成未来自带采样噪声与分布偏移,直接采信 vw − vwo,会把噪声引入控制逻辑。对齐项搭配超额误差项,就是从噪声里筛选出少量真正有用的修正信号。团队提到,这个思路延续了 professor forcing 的核心思想。
**第三阶段冻结 WAM 和适配器,训练轻量门控 ω。**门控标签由适配器修正后的成对结果生成:修正后的动作增量降低了和专家动作之间的误差,标记为正样本。门控仅接收当前观测与本体状态,学习在生成视频之前,预判本次的修正是否具备价值。Δa 需要等视频生成完成才能算出,门控本质是提前预估收益。
推理阶段简化为二选一决策。优先运行门控,得分低于阈值,直接走无未来动作流,完成十步动作更新,全程跳过视频计算;得分高于阈值,才生成未来视频,并且在每次视频更新之后,执行适配器校正后的动作更新。阈值在验证集上调优确定:LIBERO 取 0.439,RoboTwin 2.0 取 0.541。训练时两条分支都会运行,用来构造 Δa;推理阶段只执行选中的单条支路。延迟表现由此决定:门控本身算力开销很低,成本大头是视频生成。
校正模块挂载在有未来路径上,原因是这条支路依赖带噪采样得到的合成表征。长程任务依靠这类表征获取前瞻能力,但表征一旦偏移,精密操作最先受损,无未来速度在这里充当稳定锚点。门控标签依托成对动作误差构建,不需要任务阶段标签,也可以直接适配时长不固定的真机测试回合。
平均分掩盖的崩盘与修复
实验底座沿用 FAST-WAM 的 Wan2.2-TI2V-5B,每个基准单独训练。所有变体共用同一个 Stage-1 检查点、初始状态与随机种子。这个设计的核心价值:把适配器、门控带来的效果,和骨干模型本身的随机差异剥离开。代价是无法评估骨干重训带来的方差,但组件消融结论更干净。
LIBERO 偏向桌面长程语言条件任务,RoboTwin 2.0 面向双臂操作,二者组合很容易拉开平均指标和尾部极端案例之间的差距。
以无未来分支作为基准,开启未来预测之后:LIBERO 平均成功率从 97.4% 升至 98.2%,提升 0.8 个百分点; RoboTwin 2.0 从 91.9% 降至 91.1%,下滑 0.8 个百分点。
LIBERO 的微弱正向收益几乎全部来自 Long 长程子集;其余子集波动不超过 0.4 个百分点。RoboTwin 在干净、随机环境设定下趋势一致,随机环境扰动不会放大这种负迁移效应。FAST-WAM 的 Joint、IDM 未来变体也复现该规律:长程任务受益,双臂基准平均表现走弱。
只看均值很容易误判未来预测影响微弱,但分任务统计结论完全反转。
RoboTwin 50 个任务里,21 个任务开启未来后性能下跌。退化高度集中:Press Stapler 下跌 54.0 个百分点,Place Can Basket 下跌 34.0 个百分点;其余受损任务跌幅最高仅 2.5 个百分点。LIBERO 只有 7/40 的任务下滑,波动区间相对温和。并且这两个重灾任务,在多种未来信息使用方案里都会出现严重失效,属于共性问题。
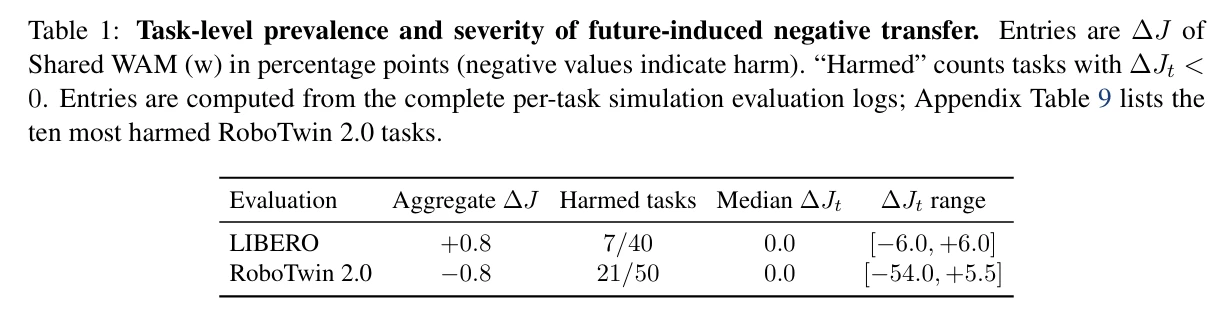
还有一个容易被忽略的分布特征:RoboTwin 半数任务,开启未来前后成功率变化不超过 1 个百分点。 一部分任务拿到正向收益、一部分精密任务承受暴跌、大部分任务几乎不受影响,三类样本取平均,就形成 「开不开未来差别不大」 的均值假象。
未来视频生成的延迟成本很高。在单卡 H100 80 GB、BF16、batch size=1 的环境下测试:有未来路径延迟约为无未来路径的 1.7~1.9 倍。无论本次预测最终对任务有益还是有害,只要调用视频生成,这笔开销就会产生。
仅启用校正模块、全程生成视频的版本 Utility-WAM(Correction):LIBERO 98.7%,RoboTwin 92.8%。 两个重灾任务的跌幅收窄至 6.0、14.0;RoboTwin 的整体增益里,接近八成来自这两个被修复的任务,同时长程子集原本的正向收益没有丢失。
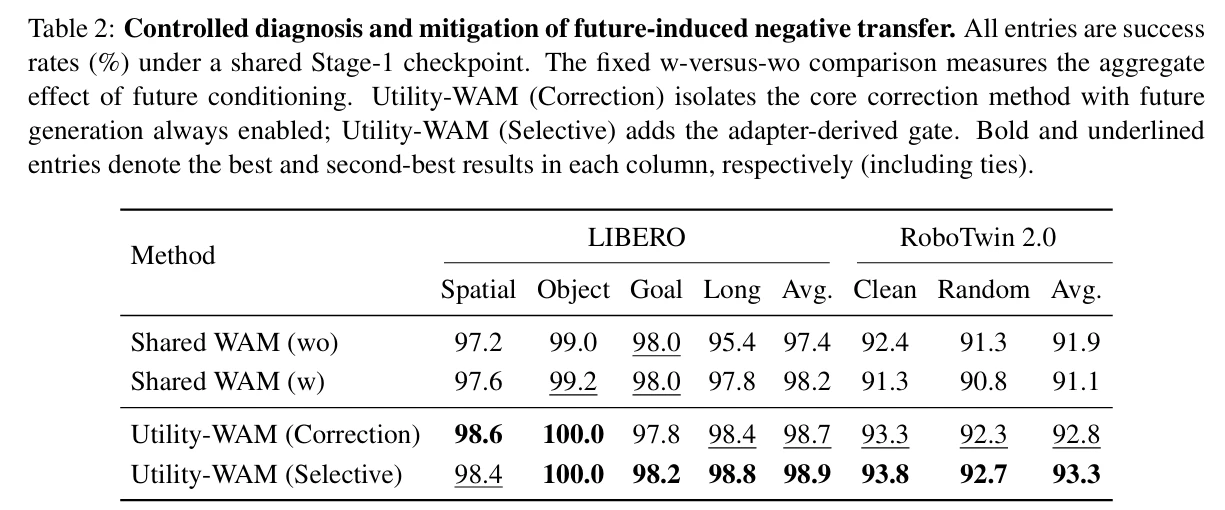
消融实验排除了 「单纯增加网络容量实现修复」 的猜想。单独启用对齐项可以拿到一部分提升,叠加超额误差惩罚之后,修复能力才到达上限。
在校正基础上叠加门控选择性推理,最终版本 Utility-WAM(Selective)达到 LIBERO 98.9%、RoboTwin 93.3%。 RoboTwin 仅保留 24.5% 的视频生成请求,75.5% 的查询直接跳过视频分支,端到端延迟下降 37.9%。LIBERO 场景下未来预测整体正向收益稳定,门控大多选择开启未来,延迟优化幅度很小。
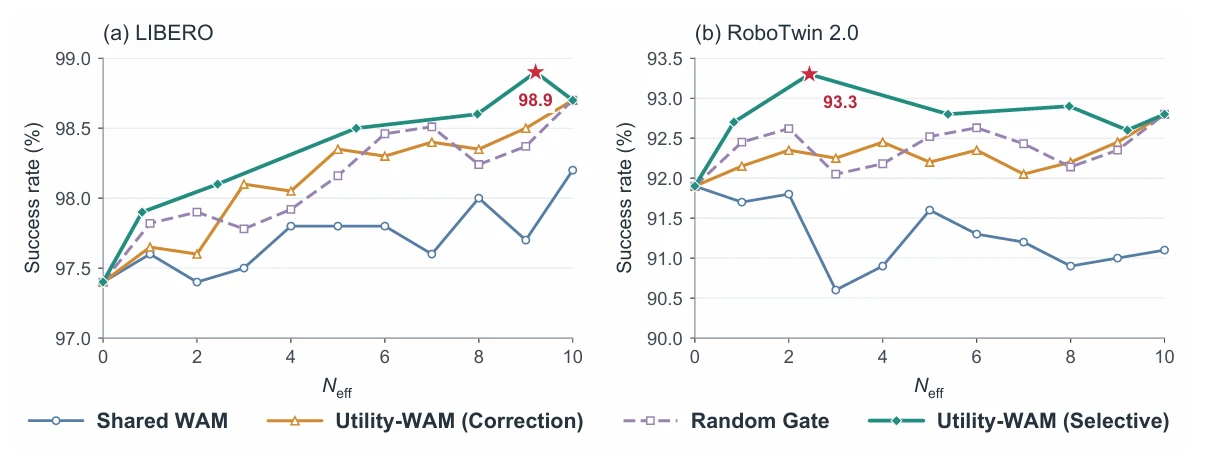
同等算力预算下,通过学习得到的门控策略,显著优于固定截断步数、随机开启校正分支两种朴素基线。
门控额外增益的来源:过滤掉那些即便经过校正,未来预测依旧无法带来正向价值的时序步。校正稳住重灾任务的性能下限,门控进一步淘汰无效调用,在更低算力预算下抬升整体性能上限。
横向对比同类方案:FAST-WAM 的未来变体拉高长程任务,但双臂任务反而掉点;PFD 效果可观,但推理阶段彻底放弃视觉预测能力;AdaWAM 同样做路由,依赖人工标注的阶段监督标签。
双臂三任务多出十次成功
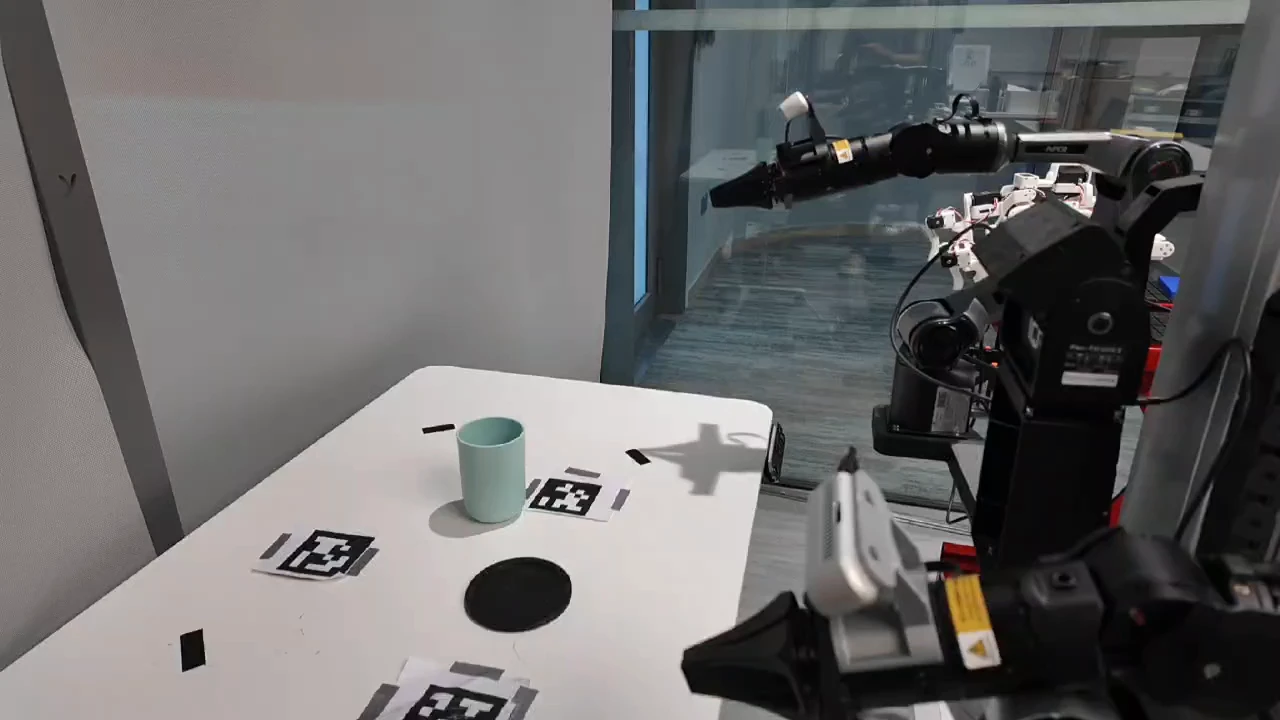
脱离仿真环境,团队使用两台 AgileX PiPER 六自由度机械臂搭建双臂平台,每条臂配备两指夹爪。
观测输入包含一路固定前视 RGB,以及左右臂各自的腕部 RGB。机器人本体状态为 14 维向量,涵盖双臂关节角度与夹爪开合信息。
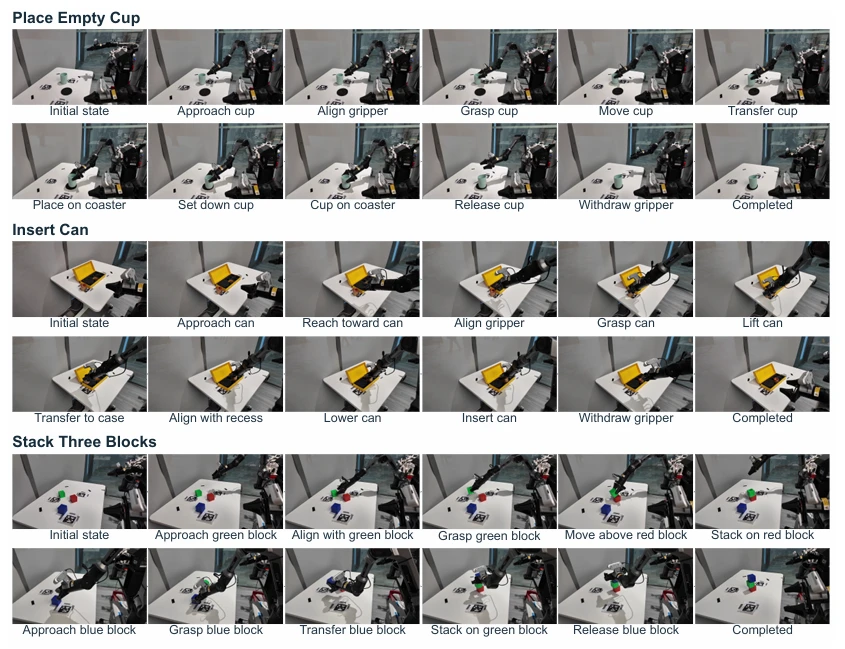
实验设置三项任务:Place Empty Cup、Insert Can、Stack Three Blocks,每项任务采集 200 条遥操作演示数据,采样频率 10 赫兹,训练窗口长度 32 步,对应 3.2 秒动作视野。
每项任务评测 20 次,测试时物体初始摆放位置随机变化。FAST-WAM 与 Utility-WAM(Selective)使用同一批演示数据,后者遵循前文的三阶段流程完成训练。
Utility-WAM(Selective)一共成功 53/60,成功率 88.3%;FAST-WAM 成功 43/60,成功率 71.7%,二者相差 16.7 个百分点,双侧 95% Newcombe 置信区间为 2.3 到 30.4。
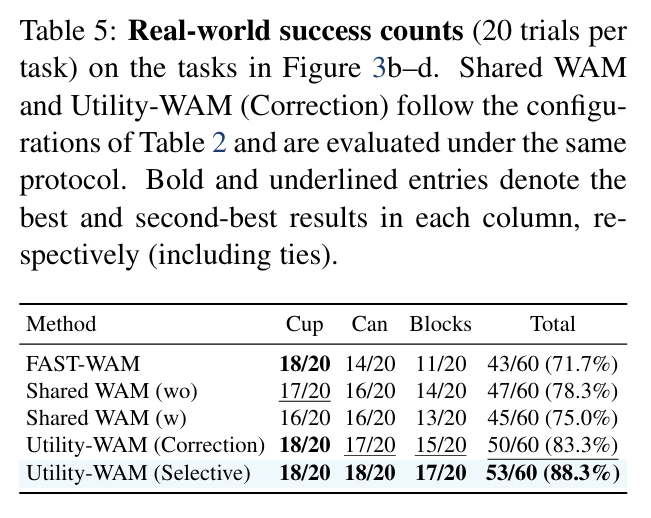
拆分到单项任务来看:
Place Empty Cup 两组持平,均为 18/20;Insert Can 从 14/20 提升至 18/20,多成功 4 次,难点集中在罐体和凹槽的对准操作;Stack Three Blocks 从 11/20 提升至 17/20,多成功 6 次,也是三项任务里时序最长的多阶段任务。对准、堆叠这类操作对误差更加敏感,也更适合在部分时机调用经过校正的未来路径。
这一分层规律,和仿真得出的「长程任务适合利用未来预测、校正机制保护精密操作」的结论相互印证。
中间对照实验组的结果同样清晰。共享 WAM 无未来分支为 47/60,成功率 78.3%;开启未校正的未来预测后为 45/60,成功率 75.0%。
在真机场景下,直接开启未来预测甚至小幅降低性能;仅启用校正模块可以达到 50/60,成功率 83.3%;叠加门控之后进一步提升至 53/60。收益逐级叠加,先校正、再选择性生成视频的思路生效,单纯持续生成未来画面无法拿到同等效果。
但实验呈现出清晰的分层信号:部分任务不受影响、对准类任务受益、长程堆叠任务提升最明显,分层逻辑和仿真诊断保持一致。真机没有复现 Press Stapler 那种暴跌 54.0 个百分点的极端失效,但「开启未校正未来小幅掉点,校正搭配门控逐步抬升性能」的变化趋势依然成立。