

同一天两篇论文,复旦大学付彦伟团队:机器人先行感知,接住新视角下的动作
作者:江思奇
同一天两篇论文,复旦大学付彦伟团队:机器人先行感知,接住新视角下的动作
机器人伸手抓取被杂物遮挡的杯子,最直观的解法就是转动腕载相机重新观测。但相机转动会同步改变机械臂构型,策略将面临训练期间从未见过的初始状态,图像、位姿与剩余任务之间的关联全部错位。
团队量化了这一负面影响:在成熟的视觉语言动作模型前接入相机重定位流程后,LIBERO 扰动起点协议下平均成功率从 46.3% 跌至 11.5%;另一骨干模型则由 30.7% 下滑至 7.0%。
10 月 16 日,复旦大学、上海创智学院团队连发两篇论文:《Look Before You Act: Bridging Active Perception and Vision-Language-Action Models via Observation-Aligned Data Adaptation》与《AWAM: Active Trajectory-Conditioned View Imagination for Robust Robot Manipulation》,两篇文章的第一作者均为 Jiawei Geng。
该课题组由复旦大学大数据学院终身教授付彦伟带领,他长期深耕少样本学习、生成模型、三维视觉与具身智能方向,曾在 2023 年斩获国家自然科学奖二等奖,团队此前就已探索过将虚拟视角选择接入视觉语言动作模型的相关研究。
主动感知的思路,是让机器人先规划观测位置,再生成动作。视觉语言动作模型的输入高度依赖相机位姿;在杂物遮挡场景下,目标可能直接脱离视野,即便动作模型性能优异,也无法弥补缺失的观测信息。将相机调整至可看见目标的视角,是主动感知最直接的实现方式。
过往方案存在两处瓶颈。
- 实体相机方案会产生执行代价:视角调整后机器人本体状态同步变化,感知与操作之间出现接口断层。早期系统为此采用感知臂或可动颈部,将观测与操作动作联合学习。
- 虚拟视角方案规避了实体运动代价,但预设相机只能在固定机位中选择,重建渲染无法还原初始几何信息中不存在的物体表面;同时现有世界模型大多用于预测动作带来的未来状态,很少用来主动查询未曾观测过的方位。
ActiveAlign 与 AWAM 分别补齐这一接口的不同环节。
- ActiveAlign 正视相机转动会改变策略初始状态这一问题,利用部署阶段所用的视角模块构建训练数据,将现有演示样本对齐至主动感知结束时的状态,通过闭环对齐、回放并筛选有效样本,再对策略微调。
- AWAM 则将视角视作虚拟查询:由任务条件化的相机轨迹驱动基于几何的世界模型,把沿途观测画面压缩为固定维度的记忆,在操作阶段与实时观测信息一同送入策略。两条路线都没有把视角模块作为推理阶段的外挂组件,而是在训练阶段,借助部署所用模块生成对应数据或表征,共同覆盖从规划观测点位到完成操作的完整链路。
ActiveAlign 在 LIBERO 数据集 40 项任务上将 π0.5 基线由 46.3% 提升至 72.7%,AWAM 在 LIBERO-Occ 数据集取得 75.9% 的成功率,让遮挡环境下的机器人操作得以平稳接续。
训练复用部署的相机
两项工作始于同一个核心洞察:当机器人目标被遮挡,最有效的解法是移动相机获取可视视角,但这一步会直接改变动作策略的输入条件。
视觉语言动作模型负责将观测与语言指令直接映射为动作,而观测结果完全由相机位姿决定。一旦相机变位,画面内物体的位置、尺度、遮挡关系都会改变,机械臂构型也随之变动,策略需要基于全新的视觉与本体感知组合推导后续动作。
团队将这个交接处的分布偏移命名为首帧分布敏感性,「首帧」即主动感知环节传递给操作策略的那一帧观测。
两项工作拥有统一输入设定:机器人搭载一台场景相机与一台腕部相机,输入包含语言指令、本体感知、深度图以及相机标定参数,策略输出一段动作块。
二者差异,来自对视角变动的不同假设。
- ActiveAlign 驱动腕部相机真实转动,机器人本体随之运动;
- AWAM 则仅让虚拟相机沿规划轨迹移动,机器人本体保持静止,该轨迹不会真机执行。
腕载相机是这个问题的核心根源:相机固连于机械臂末端,视角变动时图像与机械臂构型同步改变,二者在数据中深度绑定;换成虚拟相机后,图像可以变化,但本体构型维持不变,便将这两个耦合变量解耦。
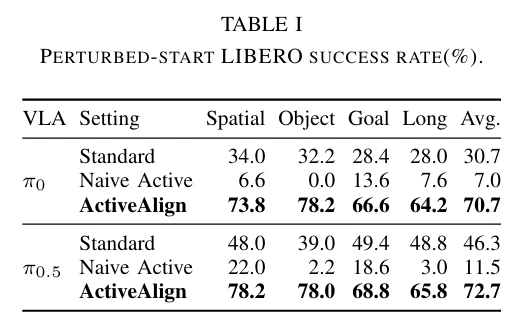
该图片为名为“TABLE I PERTURBED-START LIBERO SUCCESS RATE(%)”的实验数据表,展示了不同设置下的LIBERO任务成功率情况。表格分为π₀和π₀.₅两类设置,每类下包含Standard、Naive Active、ActiveAlign三个子项,子项后依次对应Spatial、Object、Goal、Long四个维度的成功率数据,以及Avg.平均成功率。其中ActiveAlign设置的各维度成功率及平均成功率均显著高于另外两类设置,例如π₀.₅类别下ActiveAlign的平均成功率达72.7%,远超同类别下Standard的46.3%与Naive Act
团队首先量化了这种分布错位带来的影响。
在 LIBERO 扰动起点协议下,为 π0.5 前置相机重定位模块、保持其余条件不变,四组任务套件平均成功率由 46.3% 跌至 11.5%;π0 基线则从 30.7% 下滑至 7.0%。动作分块机制会放大前期误差,误差会顺着已执行动作持续累积,即便后续获得新图像,错误也已经固化。
主动感知提供质量更优的观测,但动作策略只能够兼容自身可承接的观测,这两点需要分开考量。团队设计对照实验,将视角信息、机器人状态演化与数据量变量解耦,证实失败并非单纯由图像分布偏移导致。
AWAM 从另一条路径规避了该错位。
其规划的虚拟相机轨迹不会真机落地,机器人保持原位、本体构型不变,仅依靠世界模型推演轨迹上的虚拟画面。机器人不动、观测先行,从源头规避状态错位。代价则体现在信息层面:虚拟视角只能依托初始 RGB-D 反投影点云提取信息,从未被相机采集到的物体表面,需要依靠世界模型做补全。
两套方案在此形成明确分工。
- ActiveAlign 直面真实相机转动后产生的完整状态错位,通过改造数据集,让策略在新的观测与状态分布上重新学习;
- AWAM 应对本体状态不变、但观测信息不足的场景,通过改造表征,将虚拟推演的视角压缩为可供策略持续读取的上下文。
两条路线都把部署阶段的视角模块嵌入训练数据构建流程:ActiveAlign 用它生成新的演示起点,AWAM 用它生成记忆输入,保证训练和推理阶段遵循一致的轨迹逻辑。
生成轨迹,告诉机器人看哪里
ActiveAlign 的视角模块,目标是根据当前场景与语言指令,推导相机的运动路径。
模块将 RGB 与深度信息拆分为两路 CLIP 特征,和语言指令一同编码,再通过条件自回归解码器逐位生成量化后的相机位姿 token;默认单条轨迹包含 30 个位姿,如需平滑执行,可插值至 120 个。位姿在 SE (3) 空间表达,再转换至已标定的机器人坐标系,交由控制器生成候选观测动作。
团队使用 20,000 条仿真轨迹与 1,200 条真机轨迹训练该模块,这组数据与后续操作演示数据分开采集。
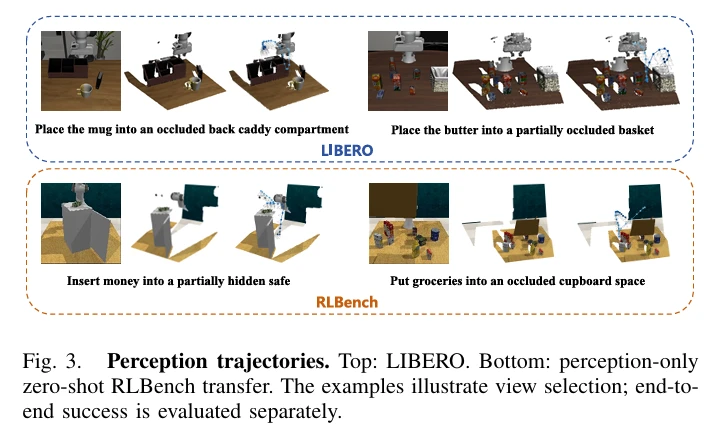
图片展示了LIBERO和RLBench的感知轨迹。上半部分为LIBERO,包含“将杯子放入遮挡的后置托盘”和“将黄油放入部分遮挡的篮子”两个任务,机器人在不同视角下操作。下半部分为RLBench,有“将钱放入部分隐藏的保险箱”和“将杂货放入遮挡的橱柜空间”任务,机器人同样在不同视角下操作。图片与上下文关系紧密,直观呈现了团队在不同任务中对机器人视角选择的实验结果。
预测得到的路径仅作为候选动作,团队并不保证其最优性或无碰撞特性。仿真环境中依靠逆运动学将相机移动至目标位姿;真机端则由控制器驱动连续运动,这条轨迹是否可用,交由后续对齐与回放流程筛选。视角模块负责提出值得观测的位置,而该位置是否有效,由操作结果判定。这套分工模式让感知模块与操作模块可以独立训练,最终在数据层面完成匹配,无需将两个模型做端到端联合耦合。
AWAM 的轨迹预测器采用另一套参数化方案。它将每一帧表征为相对初始腕部相机的变换矩阵,再拆解为旋转、归一化平移、相机辅助坐标以及轨迹尺度变量,离散为 256 档 token,通过因果 Transformer 自回归生成。预测过程不引入世界坐标下的绝对位姿,因此输出结果与场景原点无关,更换房间也无需重新标定全局坐标。团队从单条预测轨迹中,依据相机累积运动选出 21 个代表性视角:运动变化剧烈的段落采样更多点位,接近静止的段落减少采样,避免视角预算浪费在无变化区域。
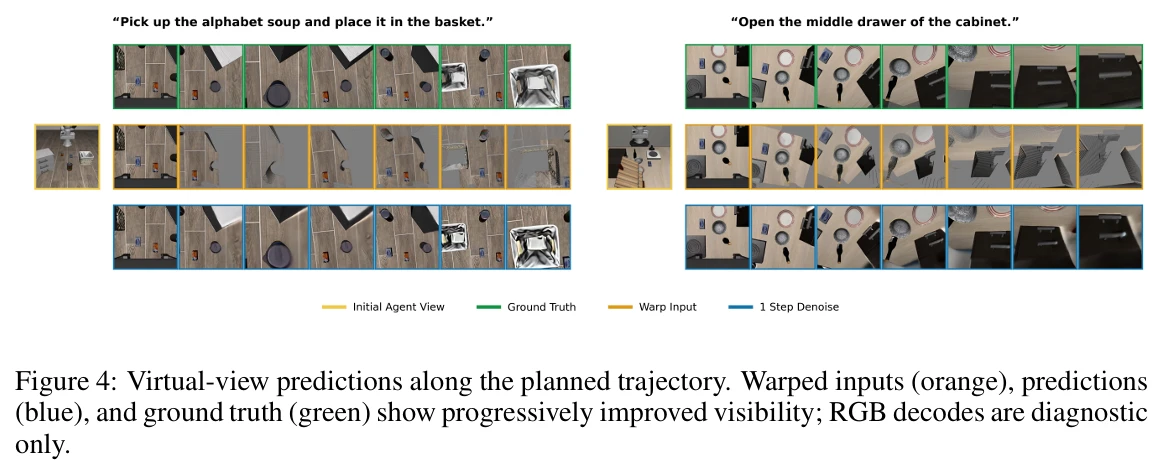
图片展示了两个任务的虚拟视角预测沿计划轨迹的情况。左侧任务为“Pick up the alphabet soup and place it in the basket.”,右侧为“Open the middle drawer of the cabinet.”。图中包含初始机器人视角(黄色)、预测视角(蓝色)和真实视角(绿色),显示了逐步提升的可见性。其中,Warp Input为橙色,1 Step Denoise为蓝色。该图与上下文紧密相关,直观呈现了两套方案在轨迹生成上的效果,与上下文提到的轨迹长度对成功率的影响相呼应。
两个模块均借鉴现有相机轨迹生成相关研究。
- ActiveAlign 的模块受语言指令驱动:语言定义寻找目标,场景几何判断可视方位,两类信息共同作为条件输入;
- AWAM 的预测器由预训练文本 - RGBD 相机轨迹模型初始化,视觉与语言编码器在适配阶段冻结,仅训练轨迹投影层与因果 Transformer。
轨迹长度对两套方案均存在影响:ActiveAlign 将位姿数量从 5 增加至 30,成功率由 56.6% 提升至 78.2%;AWAM 将虚拟视角数量从 7 增加至 21,成功率由 72.4% 提升至 75.9%,继续增加视角数量则收益不再显著。两套方案得到同一个结论:轨迹达到一定长度后,获取的信息便足以支撑任务。
两个模块的输入基本一致,均为场景 RGB-D 搭配一条语言指令,输出都是一条相机轨迹,差异体现在下游的使用方式。
- ActiveAlign 仅需要轨迹终点,终点之后的动作复用已有演示数据接续;
- AWAM 需要轨迹沿途的一系列视角,供世界模型在各个方位分别查询场景信息。
同一条相机轨迹,一端用作全新任务起点,另一端用作一连串虚拟查询。这一差异,衍生出数据层面、表征层面两套完全不同的对接方案。
规划视角,落到机械臂手上
ActiveAlign 将轨迹转化为训练数据的方式,是一轮离线重构。
团队把仿真环境重置至每条演示样本的初始状态,调用视角模块预测并执行一条相机轨迹,记录末端执行器停止时的位姿;随后在前缀窗口内寻找最接近的演示状态,默认窗口范围取整条演示的 5% 到 30%。匹配完成后通过闭环控制补偿二者之间的残差,再回放演示剩余的操作轨迹,只有完整回放成功的样本才予以保留。最终留存的是「看完之后怎么接着做」的片段,相机运动阶段的数据不参与训练。对齐片段与后续操作后缀共同接入训练目标,策略在微调阶段学习从这个新起点继续执行任务。
筛选环节直接决定数据可用性。末端执行器位置接近,并不代表物体与接触状态完全匹配,因此最近状态匹配仅用于生成候选样本,最终能否保留由回放成败判定。
团队在仿真环境尝试 2,000 条样本,保留 1,736 条,保留率 86.8%;真机实验尝试 100 次,保留 86 次,保留率 86.0%。窗口选取越靠后,保留率越高,但可用端点的多样性随之下降,中间区间在任务成功率上表现最优。这套构建方案要求环境支持重置或工位可重建,但部署阶段无需环境重置,也不需要回放操作。
研究针对窗口与终点误差分别做了参数扫描。窗口设为 5% 到 30% 时,成功率达到本组最高的 78.2%;若窗口后移至 10% 到 40%,保留率可从 86.8% 提升至 88.2%,成功率却回落至 76.6%。窗口越靠后,留存的操作片段越短、可用端点越集中,回放需要复现的场景变化反而更多。保留率与端点多样性在此处相互制衡,中间区间稳定性最佳。
推理阶段单独扰动预测得到的终点相机位置:平移误差 0.02 米,成功率下降 6.0 个百分点;0.04 米,下降 9.0 个百分点;误差达到 0.10 米时,性能低于基线训练方案。这组扰动实验独立于基础协议里的初始位姿噪声,专门量化视角模块自身出错带来的代价。该数据构建方案对端点误差存在容忍上限,一旦超出对齐后的分布,增益就会消失。
AWAM 将轨迹转化为表征的手段是构建一份记忆。团队先把初始静态相机与腕部相机采集的 RGB-D 数据反投影,生成彩色点云,再沿着预测出的 21 个视角对该点云做渲染。渲染只能还原已经观测到的物体表面,无法生成未曾见过的区域;在 LIBERO-Occ 数据集上,平均空洞率为 39.29%,峰值可达 74.47%。团队采用 WorldStereo 作为几何条件世界模型,补全这些空洞区域,并沿着虚拟轨迹预测匹配对应视角的中间特征;研究仅取用中间特征,渲染出的 RGB 图像只用于定性可视化。每个视角的特征池化为 16×16 的网格,再通过一层轻量查询编码器压缩成包含 294 个 token 的固定记忆,在单任务回合内缓存。
策略在每一次重规划步,将实时观测作为查询,从这份固定记忆中提取键、值,完成残差交叉注意力计算;融合后的表征结合本体感知与语言指令,送入条件扩散 Transformer,输出 8 步动作块。记忆仅构建一次,但检索内容会随当前观测动态变化,机械臂移动到不同位置,读取到的预测上下文也不相同。记忆固定、检索随状态动态变化,正是这套方法可以在整个任务回合持续提供空间证据的原因。训练动作策略时,团队同样使用预测轨迹构建记忆,不使用演示自带的腕部轨迹,避免训练与推理阶段输入记忆来自不同分布。
整套训练按模块顺序解耦,分为三个阶段。团队先训练轨迹预测器,再适配几何条件世界模型,最后训练动作策略;动作策略又拆成两步:先对齐实时视觉投影、重采样器、记忆编码器与融合模块,冻结预训练动作去噪器;再冻结上述连接模块,单独适配扩散动作模型。动作策略训练期间,世界模型特征提前计算并缓存,不需要每一步重复运行大模型,使得感知预测与动作学习之间拥有一套固定的表征接口。
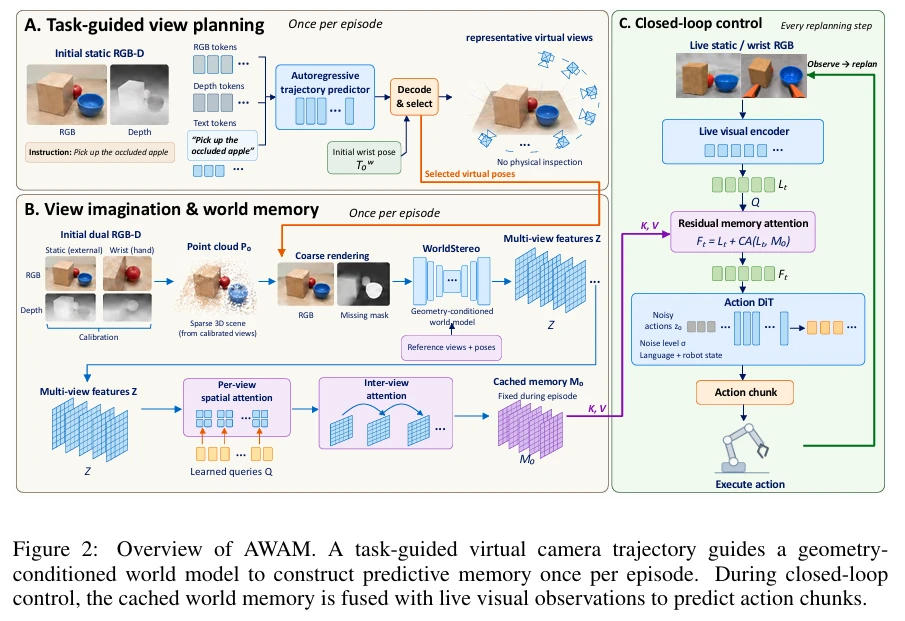
图片展示了AWAM(Active World Memory)框架的概述。A部分是任务导向视角规划,每集一次,基于初始静态RGB - D数据,通过指令生成虚拟视角,再由自回归轨迹预测器预测轨迹,最终选择视角。B部分是视角想象与世界记忆,每集一次,从初始双视RGB - D数据出发,经多视特征生成等步骤,构建世界记忆。C部分是闭环控制,每次重新规划时,使用静态/实时RGB数据,通过视觉编码器等模块,融合缓存世界记忆与实时视觉观测,预测动作片段。
两套方案的分工在此最为清晰。
- ActiveAlign 修改策略所见的任务起点,让原有模型架构在全新观测与本体状态组合下重新学习输出动作;
- AWAM 修改策略可读取的上下文,把当前视野以外的场景信息以记忆形式持续供给模型输入。
一种是把视角信息写入数据集,另一种是把视角信息写入特征表征,实现路径虽不同,但核心目标一致:当观测视角发生切换,策略的输入条件必须同步配套设计。
遮挡场景,两套方案的成绩单
ActiveAlign 的仿真评测基于 LIBERO 的四个套件开展,每个套件包含十个任务,每项任务重复运行 50 次;初始末端位姿添加标准差 0.1 的高斯扰动,这套扰动起点协议在所有实验组之间保持统一。π0.5 的平均成功率从 46.3% 提升至 72.7%,四个套件均实现性能上涨。团队将外接相机模块、标准训练与数据对齐三组方案置于同一套起点协议下对比,性能差异来源于训练数据,与评测口径无关。
这套数据构造方案迁移至其他骨干模型同样有效。π0 的成功率从 30.7% 提升至 70.7%;替换为 OpenVLA 与 GR00T N1 后,也分别取得一成以上的提升。四个骨干覆盖流匹配、自回归 token 与扩散 Transformer 三类动作建模形式。初始状态偏移越大,这套方案的价值越突出。在基准规定的初始状态下,两组性能几乎持平;扰动增大后,标准训练方案性能一路下滑至 46.3%,而 ActiveAlign 仍维持在 72.7%,性能差距随扰动幅度单调扩大。该收益来源于让策略学习部署阶段会遇到的任务起点,单纯扩充数据集无法复现这一效果。
团队设计两组对照实验,分别排除「前缀变短」和「视角变多」两种替代性解释。固定演示步数与后缀长度,仅将相机外参换回默认视角,成功率为 54.6%;使用随机视角与大幅度视角抖动做数据扩充,最高仅达到 61.4%。两组结果均低于 ActiveAlign 的 78.2%。真正带来增益的,是训练分布与部署阶段的视角模块保持对齐。
初始遮挡场景最能体现这套方法的优势。LIBERO-Occ 在首帧画面就将目标遮挡,恰好是视角选择发挥作用的场景,四个套件的性能相比标准训练高出 28.6 至 34.6 个百分点。真机实验设置三档遮挡条件,每档开展 30 次试验,总体成功样本从 35/90 提升至 83/90。另一组任务包含杯具抓取、容器取物与观察开合抓放;长流程任务的成功次数回落至 13 次,单次视角选择无法覆盖完整任务流程。
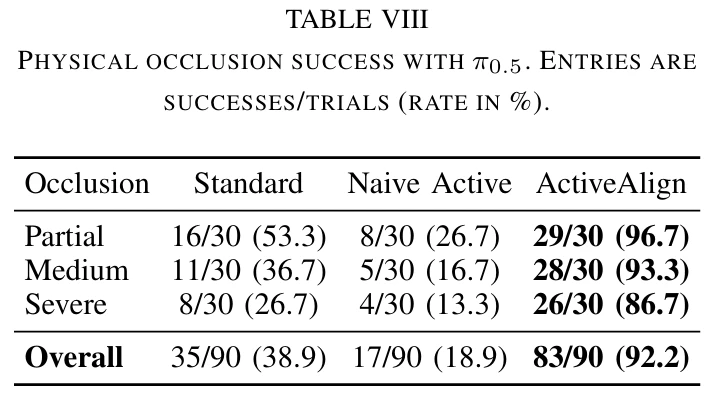
图片为表格,展示在π0.5下物理遮挡成功情况,以成功次数/试验次数(百分比)为单位。表格分为遮挡程度(Partial、Medium、Severe)和方法(Standard、Naive Active、ActiveAlign)三列。在不同遮挡程度下,Standard方法成功率分别为53.3%、36.7%、26.7%;Naive Active方法分别为26.7%、16.7%、13.3%;ActiveAlign方法分别为96.7%、93.3%、86.7%。整体成功率方面,Standard为38.9%,Naive Active为18.9%,ActiveAlign为92.2%。该表与文档中AWAM评测内容
AWAM 的评测在三个基准数据集上完成。在 LIBERO-Occ 上取得 75.9% 的平均成功率,优于专门面向遮挡场景的 VIM(74.0%),也高于世界动作模型 Fast-WAM(73.0%),四个套件中有三项取得领先。Long 套件是其短板,41.0% 的成功率低于 Fast-WAM。原因在于记忆仅基于初始场景一次性构建,全程不再更新,在长时序任务中会失效。
在 RLBench-OG 的 Occlusion1 子集上,AWAM 达到 76.5% 的平均成功率,平均排名 2.05;十个任务中有五项实现 100% 成功率。该基准的控制器与 LIBERO 不同,但方法依然可迁移,证明方案不绑定特定动作接口。在 LIBERO-Plus 的 10,030 条实例上,取得 62.4% 的成功率,相比 π0 高出 8.8 个百分点,在相机视角、物体布局两类扰动下增益尤为显著。
消融实验单独量化各个组件的贡献。四组变体保持骨干网络、训练数据与评测协议不变,仅移除或替换部分模块。移除整条预测分支,仅依靠实时观测,成功率从 75.9% 下降至 64.4%;替换为球面均匀采样视角,降至 70.2%;仅做几何变换、不使用生成式预测,降至 69.0%。基于任务条件学习得到的轨迹优于球面采样,说明「往哪看」本身承载任务信息;生成式预测效果优于单纯几何变换,代表未曾观测到的物体表面,需要依靠世界模型补全。
真机测试中,AWAM 在苹果、瓶子、积木三项任务上各运行 30 次,初始观测下目标均存在部分遮挡。总共成功 85 次,相比 π0 的 66 次多出 19 次;Motus 与 Fast-WAM 分别成功 73 次、72 次。
两组实验结果指向同一个结论。
- AWAM 的消融证明「往哪看」蕴含任务信息;
- ActiveAlign 的对照实验说明,视角效果好坏,必须以部署使用的模块作为评判标准。
选出合适的视角只是前半段,训练时让策略适配视角切换后的新状态,增益才能落地。同一团队在同一天补齐这两个部分,二者结合,才构成主动感知接入操作策略的完整接口。