

轨迹
共 62 篇相关内容
同一天两篇论文,复旦大学付彦伟团队:机器人先行感知,接住新视角下的动作
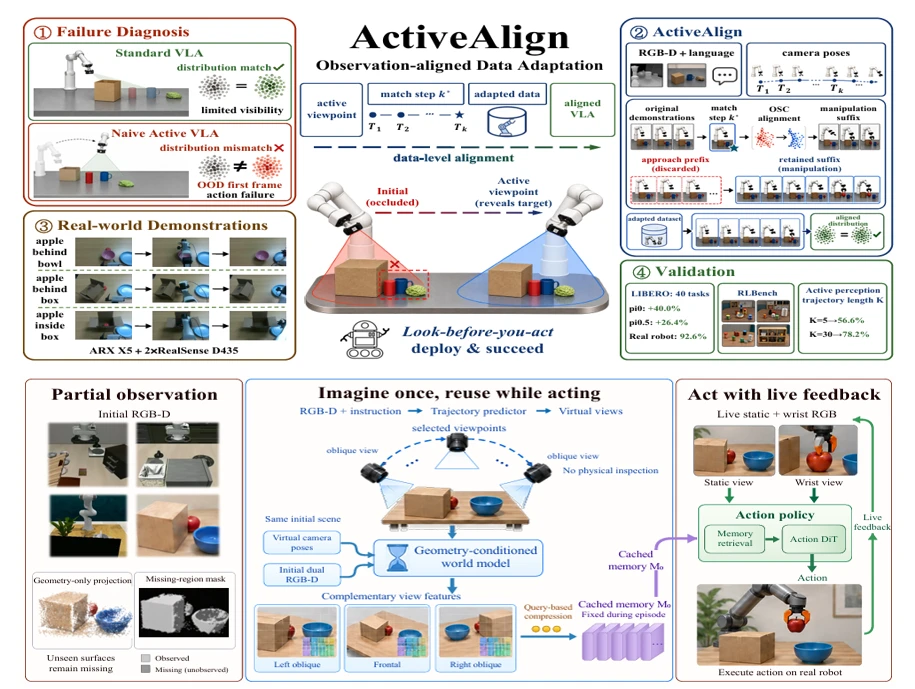
同一天两篇论文,复旦大学付彦伟团队:机器人先行感知,接住新视角下的动作 机器人伸手抓取被杂物遮挡的杯子,最直观的解法就是转动腕载相机重新观测。但相机转动会同步改变机械臂构型,策略将面临训练期间从未见过的初始状态,图像、位姿与剩余任务之间的关…
机器人都能跑马拉松了,为什么走到前台还这么难?
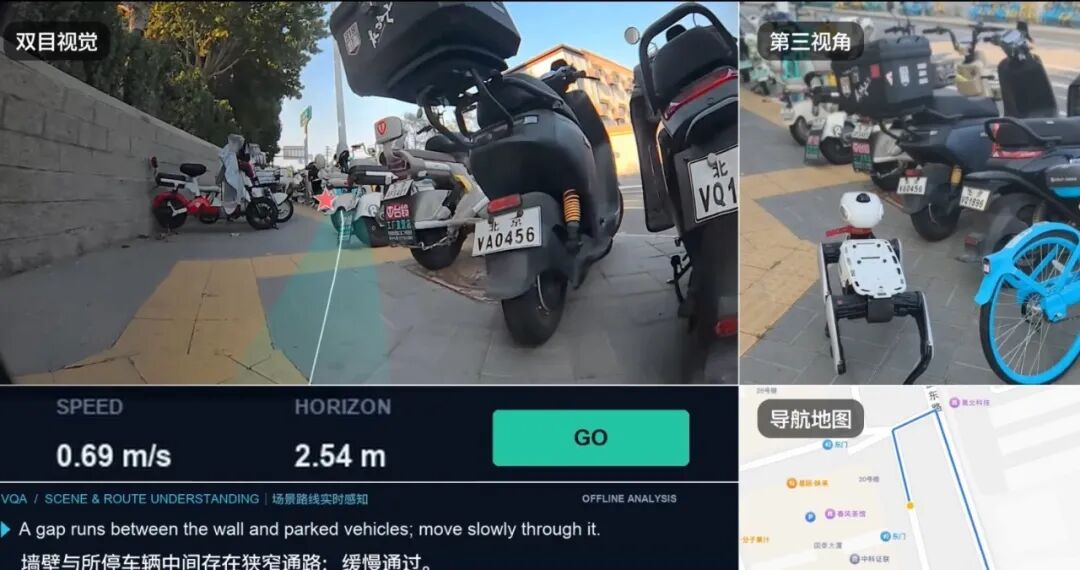
机器人越来越会动了。四足机器人爬楼梯、翻越障碍早已不新鲜。今年北京亦庄的人形机器人半程马拉松上,甚至有近四成参赛队伍采用自主导航方式。 但如果终点不是赛道上的冲线,而是某栋写字楼的前台呢? 在 Vbot(维他动力)展示的一段导航演示中,机器…
清华系创业公司新作:机器人看了 100 万小时人类操作,学会自己想办法
螺丝、包装袋、瓶盖,这些日常物件全都是为人手设计,但机器人的末端执行器大多还停留在两指夹爪。想要打造能在真实世界落地的通用机器人,灵巧手操作是绕不开的一关,而真正的瓶颈在于操作经验。通用模型需要见过足够丰富、大规模的真实操作样本,可机器人只…
Jim Fan、韩松团队提出 Robota-Embed:机器人检索经验,动作比画面更关键
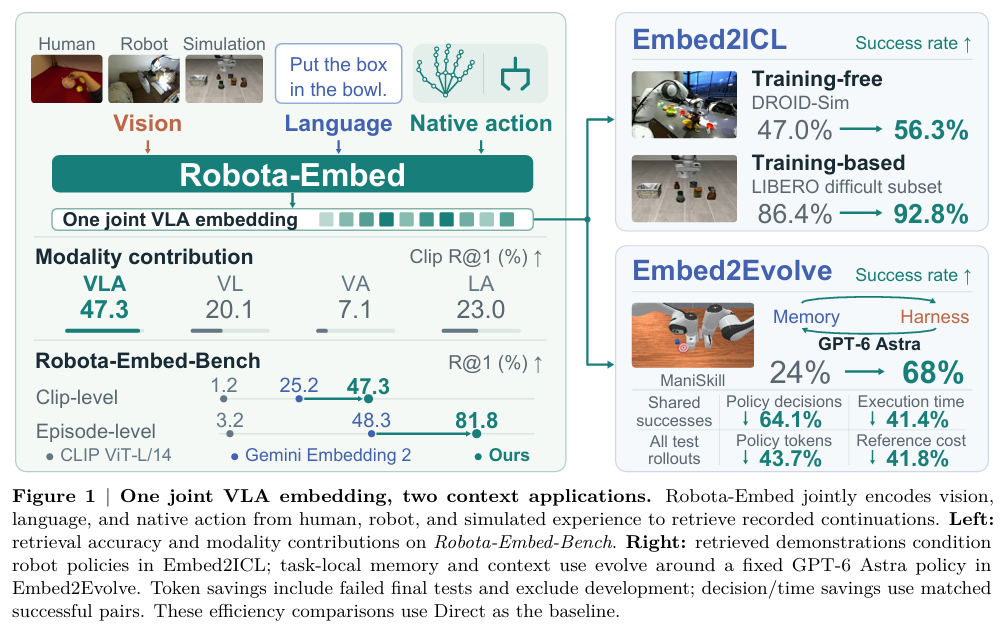
具身智能机器人想要复用过往操作经验,普遍会检索历史示范视频,模仿曾经成功的操作。 但传统检索大多只比对画面外观:只要桌子、物体看起来一致,就判定是匹配片段,忽略机械手当下的运动方向。同样的纸箱、同一段胶带,封箱和撕胶带两张画面几乎看不出差别…
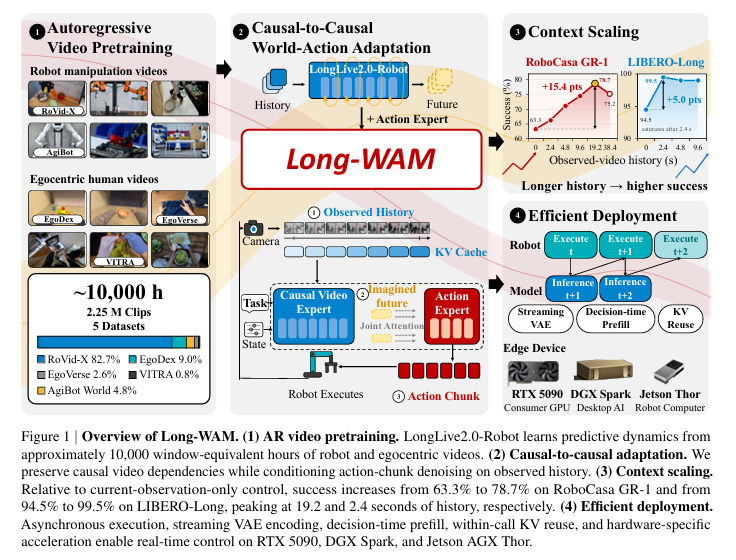
英伟达 Jim Fan 团队新作:只拉长历史解决不了 WAM 短板,核心需靠自回归预测
Long WAM 发现「能拿到历史」不等于「会用历史」:只有视频底座先以自回归方式学会从过去推未来,拉长上下文才能真正实现性能上涨。基于这一结论,团队将这套世界动作模型打造为可在边缘设备实时运行的系统。上下文时长从 0 秒拓展至 19.2 …
对话启元首席科学家董豪:机器人进家之前,先把「学费」打下来
今年 9 月,在智能机器人与系统国际会议(IROS 2026)期间,启元机器人与北京大学董豪团队举办了一场面向真实家庭场景的双臂操作挑战赛。参赛者利用示范数据训练模型,入围模型再部署到真实机器人上,执行开洗衣机门、装衣服、叠衣服等任务。最终…
「摔倒」方显真差距,I-BFM 把物理交互训进行为基座模型
这两年有不少惊艳的机器人搬箱子的 demo,但不知道大家是否有注意到一个细节,绝大多数 demo 里,一切都是按剧本走的。箱子摆在它该在的位置,机器人站得笔直,一遍过,没有任何干扰,甚至大部分镜头里都没有人的出现。 现实世界不是这样。手会没…
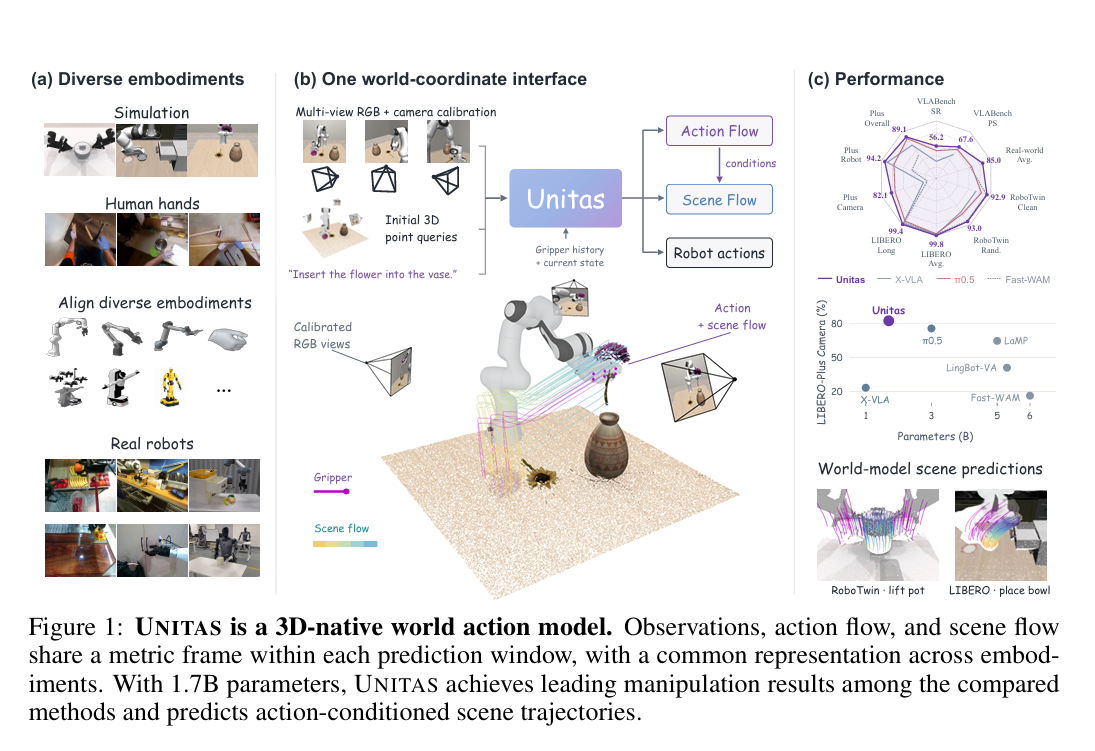
贾奎团队新作:让世界动作模型真正理解三维空间
UNITAS 将观测、动作与场景变化统一至同一个米制三维坐标系:以点轨迹表征人手与夹爪的运动,用场景流描述场景点的位移,让世界动作模型不再单纯依靠图像推测环境演化。模型参数量仅 1.7 B,在 LIBERO 基准测试上取得 99.8 % 任…
触觉,开始争夺传感器之外的生意
在美国匹兹堡举行的 IROS 2026 上,Sharpa 一口气发布了三款产品:一体式触觉感知灵巧操作机器人 D01、全手触觉灵巧手 W02,以及支持触觉反馈的外骨骼数据手套 AE01。 Sharpa 联合创始人李一帆此前在接受采访时曾表示…
杨立昆 JEPA 最新论文,端到端规划的下一程在哪?
有关具身智能,JEPA 是世界模型内一个无法回避且值得反复讨论的技术路线。它拥有很多颇具希望的特质:更好的抗干扰能力、更高效的计算与训练效率、极低的数据标注依赖......更重要的是,JEPA 基于表征学习来捕捉物理世界的规律,从而进行实 …
智在无界卢宗青团队提出 Being-M0.7,依托人类视频动作先验,训练人形机器人全身移动操作
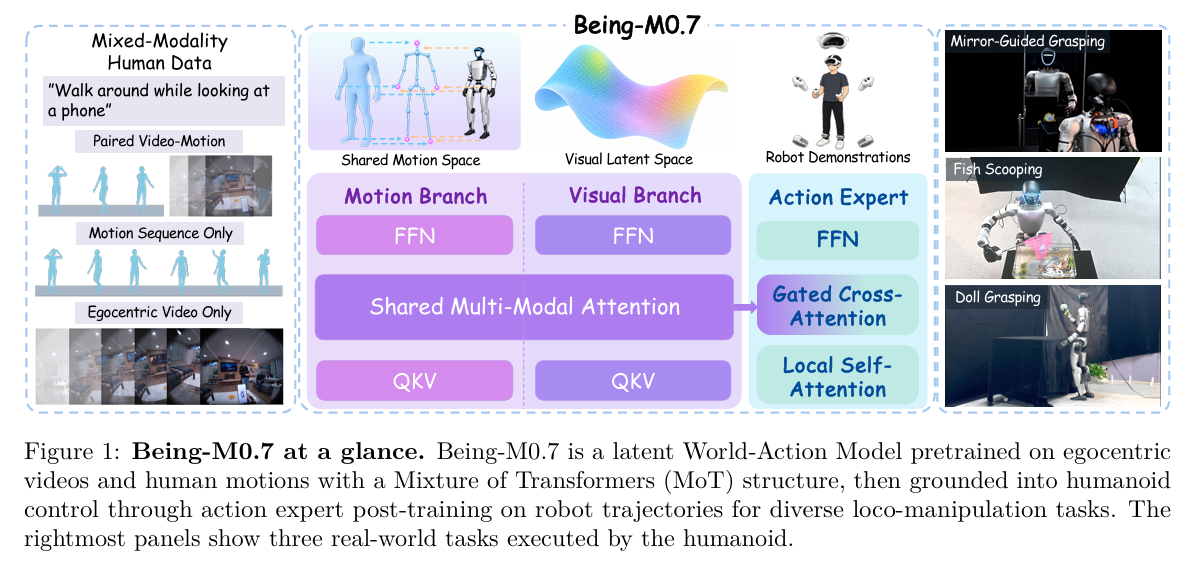
Being M0.7 依托一万余小时人类第一视角视频与人体动作数据,学习画面与全身动作的联合先验,再通过机器人轨迹完成中训与动作后训练,输出人形机器人全身移动 + 操作的控制指令。模型在 SIMPLE 仿真基准中综合成功率 71.1%,位列…
中科院自动化所与高德团队提出 DreamTrue,将机器人动作统一渲染为画面条件,实现高精度未来视频预测
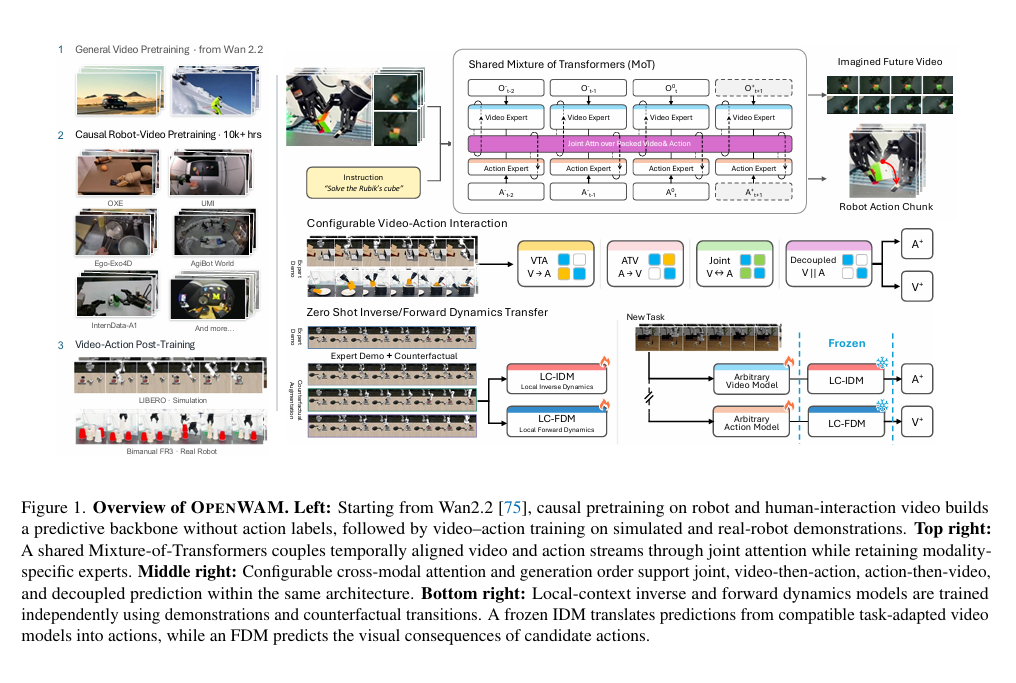
DreamTrue 将机器人动作渲染为画面内的机器人作为训练条件,为世界模型补充示范数据中缺失的失败动作,并依托人工标注训练得到的奖励模型开展强化学习。当动作执行失败时,模型能够如实预测对应的结果,它在 AgiBot 平台上将交互缺陷率从 …