

清华大学、银河通用将 552B 视觉语言表征用于机器人精细操作
视觉语言模型在大规模图文预训练中积累了物体识别、空间理解和指令处理能力。前沿模型开始展现机器人操作能力,但不少视觉—语言—动作模型(VLA)的视觉语言主干仍然较小。
大模型从图文数据中学到的表征,能否转化成更省示范、更适合精细操作的机器人策略?
11 月 16 日,清华大学、北京大学、上海交通大学与银河通用的研究团队公开了论文《ScaleVLA: Scaling Vision-Language-Action Models to 552 Billion Parameters》(中文可译为《将视觉—语言—动作模型扩展至 5,520 亿参数》)。
论文共 12 位作者,四位共同一作分别为 Ruixi Yu(清华大学、银河通用)、刘岱儒(北京大学、银河通用)、Xuchuan Chen(清华大学、银河通用)和 Zekun Qi(清华大学、银河通用)。Zekun Qi 同时也是项目负责人。
通讯作者分别是北京大学计算机学院助理教授、银河通用创始人兼 CTO 王鹤和清华大学交叉信息研究院助理教授弋力,弋力同时拥有斯坦福大学博士背景,曾任 Google Research 研究科学家,参与过 PointNet++ 等三维视觉研究。
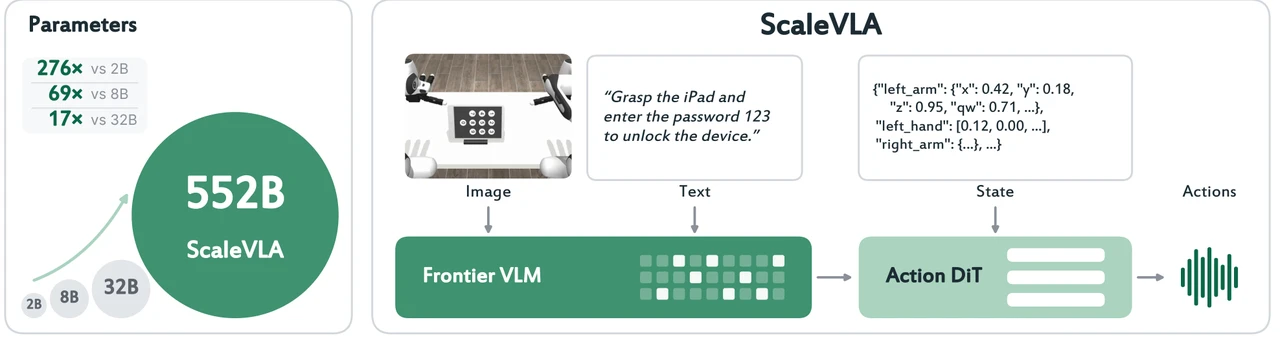
为研究前沿视觉语言表征能否支撑更省示范的机器人策略,团队提出 ScaleVLA:冻结 552B DeepSeek-V4.1-Flash 视觉语言骨干,由独立训练的动作扩散 Transformer 读取图像、指令和机器人状态,输出连续动作片段。
团队先在模拟环境中比较不同规模的视觉语言主干,固定动作模块、示范数据和训练预算;再把策略放到双臂机器人上,执行充电器抓取、双臂交接、插头对齐和插入,并改变充电器或插座的位置进行测试。
论文报告,在 LIBERO-Goal 中,ScaleVLA 使用每个任务 10 条示范时,成功率为 87.8%,高于 2B 主干使用 50 条示范时的 85.6%;在 LIBERO-PRO 中,平均成功率为 45.1%,小模型最高为 31.3%;真机参考布局测试中,充电器插入成功 9/10 次,2B 主干为 4/10 次。
这些结果的关键在于,视觉语言模型怎样把图像和指令转成动作模块能够使用的信息;同时,552B 参数的主干需要能在机器人控制流程中运行。
理解 ScaleVLA,要先看视觉语言主干输出什么,以及动作头如何把特征变成机器人指令。
让预训练表征进入动作
ScaleVLA 把视觉理解和动作生成分给两个模块。视觉语言主干读取相机画面与任务指令,动作头结合这些表征和机器人状态,输出一段连续动作。前者提供大规模预训练形成的视觉与语言信息,后者通过机器人示范学习具体的执行方式。
主干采用 DeepSeek-V4.1-Flash-1017,总参数量为 552B,采用混合专家结构。相机图像先经视觉编码器转换为视觉 token,再与任务指令一起进入语言主干。语言主干由 20 层因果编码器和 20 层解码器组成。ScaleVLA 运行因果编码器,读取其中形成的视觉和文本特征,在进入解码器前停止计算。每个 token 的顺序和模态标记都会保留,动作头因此能区分哪些信息来自图像,哪些来自指令。
这种接法改变了大模型在控制系统里的位置。论文讨论 GPT-6 Astra 等相关工作时提到,通用模型可以借助物理反馈改进操作,但反复推理和复核动作会增加决策时间。ScaleVLA 读取主干形成的特征,再交由动作头完成动作生成;语言解码器不参与这段执行过程。
视觉语言模型的特征不能直接变成机械臂指令。团队在主干和动作头之间加入特征适配器:先对特征做归一化和线性投影,把每个 token 从 5,120 维映射到 2,048 维,再通过四层自注意力 Transformer,让图像与语言特征在动作监督下进一步交互。它既统一了输入尺寸,也让模型学习哪些视觉线索与当前指令、动作相关。
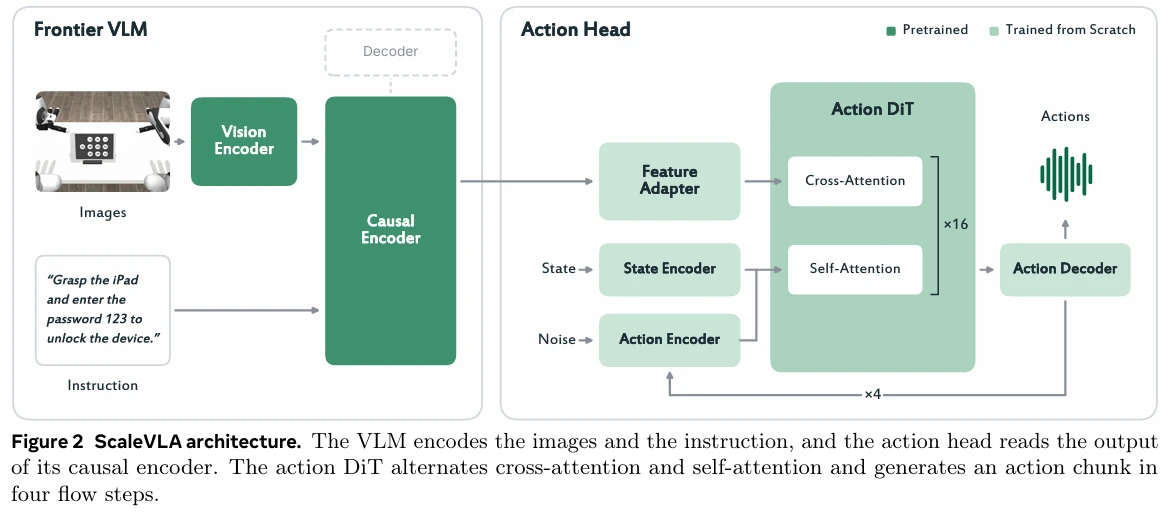
动作头还要读取机器人当前状态。论文为状态和带噪动作分别设置编码器,并针对机器人本体设计多层感知机。动作序列中的每一步都会成为带位置标记的 token,模型还会接收当前的流动时间信息。动作预测由此同时参考画面、指令、机器人状态,以及动作序列当前的生成阶段。
负责生成动作的是扩散 Transformer(DiT)。它由 32 层交替排列的自注意力和交叉注意力组成:自注意力让机器人状态与不同时间步的动作相互参照,交叉注意力从适配后的图像、文本特征中读取信息。动作解码器将 DiT 输出转换为整段动作的预测速度,供后续生成过程逐步更新。
团队沿用了英伟达 GR00T N1.7 的动作头架构,但动作侧各模块都从随机初始化开始,再使用机器人示范训练。对比实验也没有加载预训练的机器人动作专家。视觉语言主干提供预训练表征,动作头学习连续控制,两者的分工构成了 ScaleVLA 的基本结构。
从示范到动作块
ScaleVLA 的训练不更新 552B 参数的视觉语言主干。团队先用冻结主干提取示范数据中的图像与指令特征,并将这些特征缓存下来;训练时更新的是动作侧的特征适配器、状态与动作编码器、DiT 和动作解码器。这样不必在每次动作模块参数更新时重新计算整套视觉语言特征。
论文报告,训练使用 64 张 NVIDIA H200 GPU,分布在 8 个节点上,全局 batch size 为 640。LIBERO 的完整数据训练使用 5,000 步 AdamW 优化,学习率为 1e-4,并配合余弦衰减和 5% warm-up;DexJoCo 使用 20,000 步。机器人状态和动作值根据训练数据的第 1 和第 99 百分位进行归一化。
动作头通过流匹配学习如何生成动作块。训练时,团队从示范动作和随机高斯噪声出发,抽取一个流动时间,将噪声与示范动作按比例线性混合。模型看到的有时接近随机噪声,有时已经接近真实示范;它需要根据视觉语言特征、机器人状态和当前混合程度,预测从噪声走向示范动作的变化方向。
这项训练不是让模型逐字输出一串机器人指令,而是让它学习整段数值动作如何从噪声逐渐形成。损失函数在有效动作维度和时间步上计算,状态和动作都用训练数据的百分位数归一化。由于视觉语言主干被冻结,训练过程中计算得到的主干特征可以重复使用。
推理时,动作头从随机噪声开始,按照预测出的方向经过四步更新,得到一个动作块。四步更新复用同一批视觉语言特征,因此主干对每个动作块只运行一次。ScaleVLA 在 LIBERO 中预测未来 16 步,先执行其中 8 步,再根据新观测重新规划;在 DexJoCo 中预测 30 步,并通过带时间戳的指令缓冲,在控制器执行已有动作时异步生成下一段动作。
在 RoboCasa 的测时中,ScaleVLA 的动作块中位延迟约为 216 毫秒,Cosmos-Reason2-2B 约为 115 毫秒。虽然 ScaleVLA 的主干总参数是后者的 276 倍,但动作块延迟没有按参数量同比例增加。
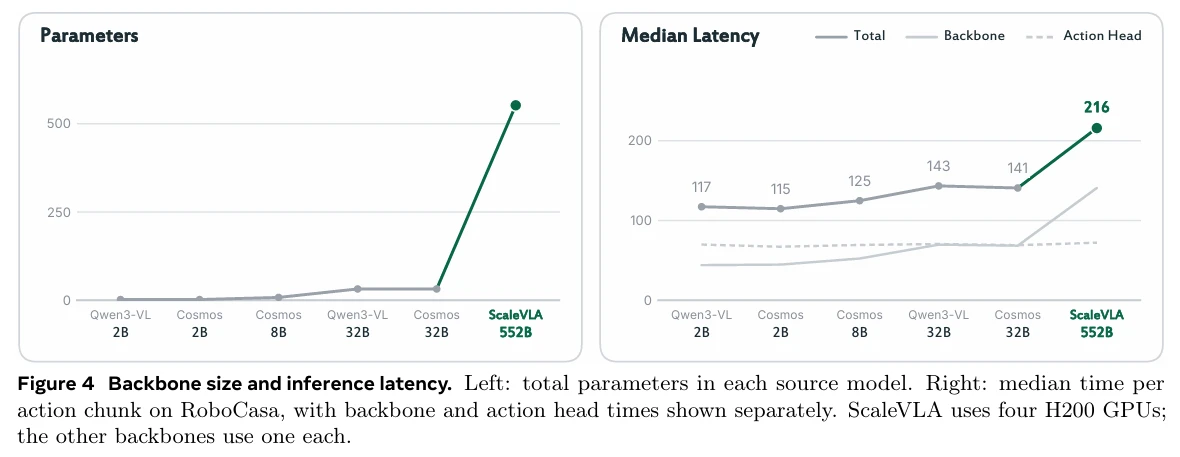
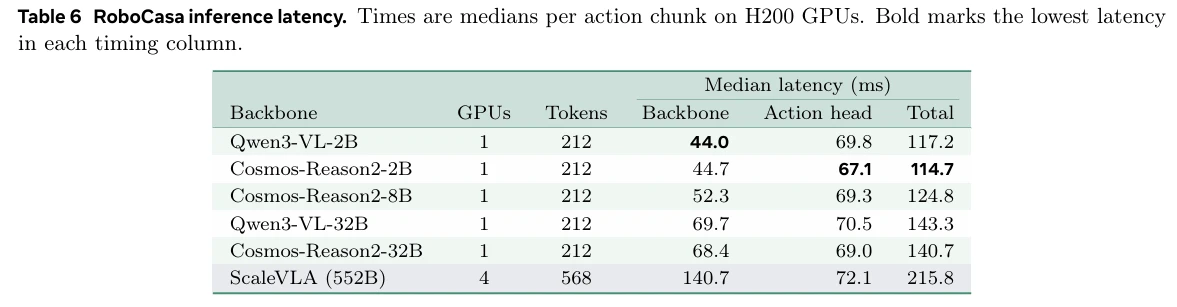
表中时间是从客户端发送观测到收到动作块的往返延迟。动作头的耗时在不同主干间都约为 70 毫秒;小主干扩展到 32B 时,增加的时间主要来自视觉语言主干推理。ScaleVLA 使用 4 张 H200 GPU,2B 主干使用 1 张;两者每次输入的 token 数也不同,分别约为 568 和 212。这个结果说明其测得延迟增长低于参数量增长,但不能直接当作同等硬件配置下的效率比较。
动作块延迟也不等于机器人的底层控制频率。LIBERO 中,模型预测 16 步动作后只执行前 8 步,再获取新观测重新规划;实际操作还包括机械臂执行、等待反馈和下一轮动作推理。论文在真机充电器任务中测得每动作块往返延迟为 384 毫秒,和完整任务需要多长时间是两种不同指标。
数据效率与泛化
团队用四类模拟测试观察 ScaleVLA 的表现:LIBERO 评估语言指令下的桌面操作,LIBERO-PRO 在原任务基础上改变物体或环境,RoboCasa 测试不同厨房场景,DexJoCo 则包含双手协同的灵巧操作任务。这些基准覆盖从常规桌面操作到场景变化、双手协调等不同条件。
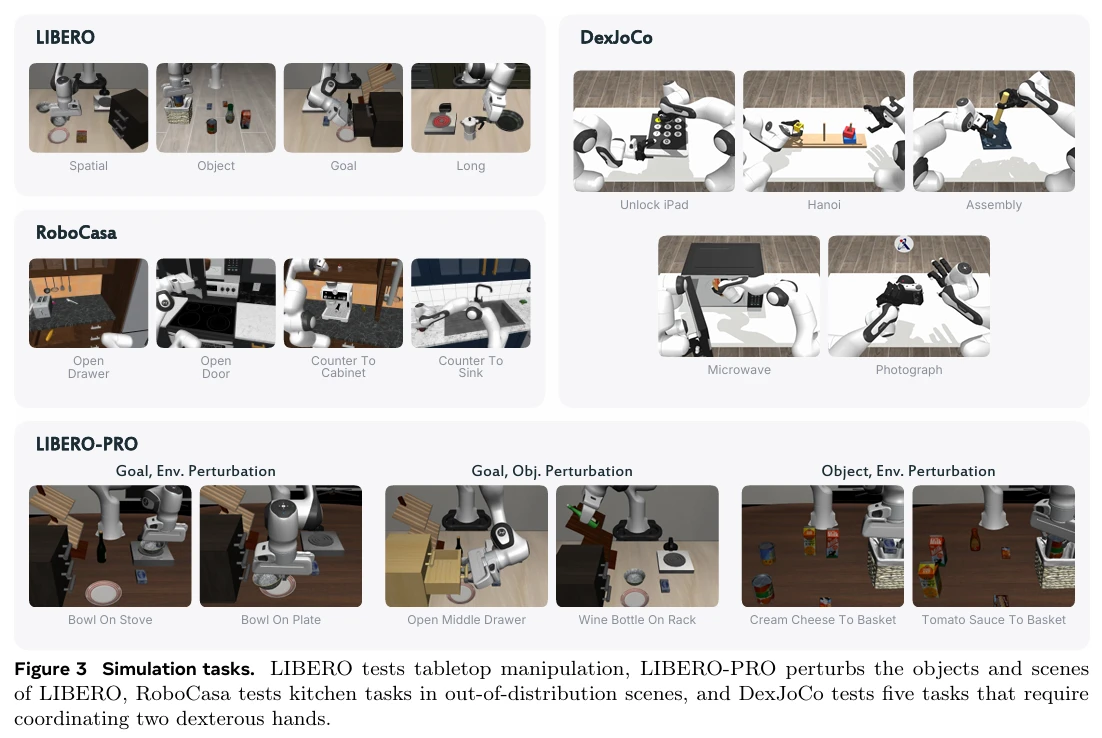
在 LIBERO 的完整示范数据设置中,ScaleVLA 四个任务套件的平均成功率为 96.1%,高于 Cosmos-Reason2-2B 的 90.7%。不过,Spatial 和 Object 两类任务中,多种模型的成绩已经接近饱和;差距更明显的是需要理解目标指令的 Goal,以及需要串联多个步骤的 Long。ScaleVLA 在这两组的成功率分别为 96.8% 和 90.2%。
LIBERO-PRO 检验的是训练后不重新调整策略,直接面对环境或物体扰动时的表现。团队用 LIBERO 策略在扰动后的设置中测试,ScaleVLA 的平均成功率为 45.1%,小模型中的最高值为 31.3%。但不同扰动类型下结果并不一致:在 Object 套件的环境扰动中,ScaleVLA 为 31.2%,略低于其他主干的最高值 32.4%。整体均值支持它有更好的迁移表现,单项任务仍会受到扰动类型影响。
RoboCasa 把策略放进训练时未见过的厨房场景,分别使用每个任务 30 条或 100 条生成示范。ScaleVLA 在两种数据量下的成功率为 30.7% 和 54.9%;小模型中的最好结果为 25.6% 和 45.6%。这个基准测试的是模拟厨房中的场景泛化,不能直接等同于真实厨房中的部署效果。
DexJoCo 包含解锁平板、汉诺塔、装配、微波炉和拍照五项双手任务,每项使用 100 条人类示范。物体随机化设置下,ScaleVLA 平均成功率为 42.1%,小模型最高为 38.1%;完整随机化后分别为 24.4% 和 22.1%。完整随机化仍然很难,装配任务中所有模型的成功率都很低,ScaleVLA 也只有 1.3%。扩大主干改善了部分多任务表现,但没有消除任务本身的难度。
样本效率测试在 LIBERO-Goal 和 Long 中进行,每个任务分别使用 5、10、25 或 50 条示范,训练步数固定为 5,000。下表只保留 Goal 中最能说明数据量差异的两组:
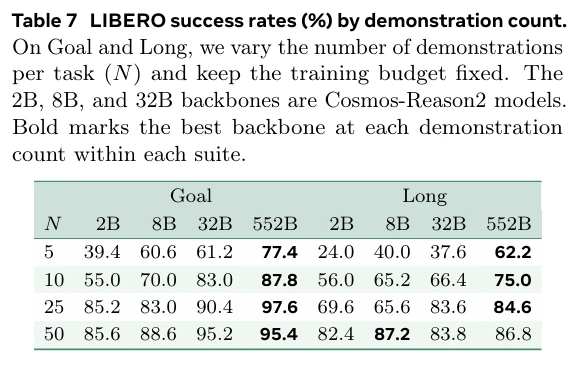
每个任务使用 10 条示范时,ScaleVLA 的成功率为 87.8%,高于 2B 主干使用 50 条示范时的 85.6%。使用 5 条示范时,ScaleVLA 为 77.4%,2B 主干为 39.4%。随着示范数量增加,两个主干的差距总体缩小;对于需要串联更多步骤的 Long,增加示范仍能继续改善结果。
「10 条示范」有明确口径:这些轨迹用于策略参数更新,但该实验的状态和动作归一化统计仍使用完整训练集的信息。因此,这个数字说明的是策略更新使用的示范数,并非预处理阶段也只获得了这 10 条数据。每个策略只训练了一个随机种子,示范子集来自同一组嵌套序列;结果需要在其他随机种子和示范子集上继续复核。
插入难在最后一步
团队把三种策略放到双臂机器人上执行充电器插入任务。右臂抓起手机充电器并交给左臂,左臂再把插头对准插线板插孔、插入并松手。机器人通过顶部相机和两只腕部相机观察操作。这项任务同时涉及抓取、双臂交接、空间对齐和接触操作,可以检验视觉语言表征在真实动作中的作用。
真机训练数据包括 171 段完整遥操作演示,以及 132 段聚焦插入动作的片段,共 303 个 episode、约 52 万帧,另留出 26 个 episode 验证。多数完整演示从主要充电器位置附近开始,少量演示包含位置偏移。三种策略使用相同的动作 DiT、训练数据和训练预算;其中 π0.5 经过大规模机器人数据预训练,可以作为判断机器人预训练能否弥补视觉语言主干规模差异的参照。
每种策略进行 10 次参考布局测试和 15 次分布外测试。参考布局从主要训练位置附近开始;分布外设置会移动或旋转充电器,也会改变插线板的位置。成功标准是插头插入插孔后,左夹爪松开充电器。这样统计的是完整插入结果,而不是机械臂将插头移动到插座附近就算成功。
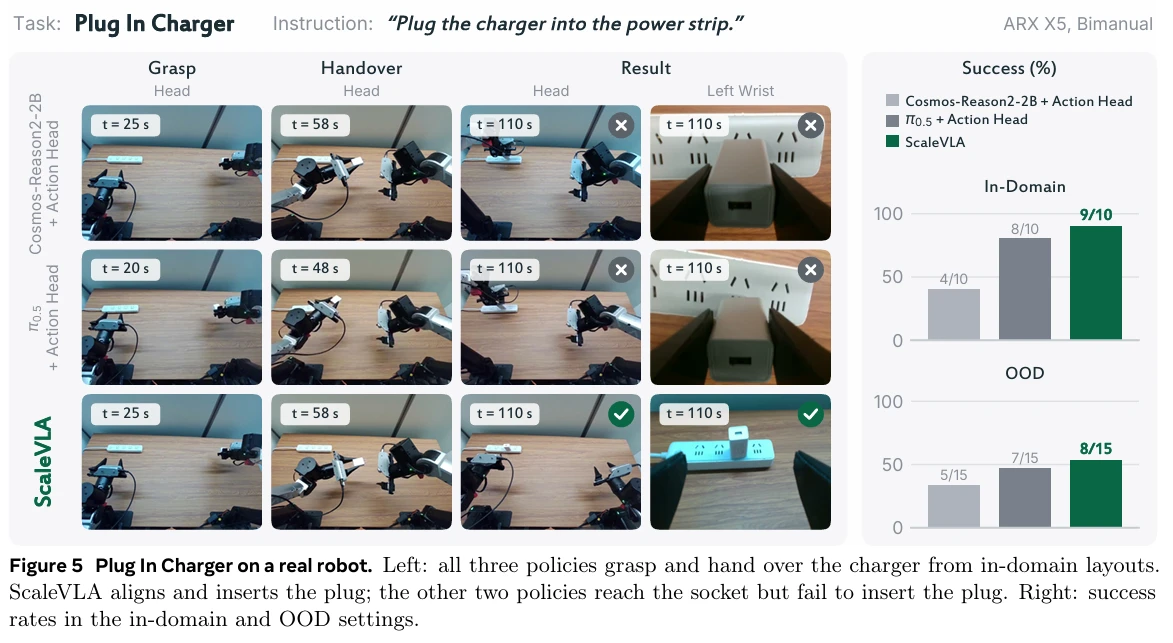
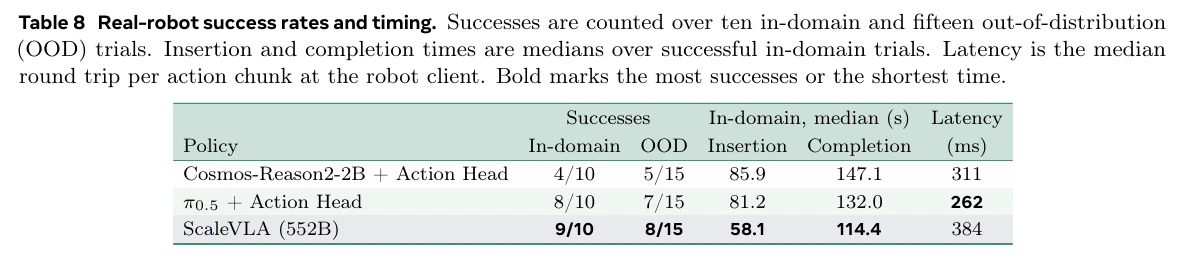
成功试验中的抓取与交接耗时相近,差异主要出现在插入阶段。论文演示中,另外两种策略能把插头移到插孔附近,却没有完成插入;ScaleVLA 更常完成接触后的对齐和推进。论文报告,所有参考布局失败都发生在插入阶段。ScaleVLA 成功试验的插入中位时间为 58.1 秒,低于另两种策略。
每动作块延迟呈现出另一面:ScaleVLA 为 384 毫秒,高于 π0.5 的 262 毫秒;但成功试验的整体完成时间中位数为 114.4 秒,短于 π0.5 的 132.0 秒。模型生成一个动作块需要多久,与机器人最终完成任务需要多久并不相同。更准确的插入动作减少了后续调整时间,抵消了更长的推理延迟。
真机证据目前集中在一项充电器插入任务,每种策略测试 25 次,训练各使用一个随机种子;成功与否由操作人员判断。分布外测试主要改变充电器和插线板的空间位置,尚未覆盖更多物体、机器人和接触任务。因此,这些结果说明 ScaleVLA 在这套双臂插入任务中展示出较好的对齐和插入表现,还不足以说明它能普遍处理各种真实操作。
ScaleVLA 展示了一种把前沿视觉语言表征用于机器人策略的方式:冻结视觉语言主干,由动作模块读取图像、指令和机器人状态,生成连续控制。模拟测试报告了样本效率和部分泛化表现,真机实验则把增益集中呈现在接触后的对齐与插入阶段。
论文也显示,这条路线仍有明确条件:552B 主干需要更多 GPU,真机验证目前只有一项任务。当前证据支持继续检验大规模预训练表征对机器人学习的作用,尤其是在示范有限、场景变化或接触控制要求较高的任务中。
发现文章有错?告诉我们