

UC 伯克利团队提出 SuperMimic,单卡训练 3 小时超越 128 卡基线
作者:江思奇
UC 伯克利团队提出 SuperMimic,单卡训练 3 小时超越 128 卡基线
人形机器人想要掌握行走、跳跃乃至空翻,背后需要多大的训练算力?
过去的常规做法,是让机器人在模拟器内不断试错,依靠强化学习优化动作控制策略。动作库规模越大,对应的训练成本也水涨船高。
10 月 14 日,英伟达、麻省理工学院、加州大学伯克利分校、牛津大学、卡内基梅隆大学联合团队发表论文《Robota-Embed: Unified VLA Embeddings for Robot In-Context Learning and Evolution》。论文共 19 位作者,刘昀泽、Jing Wang 为共同第一作者,英伟达研究科学家蔡涵担任通讯作者。
作者名单中还包括了英伟达 GEAR 团队共同负责人朱玉可、伯克利人工智能研究实验室(BAIR)创始共同负责人 Trevor Darrell、英伟达 GEAR 团队共同负责人 Jim Fan,以及以模型压缩和高效 AI 计算研究知名的麻省理工学院副教授韩松。
这项研究瞄准一大训练瓶颈:随着动作库持续扩容,能否脱离集群级算力,依然训练出适配大规模动作集的统一控制器?
论文数据显示,SuperMimic 仅用单张 NVIDIA H100 GPU 训练 3 小时,归一化回报指标便优于基线 SONIC 的公开模型。SONIC 则动用 128 张 NVIDIA L40 GPU,训练时长约 7 天。按论文统计口径,SuperMimic 的 GPU 小时开销降低超 1,000 倍。
团队还把训练完成的控制策略部署在宇树 Unitree G1 人形真机,成功实现跳跃、侧滚、空翻等动作。
SuperMimic 的核心思路,并非为每个动作单独训练独立控制器,而是依靠单个可微世界模型,支撑整套动作库的学习。
先学会身体怎么动
先拆解老方案成本高昂的根源。当下主流动作跟踪大多采用无模型强化学习,代表算法为近端策略优化(PPO)。这类方法将物理仿真器视作黑盒,依靠海量采样评估动作优劣。采样过程噪声高,只能依靠大规模仿真压低误差;动作库越大,所需仿真量就越多,最终只能依靠堆砌算力。
SuperMimic 的核心改进是引入世界模型。世界模型本身是神经网络,输入机器人当前状态与动作,预测下一时刻状态,同时输出即时奖励、机器人观测信息以及摔倒风险。得益于可微特性,策略能沿着网络反向传递梯度至每一步动作,直接获取参数调整方向,该方法即沿时间反向传播(BPTT)。
**SuperMimic 用单个世界模型支撑整套动作库学习。**所有动作共享同一套机器人本体动力学,新增动作片段仅为模型补充身体与接触交互的样本,无需扩充模型容量。
团队并未修改仿真器。世界模型从普通刚体仿真器生成的数据中学习,仿真器本身不需要支持可微计算,碰撞接触这类非光滑物理过程依旧交由原生仿真器处理。
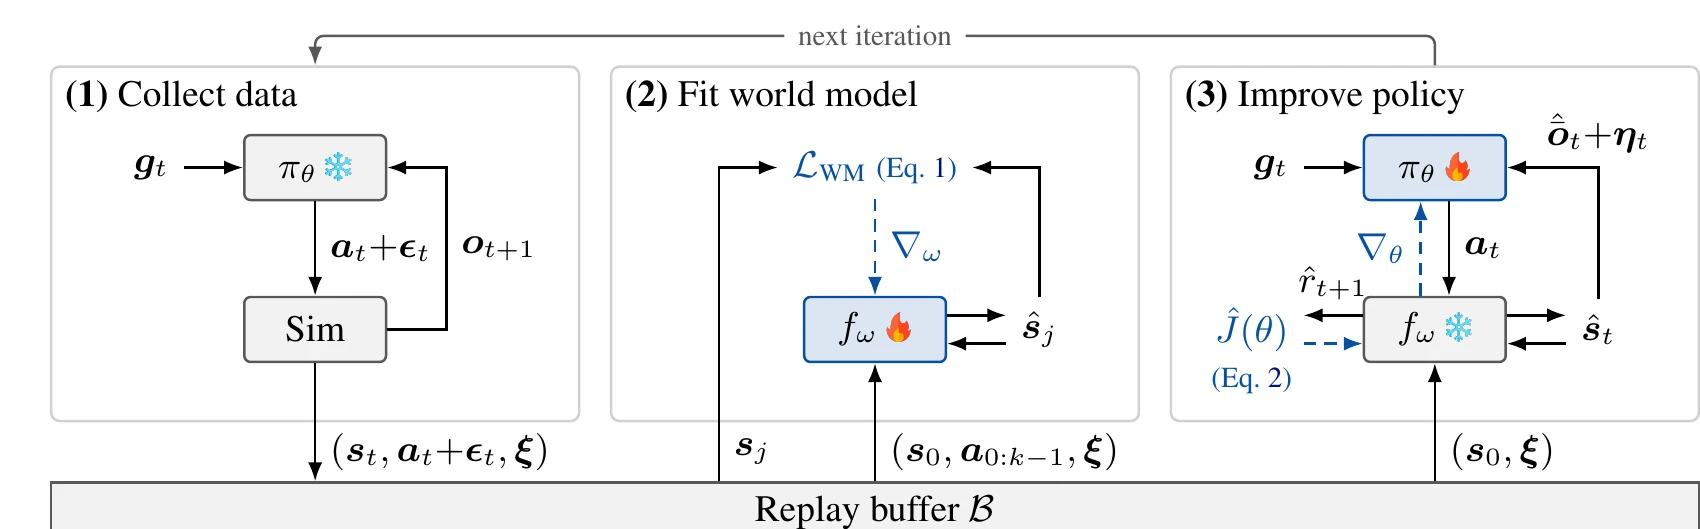
图片展示了SuperMimic的三步训练循环。第一步,策略πθ在仿真器Sim中运行,经历存入回放缓冲区,新数据挤掉旧数据;第二步,从缓冲区抽取片段,世界模型fω按动作预测并和真实结果对齐;第三步,冻结世界模型,策略在它里想象32步,想象回报反向传播回策略。循环中还涉及损失函数LWM、策略更新等。该图与上下文紧密相关,直观呈现了SuperMimic的训练流程。
整套训练是三段循环流程。
第一步,当前策略在仿真器中采集轨迹存入回放缓冲区,新数据覆盖老旧样本;
第二步,从缓冲区抽取连续 8 步片段,世界模型从初始状态出发,依照历史动作做递推预测,并和真实轨迹做对齐;
第三步,冻结世界模型,让策略在模型中推演想象 32 步,再将虚拟推演得到的回报反向传播更新策略。
三个步骤交替迭代,世界模型与策略同步优化。旧策略采集的数据依旧可用于训练世界模型,因为机器人本体动力学和采集数据的策略无关,数据利用率更高。
数据采集阶段会为动作叠加噪声,拓宽世界模型见过的动作分布。仿真中的随机变量,例如地面摩擦、关节标定误差、躯干重心偏移,都会作为额外输入给到模型。借此,世界模型可以保持确定性,预测结果更加稳定。
虚拟推演仅向前预测 32 步,远期回报交由评价网络(critic)预估,评估后续能获取的总奖励。这使得世界模型只需保证 32 步内预测精度。团队也提到,训练过程中模型会自主修正预测偏差,实际能够实现更长时段的稳定推演。
策略输入为机器人本体感知信息:29 个关节位置与速度、IMU 输出的角速度、重力方向以及上一步动作,取最近 10 帧。优化目标是参考动作后续 10 帧轨迹。模型网络均采用多层感知机;世界模型动力学网络共 3 层,每层 2,048 个神经元。
两轮筛出 129,514 条动作
确定训练方案后,还需要规模充足、物理可行的动作库。团队选用公开数据集 BONES-SEED 中已映射至 G1 机器人的动作片段,原始总量 142,220 条。其中大量样本涉及爬楼梯、搬箱子、坐椅子等场景,或是存在映射错误,平地环境下的 G1 无法执行,需要预先过滤。
第一轮为关键词粗筛。每条动作以行为命名,名称包含楼梯、梯子、箱子、椅子、坐下、攀爬等关键词的样本直接剔除。关键词列表改编自 SONIC 公开的数据处理代码,并由团队补充遗漏词条。本轮筛除 12,553 条,剩余 129,667 条。
第二轮做物理可行性校验,专门过滤名称无法识别的无效动作,例如走到箱子上。团队将每条动作放入 MuJoCo 执行运动学回放,监测机器人身体最低点高度。最低点连续 0.6 秒高于 0.20 米判定为踩踏异物,低于 - 0.12 米判定腿部穿模入地面,静止状态下双脚离地超过 0.02 米且持续 0.5 秒,同样标记为不可行。本轮再剔除 153 条,最终得到 129,514 条有效动作,总时长约 264 小时。
该动作库对应 SONIC 公开训练子集。SONIC 使用的动作总时长 611 小时,而 SuperMimic 仅需 264.56 小时,数据量减少约 2.3 倍。
训练时,机器人不会固定从动作起始位置重启。团队将动作时间轴切分为 1 秒片段,并记录各段得分。环境重置策略采用混合采样,50% 概率均匀随机选取,40% 偏向采样低分困难片段,10% 依据历史难度采样,保证已学习的高难度动作可以反复复习。
训练配置方面,单块 GPU 启动 4,096 个仿真环境,每次策略更新使用 4,096 条虚拟推演轨迹,总计训练 320,000 轮。仿真器采用 GPU 版 MuJoCo Warp,控制频率 50 Hz。全部算力开销在 Lambda 云的 NVIDIA H100 上实测。团队使用多组随机种子重复实验,训练过程稳定,论文将这一特性归因于动作跟踪任务逐步设置奖励。
单卡 3 小时,失败从 179 条降到 25 条
先看 SuperMimic 和 SONIC 的正面对比。二者统一沿用 BeyondMimic 的动作跟踪设定,SONIC 是当前最具参考价值的公开基线。评测指标采用归一化回报,代表整段动作总得分与满分的比值,机器人中途摔倒就会拉低分数。
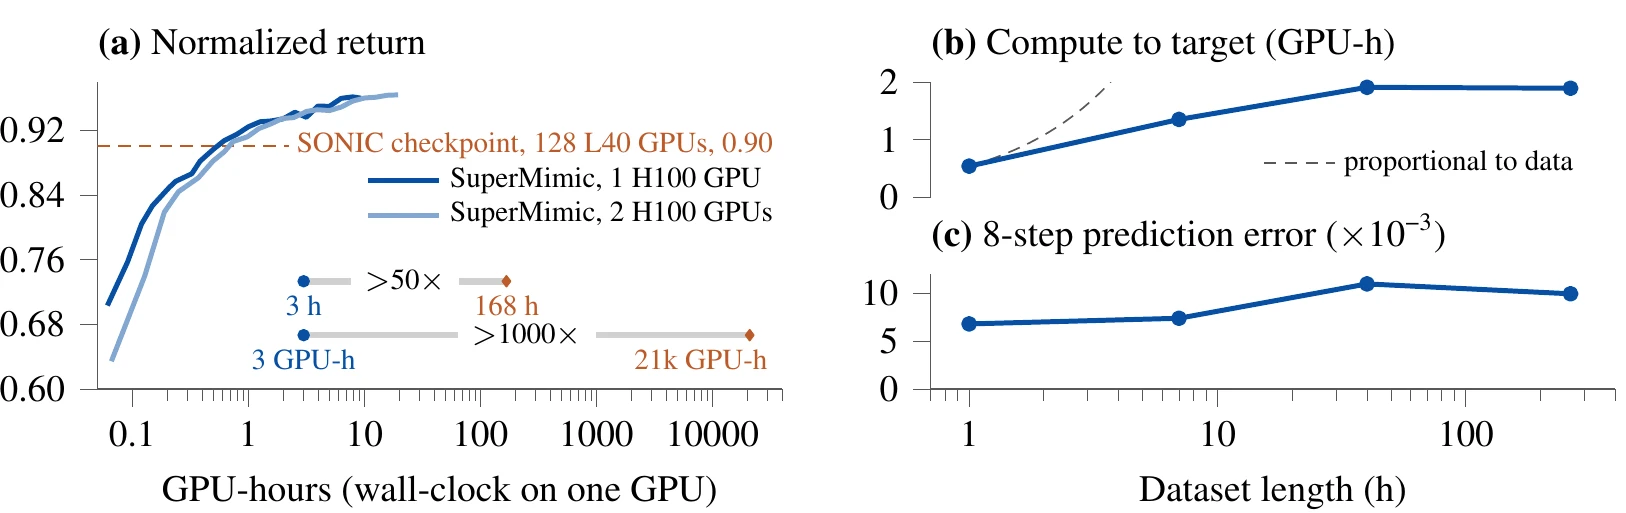
这张图共有三个子图,(a)为归一化回报对比图,对比了SuperMimic在1块H100 GPU、2块H100 GPU上的得分,以及SONIC用128块L40 GPU训练的模型得分,还标注了不同时长对应的算力消耗,清晰体现SuperMimic单卡3小时的训练表现就超过了128卡基线;(b)为达到目标所需算力随数据集长度变化的折线图,(c)为8步预测误差随数据集长度变化的折线图,两者分别呈现了算力和预测误差的变化情况,反映出随着训练时长增加,达标所需算力增长缓慢,世界模型预测误差也保持稳定。
**单张 H100 训练 3 小时后,SuperMimic 得分即可超越 SONIC 模型,后者依靠 128 张 L40 训练 7 天,最终得分 0.90。**墙钟时间缩短约 56 倍,GPU 小时数缩减约 7,200 倍。团队对 3 小时这个节点取值偏保守,从该时间点之后,每一个保存的模型存档,在得分与失败动作数量上都优于 SONIC。这 3 小时统计完整训练循环,不包含后续评测耗时。
团队也说明了两组实验硬件存在差异。H100 的 fp32 峰值算力为 L40 的 0.74 倍,张量核心峰值算力为 L40 的 5.5 倍,但两组实验都没有跑满硬件峰值。团队认为,2.3 倍的数据量差距与最高 5.5 倍的硬件差距,无法解释上千倍的 GPU 小时开销差异。
在全部 129,514 条动作上逐一测试,SuperMimic 训练 3 小时后失败 25 条。SONIC 公开模型失败 179 条,SONIC v1.1 版本失败 239 条。SONIC 失效样本包含全部 44 个空翻、全部 22 个侧滚、整套舞蹈的 8 段动作,24 个立定跳远样本里也有 15 个执行失败。这些样本都属于双方的训练集,用来衡量模型对训练动作的覆盖完整度。
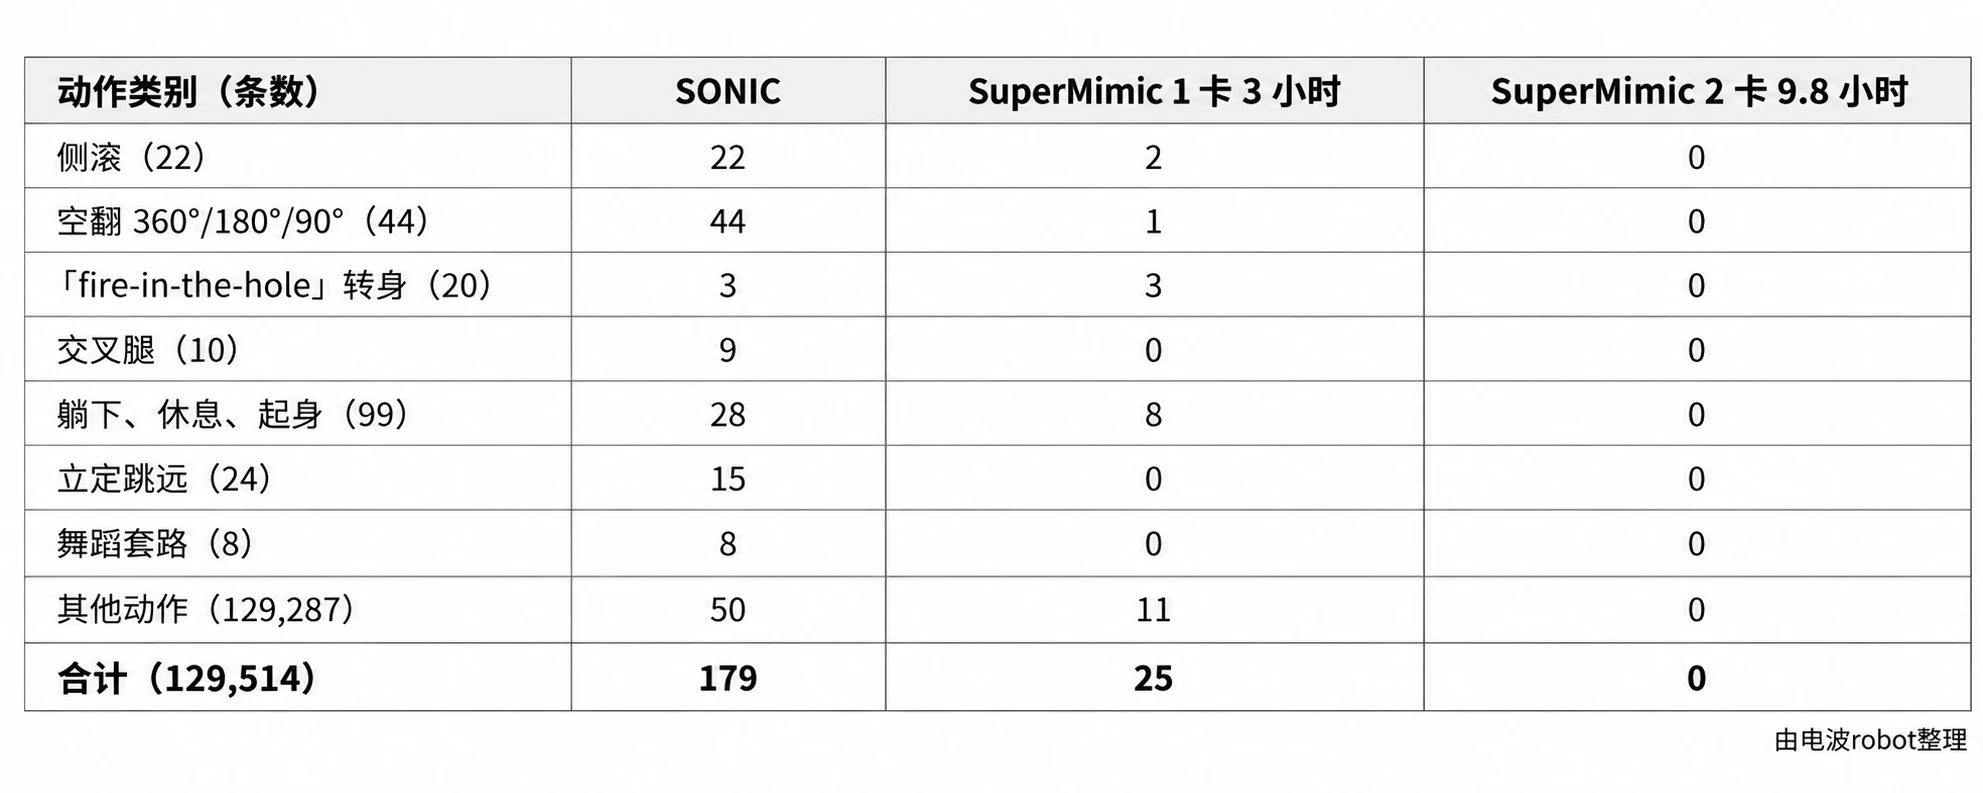
SuperMimic 的失败案例集中在少数高难度动作组。测试前五组合计 195 条动作,贡献 25 次失败里的 14 次。不存在任意动作组中,SuperMimic 失败数量高于 SONIC 的情况。使用两块 GPU 训练 9.8 小时后,模型实现全部动作零失败。
为消除实验设定带来的干扰,团队额外搭建严格对照基线 PPO-Sim。基线直接在仿真器运行 PPO 算法,动作、观测、奖励、摔倒判定、参数随机化、网络规模与评测规则全部对齐 SuperMimic,单卡仿真环境数量更是 SuperMimic 的两倍。测试选取 LAFAN1 数据集的 40 段动作,总时长 2.45 小时。
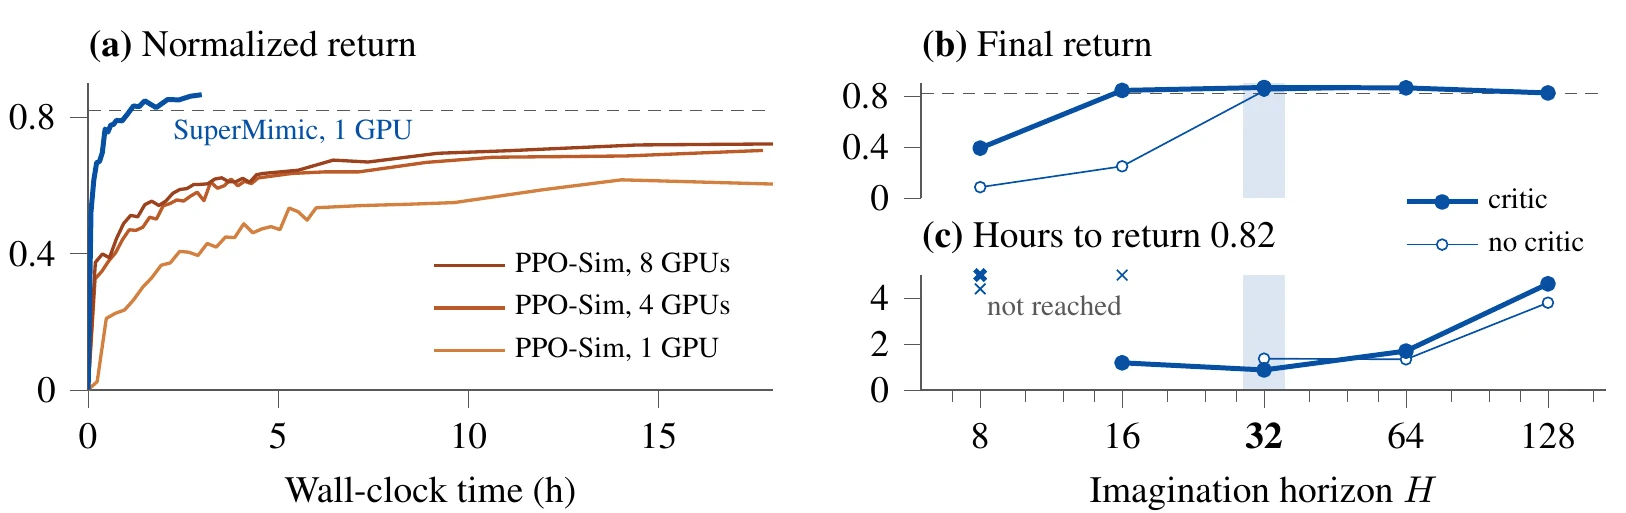
该图包含三个子图,是伯克利团队SuperMimic相关的实验结果图:左侧(a)图展示了SuperMimic(单GPU)与不同GPU数量的PPO-Sim方法,在LAFAN1数据集上的归一化得分随挂钟时间的变化,可见SuperMimic单GPU的得分上升速度最快,初始阶段就远超各数量GPU的PPO-Sim。右侧分为(b)(c)图,(b)图体现不同想象步数H下,有无评价网络的最终得分,在H=32时,有无评价网络的最终得分均达到0.8的较高水平;(c)图对应不同想象步数下,两种设置达到0.82得分的耗时,在H=32时,两者耗时相近,且仅当H不小于16时,两种设置都能达成目标得分。
实验结果显示,SuperMimic 单卡训练 1.2 小时即可拿到 0.82 分。PPO-Sim 在 18 小时算力预算内始终无法达到该分数。单卡训练最终得分 0.60,4 卡为 0.70,8 卡仅提升至 0.72,算力从 4 卡扩容至 8 卡几乎没有收益。
团队拆解出世界模型大幅节省算力的三点核心特性。
第一,模型预测稳定,性能不会随数据增长衰减。训练数据从 1 小时扩充至 264 小时,8 步预测误差稳定维持在 0.007 到 0.011 区间,达标所需 GPU 小时数仅缓慢上涨。
第二,推演速度更快。在 2,000 至 16,000 并行环境下,推演速度比 MuJoCo Warp 高出 10 倍以上,64,000 并行环境下提速可达 62 倍。
第三,梯度质量更高。针对 LAFAN1 里行走、奔跑、冲刺动作,在同一世界模型环境中,SuperMimic 达到 PPO 最优成绩所需的推演步数减少约 64 倍。本组对照全部在世界模型内运行,硬件速度条件保持一致,性能差距来自一阶梯度更新机制。
团队还单独验证评价网络的作用。移除评价网络后,推演步数上限 16 步时训练直接失败。加入评价网络,仅 16 步推演就能达到无评价网络版本 32 步的效果,32 步是训练的最优配置。推演步数从 64 提升至 128,达标耗时近乎翻倍,最终得分同步下降,128 步也是单张 H100 的显存承载上限。
在得分相同的前提下,评价网络还会改变机器人的行为。仿真实验令机器人保持 T 字姿态,再以 0.5 到 4 米每秒的速度侧向推搡。搭载评价网络的策略,可以在 0.5 到 2.4 秒内恢复站稳。移除评价网络的策略始终无法稳定平衡,0.5 米每秒的推力下就会踉跄,4 米每秒直接倒地。根源在于平衡恢复对应的奖励,往往落在 32 步推演窗口之外。
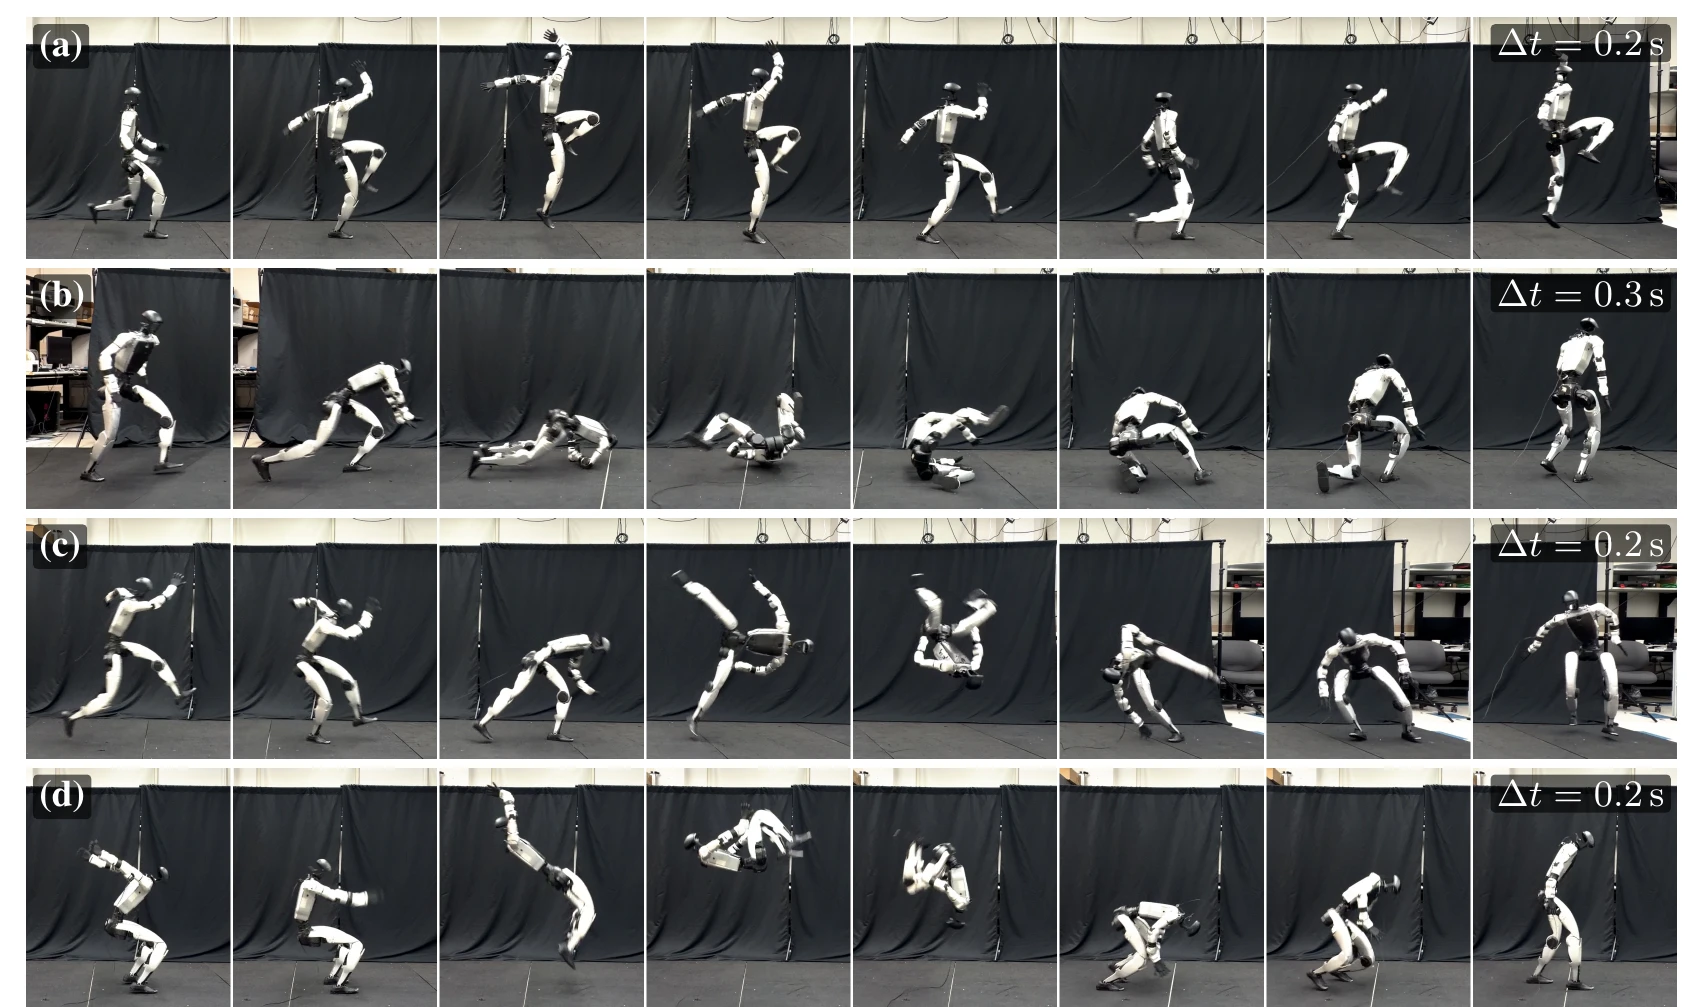
这张图片是伯克利团队SuperMimic相关的动作演示图,展示了宇树G1机器人在同一通用跟踪策略下完成的四类不同动作,未针对单个动作做单独调整。图片分为四个区域,分别对应标注的四个动作类别:(a)为跳步动作,(b)为躯干四肢贴地的侧滚动作,(c)为90°空翻动作,(d)为原地360°空翻动作。各区域右侧标注了每个动作序列的时间间隔,其中a、c、d的时间间隔为0.2秒,b的时间间隔为0.3秒,涵盖了移动、全身贴地以及杂技类的动作。
真机实验中,同一套通用跟踪策略直接部署到宇树 G1,没有针对单独动作微调参数。四项演示动作包含跳步、躯干四肢贴地侧滚、90 度空翻以及原地 360 度空翻,覆盖移动、全身贴地、特技杂技三类场景。训练阶段仅对物理参数做随机化处理,团队发现这就足以完成仿真到真机的迁移。
团队还探索了一类下游应用,控制机器人接收速度指令完成行走。基于同一世界模型,使用速度跟踪奖励训练速度编码器。对照组采用动作跟踪奖励做知识蒸馏。在覆盖全速度区间的 672 组阶跃指令测试中,前者在 650 组指令下误差更小,后者仅 15 组表现更优。两组的相对误差中位数分别为 0.16 与 0.49。只有蒸馏方案会出现摔倒问题,故障集中在 7 组平移搭配快速转向的指令,这类指令对应的样本在动作库中几乎不存在。
作者也梳理了现有局限。多接口联合训练的研究尚不完善,速度奖励当前只更新速度编码器,不会更新共享解码器。世界模型仅依托仿真数据学习,还未引入真机采集的数据。模型只在平地场景完成训练,面向复杂地形与物体交互的拓展工作仍在推进。