

和 SADL 作者孙俊涵聊聊:JEPA 的表征塌缩从哪里开始?
基于联合嵌入预测架构(Joint-Embedding Predictive Architecture,JEPA)的世界模型,会把图像编码成内部表征,再据此预测未来状态。
把画面转成数字的过程叫「编码」,得到的这组数字就是画面的「表征」。
如果两张有差异的图像经过编码后,得到的表征几乎一样,模型就很难通过表征作出正确判断。当许多原本不同的画面都被编码得难以区分,就会出现「表征塌缩」。
为了让不同画面的表征保有差别,研究人员通常会在训练中加入约束,但约束加在投影层的输出上。编码器先生成表征,投影层再对它加工。投影层可以重新组合、放大表征中还保留的差异,却无法找回已经丢失的信息。因此,投影结果符合约束,却并不能代表编码器保留了足够区分不同画面的信息。
如果投影层输出看起来仍有差别,编码器怎么会已经丢掉了区分画面的信息?
11 月 16 日,浙江大学孙俊涵为第一作者,清华大学助理教授赵昊、浙江大学教授章国锋为通讯作者,联合浙江大学 CAD&CG 全国重点实验室、清华大学智能产业研究院、RoboParty Lab、阿里巴巴集团和 InSpatio,发布研究《SADL: On the Demand-Supply Geometry of Representation Collapse》(表征塌缩的供需几何)。
这项研究将这处落差概括为投影层的「需求」与编码器的「供给」不匹配,并提出训练方法 SADL:在编码器保留的差别不足时,直接对编码器增加约束。
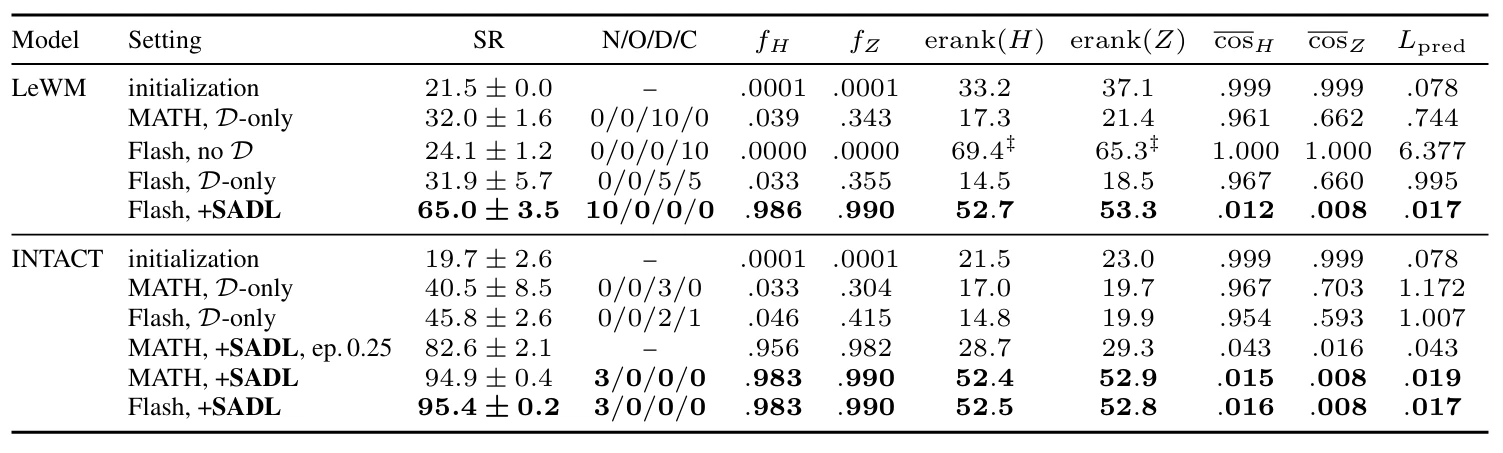
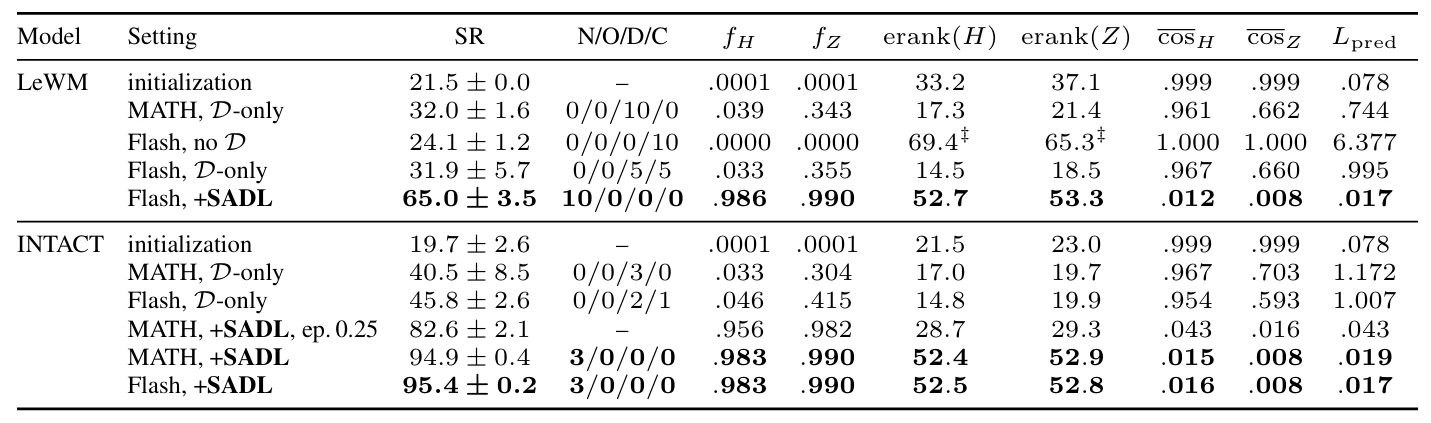
这项工作起于团队训练机器人世界模型 INTACT 时遇到的问题,随后也在另一款世界模型 LeWorldModel(LeWM)上做了验证。为了观察塌缩时会发生什么,研究人员用 Flash 注意力后端训练 LeWM,并撤掉原有的输出约束。四项任务联合训练一轮后,不同画面的编码结果已几乎一样,四项任务的平均成功率为 24.1%。
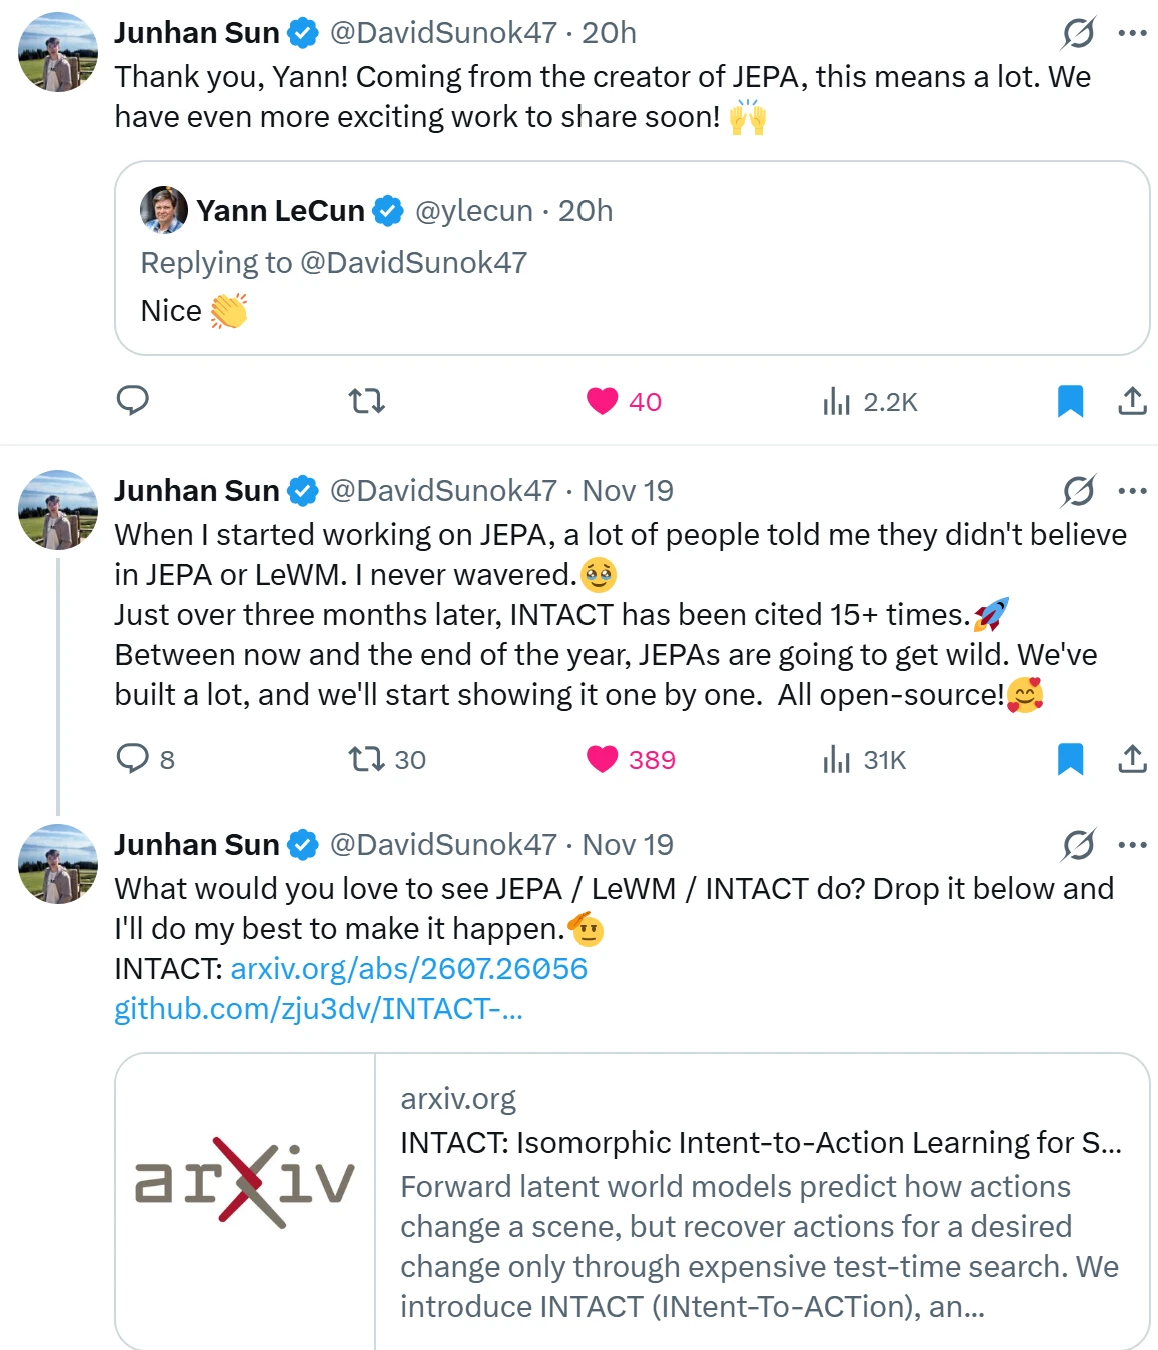
这项工作在 X 上发布后也迅速获得了关注。仅一天时间,孙俊涵介绍 SADL 的帖子便收获近千个点赞,并获得 JEPA 提出者 Yann LeCun 本人的转发和回复,LeCun 留下了「Nice」的评价。孙俊涵随后回应称,得到 JEPA 创造者的肯定,对自己意义重大。
借这篇论文发布的契机,42 号电波采访了论文第一作者孙俊涵,和他聊了团队如何定位表征塌缩、怎样判断何时该纠正编码器,以及这些训练进展离真实机器人还有多远。
表征塌缩从编码器开始
孙俊涵回忆,团队从今年 5 月开始做 JEPA,7 月底发布机器人世界模型 INTACT。当时项目的实验都用 MATH-only 后端计算注意力。这样做速度更慢,也更占显存,但换用其他后端时,「无论单任务还是四任务训练,都有可能发生表征塌缩」。团队试过更换用来防止塌缩的正则项,问题仍会出现。到了 8 月,他们开始逐个排查模型组件。
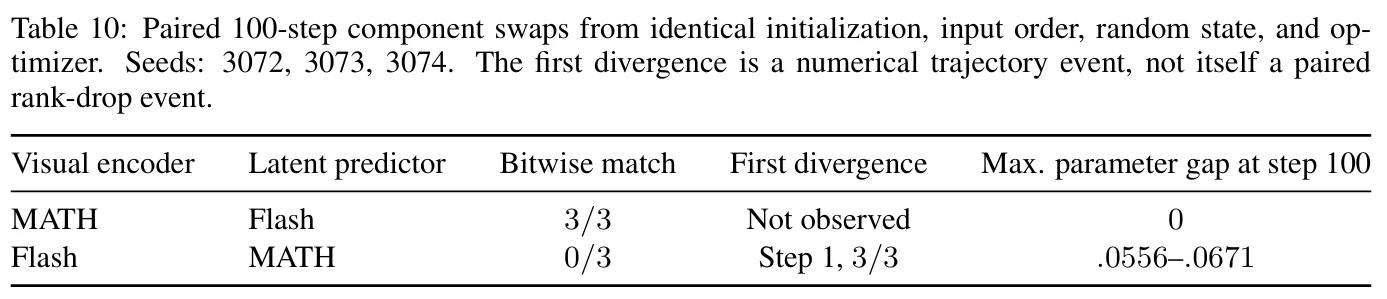
为了判断训练中的数值差异从哪里出现,团队固定初始参数、输入顺序、随机状态和优化器,只交换视觉编码器和预测器的注意力后端。编码器用 MATH、预测器用 Flash 时,3 次实验的前 100 步都与参考结果逐位一致。两者对调后,3 次实验都在第 1 步出现了数值差异。其中一次实验中,最早测到的差异出现在视觉编码器反向传播的梯度中,随后在参数更新中逐步放大。
第一步的数值偏差提供了排查线索。为了定位表征从哪里开始退化,研究人员又检查了 37 次训练中各层的输出。其中 13 次出现严重退化,有效秩降到同一训练轮次健康参考值的一半以下,最早观察到的异常都在视觉编码器里。有效秩反映样本间的差异分布在多少个有效方向上。这个数下降,意味着不同画面之间的变化越来越集中在少数方向。
「我们做了一些消融实验,想找出究竟是哪里先出现塌缩。结果发现,编码器倒数几层,也就是 ViT 的倒数几层,会率先出现塌缩。」孙俊涵说。
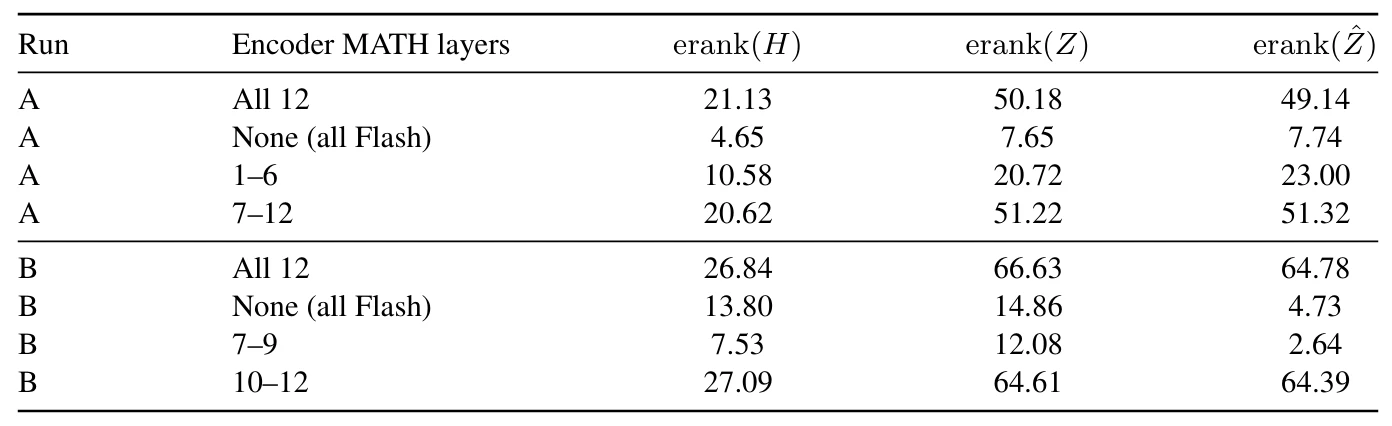
为了检验哪些层对注意力后端更敏感,团队把预测器固定为 MATH,只改变编码器中使用 MATH 的层,再用同一批 PushT 样本测量表征。只换第 7–9 层,编码器输出的有效秩为 7.53。只换最后的第 10–12 层,有效秩达到 27.09,接近全部 12 层都用 MATH 时的 26.84。
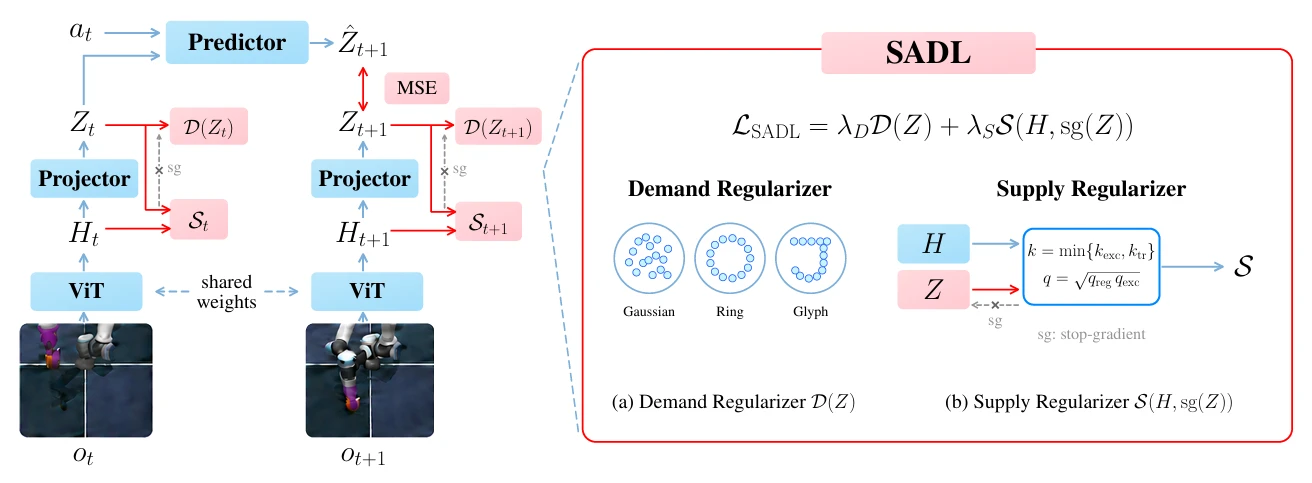
编码器已经开始退化,原有的训练约束为什么没能及时纠正它?一帧画面先经过视觉编码器 ViT,得到表征 H,再经过投影层得到 Z。预测器接收当前的 Z 和动作,预测下一时刻的表征。图中的 D(Z) 是原有的防塌缩约束,它直接作用在 Z 上。编码器里的变化要经过投影层,才可能影响这道约束。
团队测量了 LeWM 和 INTACT 在编码和投影两个阶段保留的样本差异。刚开始训练时,不同样本之间的差异只占编码器表征总能量的约 0.01%。只用原有输出约束训练一轮后,这个比例在 H 中约为 3%–5%,在 Z 中达到约 30%–42%。以使用 Flash 的 INTACT 为例,样本差异在 H 中占 4.6%,在 Z 中占 41.5%。投影层减去一批画面共有的成分后,剩余差异在输出中所占的比例可以升高。
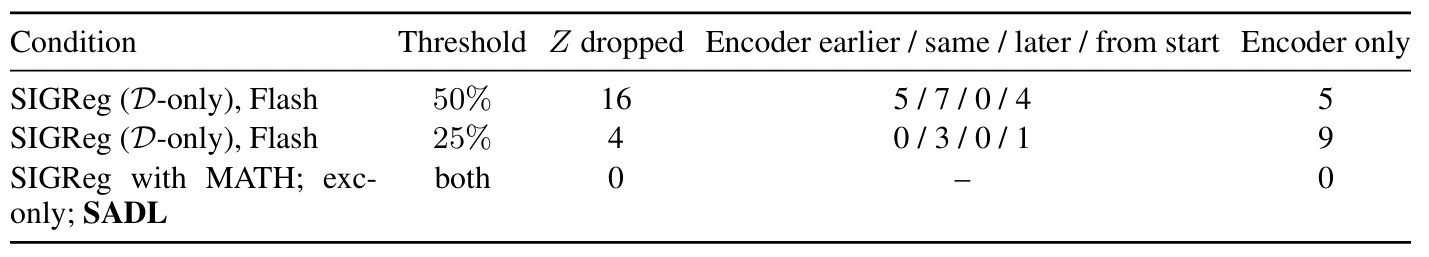
为了看这种落差在训练过程中何时出现,团队在 LeWM 上比较了编码器深层和 Z 的有效秩变化。实验使用 Flash,只用 SIGReg 约束 Z,并以归一化有效秩跌破各自峰值的 50% 为界。40 个「训练运行 × 任务」组合中,有 16 个组合的 Z 跌破阈值。其中 5 个组合的编码器更早跌破,7 个在同一次记录中跌破,另外 4 个从首次记录起,编码器就已低于阈值。此外,还有 5 个组合只观察到编码器跌破阈值。只监测 Z,就会漏掉这 5 次退化。
问题出在训练信号经过投影层时会发生什么。研究使用的投影层带有「批归一化」,训练时会减去同一批样本的平均值。假如给每张图的编码结果都加上同一组数字,平均值也会增加同样的量,相减后 Z 保持不变。数学上,这些共同变化的方向属于投影器 Jacobian 的零空间。这样一来,通过 Z 计算的预测损失和防塌缩约束,都无法沿这个共有方向给 H 传回纠正信号。共有成分可以继续占据 H 的大部分能量,真正能区分不同画面的变化只占很小一部分。
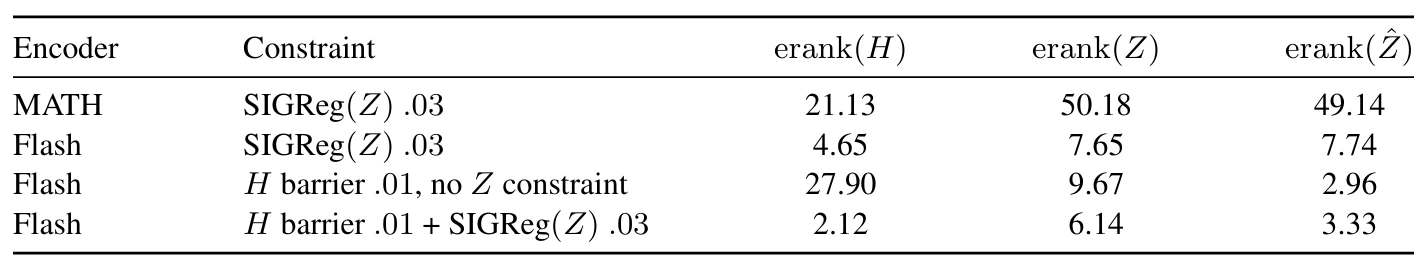
团队也测试了把约束直接加在编码器上。两组实验使用相同的注意力后端,只改变约束的位置。只约束 Z 时,H 的有效秩为 4.65。改为只约束 H 后,这一数值升到 27.90,Z 的有效秩为 9.67,预测器输出的有效秩则从 7.74 降到 2.96。编码器里的样本差异分布到了更多方向,预测器输出里的差异却变得更集中。
这就给后续方法留下了两个问题。编码器里保住了多少画面差异?其中又有多少能传到投影输出?
SADL 按需约束编码器
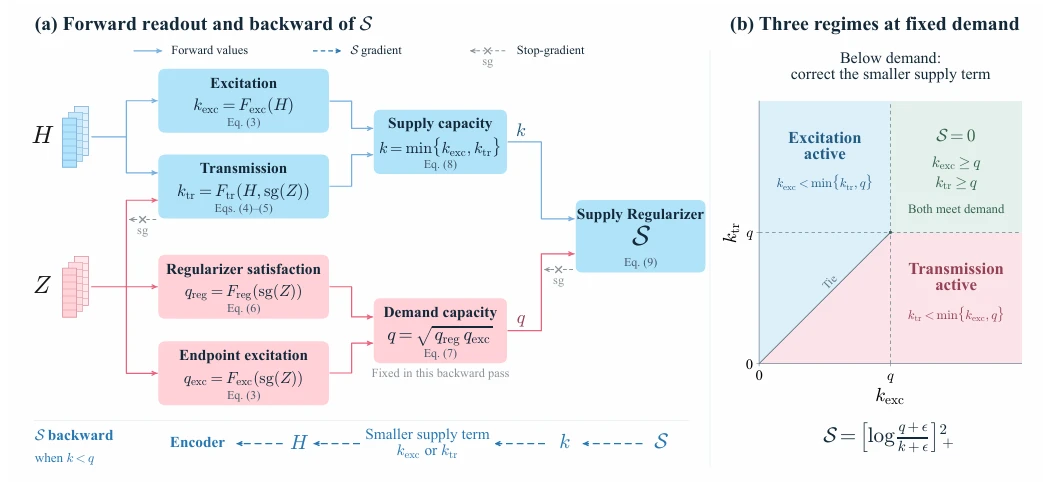
团队提出了 SADL,全称 Supply And Demand Loss(供需损失)。这是一种训练方法,保留原来的预测损失和投影层约束,再给编码器加一项按需启用的「供给正则」。当编码器能保留并传给投影层的差异低于当前需求时,额外约束才介入。
「需求需要多少,我就让供给给多少。」孙俊涵在采访中这样解释。
具体到模型里,供给由两个分数决定。「激发」衡量 H 里有多少变化来自不同样本,以及这些差异分布在多少个方向上。「传输」则根据 H 和 Z 的线性关联,估计 H 里的变化有多少能在 Z 中找到对应。SADL 取两项中较低的分数作为供给 k。任意一项跟不上,都会限制实际供给。
需求 q 从 Z 的当前状态算出。团队用一个分数衡量 Z 满足原有输出约束的程度,用另一个分数衡量 Z 已经形成的样本差异,再取两者的几何平均。训练时,模型先用当前的 Z 算出需求,把它作为本次更新的参照。供给低于需求时,额外的纠正信号直接传给编码器,作用在较低的那项供给分数上。两项都达到需求后,惩罚归零。
为了检验激发和传输各自能发现什么问题,团队把需求固定在 0.70,分别制造两种缺口。第一组里,已有的样本差异能传过去,但编码器留下的差异太少。只检查传输时,200 步后激发分数仍是 0.494,完整 SADL 则把它提高到 0.713。第二组里,编码器保留的差异已经够多,传输却跟不上。只检查激发时,传输分数停在 0.314,完整 SADL 将它提高到 0.789。两组实验里,单独检查的那一项都已经达标,另一项的缺口因此没有触发纠正。
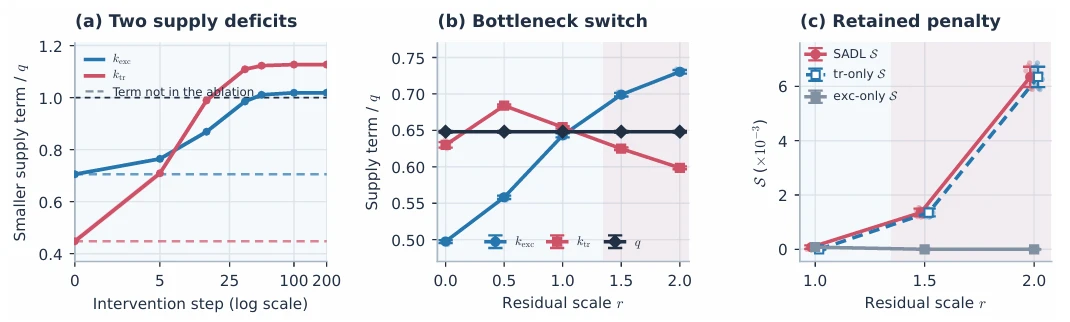
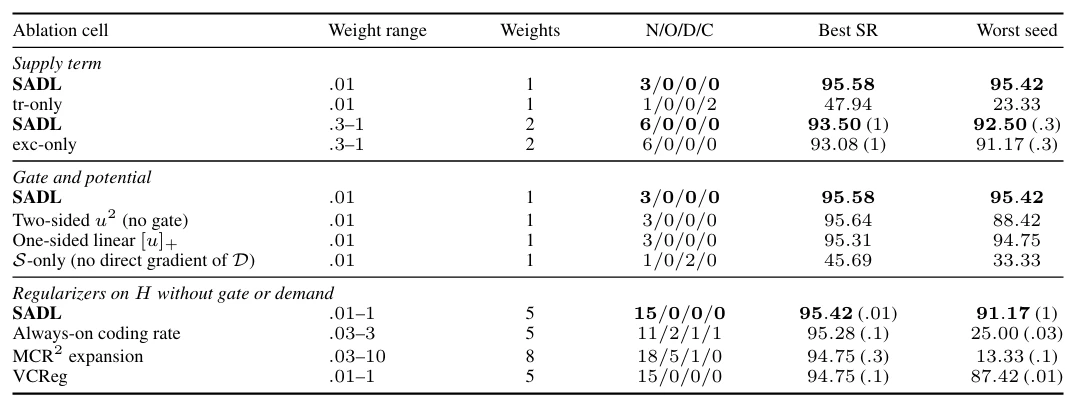
团队接着在 INTACT 的四任务训练里检验「够了就停」这条规则。对照使用双向惩罚,供给高于或低于需求都会受罚。在相同权重下,训练一轮后,双向惩罚和完整 SADL 的平均成功率分别为 95.64% 和 95.58%。两组平均成绩接近,但各自成绩最低的一次相差 7 个百分点,分别为 88.42% 和 95.42%。
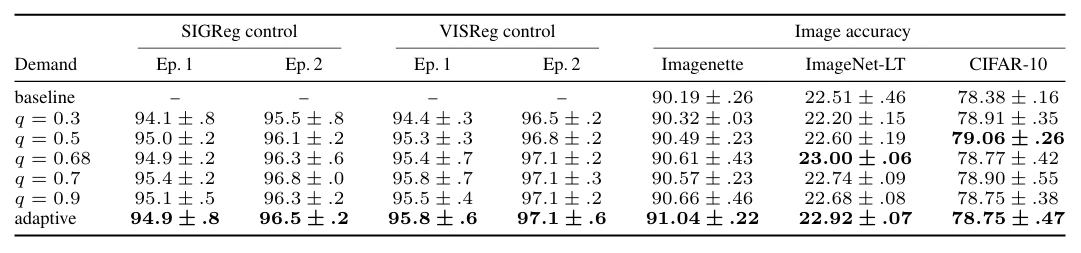
需求也可以设成固定值。团队在两种输出约束下做了比较。用 SIGReg 时,训练两轮后,固定 q=0.70 的四任务平均成功率为 96.8%,自适应需求为 96.5%。换成 VISReg,固定 q=0.68、0.70 或 0.90 都能达到 97.1%,自适应需求也达到 97.1%。固定值选得合适,同样能跑出接近的成绩。自适应需求让模型换一组训练设置后,仍能沿用同一套规则,从当前输出计算需求。
SADL 改动的是训练目标,模型结构和预测流程照常运行。真正回到机器人任务里,还要看这些被保留并传到 Z 的差异能不能让预测更准确,以及预测的改善能不能转化为更高的控制成功率。
表征更稳,控制成功率更高
同一个世界模型分别学四项任务,和用同一个编码器同时学四项任务,结果会有什么差别?
孙俊涵在采访中谈到,他更关心的是,解决表征退化以后,JEPA 能不能继续往多任务联合训练走。团队为此在 LeWorldModel(LeWM)和 INTACT 上做了两套实验。单任务实验把 PushT、Cube、Reacher 和 TwoRoom 分开训练,再平均四项成绩。联合训练则让四项任务共用编码器和投影层。评测时,LeWM 会搜索候选动作,INTACT 直接输出动作,因此增益都在各自模型内比较。
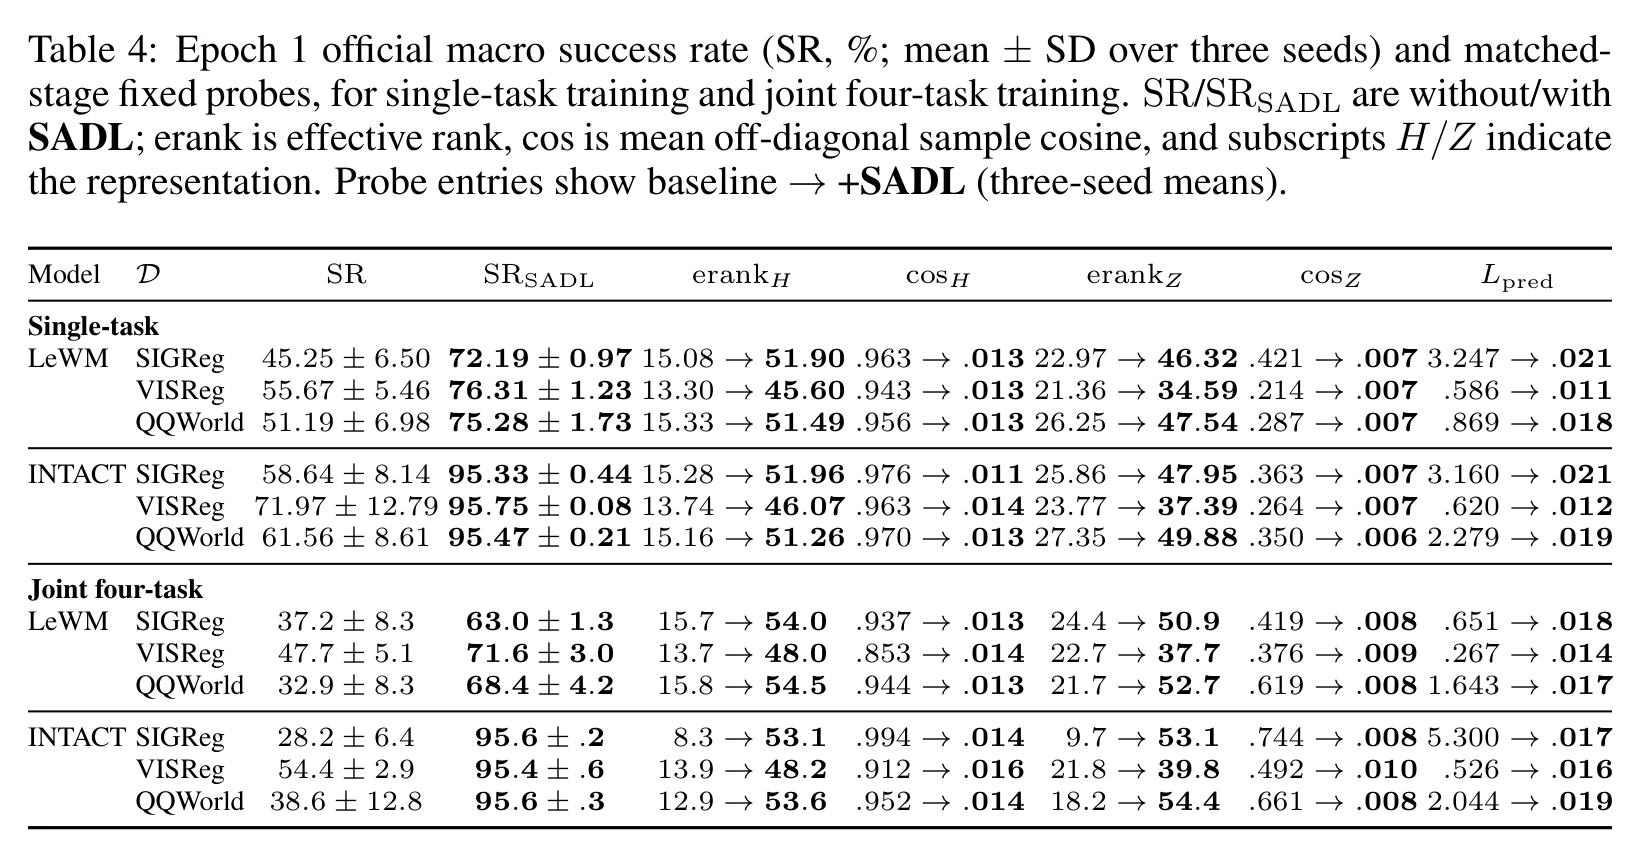
团队用三种输出约束分别测试两款模型。训练一轮后,单任务实验的六组对照中,加入 SADL 后的平均成功率提高了 20.6–36.7 个百分点。四任务联合训练的六组对照中,增幅为 23.9–67.4 个百分点。以联合训练中的 INTACT、SIGReg 组合为例,编码器输出 H 的有效秩从 8.3 升到 53.1,投影输出 Z 的有效秩从 9.7 升到 53.1,预测下一状态表征的损失从 5.300 降到 0.017,四任务平均成功率从 28.2% 升到 95.6%。在同一组实验里,编码器保留的差异、预测的准确度和最终的控制成绩都出现了改善。
平均成绩上去了,换个随机起点还会不会塌缩?团队另用 10 个随机种子重复 LeWM 四任务训练,固定使用 Flash 后端和 SIGReg 输出约束。训练两轮后,只用原有约束的 10 次训练中,5 次退化、5 次塌缩。加入 SADL 后,10 次都达到研究设定的正常标准。孙俊涵回顾这组结果时说:「本来是有退化和坍塌的,而现在既不退化也不坍塌」。对联合训练来说,这组结果补足了平均成功率看不出来的一点,即换了随机起点,模型还能不能稳定训下去。
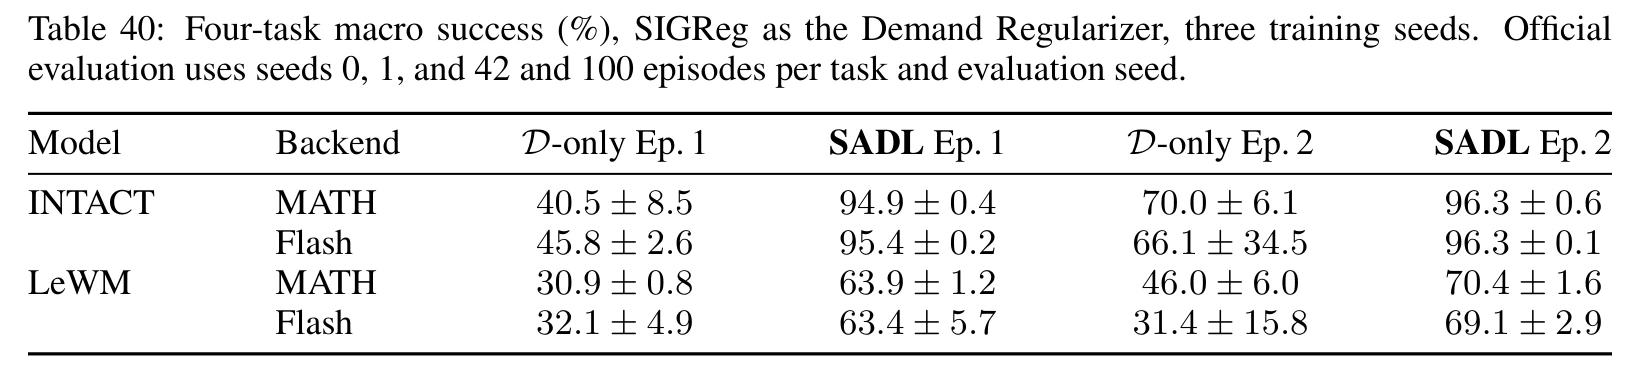
团队又单独对齐注意力后端、数据顺序和更新次数,检查提升是不是来自换用 Flash。在 INTACT 上,两轮训练后,使用 MATH 时,加入 SADL 让四任务平均成功率从 70.0% 升到 96.3%。使用 Flash 时,从 66.1% 升到 96.3%。LeWM 在两种后端下也都有提升。四组对照里,加入 SADL 训练一轮的成绩,都已经超过了相同后端下基线训练两轮的成绩。 以 INTACT 为例,这两档训练预算分别是 5,695 次和 11,390 次参数更新。
接下来,团队把输出约束换成了不同的分布目标。训练过程中,研究人员追踪了四种设置下的四任务成功率,其中包括环形混合分布和球壳分布。采用环形混合分布时,加入 SADL 的 INTACT 在第 5 轮达到 97.8%。如果想看 LeWM 加入 SADL 前后的变化,可以在同一小图里对照红线和灰线,这两条线对应同一个模型。
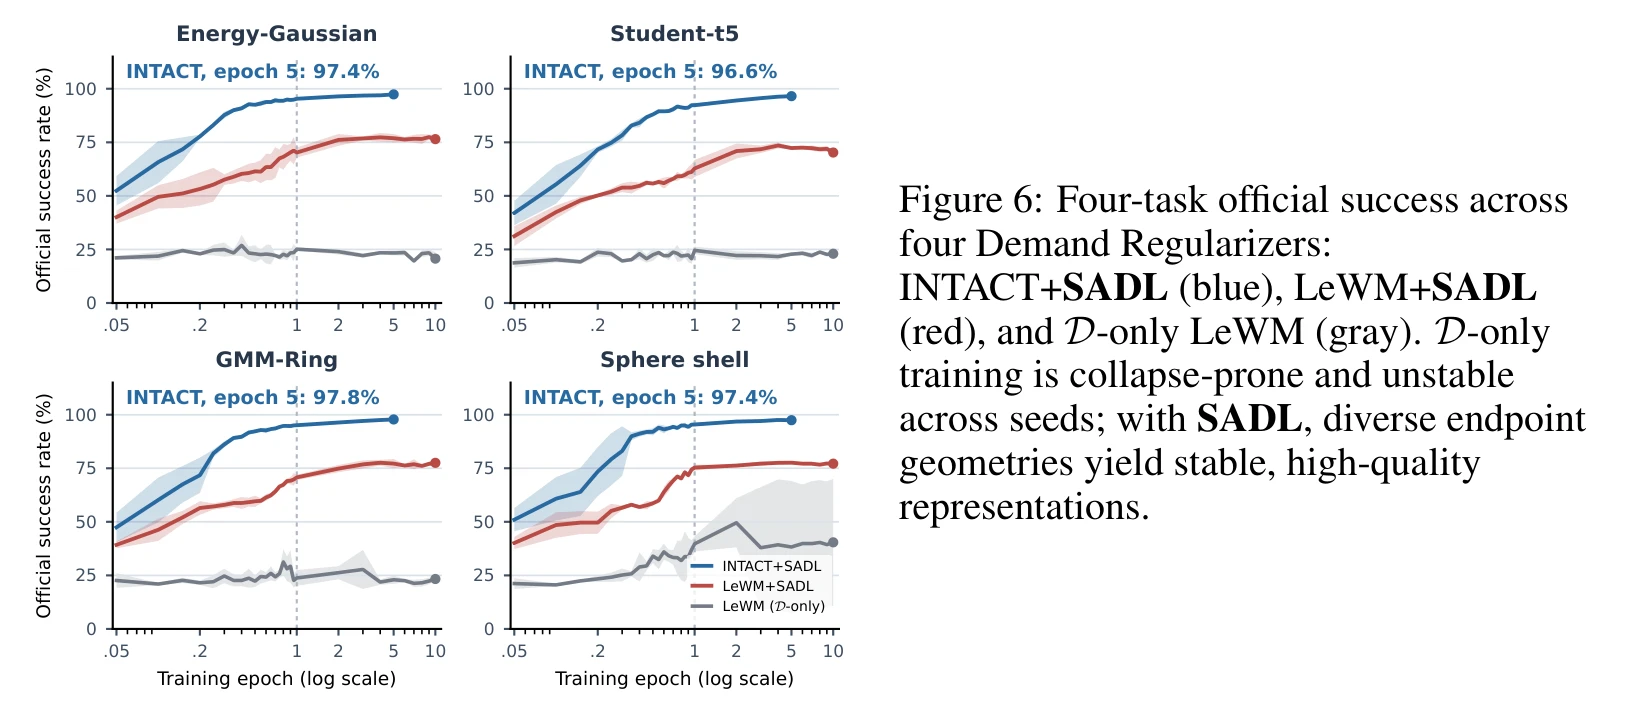
把八种输出约束的成绩放到一起,INTACT 训练一轮后的四任务平均成功率在 92.33%–95.81% 之间,其中七种超过 95%。但把平均分拆开看,任务间的差距仍然很明显。比如用 SIGReg 时,四任务平均成功率是 95.58%,Cube 和 TwoRoom 在这组评测里都达到 100%,但需要把 T 形积木推到位并对准朝向的 PushT,成功率为 85.44%。在八种设置里,PushT 的成绩介于 76.67% 和 86.33% 之间。
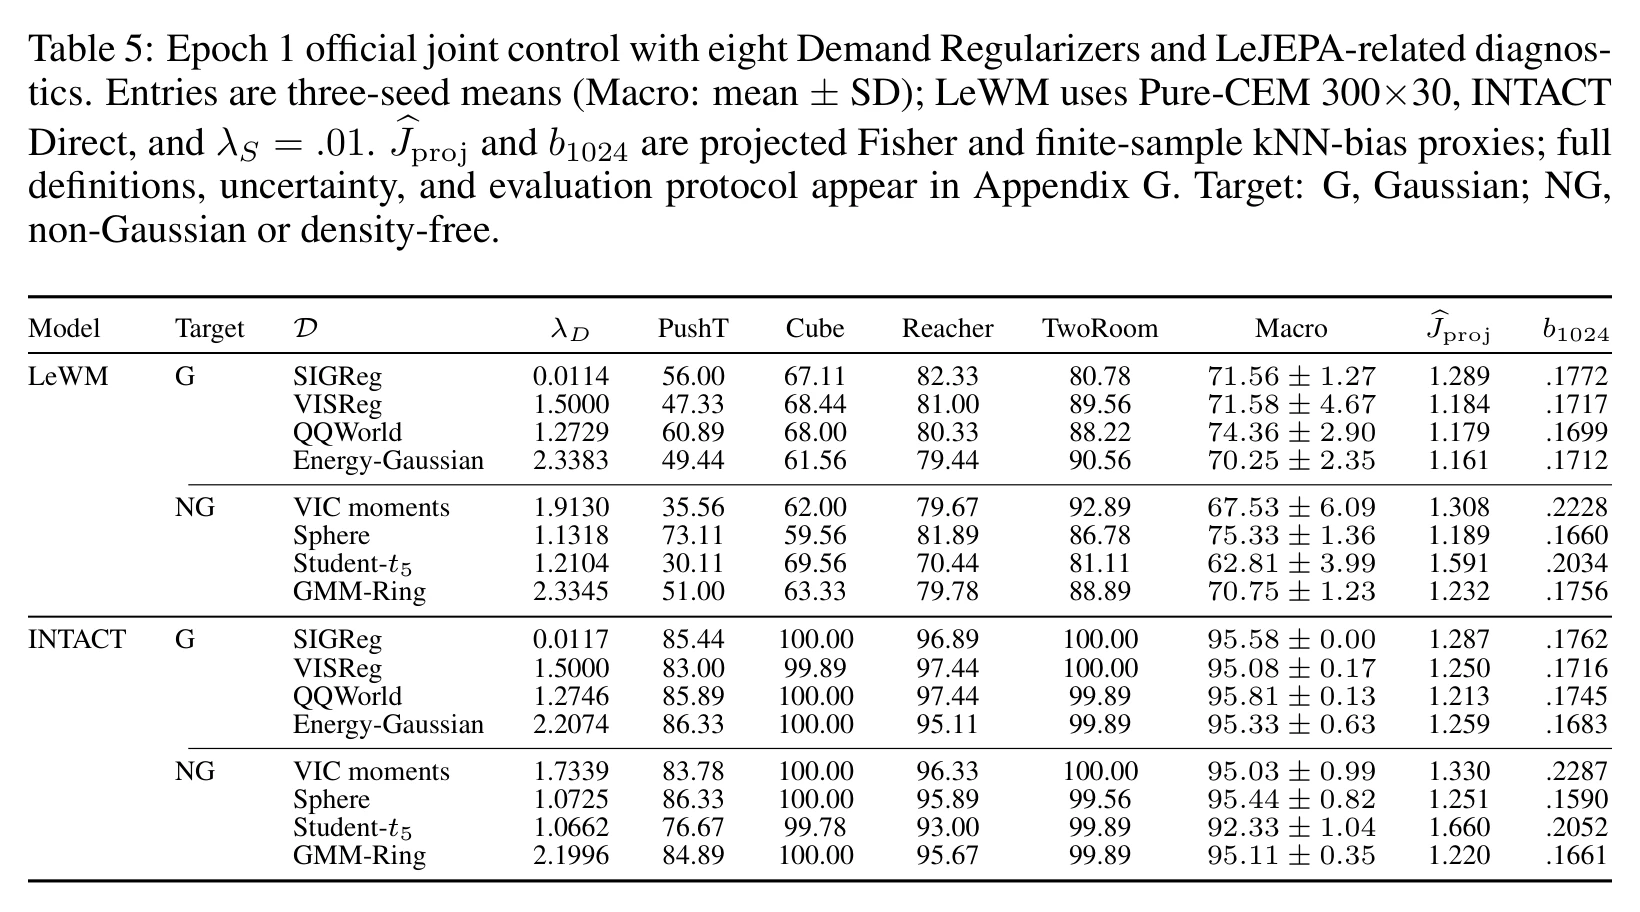
四项任务共用一套编码器时,SADL 能让模型更早取得较高的平均成绩。PushT 的单项结果也说明,即使平均成功率超过 95%,位置和朝向都要对准的操作仍有明显的提升空间。
从图像分类到真机,SADL 能走多远
SADL 最初是为了解决机器人世界模型的训练问题。如果把任务换成图像分类,它还能让编码器更早学到有用的表征吗?
团队选了四个数据集做配对实验。每组使用相同的数据、模型结构、训练设置和评测方式,只比较加不加 SADL。计算激发分数时,研究人员还做了一处针对图像的调整,先把同一张图经过不同裁剪和增强后得到的表征取平均,再衡量不同图像之间的差异。这样,分数反映的是图与图之间有多少区别。
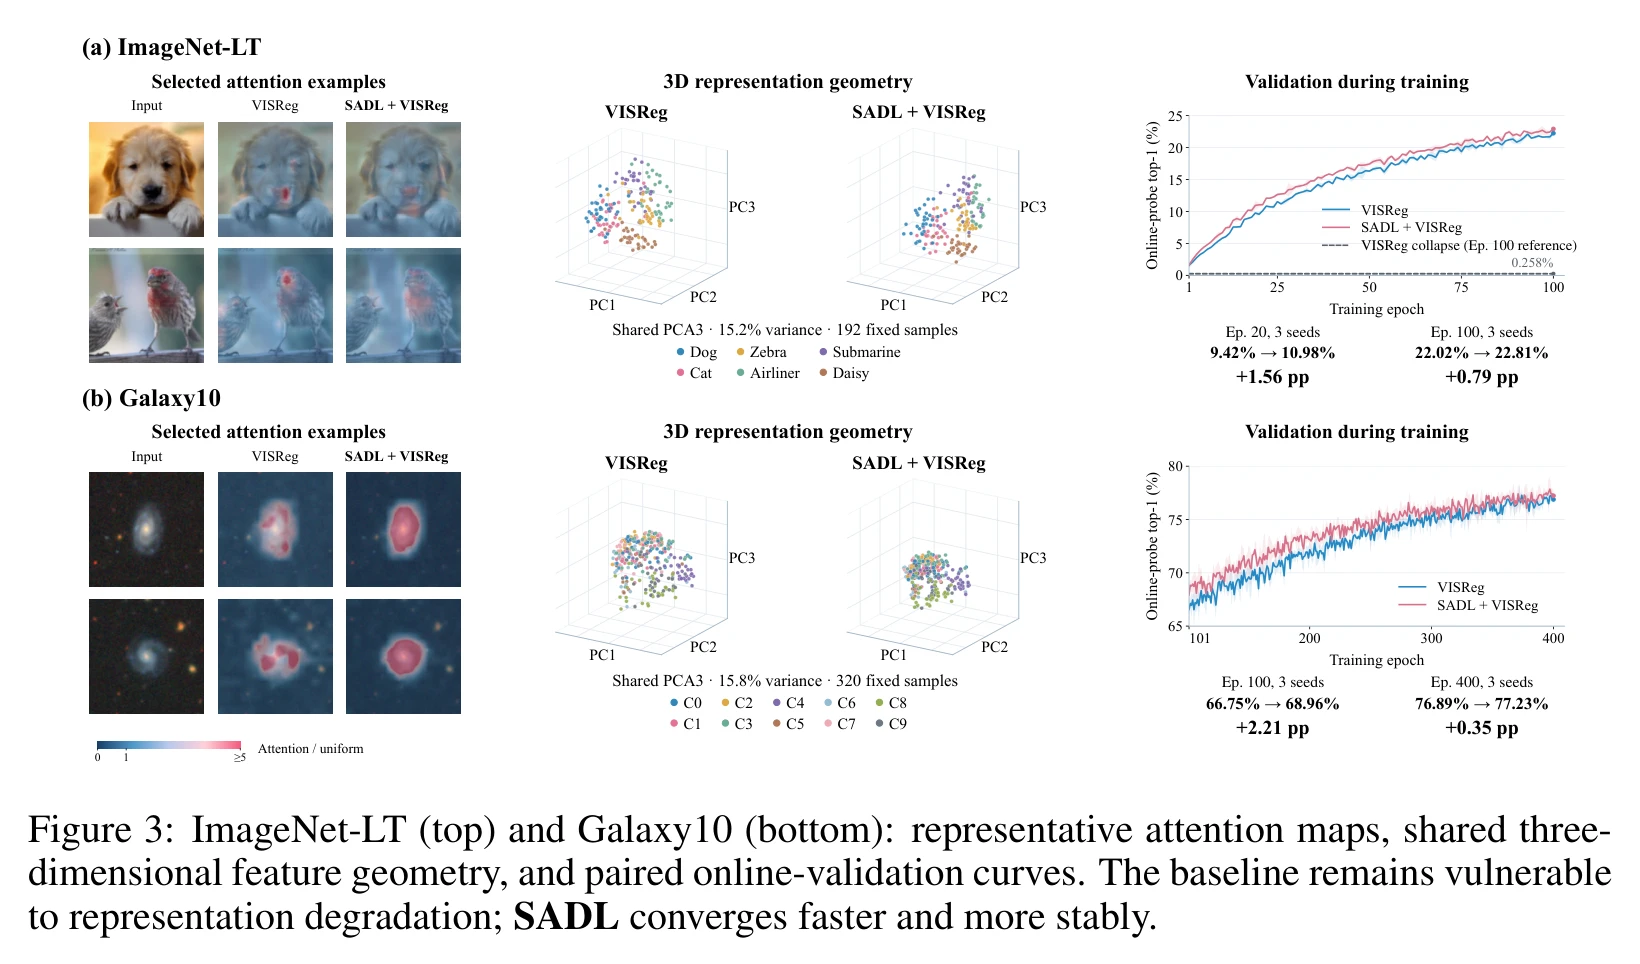
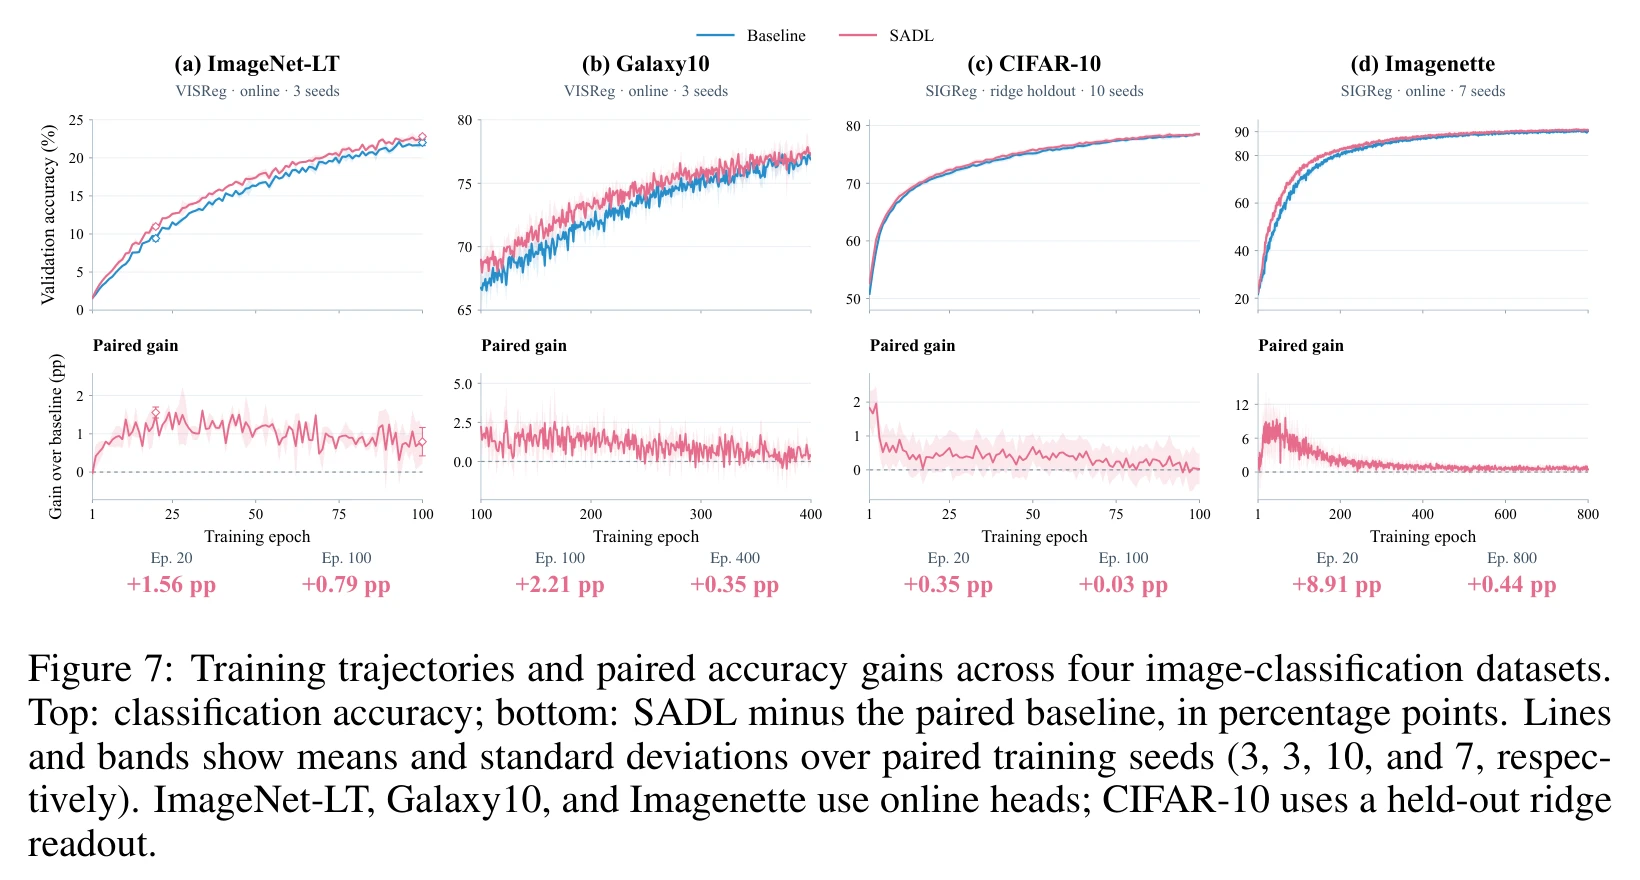
在 ImageNet-LT 和 Galaxy10 上,团队用狗、鸟和星系的样本展示模型关注的区域,并通过固定样本在共享三维坐标系中的投影,比较加入 SADL 前后的表征分布。分类准确率则用来检验这些表征能提供多少类别信息。ImageNet-LT 训练到第 100 轮时,加入 SADL 后的平均准确率为 22.81%,基线为 22.02%。Galaxy10 在第 100 轮领先 2.21 个百分点,到第 400 轮,差距缩小到 0.35 个百分点。把前后两个时间点放在一起,就能看出其中一部分收益来自模型更早学会区分类别。
Imagenette 数据集上,这种「前期提速、后期收敛」的趋势更加明显。第 20 轮,加入 SADL 的模型平均准确率为 44.51%,基线为 35.60%,7 组配对训练全部提高。到第 800 轮,两组的差距缩小到 0.44 个百分点。CIFAR-10 在第 1 轮也提高了 1.83 个百分点,但到了第 100 轮,两组分别是 78.52% 和 78.50%,差异落在随机种子的波动范围内。图像实验里最一致的收益,是在训练早期学出能用于分类的表征。训练到最后还能领先多少,要看数据集和训练设置。
采访中,42 号电波还问到了模型训坏后能不能补救:「如果模型已经训坏了,中途加上 SADL,还拉得回来吗?」
「准确来说,有一定概率可以拉回来。」孙俊涵说。
团队选取了接近塌缩的训练存档,让两组从同一个存档出发继续训练。以 INTACT 为例,从随机种子 3072 的存档续训后,加入 SADL 的四任务平均成功率为 53.92%,对照组为 24.42%。换到种子 0 的存档,仍用 0.01 的供给正则权重,加入 SADL 的一组得到 26.50%,低于对照组的 28.92%。这些实验的起点都还保有部分样本差异,恢复效果会随存档和约束强度变化。
到真实机器人落地,孙俊涵认为 JEPA 的潜力落在 System 0,也就是需要快速响应的底层控制。他看重的是,模型可以在表征空间里预测动作会带来什么变化,省去重建完整画面的步骤。他认为,把计算用在会影响动作的信息上,有机会让模型做得更小、响应更快。
他在采访中也提到,团队正在推进从仿真到真实场景的工作。这项研究验证的是训练稳定性和仿真控制,System 0 设想还要靠真机上的响应延迟和任务成功率来检验。
发现文章有错?告诉我们